Intel Panther Lake 采用 18A 工艺、RibbonFET 晶体管和 PowerVia 背面供电,制造工艺上的升级已经足够引人关注。但 SemiAnalysis 公布的芯片拆解中,还有一个更适合从架构角度琢磨的变化:NPU 面积大幅缩小了。
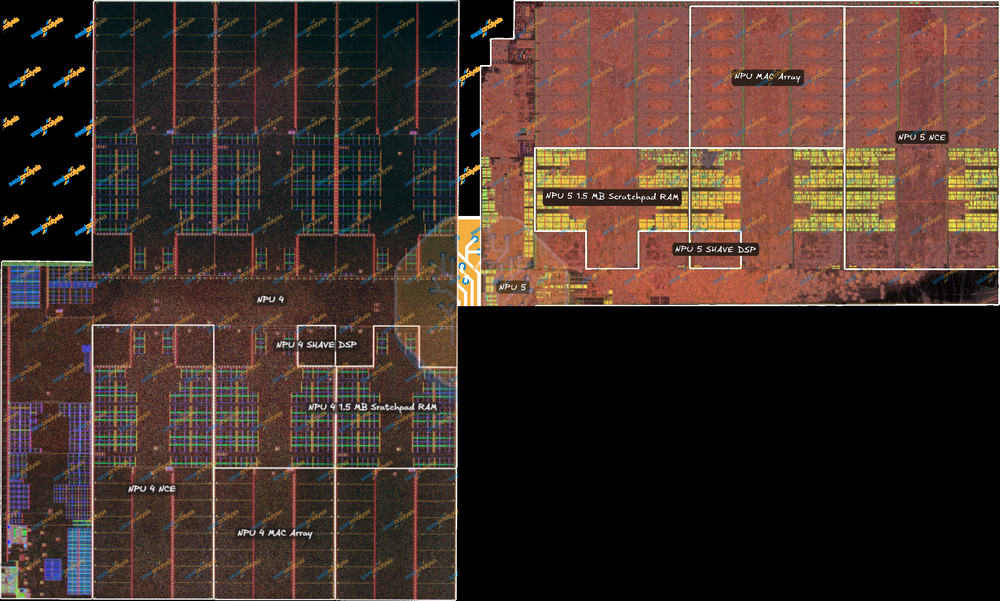
与 Lunar Lake 的 NPU 4 相比,Panther Lake 的 NPU 5 面积减少了 36.9%,但 INT8 MAC 总数量没有减少。Intel 重新组织了计算引擎,同时削减了局部存储和 DSP 资源。换句话说,在保住主要矩阵运算资源的前提下,Intel 选择重新分配 NPU 内部的芯片面积。
01|计算引擎从 6 个变成 3 个
先看 NPU 的基本组成:Intel 的 NPU 由多个神经计算引擎(NCE)构成,每个引擎包含 MAC 阵列、局部 Scratchpad 存储,以及负责向量和其他可编程运算的 SHAVE DSP。
在 Lunar Lake 的 NPU 4 中,这些资源分布在 6 个 NCE 内。到了 Panther Lake 的 NPU 5,NCE 数量缩减为 3 个,但每个 NCE 内部的 MAC 阵列变得更大。
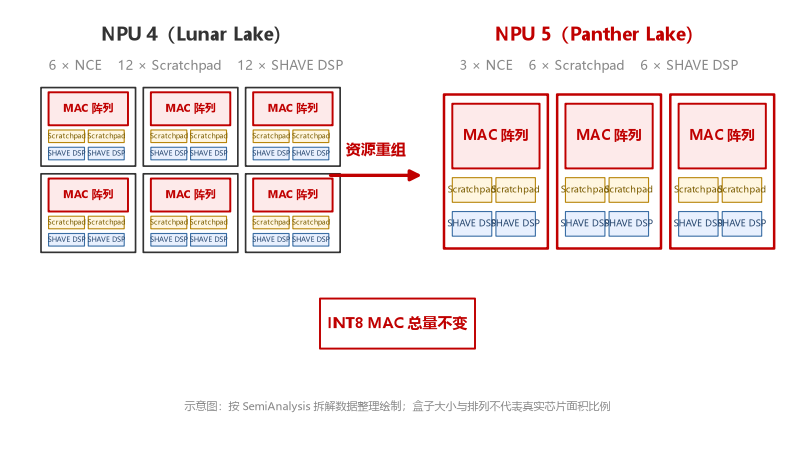
根据 SemiAnalysis 的 Die Shot 测量,新一代单个 NCE 的整体面积比上一代大 22.6%,而整颗 NPU 的面积却减少了 36.9%。原因在于,Intel 减少了重复配置的外围资源。
对于采用多个神经计算引擎(NCE)的 NPU 来说,每增加一个引擎,通常也需要配套局部存储、控制和数据处理资源。把 MAC 集中到更少、更大的引擎中,可以减少部分重复开销。但引擎变大也意味着,计算阵列对数据供应能力提出了新的要求。
02|面积省在哪里?局部存储是关键
SemiAnalysis 的拆解显示,NPU 5 将 Scratchpad 和 SHAVE DSP 数量从 12 组减少到 6 组。其中,Scratchpad 的减少贡献了最大的面积节省。
Scratchpad 负责在 MAC 阵列附近保存权重、激活值和中间结果,让数据能够在片上重复使用,减少对外部 DRAM 的访问需求。
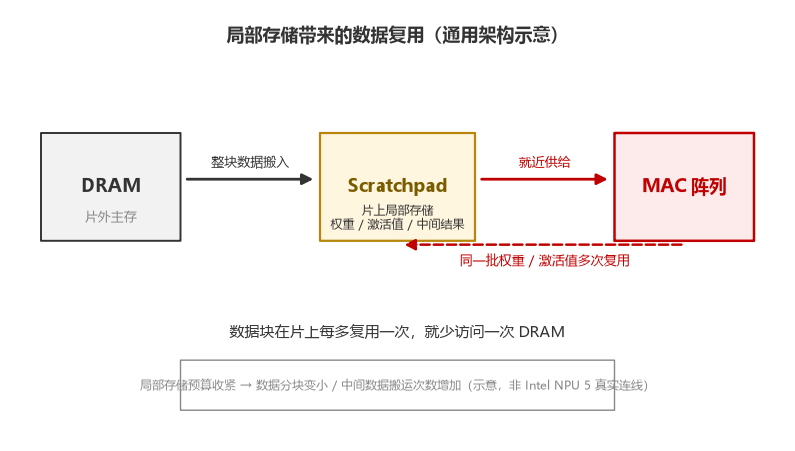
对于矩阵运算来说,MAC 数量决定了理论计算规模,但实际利用率还受到数据供应能力的影响。当局部存储足够容纳当前计算所需的数据块时,同一批权重或激活值可以多次复用。局部存储预算收紧之后,部分工作负载可能需要采用更小的数据分块,或者增加中间数据的搬运次数。因此,减少 Scratchpad 虽然省了面积,却也可能增加数据调度的难度。
需要注意的是,拆解确认了存储区域和数量的变化,但不能仅凭 Die Shot 推断具体模型的 DRAM 流量增加了多少。实际影响还取决于编译器如何安排数据分块、模型结构以及运行时的数据复用情况。
03|DSP 减半,哪些任务交给专用硬件?
除了局部存储,SHAVE DSP 的数量也从 12 个降至 6 个。MAC 阵列主要承担矩阵乘法和卷积,SHAVE 则负责不适合直接映射到 MAC 阵列的向量运算和自定义操作。
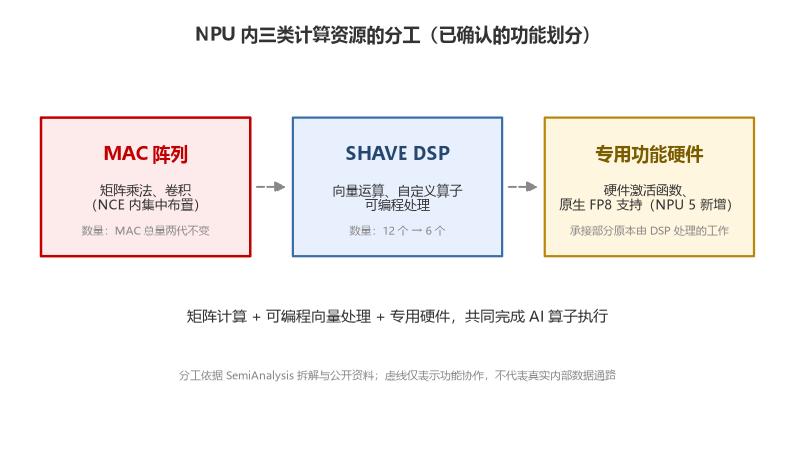
NPU 5 同时增加了硬件激活函数支持,并引入原生 FP8 计算能力。其中,硬件激活函数可以减少一部分原本需要可编程 DSP 处理的工作;FP8 则将操作数宽度从 FP16 的 16 位缩小到 8 位,有助于降低相关数据的存储与传输需求。
这两项变化为减少外围资源提供了条件,但 FP8 并不意味着所有模型都可以直接转换。数值范围、精度损失和量化策略仍然需要在模型部署时仔细验证。
从架构上看,NPU 5 采用了更集中的 MAC 阵列、更少的局部存储与 DSP 资源,并通过新增专用计算能力来调整部分运算的执行方式。
04|面积减少 36.9%,性能会怎样?
Lunar Lake NPU 4 的官方 AI 算力为 48 TOPS,Panther Lake NPU 5 提升到 50 TOPS。两代产品的峰值算力接近,但 NPU 5 使用的硅面积明显更少,意味着单位面积能够提供更高的理论计算能力。
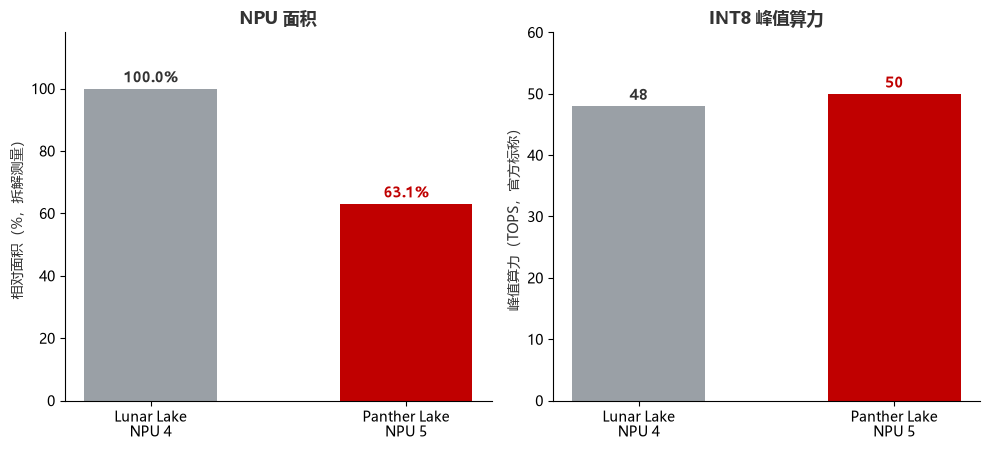
不过,峰值 TOPS 并不能完整反映真实模型的执行效率。如果模型的主要计算能够持续填满 MAC 阵列,较大的计算引擎有机会维持较高利用率。对于依赖复杂数据搬运、局部存储或可编程运算的任务,Scratchpad 与 DSP 资源减少可能带来不同的性能表现。
此外,两代 NPU 分别采用不同制造工艺。36.9% 的面积差异同时包含工艺与架构变化,不能全部归功于 NCE 重组。目前的 Die Shot 能够揭示资源分配方式,但要判断这套设计在不同 AI 模型上的实际收益,还需要结合模型级性能、功耗以及数据搬运测试。
05|NPU 设计可以从中学到什么?
Panther Lake 这次调整提供了一个非常具体的架构案例。在 MAC 总数量不变的情况下,Intel 将计算资源集中到更少的 NCE 内,减少重复配置的局部存储和 DSP,同时引入 FP8 与硬件激活函数支持。
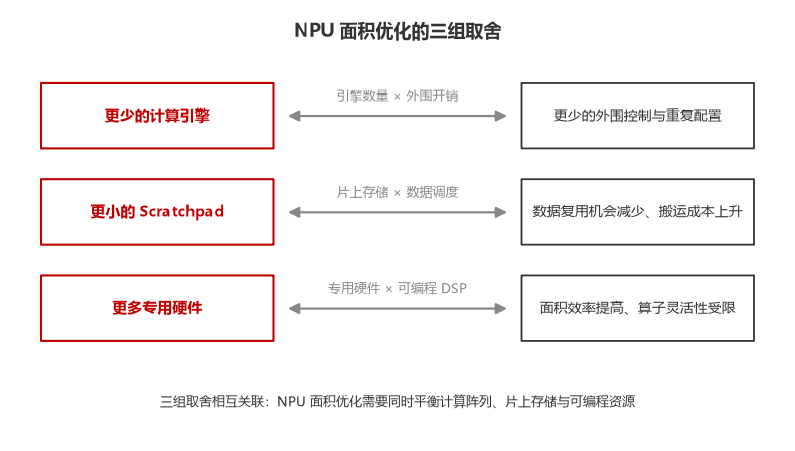
对 NPU 和 SoC 架构工程师来说,这里面涉及三项相互关联的取舍。第一,计算阵列的规模与组织方式,会影响外围控制和存储资源的重复开销。第二,Scratchpad 面积直接影响数据复用能力,减少片上存储需要重新评估分块策略与搬运成本。第三,专用硬件与可编程 DSP 之间的职责分配,会影响面积效率,也会改变支持不同算子的灵活性。
Panther Lake 展示的是一种更重视面积效率的 NPU 设计思路:它通过重新组织计算与外围资源,在保留 MAC 总量的同时缩小芯片面积。对于设计 AI 加速器的工程师来说,真正值得持续研究的是下一步——当局部存储和可编程资源减少之后,编译器与数据调度能否继续让计算阵列保持高利用率。这类架构演进的话题,在云栈社区也经常被拿出来反复讨论。
 发表于 3 小时前
|
查看: 1|
回复: 0
 /1


