AI芯片的计算单元正变得越来越专用。矩阵乘法交给专门的阵列,数据搬运归DMA,片上存储也围绕特定模型做优化。可问题在于,这些硬件依然需要有人来启动任务、备好数据、跟踪执行状态,并把不同计算阶段串起来。
传统上,这类工作可以由主CPU、寄存器接口和硬件状态机完成。但加速器一多、任务类型一变,控制路径就容易变得复杂,很多操作还不得不频繁穿过系统总线。
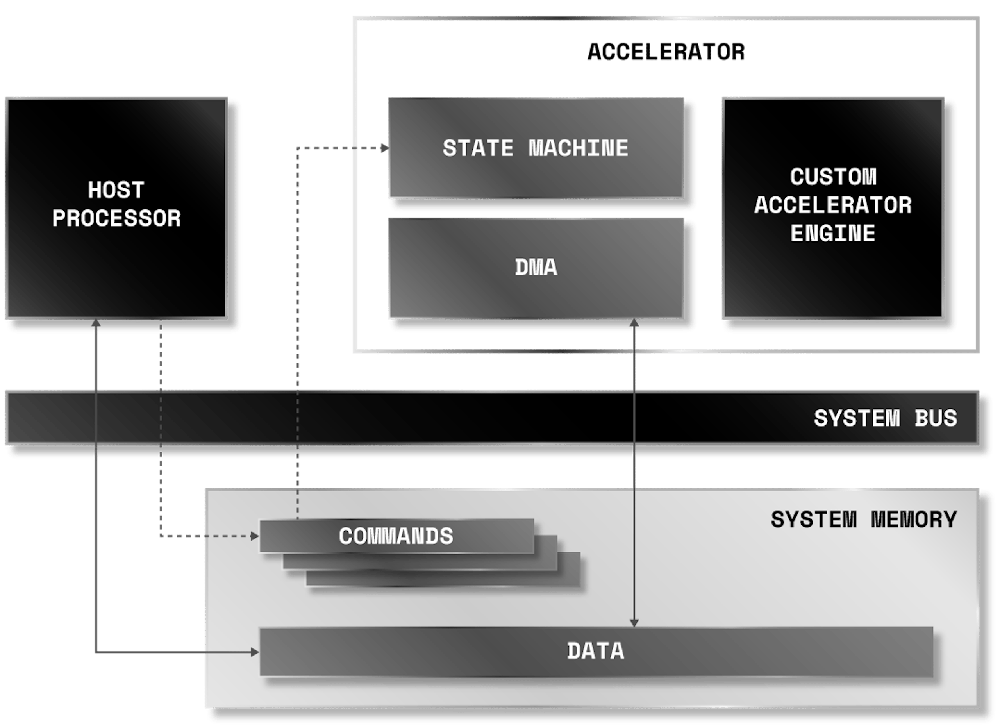
传统方式:主处理器经系统总线、状态机与DMA管理加速器(来源:SiFive官方博客,2026年10月)
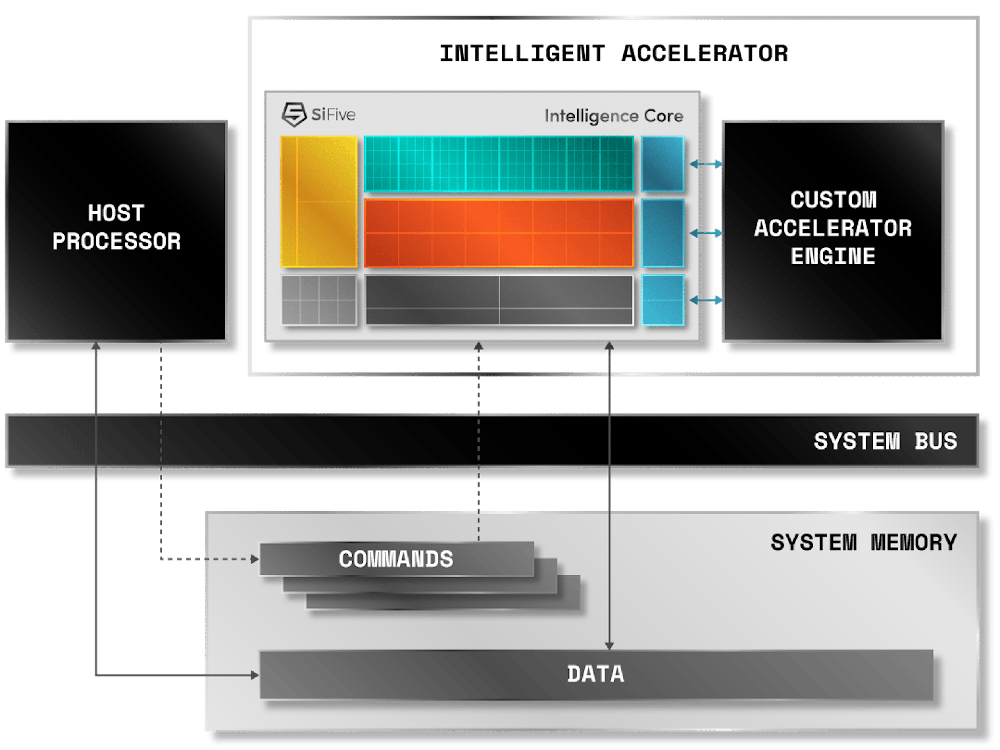
ACU方式:可编程RISC-V控制核心(Intelligence Core)靠近专用加速器引擎部署(来源:SiFive官方博客,2026年10月)
SiFive 在 10 月发布的技术文章中提出了另一个思路:让 RISC-V 处理器来承担专用加速器的控制工作。这种处理器叫 Accelerator Control Unit(ACU),可以贴近计算引擎部署,再通过专门的指令、数据和存储接口与硬件协同。
整体思路很清晰:可编程 CPU 负责控制和部分辅助计算,专用硬件继续扛高吞吐的核心运算。
01|为什么AI加速器还需要一颗CPU
一颗矩阵计算引擎的乘加吞吐可以很高,但它没法独立跑完整个 AI 任务。
以矩阵乘法为例,开算之前要备好输入数据和权重,配好矩阵尺寸和执行参数;算完之后,可能还要做数据格式转换、激活函数等后处理。
如果所有任务都丢给服务器主 CPU 管理,频繁的底层控制会抬高软硬件之间的交互开销。用固定状态机倒是能降一点控制延迟,可一旦遇到新算法、新数据格式或功能改动,灵活性就捉襟见肘。
SiFive 的做法,是在专用加速器旁边放一颗 RISC-V 控制核心。
这颗 CPU 负责任务调度、指令下发、资源管理,以及一部分数据预处理和后处理;加速器则专注矩阵运算这类固定计算任务。
这种分工并不是 SiFive 第一个提出来。它真正的实现价值,在于怎么让控制核心低延迟地访问加速器,同时避免大量数据都挤在普通寄存器控制路径上。
02|SSCI:让控制指令直接进入加速器
在常见 SoC 设计里,CPU 可以通过内存映射寄存器来配置加速器:处理器发起总线访问,写入控制寄存器,加速器再依据寄存器状态启动。这套方式成熟、通用,但对频繁发生的细粒度操作来说,控制路径偏长。
SiFive 的 SSCI(Scalar Coprocessor Interface,标量协处理器接口)给出了另一条路。它直接挂在 RISC-V 核心的标量执行流水线上,允许处理器通过自定义指令与专用加速器交互。加速器可以拿到相关操作数,并把结果返回给处理器。比如控制核心用一条自定义指令就能触发专用运算,不用把每次操作都翻译成普通外设寄存器访问。
SSCI 还复用 CPU 现有的指令译码、寄存器访问和流水线控制机制,减少了专用逻辑里需要重复实现的部分。
这条接口主要解决低延迟控制和紧耦合运算,并不负责向大型计算阵列持续搬运全部输入数据。
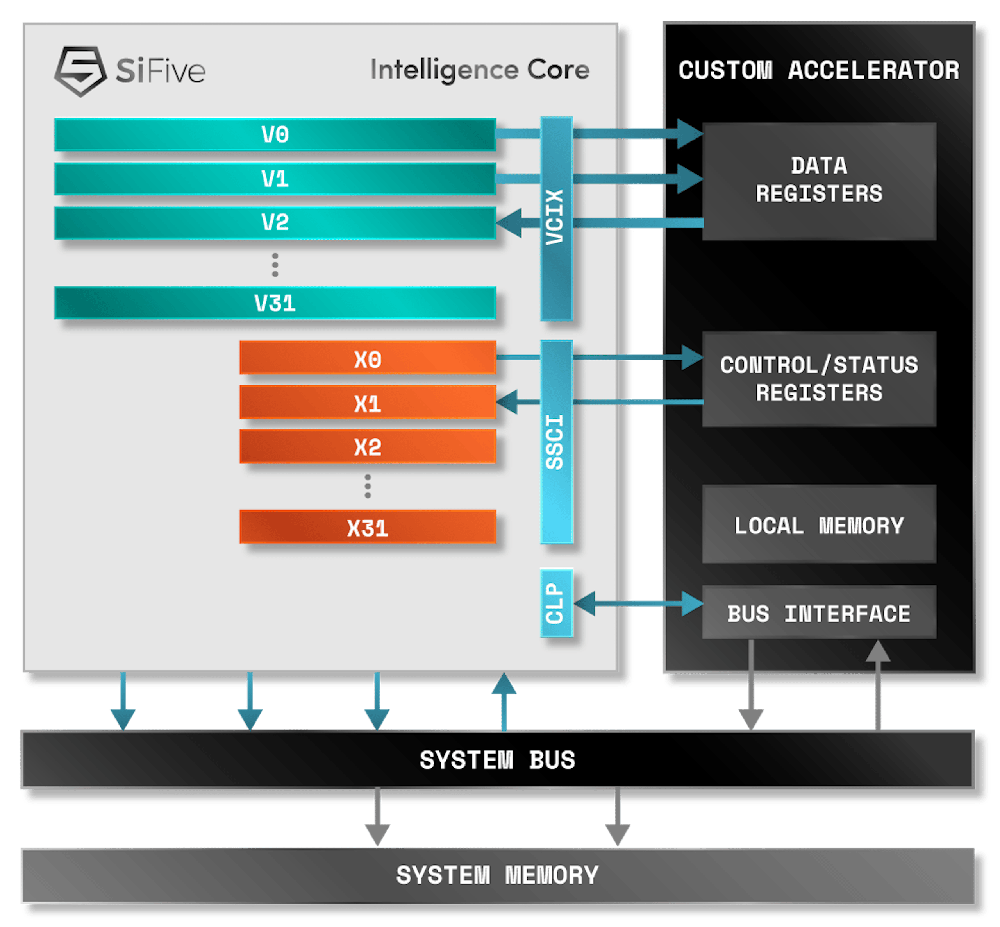
向量寄存器(V0–V31)与标量寄存器(X0–X31)分别经 VCIX、SSCI 连接加速器的数据寄存器与控制状态寄存器,CLP 直达本地存储(来源:SiFive官方博客,2026年10月)
03|VCIX:给专用计算引擎提供宽数据接口
控制指令可以很短,但 AI 计算的数据量往往很大。
如果加速器要频繁读取向量操作数,光靠标量寄存器或控制总线显然不够。
SiFive 的 VCIX(Vector Coprocessor Interface,向量协处理器接口)直接把处理器的向量寄存器体系接出去,让外部专用加速器能按向量指令格式取操作数,执行自定义向量运算。
SiFive 第二代 Intelligence 系列提供了不同宽度的接口配置:
| 处理器系列 |
向量寄存器长度 |
VCIX接口宽度 |
| X100 |
128 bit |
依具体配置 |
| X200 |
512 bit |
1024 bit |
| X300 |
1024 bit |
2048 bit |
这样一来,芯片设计者就可以按加速器的数据需求,选择不同等级的控制核心。
例如计算引擎要处理向量数据时,可以通过 VCIX 与处理器的向量执行体系交互,没必要把每次向量操作拆成一大堆标量控制指令。
不过要注意,VCIX 的接口宽度不能直接等同于加速器的持续供数带宽。数据依然要从内存进到向量寄存器,实际吞吐受处理器访存能力、指令调度和加速器接收能力共同限制。
对于大型张量搬运,系统仍可能使用 DMA 或独立的内存访问路径。
04|CLP:让控制核心直接访问本地存储
除了指令控制和向量数据交互,SiFive 还提供了 Core Local Port(CLP)。它让控制核心能访问本地或客户自定义的 RAM,部分访问可以绕过 L2 缓存层级。
这对需要频繁处理局部数据的加速器很有价值。比如控制核心可能要读取加速器本地存储里的参数,做数据格式调整,或处理部分辅助计算。
如果这些数据已经在加速器附近的 SRAM 里,再走一遍长长的缓存路径,只会增加不必要的延迟。
CLP 提供了更直接的本地存储访问路径,但架构设计者也需要明确本地数据怎么管理,以及它和系统其他存储空间之间如何同步。
把三种接口放到一起看,SiFive 实际上是把不同任务拆开了:SSCI 负责低延迟指令交互,VCIX 负责和向量执行体系做宽数据交互,CLP 负责访问本地存储。
三者与系统内存接口、DMA 配合,形成完整的加速器控制和数据处理路径。
05|控制核心应该选多大的RISC-V
并非所有加速器都需要同样复杂的控制 CPU。SiFive 的 X100 系列更适合以指令控制为主的场景:它可以通过 SSCI 管理专用硬件,并用片上紧耦合存储跑较轻量的控制软件。
X200 和 X300 系列则提供更宽的向量执行能力,适合要处理较多数据、执行辅助向量运算,或者承担更复杂软件任务的加速器。
这个选择牵扯到三个实际问题:控制指令有多频繁?需要经过控制核心的数据比例有多高?加速器之外还有多少辅助计算要跑?
如果控制任务很简单,上大型向量 CPU 只会增加面积和功耗;但要是控制核心还要执行 Softmax、激活函数或数据格式转换,较强的向量能力反而能减轻专用硬件的设计负担。
SiFive 披露,已有半导体客户授权 X100 用于工业边缘 AI 加速器控制,X200 系列也有数据中心应用案例。
06|这套设计给SoC架构带来了什么
SiFive 的 ACU 方案,本质上是专用加速器设计中的一种取舍。
固定硬件适合处理高吞吐、重复性强的计算;可编程 CPU 适合处理任务组织、状态判断和不断变化的辅助操作。两者通过紧耦合接口协作,能减少部分操作对主 CPU 和通用控制总线的依赖。
对 SoC工程师 来说,值得借鉴的是它对控制路径、向量数据路径和本地存储路径的拆分方式。
当一颗芯片集成的专用计算单元越来越多,除了优化计算阵列本身,还要考虑谁来组织计算,以及控制器该用怎样的接口与硬件协作。
这类围绕加速器控制路径与 SoC 架构的讨论,在云栈社区也有不少开发者持续关注。
 发表于 昨天 22:09
|
查看: 1|
回复: 0
 /1


