10月23日,一项来自博洛尼亚大学等机构的研究,将国产算能SG2044、NVIDIA Grace和Intel Xeon放进同一套测试体系,比较了科学计算、内存带宽以及大模型推理性能。
结果显示,在部分高性能计算负载中,国产RISC-V与成熟的Arm、x86服务器平台之间仍有约8~15倍的绝对性能差距。但到了大模型解码环节,SG2044的64核吞吐量却超过了参测的Intel平台,能效表现同样亮眼。
同样是服务器CPU,为什么科学计算差距明显,换到大模型解码就翻盘了?答案藏在向量执行单元、内存系统和多核资源组织这几个关键点里。
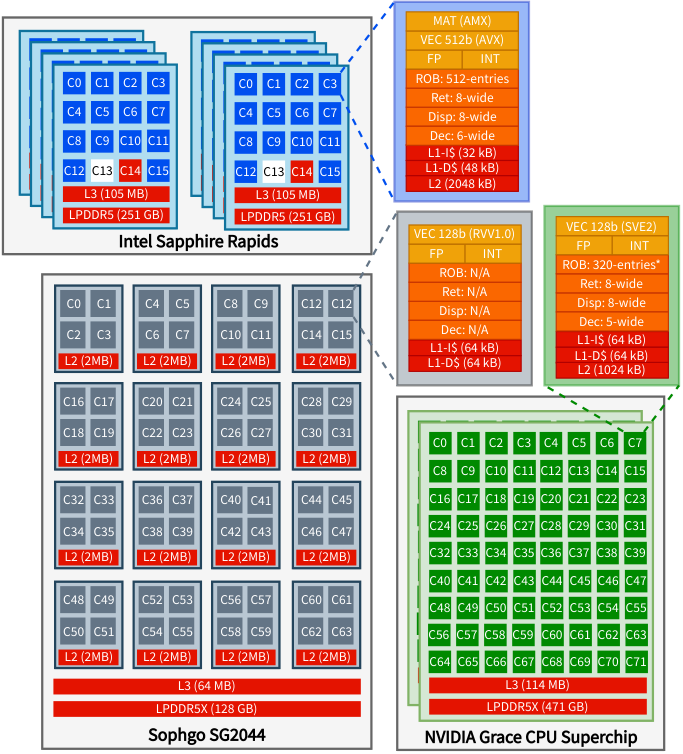
三款参测服务器处理器的架构对比(Intel Xeon、算能SG2044、NVIDIA Grace),展示核心组织、缓存层级与内存系统。来源:arXiv 2610.32632 论文 Figure 1
01|64核RISC-V,架构走到哪一步了?
SG2044内部集成64个玄铁C920V3核心,基于12nm工艺制造,最高频率2.6GHz。每个核心采用12级乱序流水线、4发射设计,并支持RVV 1.0向量扩展。64个核心被组织成16个集群,每组4个核心共享2MB L2 Cache,所有核心再共享64MB L3 Cache。
这样的设计让SG2044具备了完整的多核服务器处理器架构,但与NVIDIA Grace相比,资源配置的差异还是能一眼看出。
Grace采用Arm Neoverse V2核心,测试平台包含两颗72核处理器,共144核。每个核心拥有独立的1MB L2 Cache,每颗处理器还配备114MB共享L3 Cache,并通过NVLink-C2C连接。
两者的缓存组织方式截然不同——SG2044让四个核心共享一组L2,Grace则为每个核心配置独立L2。前者能在集群内部共享缓存资源,后者减少了不同核心之间的L2容量竞争。两种设计各有取舍,但当大量核心同时执行任务时,缓存组织方式会直接影响数据访问效率。
02|为什么浮点计算与Arm差距明显?
在HPL这类计算密集型测试中,SG2044与Grace仍有较大性能差距。
其中一个重要原因是向量执行资源。SG2044的C920V3核心采用128位向量执行资源,而Grace的Neoverse V2核心支持128位SVE2,并配置了多条向量执行流水线。
这里很容易产生一个误解:既然两者都用128位向量,为什么性能还会差这么多?因为向量宽度只是其中一个因素。决定浮点吞吐量的,还有执行流水线数量、每周期能发射多少条指令,以及数据能否持续喂饱计算单元。
论文列出的Grace核心配置具备更强的向量执行能力,再加上更先进的4N工艺、更高的运行频率,以及成熟的软件优化,共同构成性能优势。
SG2044的64核FP64性能达到294 GFLOP/s,单核约8.02 GFLOP/s。相比之下,Grace在多项计算密集型负载中的优势相当明显。
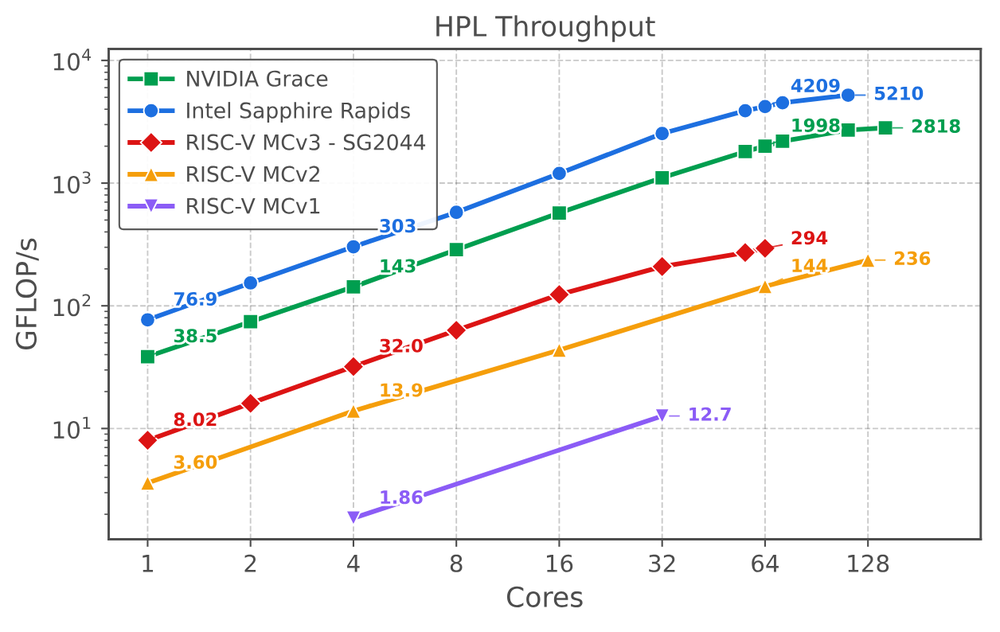
HPL(FP64)性能随核心数量的扩展对比,SG2044单核8.02 GFLOP/s、64核294 GFLOP/s,与Intel、Grace同图对照。来源:arXiv 2610.32632 论文 Figure 4(a)
这说明,RISC-V要真正进入高性能计算市场,仅靠堆核心数量远远不够。单核执行吞吐量、向量计算能力和内存系统需要同步跟上。
03|同样的核心增长,内存表现为何差异巨大?
SG2044的STREAM内存带宽测试同样值得关注。单核运行时为7.8 GB/s,扩展到64核后,持续带宽达到约107 GB/s。
研究团队还发现,任务分配方式对SG2044的性能影响显著。如果按核心编号连续分配任务,多个进程可能集中在少数L2集群中,提前触发缓存资源竞争。将任务分散到16个L2集群之后,在部分16核测试配置下,带宽能提升至原来的约两倍。
这项优化没有改动处理器硬件,只调整了进程与核心之间的对应关系。
Grace面对的问题不同。它采用双Die NUMA架构,两颗处理器分别连接自己的内存资源。研究团队发现,让任务在两个NUMA节点之间分布,能够更充分地利用系统总内存带宽。
SG2044需要避免局部L2集群过早饱和,Grace则需要合理利用两个NUMA节点的内存资源。
两者指向同一个结论:多核处理器的性能不只取决于硬件资源总量,也取决于软件是否真正理解这些资源的物理组织方式。
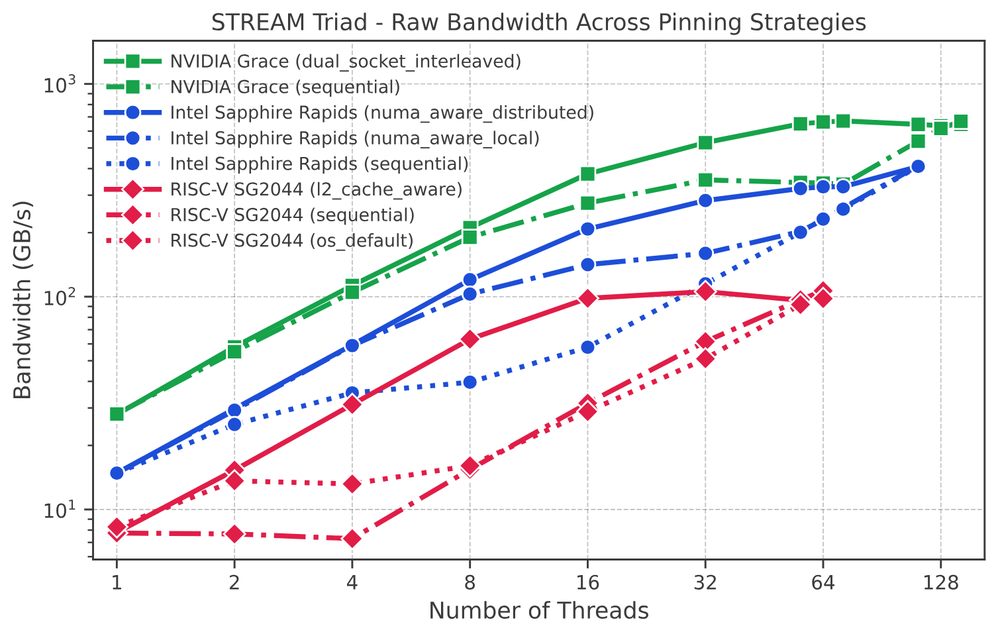
STREAM Triad在不同核心绑定策略下的带宽对比,SG2044采用L2缓存感知分配后带宽明显优于连续分配。来源:arXiv 2610.32632 论文 Figure 3(a)
04|大模型解码:吞吐量不敌Arm,能效反而更高
这次研究中,SG2044最亮眼的表现来自llama.cpp大模型推理测试。在64核配置下,SG2044的解码吞吐量达到17.4 token/s,超过了参测Intel Xeon的14.0 token/s。
不过Arm平台仍然保有明显的绝对性能优势。NVIDIA Grace在相应测试中的解码吞吐量约50.9 token/s,接近SG2044的三倍。
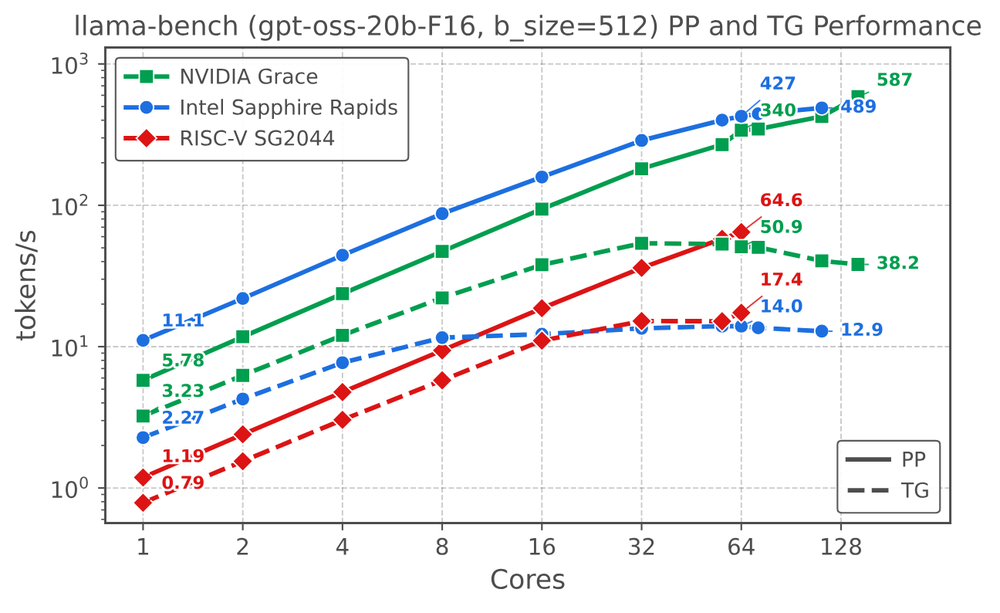
llama-bench(gpt-oss-20b-F16)Prefill与Decode吞吐量随核心数量的变化,64核SG2044解码17.4 token/s,超过Intel的14.0 token/s。来源:arXiv 2610.32632 论文 Figure 10(a)
如果换到能效维度,结论又变了。SG2044的解码能效达到0.209 token/J,Grace为0.159 token/J,Intel平台只有0.017 token/J。
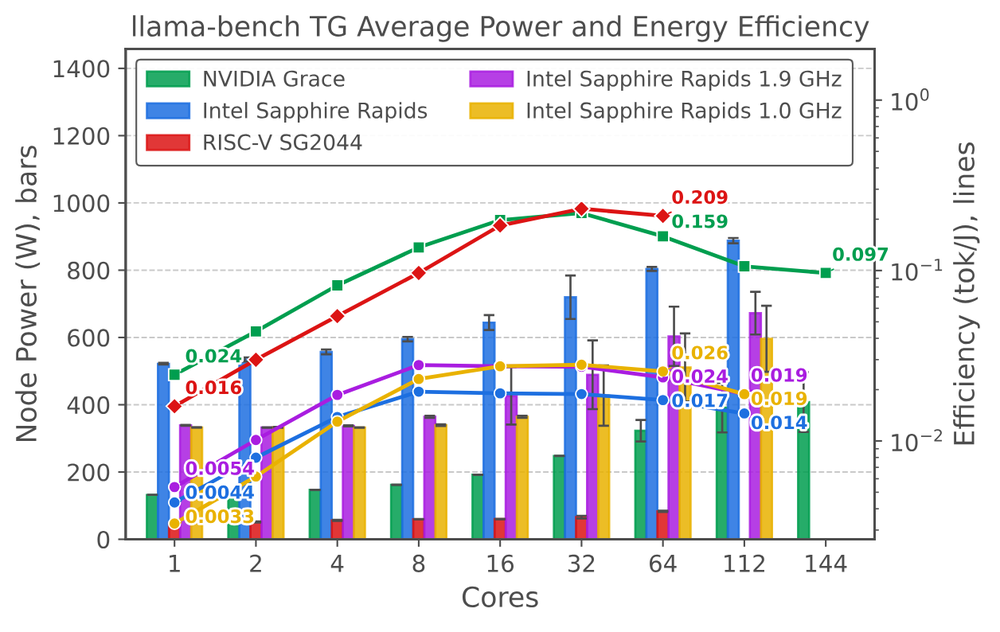
llama-bench解码阶段的整机功耗与能效对比,SG2044能效0.209 tok/J,高于Grace的0.159与Intel的0.017。来源:arXiv 2610.32632 论文 Figure 11(h)
也就是说,在本文采用的测试条件下,SG2044虽然没有达到Grace的绝对解码吞吐量,却能以更低的能耗完成Token生成。这种差异与大模型推理的负载特征有关。
Prefill阶段需要处理整个输入序列,计算并行度很高;Decode则是逐步生成Token,对内存访问和数据复用有不同要求。所以,一颗CPU在传统浮点计算中领先,并不意味着它在所有AI推理任务中都能获得同比例优势。
对RISC-V来说,这组结果也说明:随着软件适配和多核调度持续优化,现有处理器架构仍然有值得挖掘的应用空间。
05|国产RISC-V的下一课
从这次测试可以看到,SG2044已经能够运行完整的科学计算和大模型推理工作负载,在多核扩展与部分任务能效方面取得了实际进展。
但与NVIDIA Grace这样的成熟Arm服务器平台相比,单核计算能力、向量执行吞吐量以及整机内存系统仍是需要持续补强的方向。这也解释了为什么高性能CPU设计不能只追求更多核心。
增加向量执行单元,可以提高理论计算吞吐量,但需要更强的数据供应能力;扩大缓存容量,可以改善数据复用,但也得考虑访问延迟与面积成本;增加核心数量,则会进一步提高共享缓存和内存接口的负载。资源之间必须保持平衡。
SG2044还有一个值得关注的特点:采用统一内存访问架构,减少了多NUMA节点之间的数据放置复杂性。但UMA并不能消除共享缓存和主存带宽的竞争。
从64核SG2044到144核Grace,真正决定服务器CPU性能的,始终是计算、缓存、互连与内存系统能否协同工作。
国产RISC-V已经走到了能够通过真实应用与成熟服务器平台正面对比的阶段。此次测试既展示了多核扩展和部分推理任务中的竞争力,也让下一代处理器的改进方向更加清晰。
 发表于 昨天 22:33
|
查看: 4|
回复: 0
 /1


