空调外机的主控板,十几年都是 Cortex-M0 和 M3 的地盘,跑查表,跑 PID。这两年板子上开始出现 NPU,有的还带 DDR。国芯科技 2024 年 7 月底推出的 CCR4001S 是个能逐条查证的样本:自研 RISC-V 核 CRV4H,230MHz,片上挂一颗 0.3 TOPS 的 NPU,封装里合了 8 到 32MB DDR。公司在 2026 年 8 月的半年度评估公告里写,这颗芯片在智能商用空调上累计出货超过 10 万颗。看配置单,它不太像一颗 MCU。
一、规格先摆上桌
| 项目 |
参数 |
| 内核 |
自研 RISC-V CRV4H,RV32IMCB,扩展 DSP 与 SIMD 指令,230MHz |
| 核性能 |
Dhrystone 2.67 DMIPS/MHz,CoreMark 2.42 CoreMark/MHz |
| 缓存 |
32KB ICache + 32KB DCache |
| 片上 SRAM |
256KB |
| 合封存储 |
8 / 16 / 32MB DDR,另加 SIP Flash |
| NPU |
0.3 TOPS @INT8,含卷积、池化、激活算子 |
| 支持网络 |
MobileNet、ResNet、VGG、EfficientNet、YOLO |
| 视觉接口 |
MIPI CSI、DVP |
| 通信与控制 |
USB 2.0 host/device、CAN、UART、SPI、SSI、I2C、I2S、PWM、PWMT |
| 模拟 |
12 位 ADC、12 位 DAC、ACMP |
| 温度 |
官网只写“按工业级设计和生产”,未给区间 |
| 价格 |
未公开 |
表注:规格取自国芯科技官网新闻稿、国泰君安 2024 年半年度持续督导跟踪报告,以及爱集微 2025 年 9 月研讨会报道。
前五行看下来,这是一颗中规中矩的国产 RISC-V MCU 加强版。230MHz 的核,256KB SRAM,接口也齐全,国内同档产品不少。打破平衡的是合封 DDR 那一行:一颗 MCU 往封装里塞 8 到 32MB DDR,这不是 MCU 的做法。
二、0.3 TOPS 这笔账
0.3 TOPS 就是 300 GOPS。除以 230MHz,平均每个时钟周期 1304 次运算。把一次乘加算作两次运算,相当于 652 个 MAC 并行。
这个量级放进 MCU 不常见。拿上一篇拆过的 TI MSPM0G5187 做参照:TinyEngine 标 2.56 GOPS @80MHz,折下来每周期 32 次运算,16 个 MAC。国芯这颗按同样算法,每周期吞吐是它的 40 倍。
两种解释都能讲通。一种是 NPU 有独立时钟域,跑得比 CPU 高;另一种是阵列本身就做得大。国芯的公开材料里没写 NPU 的 MAC 阵列规模,也没写它挂在哪条总线上,只说了“集成卷积、池化、激活等多种硬件加速算子”。
所以这个数只能当峰值看。峰值的意思是阵列满负荷、数据不断供。工程上真正要问的是另外一句:一帧多少毫秒。国芯没有公布这个数。
三、模型放在哪,才是分水岭
普通 MCU 做 AI 的办法是省。权重压到 4 位、2 位,模型往片上 SRAM 里塞,塞不下就剪枝。TI 就是这么干的,32KB SRAM 摆在那儿,天花板看得见。
国芯选了另一条路:把 DDR 合进封装,当 NPU 的“显存”用。这个说法出自国芯技术经理孙磊在 2025 年 9 月端侧 AI 芯片研讨会上的介绍,原话是“芯片集成 DDR 和 SIP FLASH 作为 NPU 的显存,不同规模的 AI 模型可直接在 DDR 中运行并由 NPU 调用”。
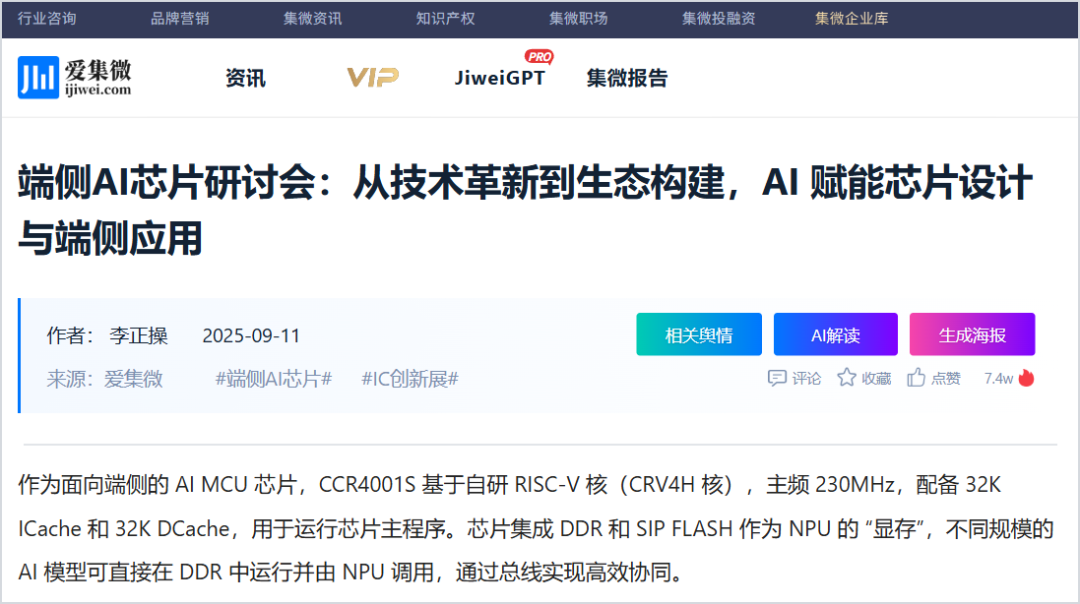
图 1:爱集微 2025-09-11 报道原文,页面下方段落即本文引用那句。来源:ijiwei.com/n/958591
按 int8 权重粗算容量:
- YOLOv5n,约 187 万参数,1.9MB
- YOLOv8n,约 320 万参数,3.2MB
- MobileNetV2,约 350 万参数,3.5MB
- YOLOv5s,约 720 万参数,7.2MB
- ResNet18,约 1170 万参数,11.7MB
256KB SRAM 一个都装不下。8MB 那档能把前四个装进去,ResNet18 得往 16MB 那档配。32MB 版留给 YOLOv5s 这个量级,还要扣掉激活值和中间缓冲。
这就是这颗芯片能跑 YOLO 的第一因。不是 0.3 TOPS,是 8MB。
代价也在这一行。DDR 要刷新,要供电,要占封装面积,BOM 和功耗都比纯 SRAM 方案高一截。麻烦的是国芯没有公布 DDR 位宽与速率。NPU 每做一次卷积,权重都要从 DDR 搬进片上缓存,搬得动搬不动,就看这两个没公开的数。
还有一个旁证能说明这颗 NPU 的定位。国芯另一颗芯片 CCR7002 用的是多芯片封装,主系统是 64 位四核 RISC-V,跑到 1.5GHz,旁边那颗 AI 子系统给的还是 0.3 TOPS。同一档算力,既可以配 230MHz 的 MCU,也可以配 1.5GHz 的四核 SoC。在这家公司的设计里,0.3 TOPS 不是一个性能指标,是一块可以反复贴的积木。
四、输入有多大,算力才够不够
回到空调那件事。国芯官网的说法是,CCR4001S 结合热电堆传感器和 YOLO 目标检测模型,做人体空间位置探测和空调风向控制。合作方美电科技主攻低分辨率红外阵列。
这句话给了答案的一部分。热电堆阵列不是 640×640 的摄像头,像素数在几百到几千这个量级,送进网络之前通常还要插值到很小的尺寸。假设一路输入从 640×640 降到 96×96,像素数差 44 倍,卷积计算量按面积走,也差 44 倍。同样的网络结构,算力需求直接掉到原来的四十多分之一。
一维信号更省。拉弧检测这类活,1024 点 FFT 出来 128 个特征,int8 输入就是 1KB。上一篇里 TI 那个电弧检测例子,输入正好也是这个规模。国芯这颗芯片在电力拉弧检测上也已部署验证,场景是同一个,输入维度也在一个量级。
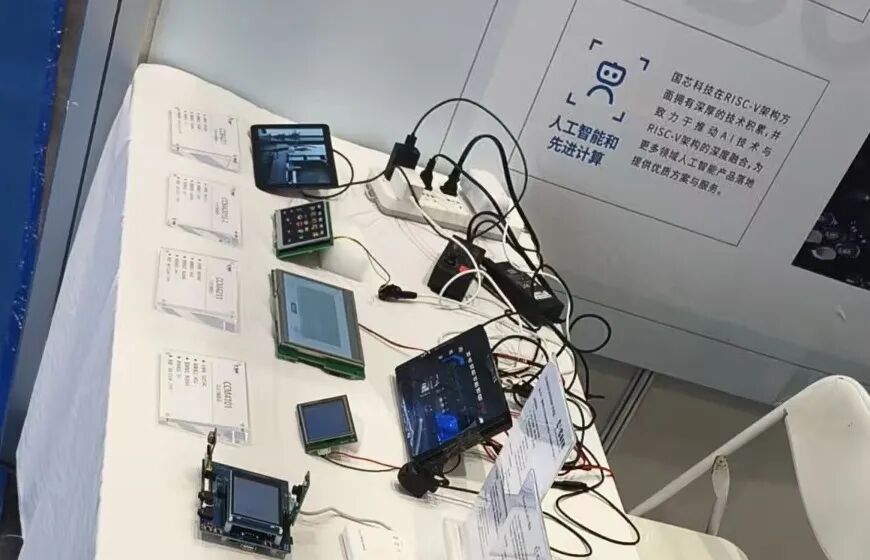
图 2:国芯 2025 CICE 展台演示区,桌上为生态伙伴方案板。来源:china-core.com/News_show-200-88.html
到这里,0.3 TOPS 够不够用就有答案了。跑一维波形和低分辨率热成像,够用;跑 640×640 的 RGB 检测,不够。判断依据不是 TOPS 的数字,是输入张量多大。
五、四条路线,四种代价
| 项目 |
国芯 CCR4001S |
海思 Hi3066M |
乐鑫 ESP32-S3 |
TI MSPM0G5187 |
| 内核 |
RISC-V CRV4H 230MHz |
RISC-V 200MHz,带 FPU |
双核 Xtensa LX7 240MHz |
Cortex-M0+ 80MHz |
| AI 单元 |
NPU,0.3 TOPS@INT8 |
eAI 引擎,未标 TOPS |
向量指令,无 NPU |
TinyEngine,2.56 GOPS |
| 片上 SRAM |
256KB |
64KB |
512KB |
32KB |
| 模型放哪 |
合封 DDR 8/16/32MB |
内置 Flash 512KB |
外挂 Octal PSRAM |
片上 SRAM,权重压到 2 位 |
| 外设侧重 |
MIPI CSI、DVP、USB |
18 路 HRPWM、3 路 3MSPS ADC |
Wi-Fi 与 BLE |
4 路 UNICOMM、USB 全速 |
| 价格 |
未公开 |
未公开 |
按型号配置 |
0.97 美元 @1k |
表注:海思数据取自海思官网 Hi3066M 产品页,乐鑫取自 Espressif 官网 ESP32-S3 页面,TI 取自 ti.com 产品页与数据手册。国芯未公开报价。
这张表最值得看的不是算力行,是空着的格子。四家里只有国芯和 TI 给了 TOPS 或 GOPS。海思写“eAI 引擎”,乐鑫写“向量指令”,两家都没给数字。口径不统一,横向比算力没有意义。
外设那一行反而更能说明各家对场景的判断。海思给 18 路 800ps 的 HRPWM、3 路 3MSPS 的 ADC、23 个通道,这是给电机控制留的位置,AI 是附加项。国芯给 MIPI CSI 和 DVP,是按视觉留的口子,哪怕这颗核只有 230MHz。乐鑫把 Wi-Fi 和 BLE 做进同一颗片子,赌的是联网节点。TI 用 2 位权重和 1.5μA 待机,赌的是纽扣电池。
四条路线没有优劣,只有代价不同。国产这两颗,一颗往芯片里加内存,一颗往控制里加算力,方向正好相反。
六、还差哪些数
写到这里,能查的差不多了,查不到的也得说清楚。
一是 NPU 的 MAC 阵列规模和时钟,这决定了 0.3 TOPS 是峰值还是能持续跑到。二是 DDR 位宽与速率,这决定了 NPU 的实际利用率。三是工作温度区间,官网只说按工业级设计和生产。四是实测帧率,这一项最要命,目前没有公开数据。
前三个还能量,第四个只能自己跑。所以这类芯片的选型,参数表不够用,得让 FAE 拿你的模型、你的数据跑一遍,量单帧耗时和功耗。0.3 TOPS 是宣传口径,毫秒数才是工程口径。
顺带说一句这条线的走向。国芯 2026 年公布的车规芯片 CCRC4XXX 系列已完成内部测试,走的是 22nm RRAM 工艺加 RISC-V 锁步多核,带硬件级抗量子能力,官方定位是 L3 及以上自动驾驶的域控场景,NPU 从家电挪到了车上。同一套 CPU 加 NPU 的组合,产品线从白电一路铺到车规。
空调那块板子上的变化,说到底是被场景推着走的。压缩机不会因为算力涨了就变聪明,是能耗指标和舒适度指标压下来,才逼着主控从查表换成模型。这条路国产芯片走了两年,走到十万颗,量产这一关算是过了。
你在项目里用过这类端侧 AI MCU 吗?跑的是什么模型,量化之后掉点严重不严重,实测一帧多少毫秒。这类芯片的参数表只是起点,真实的帧率、功耗和量化损失,欢迎到云栈社区和同行一起聊聊,靠实测数据把选型这件事做实。
(本文数据均来自公开披露与厂商官网,不构成投资建议。)
 发表于 8 小时前
|
查看: 4|
回复: 0
 /1


