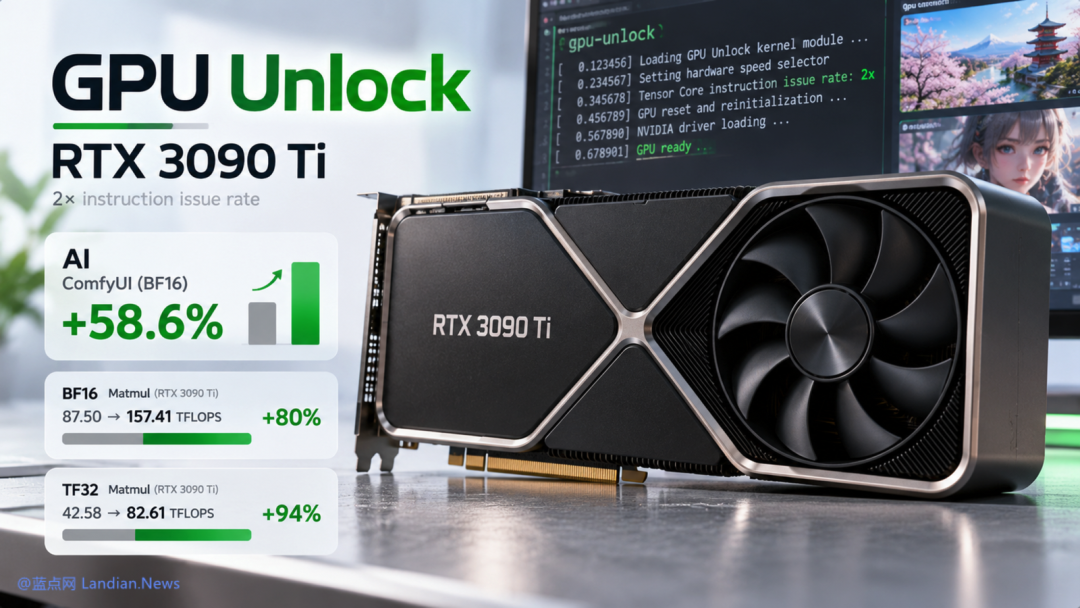
开发者 @Zagitta 日前在 GitHub 上发布了 开源项目 GPU Unlock,目标是释放部分英伟达安培架构显卡被“锁住”的算力。项目通过 Linux 内核模块,在英伟达驱动接管显卡之前调整硬件速度选择器,让特定 FP16/BF16 运算的指令发射速率翻倍。
GPU Unlock 项目介绍
GPU Unlock 面向 GA102/103/104/106 芯片,覆盖 RTX 3090、部分 RTX 3080/3070 以及 RTX 3060 显卡。项目提高的是 FP16 或 BF16 输入、FP32 累加的 FMA 运算指令发射速率,目标是达到专业卡的水平。
项目把内核模块和固件操作放在启动阶段,在英伟达驱动加载前修改 GPU 速度选择器并执行功能级复位,之后由未修改的英伟达驱动正常接管显卡。项目本身不修改驱动程序、不永久刷新显卡 VBIOS,启用时需要配置 Linux 内核启动参数。
基准测试中不同精度的提升差异很大
项目以功耗上限 450W 的 RTX 3090 Ti 显卡进行 8192³ 稠密矩阵乘法测试,采用五次测试的中位数。其中 FP16 性能从 87.46 提升到 118.39 TFLOPS,性能增加约 35%;BF16 从 87.50 提升到 157.41 TFLOPS,性能增加约 80%;TF32 从 42.58 提升到 82.61 TFLOPS,性能增加约 94%。
有 RTX 3090 Ti 用户在 ComfyUI 中测试了图像和视频生成任务,MOSS-Image SFT、Qwen-Image 2.1 Turbo 和 Z-Image Turbo 的 BF16 吞吐量分别提升 58.6%、57.2% 和 56.1%;而 MOSS 的 INT8 测试只提升 0.3%,几乎可以忽略不计。
不同任务获得的性能提升也有所区别
GPU Unlock 所说的性能翻倍主要针对特定 Tensor Core 指令发射速率,矩阵乘法基准和部分 BF16 图像生成受益比较明显,但 INT8 任务、受显存带宽限制的 LLM 解码 等场景性能提升有限。
即便显卡型号在支持列表内,具体提升也会随芯片、功耗上限和工作负载存在区别。例如在测试中 RTX 3080 Ti 20GB 版完成解锁后,BF16 仍然维持原来的速率,并没有显著提升。
访问项目: https://github.com/Zagitta/gpu-unlock/blob/main/README.md
如果你对这类开源硬件项目带来的实际收益感兴趣,也可以在 云栈社区 找到更多关于 AI 推理加速的实践经验与讨论。 |  发表于 8 小时前
|
查看: 5|
回复: 0
 /1


