本文涉及的代码基于 Linux 4.1.15,为方便理解做了精简,只保留关键函数。内容主要来自阅读内核相关书籍后的总结。
整个进程的运行过程几乎都围绕着虚拟内存的分配与使用展开,可以分成三类:
- 程序加载阶段:把代码段、数据段映射到虚拟内存,并初始化栈区和堆区。
- 运行阶段:进程或线程调用函数时,依靠栈保存局部变量和调用链。
- 动态分配阶段:通过
new、malloc 等函数从堆中申请内存。
加载程序过程中对虚拟内存的使用
在底层实现上,无论是代码段、数据段,还是栈内存、堆内存,都对应一个个 vm_area_struct 对象。
关于 vm_area_struct 更细致的内容,可以参看上一篇《Linux内核学习之虚拟内存和物理内存》。
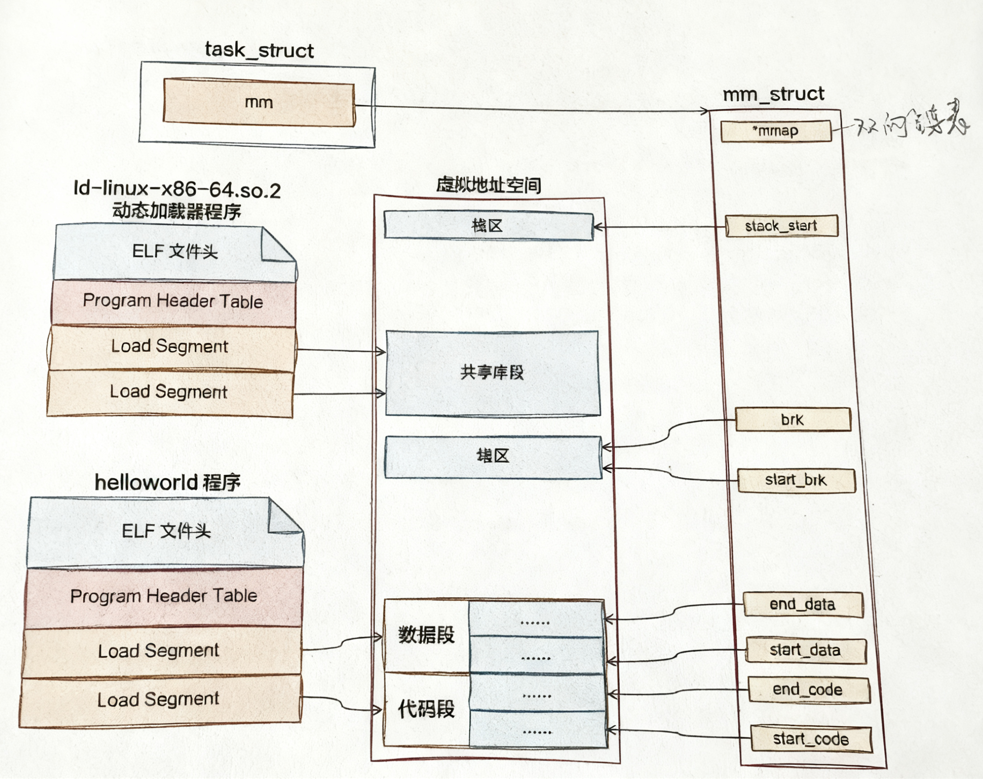
通过 cat /proc/pid/maps 可以查看某个进程地址空间的大致内容,其中每一项都是一个 vm_area_struct 的用户态视图。
mmap
调用 mmap 之后,内核会新申请一个 vm_area_struct,用来标记这段内存可用,然后返回给用户。 mmap系统调用可以用于文件映射和匿名映射,文件映射对应实际的物理文件,匿名映射则没有对应的物理文件。
sbrk 和 brk
sbrk 系统调用返回的是 mm_struct->brk 指针的当前值;brk 则尝试修改 mm_struct->brk 的值,调大就是扩展堆区,调小就是收缩堆区。
进程栈内存的使用
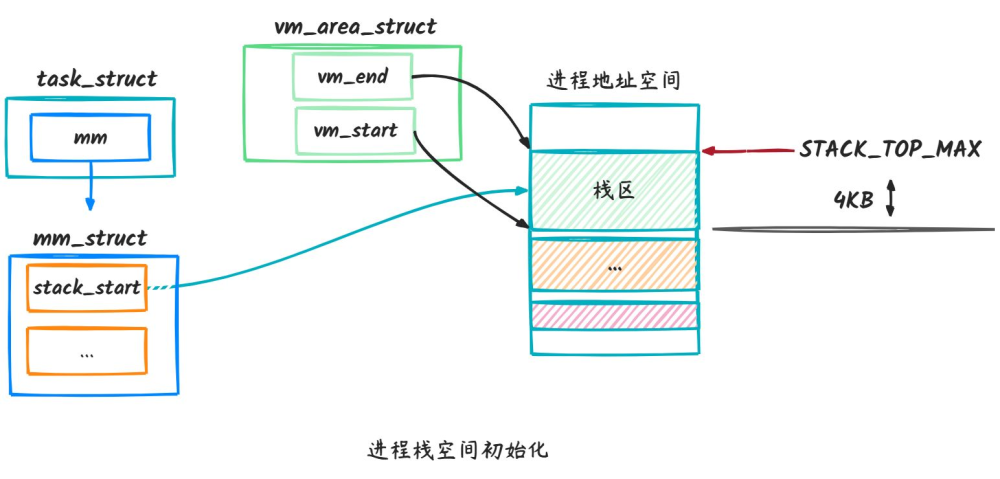
进程的栈内存其实同样是一个 vm_area_struct。
进程栈空间初始化
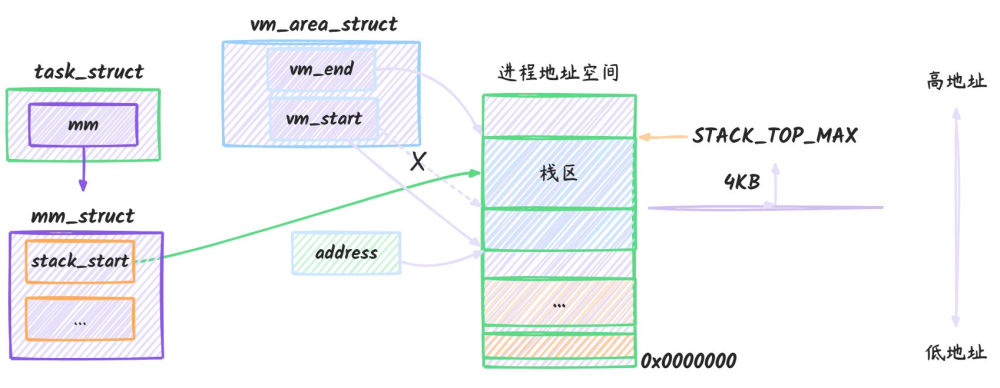
栈的自动增长
栈中保存的调用链和局部变量持续增多,超过初始分配的 4KB 时,_do_page_fault 会调用 expand_stack 对栈的虚拟空间进行扩充。
ulimit 命令可以查看栈空间大小限制,ulimit -s 10240 可以临时修改限制。长期修改则写到 /etc/security/limits.conf:
*soft stack 102400
相关代码逻辑如下:
int expand_stack(struct vm_area_struct *vma, unsigned long address)
{
    struct vm_area_struct *prev;

    address &= PAGE_MASK;
    prev = vma->vm_prev;
    if (prev && prev->vm_end == address) {
        if (!(prev->vm_flags & VM_GROWSDOWN))
            return -ENOMEM;
    }
    return expand_downwards(vma, address); // 向下扩展
}

/* 跳转进入 expand_downwards */
int expand_downwards(struct vm_area_struct *vma, unsigned long address)
{
    int error;
    ......
    // 计算栈扩充后的大小
    size = vma->vm_end - address;
    // 计算需要扩充几个页面
    grow = (vma->vm_start - address) >> PAGE_SHIFT;
    // 判断是否允许扩充 ulimit可以查看栈空间的大小限制
    error = acct_stack_growth(vma, size, grow);
    if (!error) {
        ......
            // 开始扩充
        vma->vm_start = address;
        ......
    }
    return error;
}
线程栈
Linux 线程创建分为两个层面:用户态 glibc 中实现线程栈;内核态由 clone 系统调用创建执行流。
glibc 中的 create_thread 会先申请用户栈内存,再把这块内存传给 clone。申请过程大致是:
- 先尝试
get_cached_stack 复用已有缓存栈;
- 没有缓存时,使用
mmap 申请一块匿名页内存;
- 将
pthread 对象先放到栈上;
- 把这个栈挂到链表中统一管理。
进程堆内存管理
程序运行时会大量申请和释放各种大小的对象,直接使用内核的 mmap、brk 并不现实:频繁的系统调用开销大,碎片率也很难控制。因此,应用开发者和内核之间需要一个用户态内存分配器,比如 glibc 中的 ptmalloc、Google 开发的 tcmalloc。
ptmalloc
分配区(arena)
ptmalloc 使用分配区来管理从操作系统批量申请到的内存。
static struct malloc_state main_arena;

struct malloc_state {
    // 锁
    mutex_t mutex;
    struct malloc_state *next;
};
内存块(chunk)
每个 arena 中最基本的分配单位是 malloc_chunk,由 header 和 body 两部分组成。
struct malloc_chunk {
    INTERNAL_SIZE_T prev_size;
    INTERNAL_SIZE_T size;

    struct malloc_chunk* fd;
    struct malloc_chunk* bk;

    struct malloc_chunk* fd_nextsize;
    struct malloc_chunk* bk_nextsize;
};
每次调用 malloc,都会分配一个大小合适的 chunk,并把 body 部分的 user data 地址返回给调用方。
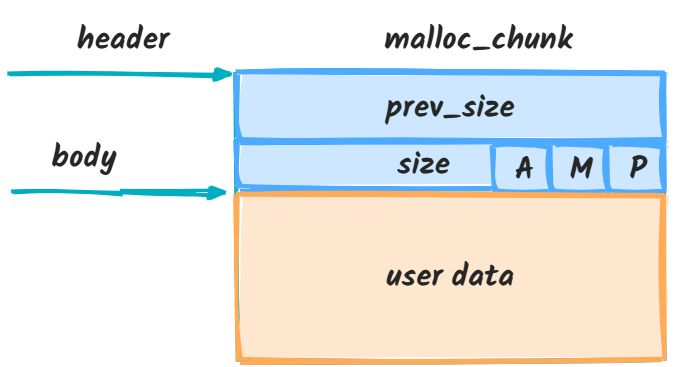
如果调用 free 释放内存,chunk 不会立刻归还内核,而是由 glibc 重新组织管理。空闲 chunk 的 body 区域中,fd、bk 字段会分别指向上一个和下一个空闲 chunk。
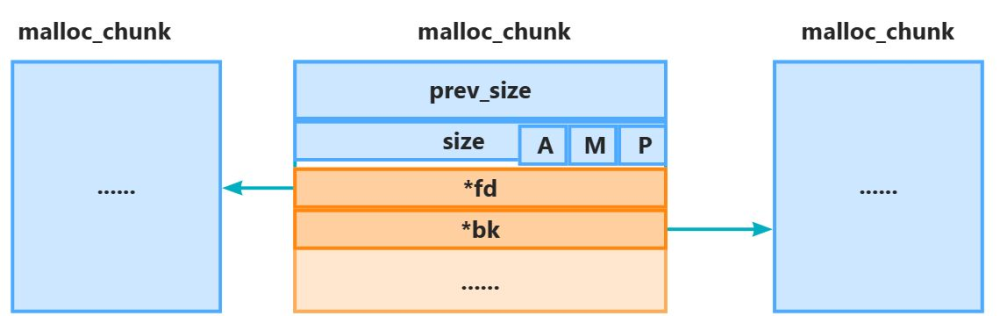
空闲内存块链表
glibc 会把大小相近的空闲 chunk 串起来,组成一个 bin。ptmalloc 中共有四类 bin:
fastbinssmallbinslargebinsunsortedbins
struct malloc_state {
    mfastinptr fastbins[NFASTBINS]; // 最小空闲内存块链表
    mchunkptr top; // TOP chunk;当所有空闲链表都申请不到时,会从这里申请
    mchunkptr last_remainder;
    /* bins
     * NBINS=128,这里一共有256个空闲链表,
     * smallbins、largebins、unsortedbins 都使用这个链表数组
     */
    mchunkptr bins[NBINS * 2];
    unsigned int binmap[BINMAPSIZE];
};
fastbins
每个 bin 链表管理的都是固定大小的 chunk。64 位系统下,各链表分别管理 32 字节、48 字节……128 字节等不同尺寸的 chunk。
glibc 提供 fastbin_index 函数,可以根据要申请的内存大小快速定位到 fastbins 中对应的下标。
#define fastbin_index(sz) \
((((unsigned int)(sz)) >> (SIZE_SZ == 8 ? 4 : 3)) - 2 )

// 32位系统中 SIZE_SZ=4;64位系统是 8
// fastbin_index(32) = 0
// fastbin_index(64) = 2; 因为 64 = 2^6,100000 >> 4 = 4,4 - 2 = 2
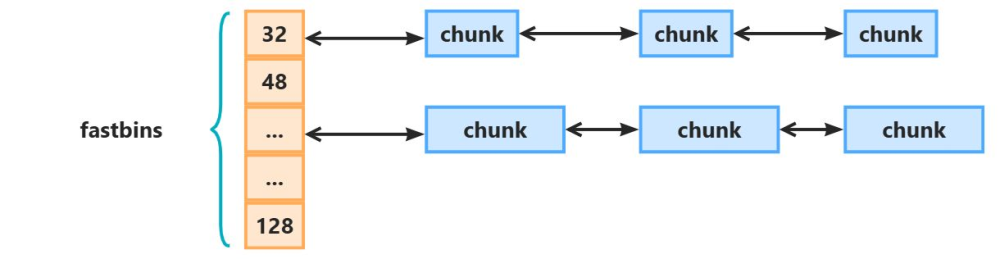
smallbins
smallbins 通过 malloc_state 的 bins 成员管理,总共有 64 个链表。和 fastbins 一样,同一个 smallbin 中的 chunk 大小一致。
largebins
largebins 与 smallbins 的差别在于它管理的内存块更大,从 1024 字节起步。相邻 largebin 之间的尺寸间隔不再是固定等差数列,这样可以减少链表数量。因此,同一个 bin 内的 chunk 大小可能不同,但会落在一定范围内。
unsortedbins
unsortedbins 中的 chunk 不像 smallbins、largebins 那样尺寸相同或相近,它管理的内存块大小不固定,更多时候被当作缓存使用。
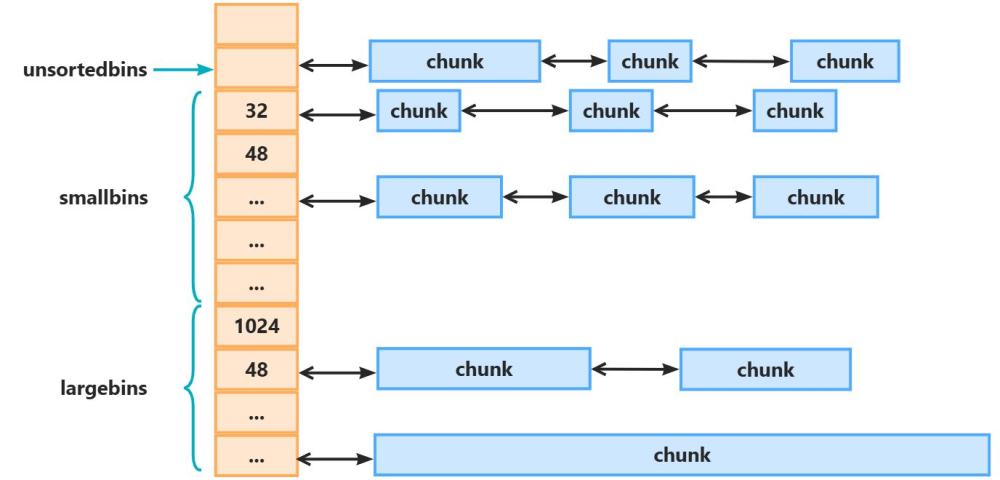
top chunk
top chunk 是独立于 fastbins、smallbins、largebins 和 unsortedbins 的特殊 chunk。当没有空闲 chunk 可用,或者需要分配的 chunk 大到各类 bins 都无法满足时,就会尝试从 top chunk 分配。
top chunk 的本质是堆空间末尾的一块连续空闲内存,不会加入任何 bin 链表,而是作为堆的边界块存在。它的主要作用有两个:
- 当其他 bin 没有足够大的空闲块满足申请请求时,直接从 top chunk 中切割内存;
- 当 top chunk 剩余空间不足时,通过
brk() 或 mmap() 向内核申请扩展堆空间,扩展后的新空间会合并到 top chunk 中。
malloc 的内存分配过程
从前面的梳理可以看出,glibc 在分配区 arena 中分别用 fastbins、bins(其中保存着 smallbins、largebins 和 unsortedbins)以及 top chunk 来管理已经申请到的空闲内存。这样,当用户申请内存时,malloc 就能根据请求大小去合适的 bin 中查找 chunk。
例如,申请 30 字节时,会到 32 字节的 bin 链表里摘下一个 chunk;申请 500 字节时,会到 512 字节的 bin 链表里取一个 chunk。用户释放内存时,glibc 再根据 chunk 的大小,把它放回合适的 bin 中,供后续申请复用。
ptmalloc 管理的 chunk 还可能发生拆分或合并:申请小块但没有完全匹配的 chunk 时,会把大块拆成多个小块;申请大块而系统中又存在大量小块时,则会合并小块,以降低碎片率。这样,不管如何申请和释放,都不会产生严重的碎片问题,这就是 glibc 内存分配器的核心思路。
当真正调用 malloc 时,会依照以下顺序逐级尝试:
- 请求字节数小于
fastbins 管理的最大块大小时,先从 fastbins 申请,成功即返回;
- 请求字节数小于
smallbins 管理的块大小时,从 smallbins 申请,成功即返回;
- 从
unsortedbins 中尝试申请;
- 从
largebins 中尝试申请;
- 如果前面都没成功,尝试从
top chunk 中分配;
- 最后仍不可用,则通过
mmap 等系统调用向操作系统申请内存。
这些步骤中,只要某一步成功,分配就立即返回,后续步骤不再执行。当 top chunk 也没有足够空间时,会调用 SYSMALLOc 向操作系统发起内存申请,SYSMALLOc 内部就是通过 mmap 等系统调用完成实际申请。
内核中虚拟内存、物理内存以及缺页中断的相关知识,可参考上一篇《Linux内核学习之虚拟内存和物理内存》。
更多系统编程主题,也可以到 云栈社区 继续查阅。
 发表于 1 小时前
|
查看: 6|
回复: 0


