在云栈社区的技术讨论中,文件系统演进一直是个热门话题。这个由小米工程师 Nanzhe Zhao 发起的 Patchset([PATCH v2 00/14] f2fs: support & optimize large folios for writable files)【1】正是 F2FS 文件系统演进过程中的关键一步。
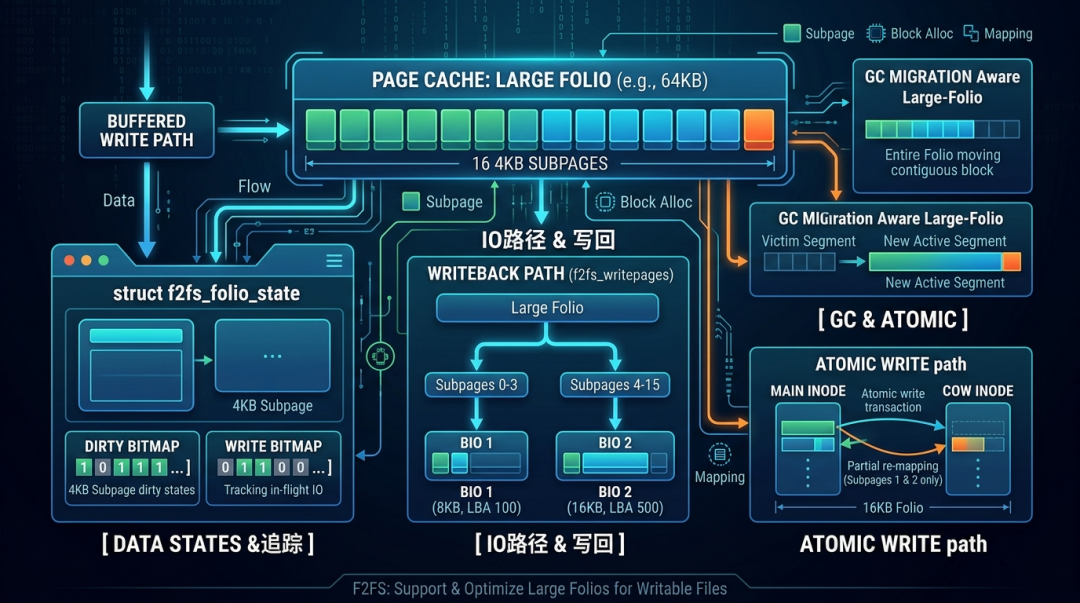
在此 Patchset 之前,F2FS 主要在只读路径支持 Large Folio(大页/多页连续内存块)。该补丁集全面打通并优化了 F2FS 在可写文件(Writable Files)Buffered I/O 路径下的 Large Folio 支持。
为了全面且深入地剖析这个 Patchset 的架构和代码实现,下面结合架构图、数据结构关系图、核心代码路径流程图,并深入到具体的函数及 patch 变更细节进行详细分析。
一、核心矛盾与架构设计演进
在引入这个 Patchset 之前,F2FS 的核心矛盾在于:内核 Page Cache 已经升级为以 Folio(支持多页连续内存,如 16KB/64KB)为单位管理,但 F2FS 内部的状态追踪和磁盘 allocation 依然严格依赖 4KB 子页(Subpage)。
1. 状态管理架构重构:从单页到大页子状态
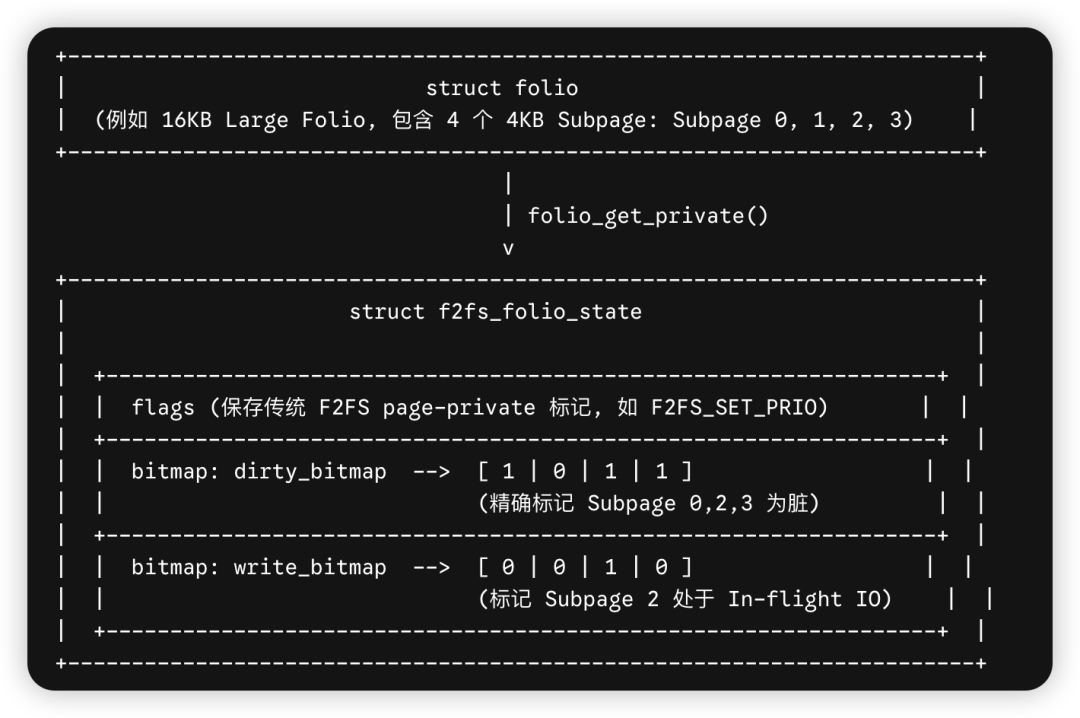
在传统 F2FS 中,page->private 用于存储单页的标志(如 F2FS_SET_PRIO 等)。但在 Large Folio 场景下,一个 Folio 包含多个 4KB 页面,如果继续只用单个标志位,就会丢失子页粒度的脏状态(Dirty Status)和写回状态(In-flight Write I/O)。
补丁 01/14 对 f2fs_folio_state 进行了大幅重构与扩展:
二、核心代码路径剖析与图解
Patchset 的主要工作集中在重构 Buffered Write(缓冲写)、Writeback(写回)、Partial Truncate(局部截断)、GC 这几大核心代码路径。
1. Buffered Write(缓冲写入路径)
关联 Patch: 03/14 f2fs: support regular file buffered writes on large folios
代码路径流程图:
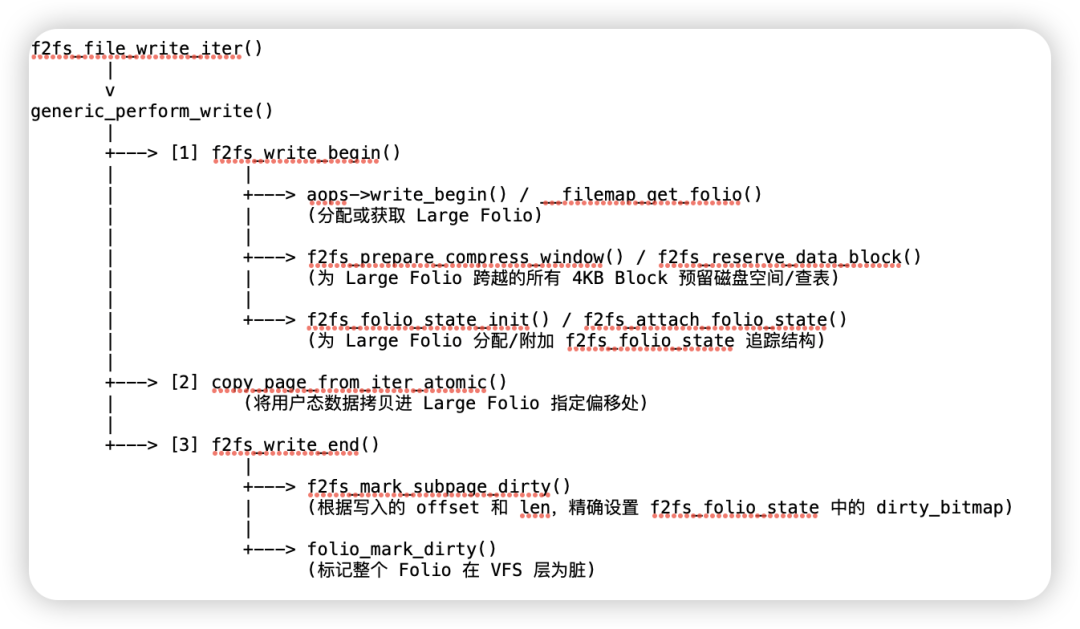
代码关键点深入:
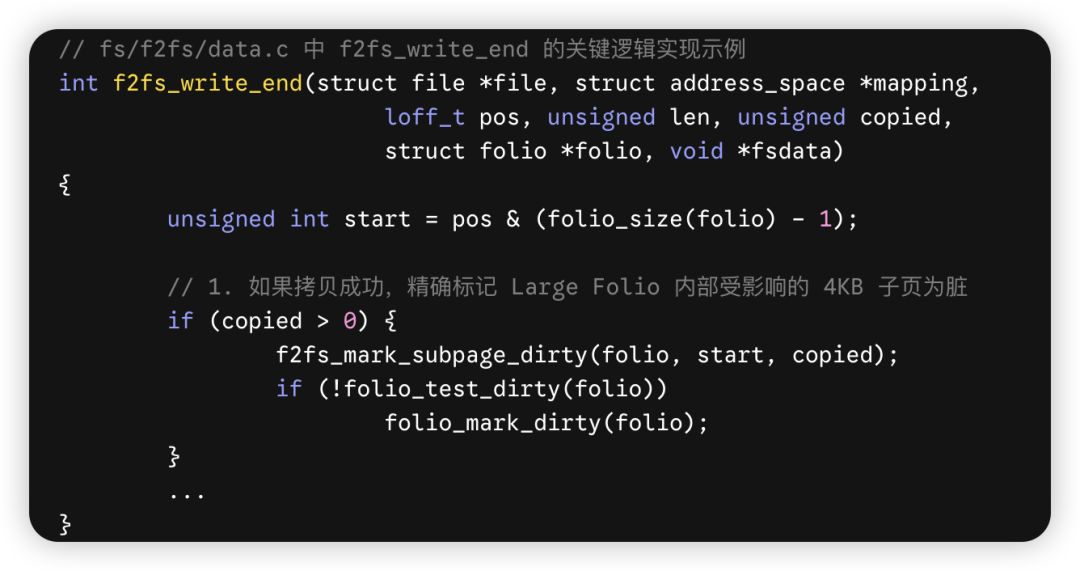
在 f2fs_write_end() 中,不能简单地标记整个 Folio 为脏,而是需要按子页粒度更新状态:
2. Writeback(写回/刷盘路径)
关联 Patch: 02/14 f2fs: carry subpage offset and count in write IO & 05/14 f2fs: support large folio writeback
当系统进行 Sync 或后台刷写(wb_work)时,Large Folio 需要被转换为多个 Bio 提交给块设备层:
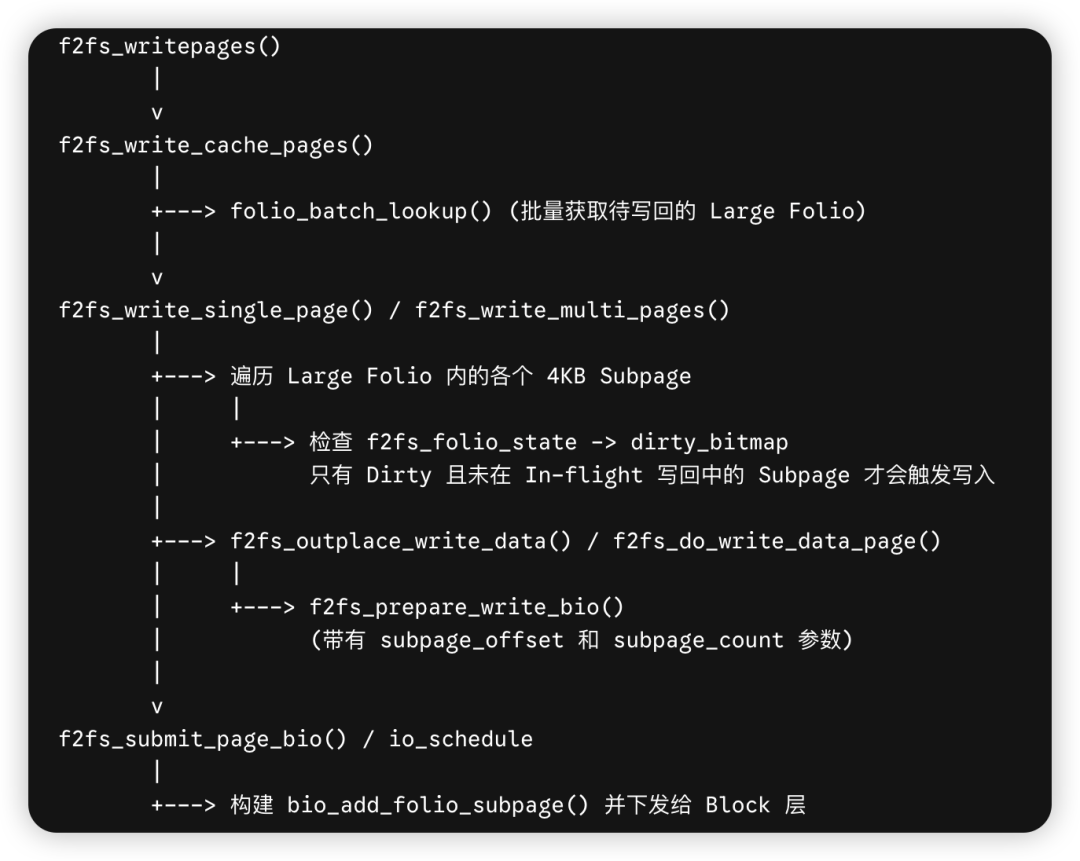
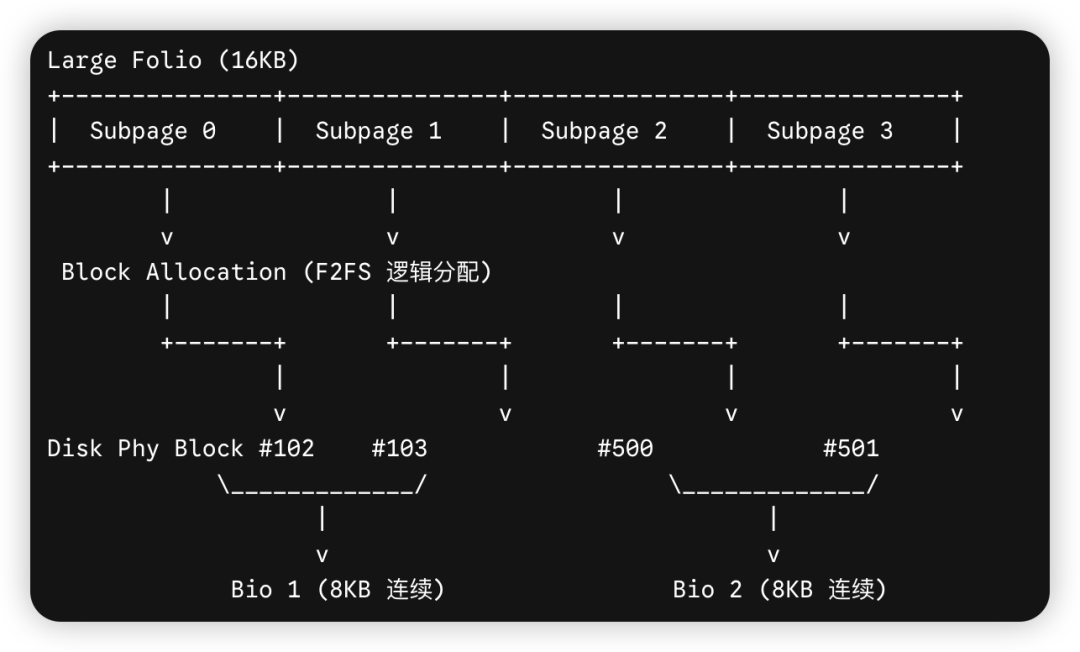
图解 Bio 拼装与磁盘映射:
Large Folio 在物理磁盘上分配的 Block 可能是不连续的(如 Out-of-place write 机制),Patch 重新设计了 Bio 的构建过程:
3. Partial Truncate(局部截断路径)
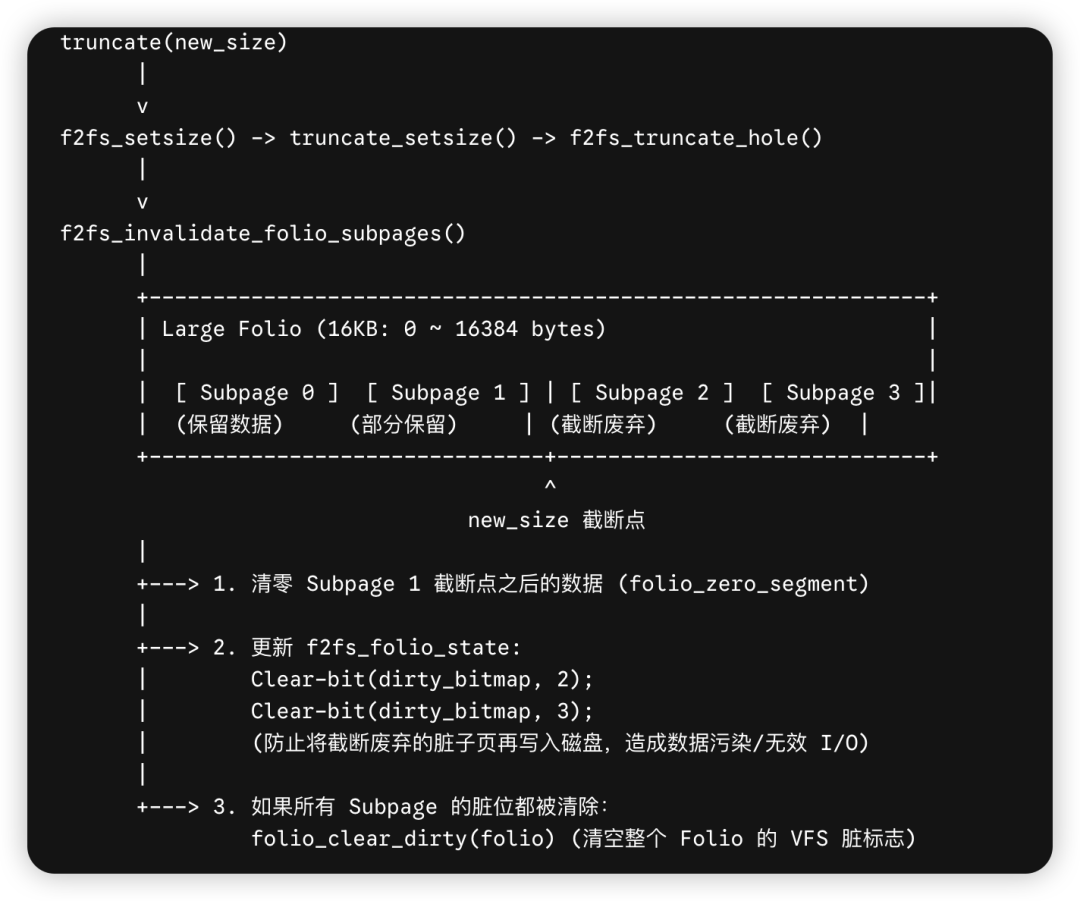
关联 Patch: 10/14 f2fs: handle partial truncate of large folio dirty subpages
核心问题分析:
假设用户调用 truncate() 将文件裁剪到中间位置,裁剪点刚好落在一个 16KB Large Folio 的第 2 个 Subpage 中间(如下图)。
截断处理流程图:
4. GC 迁移(Garbage Collection 路径)
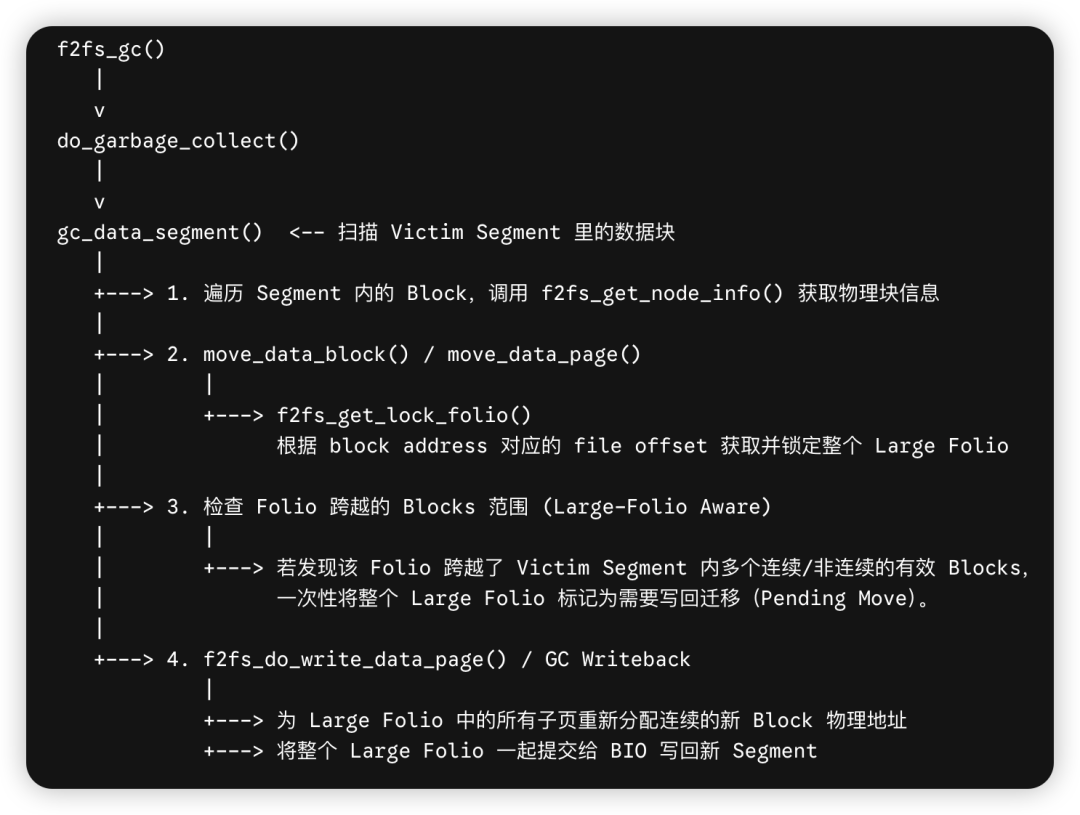
关联 Patch: 07/14 f2fs: make GC migration large-folio aware
4.1 核心矛盾与解决思路
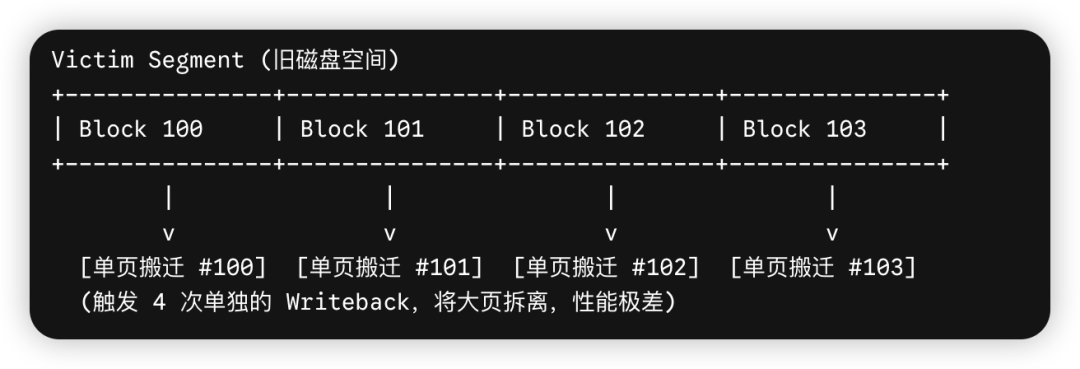
F2FS 作为日志结构文件系统(Log-structured File System),其后台 GC(或前台迫近 GC)的核心逻辑是:将 Victim Segment(垃圾回收目标段)中的有效 Block 搬迁(Migrate)到全新的 Active Segment 中,然后回收旧段。
在 Large Folio 引入前,F2FS 的 GC 是完全基于单页(4KB Page)驱动的:
- 扫描 Block Bitmap 找到有效 4KB Block。
- 通过 Page Cache 读取该 4KB Page。
- 分配新的 4KB 物理 Block 并写回(Out-of-place write)。
大页引入后的致命矛盾:
如果一个 64KB 的 Large Folio 跨越了多个 4KB 物理 Block,而 GC 依然按照老的 4KB 粒度去拆散搬迁,会导致:
- Folio 被强制裂变(Split/Invalidate):打乱 Page Cache 中大页连续性,引发严重的锁竞争。
- 数据状态撕裂:如果该 Large Folio 此时刚好部分在 Page Cache 中为 Dirty 状态,按单页迁移会导致内存数据与磁盘映射状态不一致。
Patch 07/14 的解决方案:
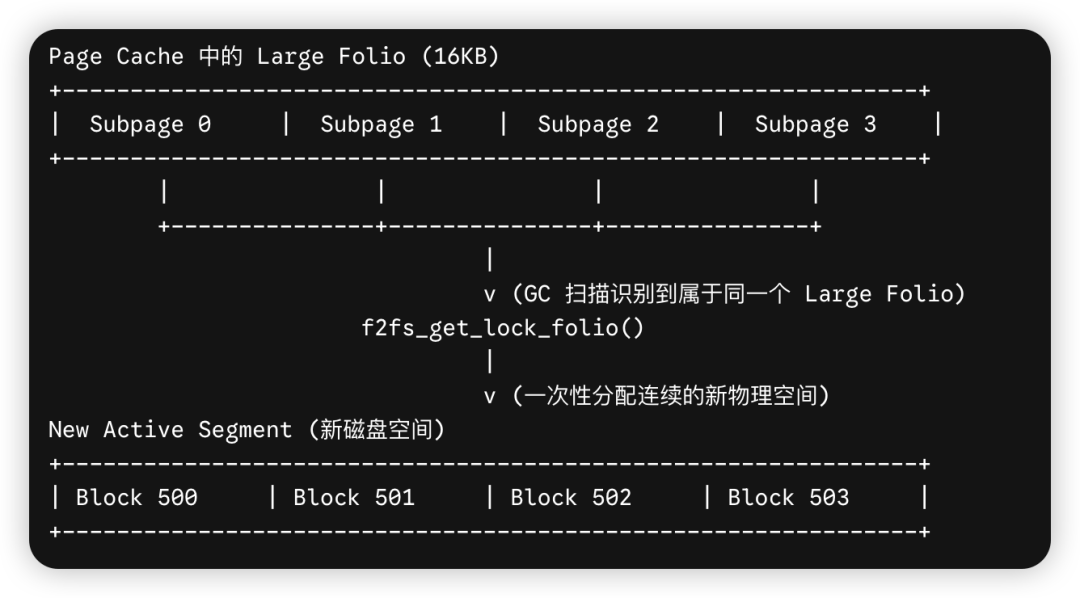
让 GC 能够感知(Aware)Large Folio 的存在。在对有效 Block 进行迁移时,优先查找并锁定其对应的整个 Large Folio;如果该 Folio 覆盖了多个相邻的 Block,将整个 Folio 涉及的所有子页/物理块作为一个整体进行批量迁移。
4.2 GC 迁移代码路径流程图
4.3 GC 迁移的物理-内存映射演进图解
传统单页 GC(容易拆散大页):
Large-Folio Aware GC(整体锁定与批量重定址):
4.4 核心代码细节剖析 (fs/f2fs/gc.c)
在 fs/f2fs/gc.c 中,针对 GC 搬迁逻辑做出了关键调整,确保不会把大页中的 Subpage 重复处理或漏处理:
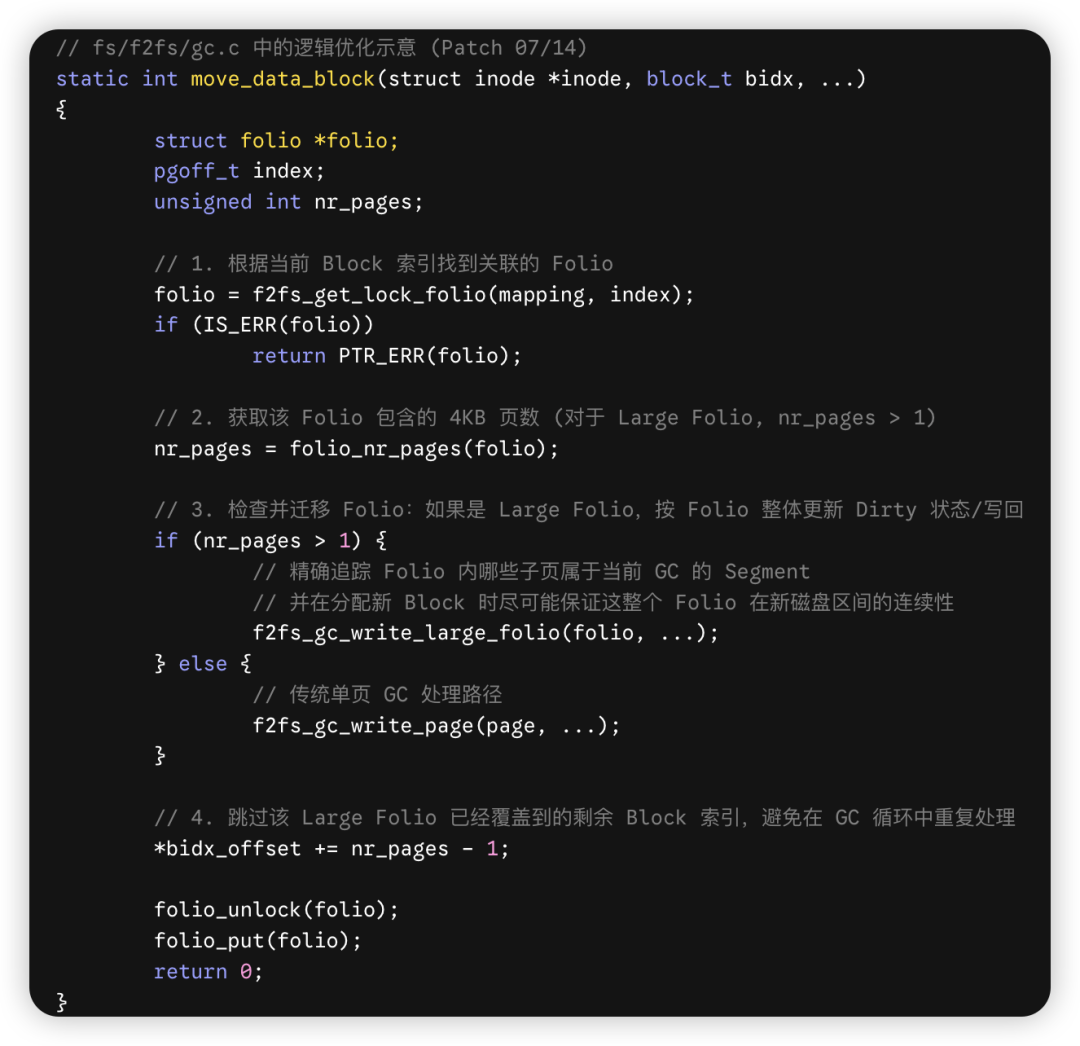
通过在 GC 路径引入对 Large Folio 的感知:
- 避免碎片化:成功防止了前后台 GC 将 Page Cache 中连续的大页强行打散。
- 重分配连续性:在搬迁写入新 Segment 时,由于整个 Large Folio 一起提交,磁盘能够重新获得分配连续 Block 的机会(Contiguous Allocation),从而进一步保障了文件后续读取的 I/O 吞吐性能。
5. Atomic Write(原子写入路径)
关联 Patch: 04/14 f2fs: support atomic file large folios buffered write
5.1 核心矛盾与解决思路
F2FS 的 Atomic Write(原子写)是其最特色的功能之一,被广泛应用于 SQLite、数据库引擎及 Android 系统关键服务(如 Setting/Config 数据库)中。它的核心原则是:"要么全写,要么全不写",用于避免数据库在断电或 Crash 时产生半写(Partial Write / Torn Page)导致数据损坏。
F2FS 传统 Atomic Write 机制:
- 当文件开启原子写(
F2FS_IOC_START_ATOMIC_WRITE)后,用户态向该文件写入的数据不会直接覆盖原有的主 inode 物理 Block。
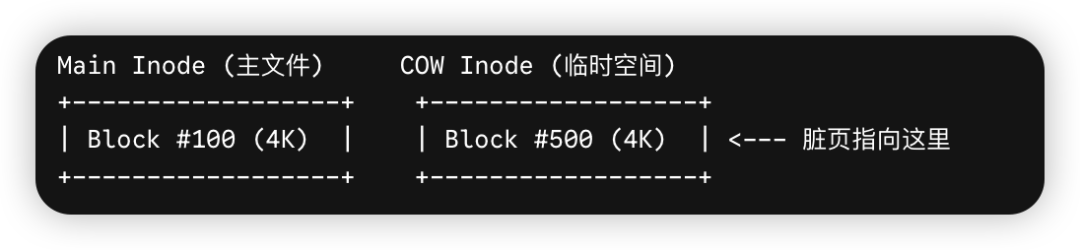
- F2FS 会在内存中维护一个匿名的 COW Inode(Copy-On-Write 临时索引节点)。
- 脏页(Dirty Pages)在写回或 commit 之前,被重定向并挂载到 COW Inode 上;直到用户调用
F2FS_IOC_COMMIT_ATOMIC_WRITE 时,才统一将 COW Inode 的物理映射批量替换/合并(Commit)到主 inode 中;如果调用 F2FS_IOC_ABORT_ATOMIC_WRITE 则直接丢弃 COW Inode。
大页引入后的致命矛盾:
- 映射错位(Mapping Mismatch):传统的 COW 重定向逻辑依赖于
page->mapping 是否指向主 inode 或 COW Inode。在 Large Folio 场景下,一个 Folio 包含多个 4KB Subpage,如果部分子页在原子写区间内被修改、部分未被修改,调用 folio_file_mapping() 时会产生映射冲突。
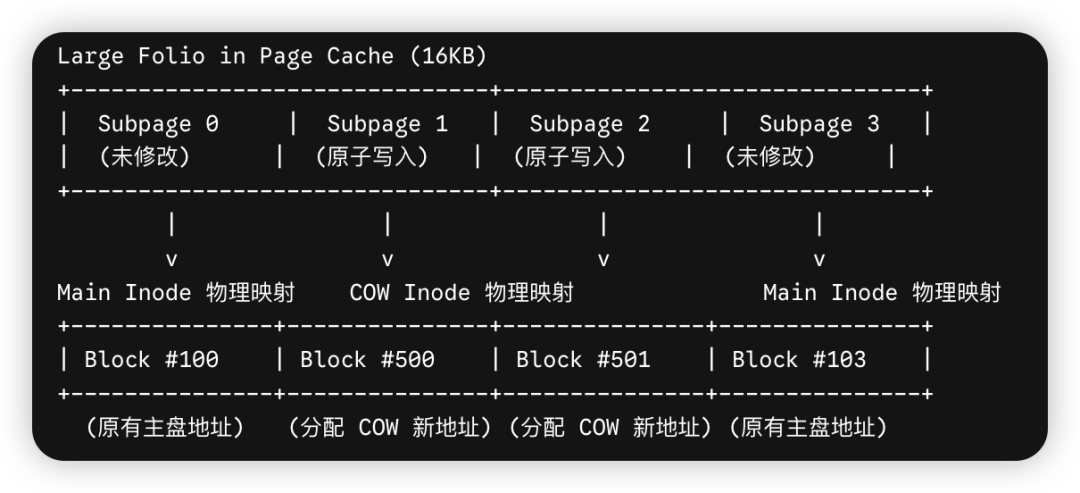
- 脏页追踪撕裂(Dirty Tracking Fragmentation):COW Inode 需要精准知道 Large Folio 中哪些子页(Subpages)被原子写动过,哪些子页仍然需要引用主文件原有的物理地址。如果简单以整个 Folio 粒度做 COW,会导致大量的无效物理块复制写放大。
Patch 04/14 的解决方案:
- 引入 Large Folio 级别的 COW 脏子页标记:结合
f2fs_folio_state 中的 dirty_bitmap,允许一个 Large Folio 在 COW 阶段只为真正修改过的子页(Dirty Subpages)分配 COW 临时 Block。
- 适配
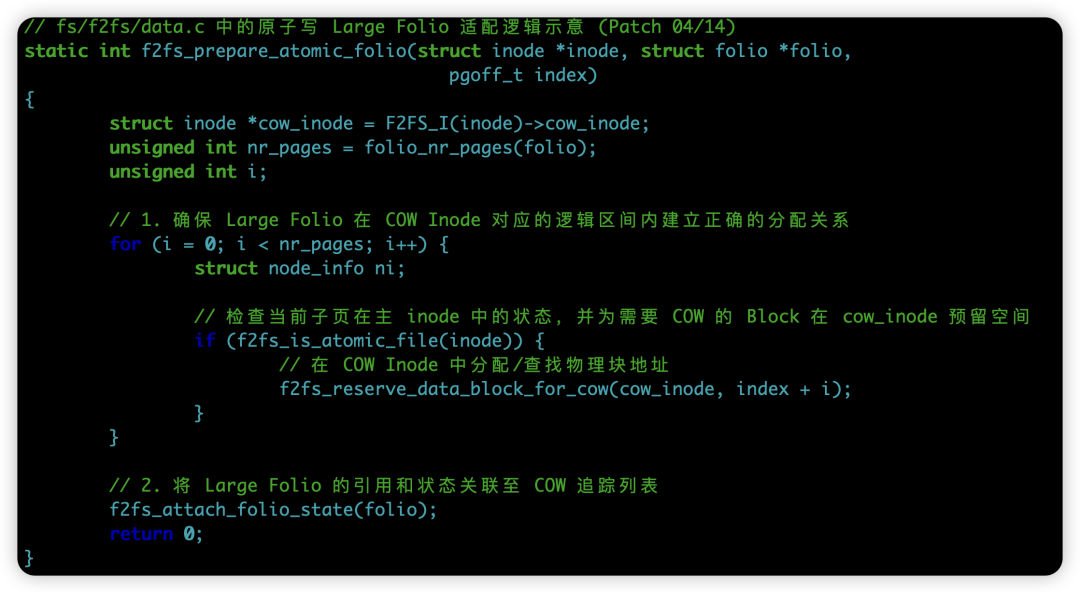
f2fs_write_begin/f2fs_write_end 的原子写上下文:在缓冲写入(Buffered Write)阶段,提前检查文件是否处于 FI_ATOMIC_FILE 状态,并在准备大页时正确挂载 COW Inode 映射。
5.2 Atomic Write 代码路径流程图
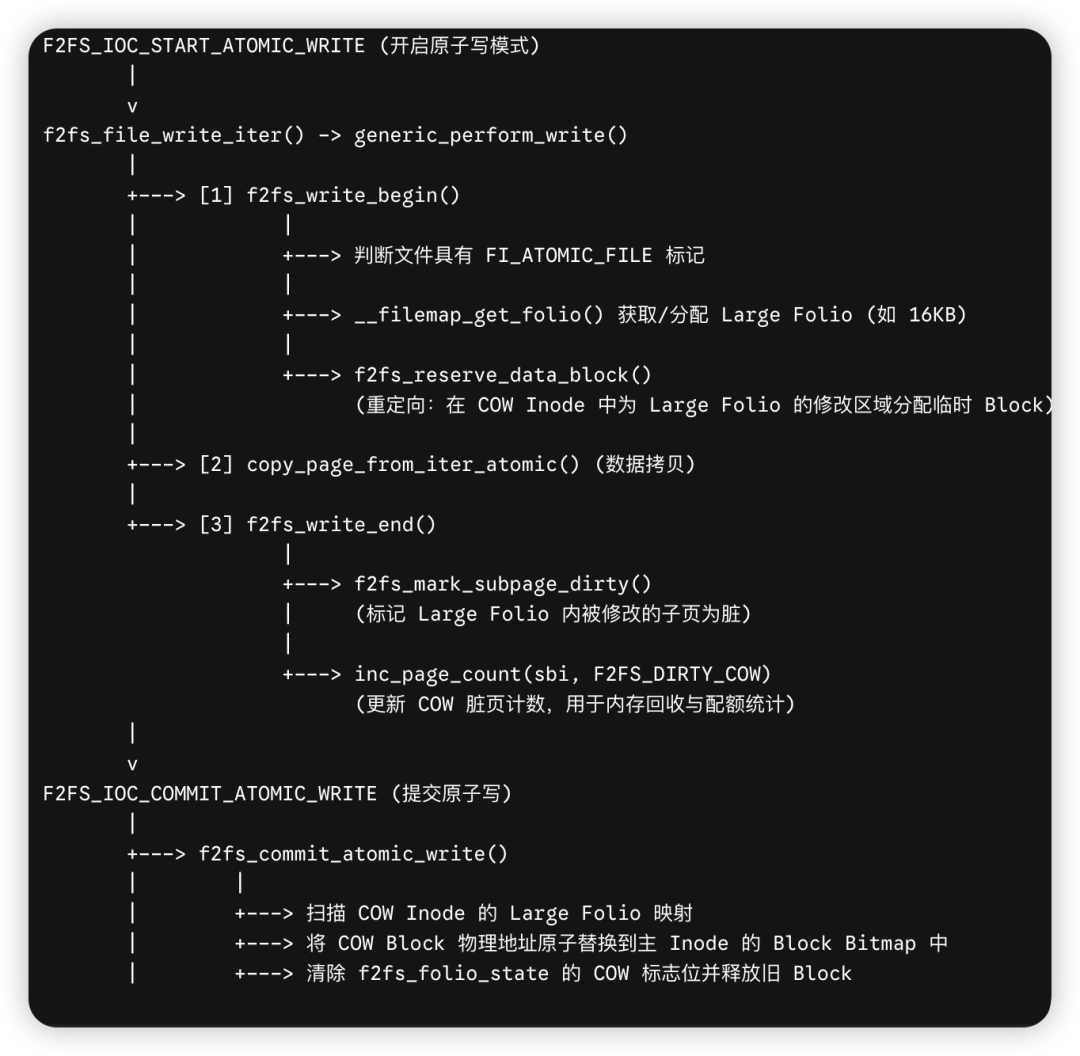
5.3 Atomic Write 的物理-逻辑映射演进图解
传统单页 COW:
Large Folio 下的精细化 COW(Patch 04/14):
5.4 核心代码细节剖析 (fs/f2fs/segment.c / fs/f2fs/data.c)
在 Patch 04/14 中,重点修改了 f2fs_prepare_atomic_page() 以及 f2fs_write_end() 路径对 Large Folio 的判断:
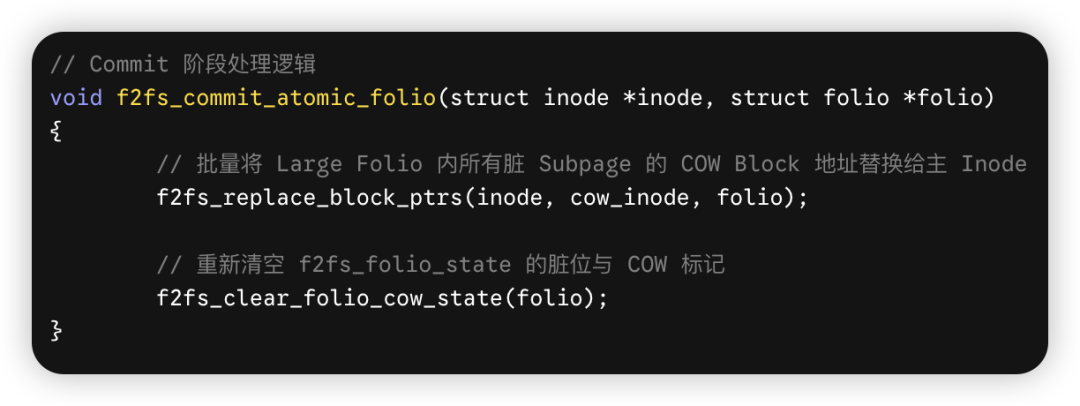
在提交阶段(f2fs_commit_atomic_write),代码会按 Large Folio 的 folio_nr_pages() 批量合并物理映射,极大缩短了 SQLite COMMIT 时的临界区延迟:
通过 Patch 04/14 的补全,F2FS 的 Atomic Write 具备了完整的 Large Folio 支持:
- 数据库性能大幅提升:SQLite 等高频调用原子写的文件在开启大页后,write_begin/end 的内存锁定与分配开销降低,COMMIT 批量替换映射的速度显著加快。
- 零数据损坏风险:保持了原子写防断电半写(Torn Page)的强可靠性安全边界,同时通过
f2fs_folio_state 保证了在 COW 过程中子页粒度物理地址映射的精准无误。
三、核心 Patch 细节与关键修改点拆解
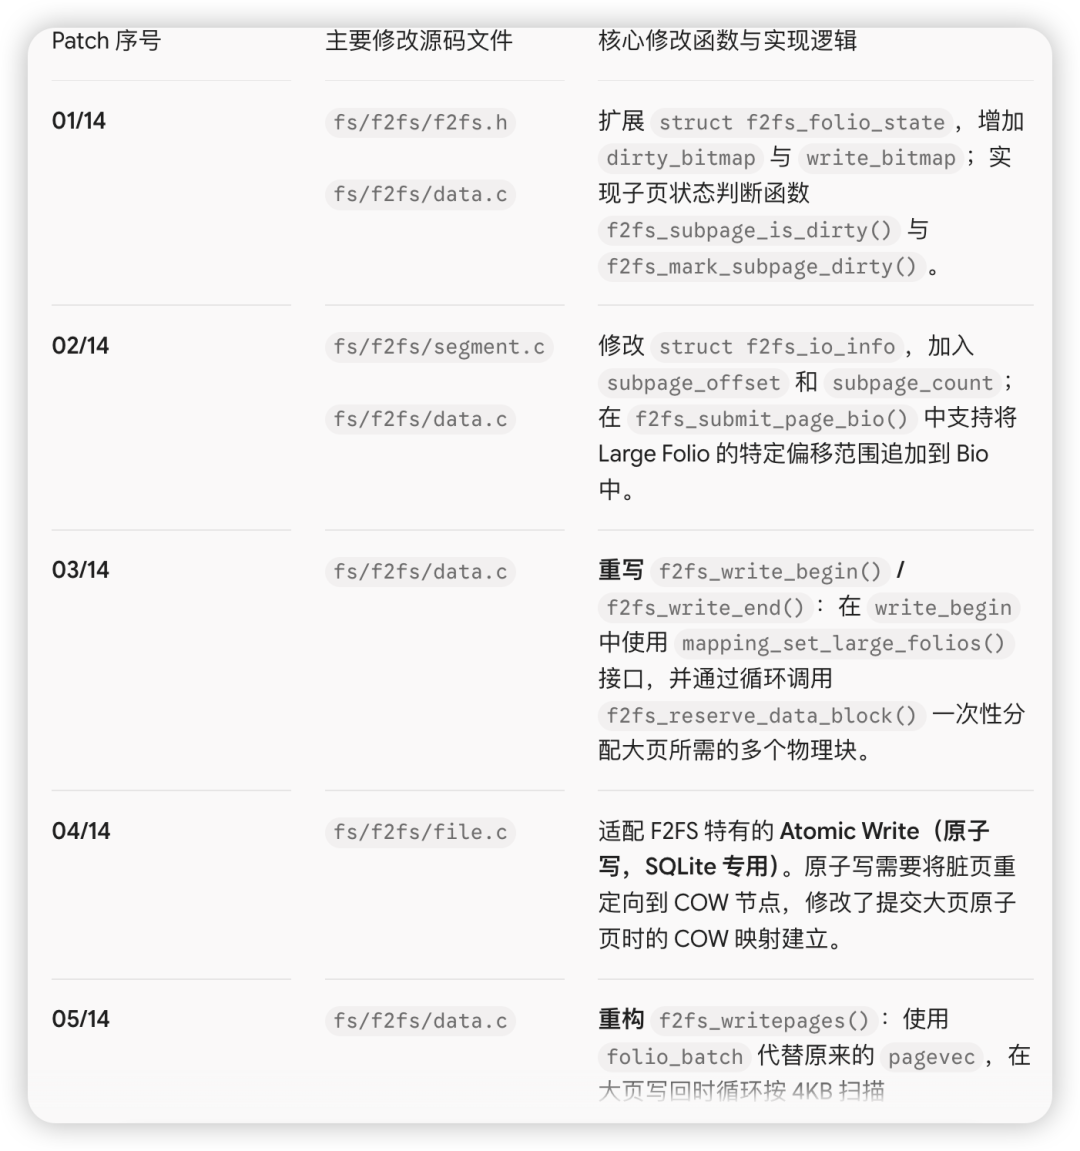
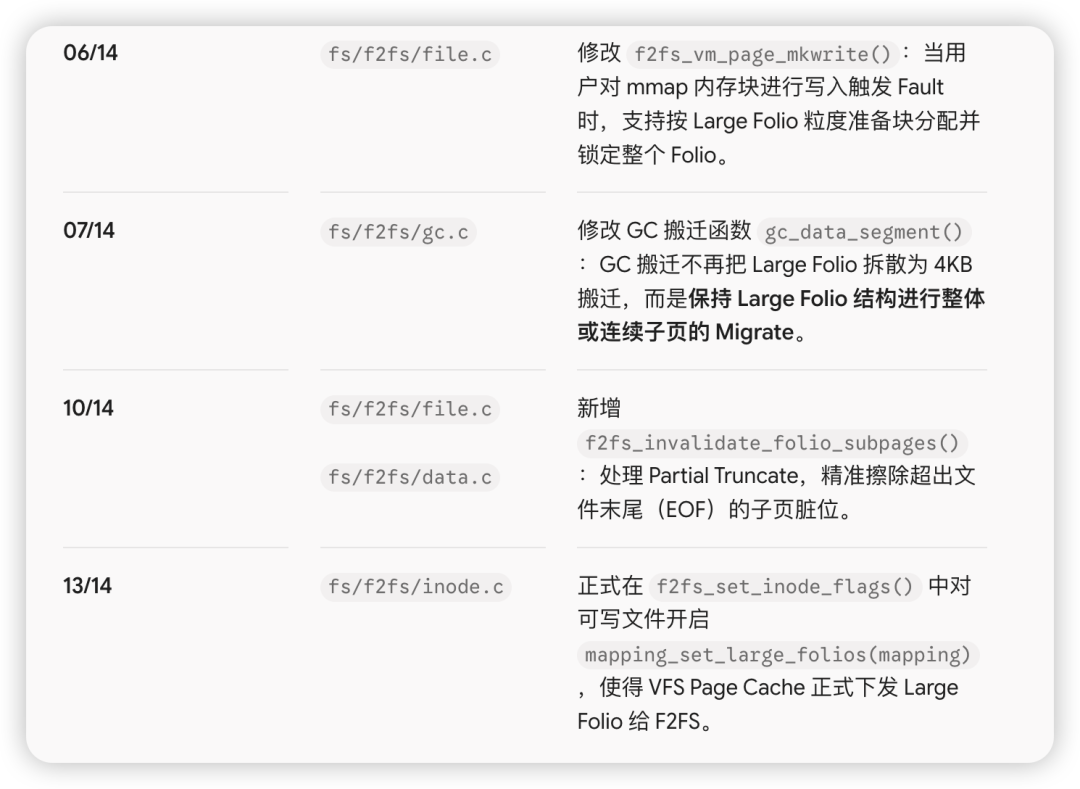
四、总结:Patchset 的改进成效
通过上述架构图与代码路径的处理,该 Patchset 实现了以下效果:
- 写放大与 CPU 锁开销降低:Buffered Write 阶段由原来的逐页(4KB)获取 page_lock 变为对 Large Folio(如 64KB)只锁一次,大大减少了锁竞争和 TLB invalidate 频率。
- I/O 连续性提升:分配物理块时能够一次性连续申请,写回时拼装出更大的连续 Bio,极大提升了 UFS/NVMe 存储介质的顺序写性能。
- 状态管理无缝衔接:通过
f2fs_folio_state 的细粒度子页追踪,完美解决了内存大页粒度与磁盘 4KB Block 粒度对齐不一致带来的数据安全与局部截断难题。
让我们共同期待 Nanzhe 的这个 patchset 早日合入 mainline。
参考文献
【1】 https://lore.kernel.org/lkml/20260915041909.2903887-1-zhaonanzhe@xiaomi.com/
 发表于 2 小时前
|
查看: 5|
回复: 0


