LPC2026 正在布拉格火热召开。第一天就遇到了不少新老朋友,国内也有许多公司的工程师专程前来。作为云栈社区的技术编辑,我在现场记录了不少关于内核技术的最新讨论。
10 月 5 日下午的 MM mc(内存管理微峰会)环节,Will Deacon 详细阐述了他对 ARM64 动态内核栈的理解,并介绍了他在 Google 围绕这一方向所做的工作。
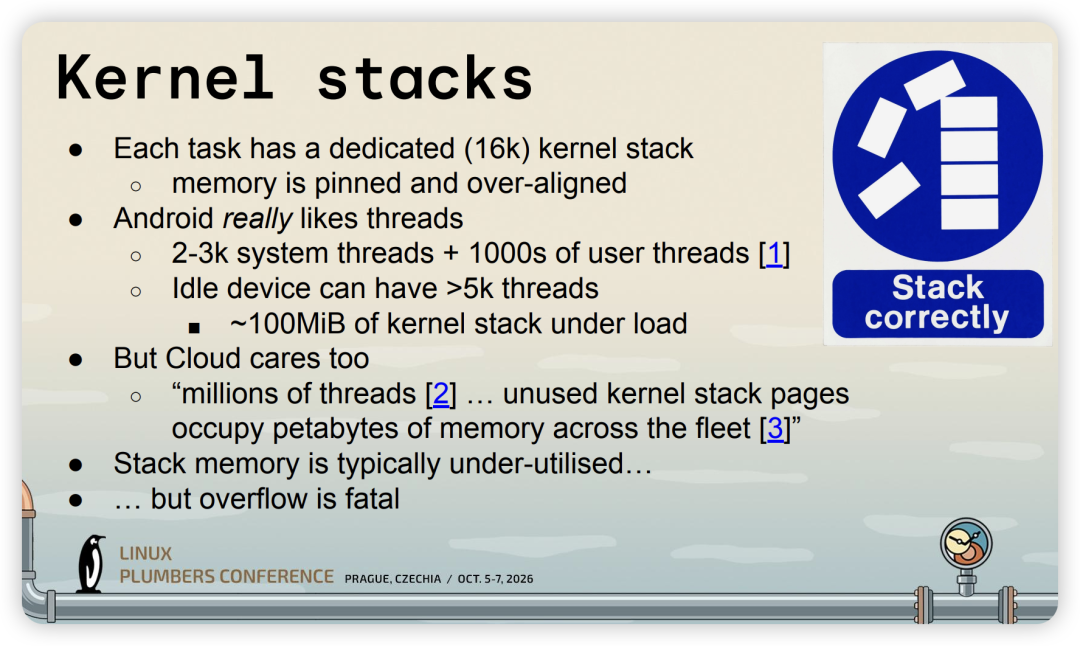
当前 Android 生态中,用户态存在大量线程(thread),每个线程在内核态对应的栈(stack)大小都是 16KB。这个 16KB 很可能严重过量——绝大多数场景下内核实际只需要 8KB 就够用了。出于简单和安全的设计,16KB 被选为一个可靠的“安全大值”,让各种场景都能有充足的栈空间,但这种设计也带来了显著的内存浪费:
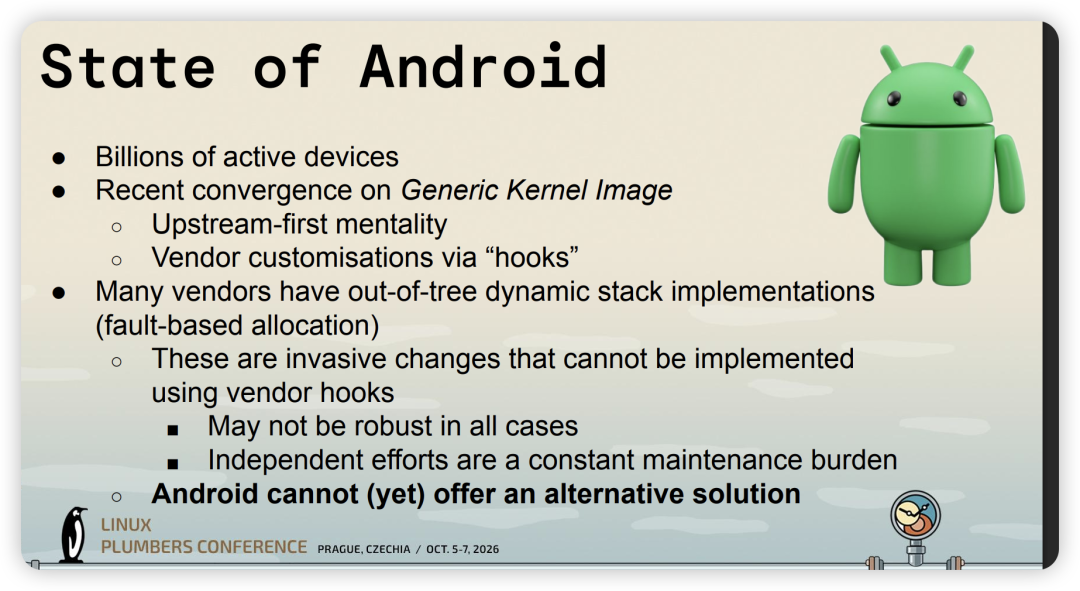
目前,部分 Android 厂商通过强行 hack Android 内核的方式实现了动态内核栈——注意,这部分工作无法仅靠 Android hooks 来完成:
这种实现方式借用了内核栈作为 Virtually mapped stacks 的特点:默认只映射 4KB 的物理地址,在栈溢出(stack overflow)触发的 fault 中执行分配,让栈逐步扩展——虚拟地址会找到对应的物理页,类似于用户态内存发生 page fault 时的分配与映射逻辑。该方法最早由 Pasha 提出,随后 Linus Walleij 对其进行了 rebase,并移植到了 arm64:
Will Deacon 对这种方法在鲁棒性方面的表现却不太放心,于是他开始寻找不同的解决路径。在这一探索过程中,Google 首先量化分析了 Android 场景,发现绝大多数情况下 8KB 其实真的够用了(包括 CTS/VTS 等测试),真正出问题的是内存压力测试 MemoryPressureTest 所触发的 direct reclaim 场景:
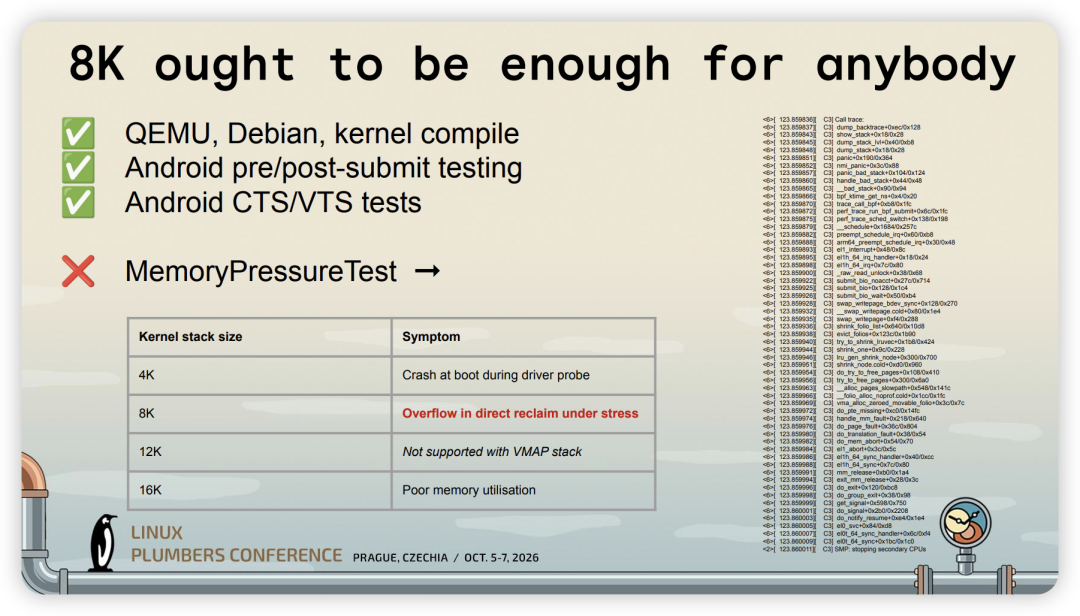
direct reclaim 其实可以看作是两项工作的叠加:一方面,触发 direct reclaim 的工作路径本身需要栈空间;另一方面,direct reclaim 自身也是一套相当复杂的流程,同样需要栈空间。两份工作同时挤在同一个调用栈里,最终就把 8KB 以上的栈给撑爆了。
例如:
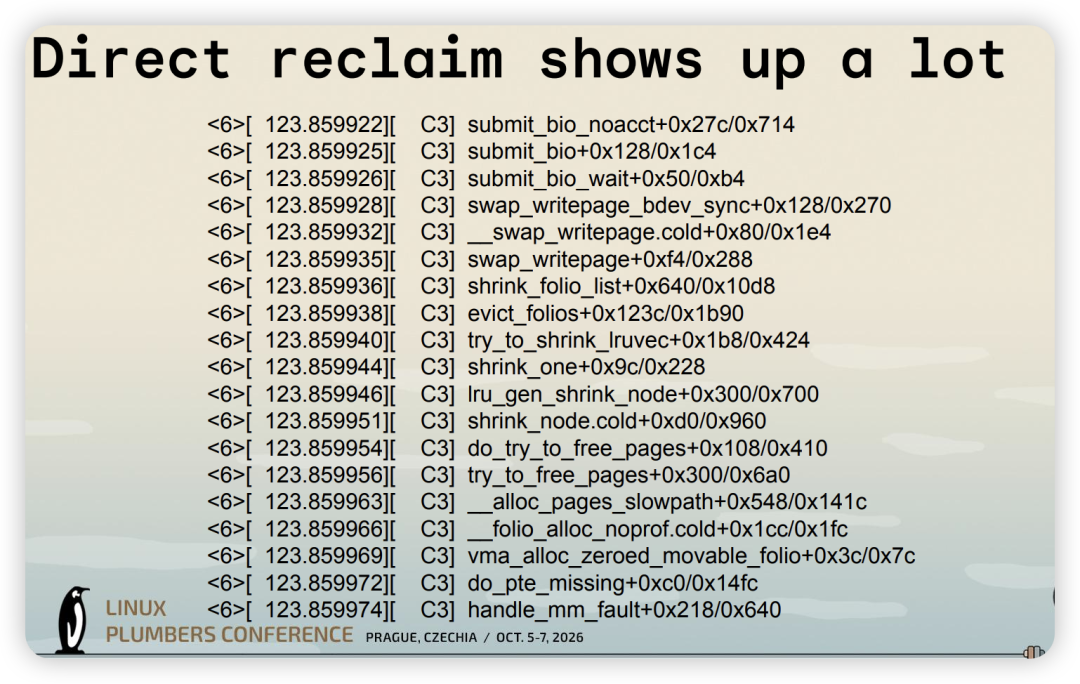
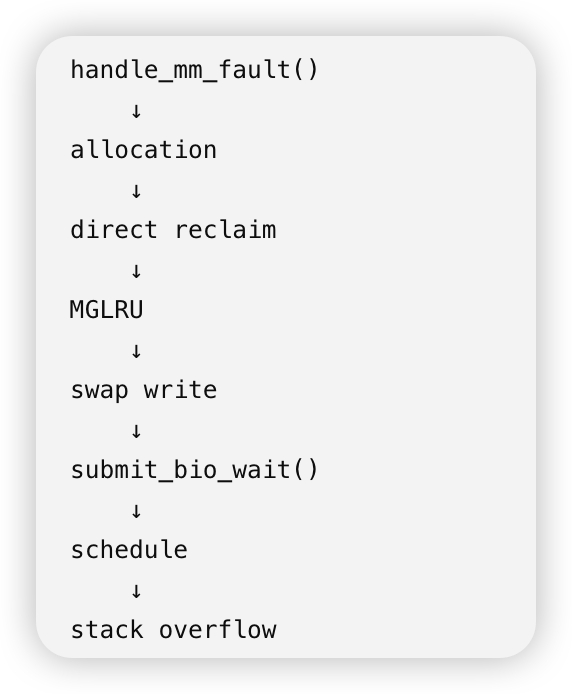
上面这次 stack overflow 的调用栈牵扯到多个软件实体:
既然基于 fault 的动态栈扩展方案不被看好,Will Deacon 和 Suren 就必须另寻出路。Suren 的一个思路是,把 direct reclaim 移动到一个独立的 worker thread 中执行,这样两项工作所需的栈空间就能分离开来,各自使用 8KB 就已经足够了。
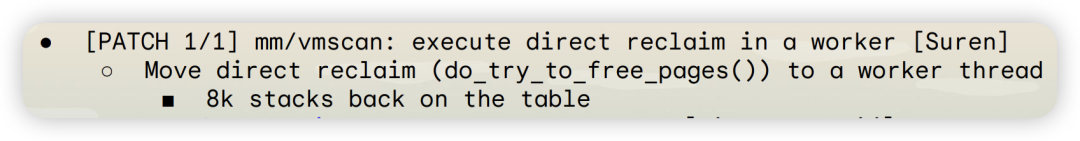
当然,这个方案也可能存在潜在的复杂度问题,比如 direct reclaim 的回收计数该如何准确统计。
Will 正在探索的另一个方案,是让内核栈大小可以通过内核启动时的 cmdline 来配置,而不是在编译阶段就固定下来。为此,他已经发出了两个 patchset:
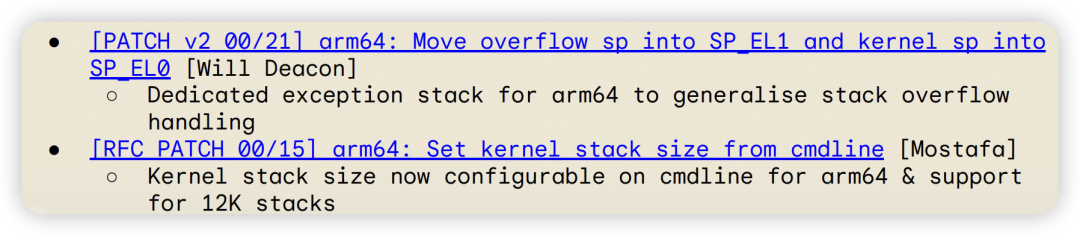
第一个 patchset 是准备工作——让 EL1 的异常处理拥有独立的 exception stack,从而简化 stack overflow 的处理逻辑,为第二个 patchset 通过 cmdline 传入栈大小奠定基础,比如启动内核时可以直接指定 12KB 的栈。
会上有多人提议,一个可行方案或许是对内核进入 direct reclaim 等已知可能超过 8KB 栈需求的场景进行标注(annotate),确保这些路径能铺满 16KB 的栈。Matthew 也提到,XFS 在实现过程中同样使用了单独的异步线程来规避 stack overflow。
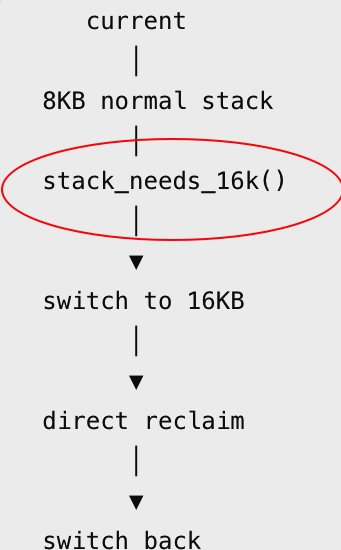
目前最值得期待的,是 Suren 的独立 worker thread 方案能否顺利落地。如果能正常工作,它或许就是短期内最简化的实现。而一条完善的 upstream 解决路径,看起来还有一段路要走。
(2026 年 10 月 6 日完成于布拉格,早晨 8:23 分)
 发表于 3 小时前
|
查看: 0|
回复: 0


