阅读本文大约需要 10 分钟。
如何保证缓存和数据库一致性,这已经是个老生常谈的话题了。但很多人仍然有不少疑惑:
- 到底是更新缓存还是删缓存?
- 应该先更新数据库再删除缓存,还是先删除缓存再更新数据库?
- 为什么要引入消息队列来保证一致性?
- 延迟双删会有什么问题?到底要不要用?
这篇文章就把这些问题逐一讲清楚。
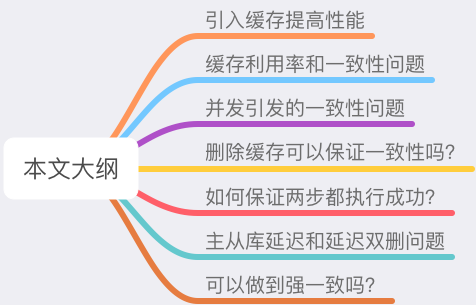
引入缓存提高性能
我们从最简单的场景开始。
如果业务处于起步阶段,流量很小,那么无论是读请求还是写请求,直接操作数据库即可,这时的架构模型如下:
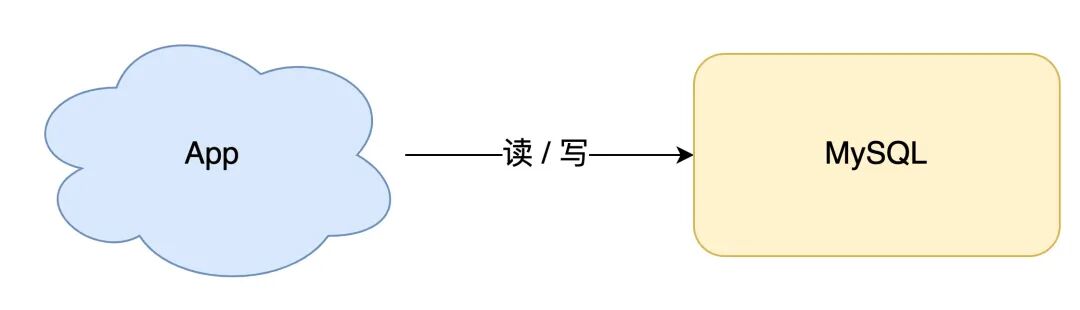
随着业务量增长,请求量越来越大,如果每次都从数据库读数据,就很容易出现性能问题。
这个阶段通常会引入「缓存」来提高读性能,架构模型变成下面这样:
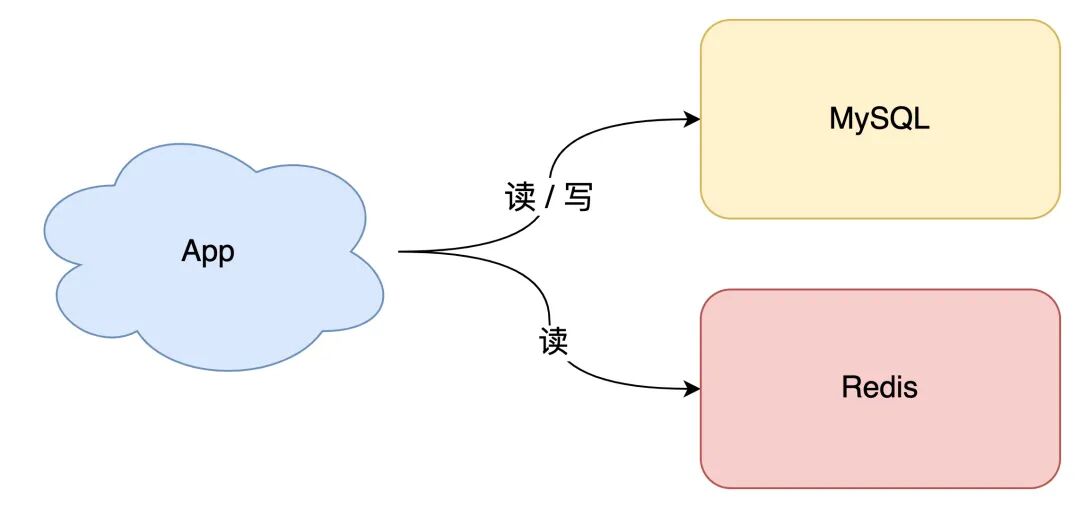
当下优秀的缓存中间件里,Redis 无疑是绕不开的选择。它不仅性能极高,还提供了很多友好的数据类型,可以很好地满足业务需求。
但引入缓存之后,就会面临一个新问题:之前数据只放在数据库中,现在还要放到缓存中读取,具体要怎么存呢?
最简单直接的方案是「全量数据刷到缓存中」:
- 数据库的数据,全量刷入缓存,不设置失效时间
- 写请求只更新数据库,不更新缓存
- 启动一个定时任务,定时把数据库的数据更新到缓存中
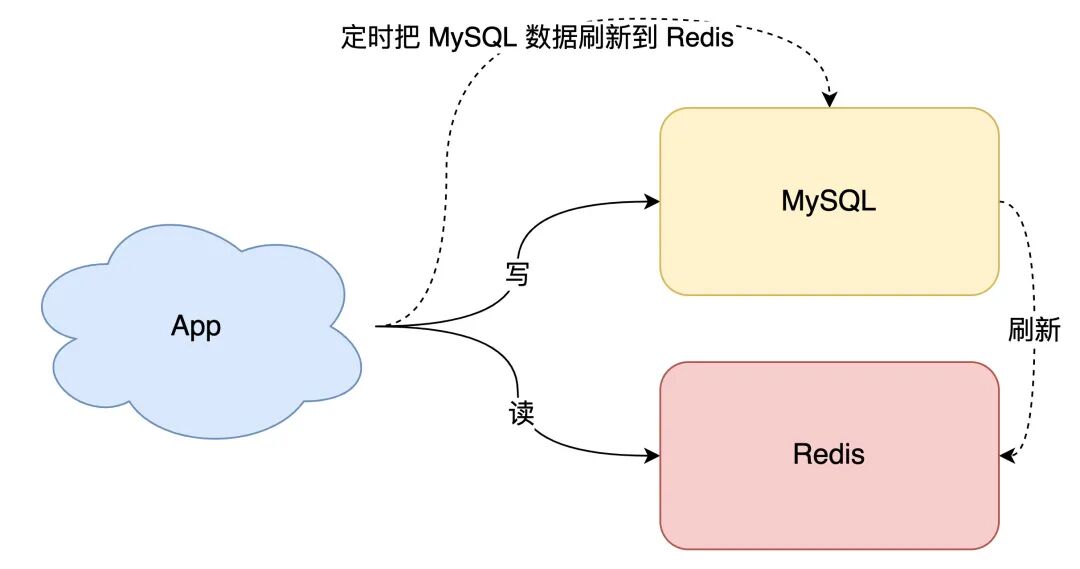
这个方案的优点是,所有读请求都可以直接「命中」缓存,不需要再查数据库,性能很高。
但缺点也很明显,主要有 2 个问题:
- 缓存利用率低:不经常访问的数据,还一直留在缓存中。
- 数据不一致:因为是「定时」刷新缓存,缓存和数据库会存在不一致,具体取决于定时任务的执行频率。
所以,这种方案通常更适合业务体量小、对数据一致性要求不高的场景。
那如果业务体量很大,该怎么解决这 2 个问题呢?
缓存利用率和一致性问题
先来看第一个问题:如何提高缓存利用率?
想让缓存利用率最大化,很容易想到的是只保留最近访问的「热数据」。具体可以这样优化:
- 写请求依旧只写数据库
- 读请求先读缓存,如果缓存不存在,则从数据库读取,并重建缓存
- 同时,写入缓存的数据都设置失效时间
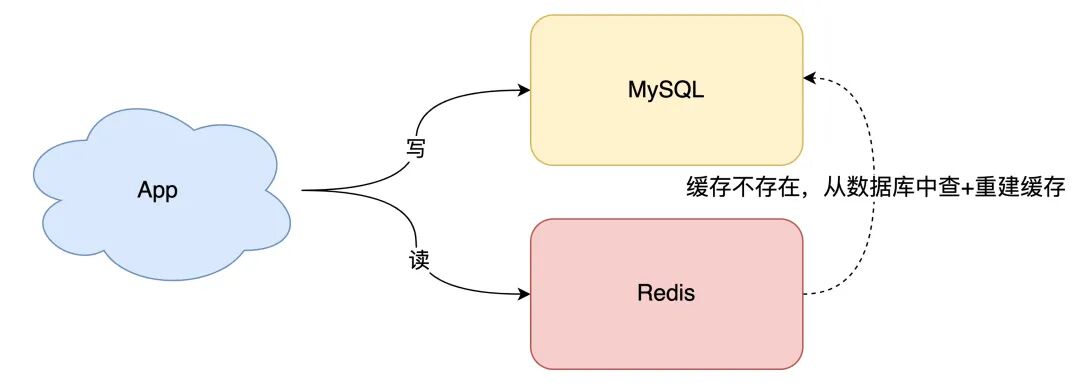
这样一来,不常访问的数据会随着时间逐渐「过期」淘汰。最终缓存中留下的,基本都是经常被访问的「热数据」,缓存利用率也就最大化。
再来看数据一致性问题。
要想保证缓存和数据库「实时」一致,就不能再靠定时任务刷新缓存了。
所以,当数据发生更新时,不仅要操作数据库,还要一并操作缓存。具体就是修改数据时,既更新数据库,也更新缓存。
但数据库和缓存都更新,就存在先后顺序问题。对应方案有 2 个:
- 先更新缓存,后更新数据库
- 先更新数据库,后更新缓存
哪个更好呢?
先不考虑并发,正常情况下无论谁先谁后,都能让两者保持一致。但现在要重点考虑「异常」情况。
因为操作分两步,就很可能出现「第一步成功、第二步失败」的情况。
这两个方案一个个分析。
1)先更新缓存,后更新数据库
如果缓存更新成功,但数据库更新失败,此时缓存中是最新值,数据库中却是「旧值」。
虽然此时读请求可以命中缓存,拿到正确值,可一旦缓存「失效」,就会从数据库读到「旧值」,重建缓存也还是旧值。
这时用户会发现,自己刚修改的数据又「变回去」了,对业务会产生直接影响。
2)先更新数据库,后更新缓存
如果数据库更新成功,但缓存更新失败,那么数据库里是最新值,缓存里还是「旧值」。
之后的读请求读到的都是旧数据。只有等缓存「失效」后,才能从数据库得到正确值。
这时用户会发现,自己刚改了数据,却看不到变化;过一段时间后数据才更新过来,业务上同样会受影响。
可见,无论谁先谁后,只要后者发生异常,就会影响业务。那怎么解决呢?
别急,后面会给出对应的解决方案。
继续分析:除了操作失败问题,还有什么场景会影响数据一致性?
这里还需要重点关注:并发问题。
并发引发的一致性问题
假设采用「先更新数据库,再更新缓存」的方案,并且两步都能「成功执行」的前提下,如果存在并发,会怎么样?
假设有线程 A 和线程 B 两个线程,需要更新「同一条」数据,可能出现这种时序:
- 线程 A 更新数据库,X = 1
- 线程 B 更新数据库,X = 2
- 线程 B 更新缓存,X = 2
- 线程 A 更新缓存,X = 1
最终,X 在缓存中是 1,在数据库中是 2,发生了不一致。
也就是说,A 虽然先于 B 发生,但 B 操作数据库和缓存的时间比 A 更短,执行时序「错乱」,最终这条数据的实际结果并不符合预期。
同样地,采用「先更新缓存,再更新数据库」的方案,也会有类似问题,这里不再展开。
除此之外,从「缓存利用率」角度看,这种方案也不太推荐。
因为每次数据变更都「无脑」更新缓存,但缓存中的数据不一定马上被读取。这会导致缓存中可能存放大量不常访问的数据,浪费缓存资源。
而且很多情况下,写到缓存中的值并不是与数据库一一对应的,它可能是先查数据库,再经过一系列「计算」后才得到并写入缓存的。
由此可见,「更新数据库 + 更新缓存」的方案,不仅缓存利用率不高,还会浪费机器性能。
所以,需要换一种思路:删除缓存。
删除缓存可以保证一致性吗?
删除缓存的方案也有 2 种:
- 先删除缓存,后更新数据库
- 先更新数据库,后删除缓存
经过前面的分析我们已经知道,只要「第二步」操作失败,就会导致数据不一致。
这里不再重复推演具体场景。你可以按前面的思路自己推一推,依然会看到不一致情况。
这里重点看「并发」问题。
1)先删除缓存,后更新数据库
如果有 2 个线程并发「读写」数据,可能出现以下场景:
- 线程 A 要更新 X = 2,原值 X = 1
- 线程 A 先删除缓存
- 线程 B 读缓存,发现不存在,从数据库中读取到旧值,X = 1
- 线程 A 将新值写入数据库,X = 2
- 线程 B 将旧值写入缓存,X = 1
最终,X 在缓存中是 1,旧值;在数据库中是 2,新值,发生不一致。
可见,先删除缓存、后更新数据库,在「读 + 写」并发时,依然存在数据不一致。
2)先更新数据库,后删除缓存
同样是 2 个线程并发「读写」数据:
- 缓存中 X 不存在,数据库 X = 1
- 线程 A 读取数据库,得到旧值,X = 1
- 线程 B 更新数据库,X = 2
- 线程 B 删除缓存
- 线程 A 将旧值写入缓存,X = 1
最终,X 在缓存中是 1,旧值;在数据库中是 2,新值,也发生了不一致。
这种情况从理论上看有可能发生,但实际概率「很低」。因为它必须同时满足 3 个条件:
- 缓存刚好已失效
- 读请求 + 写请求并发
- 更新数据库 + 删除缓存的时间,也就是步骤 3 到 4,要比读数据库 + 写缓存的时间短,也就是步骤 2 和 5
仔细想想,条件 3 的发生概率其实很低。
因为 写数据库一般会先「加锁」,写数据库通常比读数据库更耗时。
这么看,「先更新数据库 + 再删除缓存」这个方案,可以保证数据一致性。
所以,我们应该采用这种方案来操作数据库和缓存。
解决了并发问题,再来看之前遗留的问题:第二步执行「失败」导致数据不一致。
如何保证两步都执行成功?
前面分析过,无论是更新缓存还是删除缓存,只要第二步失败,就会导致数据库和缓存不一致。
保证第二步成功执行,是解决问题的关键。
想一下,程序执行过程中发生异常,最简单的解决办法是什么?
答案是:重试。
这里也可以这样做。
无论是先操作缓存,还是先操作数据库,只要后者执行失败,就可以发起重试,尽量去做「补偿」。
那是不是意味着,只要执行失败,就「无脑重试」就可以了?
答案是否定的。现实情况往往没那么简单。失败后立即重试的问题在于:
- 立即重试很大概率「还会失败」
- 「重试次数」设置多少才合理?
- 重试会一直「占用」这个线程资源,导致它无法服务其它客户端请求
可以看到,虽然重试能解决问题,但这种「同步」重试方案依旧不够严谨。
更好的方案应该怎么做?
答案是:异步重试。
什么是异步重试?其实就是把重试请求写到「消息队列」中,然后由专门的消费者来重试,直到成功。
或者更直接一点:为了避免第二步执行失败,我们可以把操作缓存这一步,直接放到消息队列中,由消费者来操作缓存。
到这里你可能会问:写消息队列也有可能会失败啊?而且引入消息队列,还增加了维护成本,这样做值得吗?
这个问题问得很好。我们先思考另一个问题:如果在执行失败的线程中一直重试,还没等执行成功,项目恰好「重启」了,那这次重试请求也就「丢失」了,这条数据就会一直不一致。
所以,这里必须把重试或第二步操作放到另一个「服务」中,而这个服务用「消息队列」最为合适。消息队列的特性正好符合我们的需求:
- 消息队列保证可靠性:写到队列中的消息,在成功消费之前不会丢失,即使项目重启也不担心
- 消息队列保证消息成功投递:下游从队列拉取消息,成功消费后才会删除消息;否则还会继续投递给消费者,这正好符合重试场景
至于写队列失败和消息队列的维护成本问题:
- 写队列失败:操作缓存和写消息队列「同时失败」的概率其实很小
- 维护成本:项目中一般都会用到消息队列,维护成本并不会因此增加很多
所以,引入消息队列来解决这个问题是比较合适的。这时的架构模型如下:
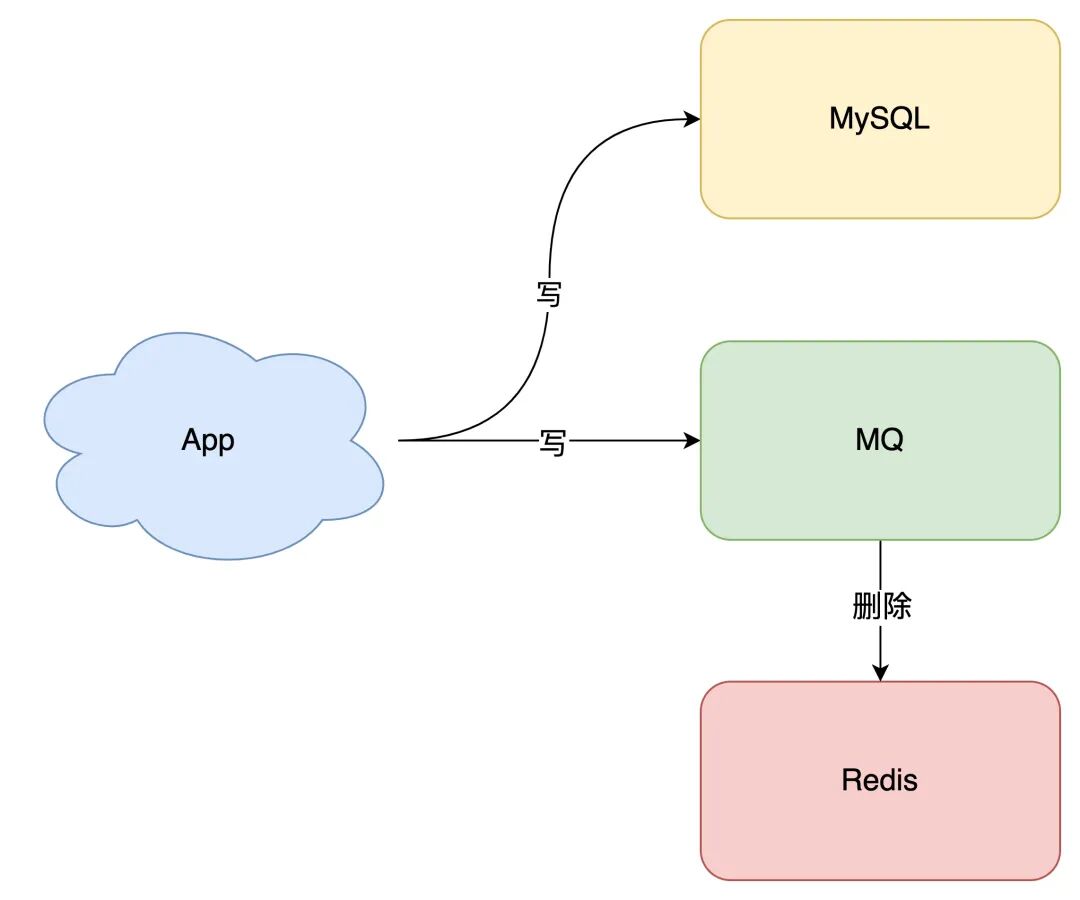
那如果确实不想在应用里写消息队列,有没有更简单的方案,同时又能保证一致性呢?
方案还是有的,这就是近几年比较流行的做法:订阅数据库变更日志,再操作缓存。
具体来说,业务应用在修改数据时,「只需」修改数据库,无需直接操作缓存。
那什么时候操作缓存呢?这和数据库的「变更日志」有关。
以 MySQL 为例,当一条数据发生修改时,MySQL 就会产生一条变更日志,也就是 Binlog。我们可以订阅这个日志,拿到具体操作的数据,再根据这条数据删除对应缓存。
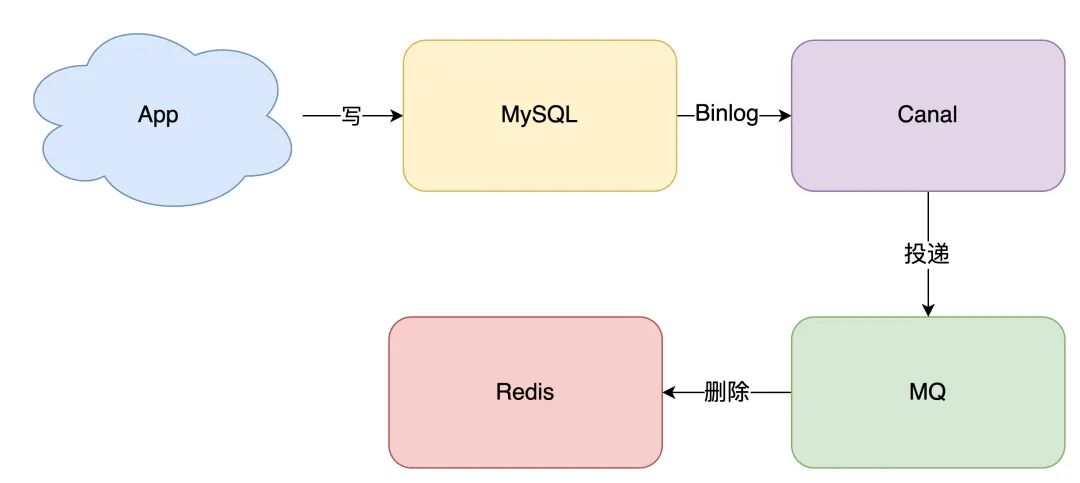
订阅变更日志,目前已经有了比较成熟的开源中间件,例如阿里的 canal。使用这种方案的优点在于:
当然,与此同时,我们需要投入精力维护 canal 的高可用和稳定性。
如果你留意观察很多数据库的特性,就会发现不少数据库都逐渐开始提供「订阅变更日志」的能力了。相信不远的将来,我们可能不需要通过中间件拉取日志,直接写程序订阅变更日志即可,这样流程会进一步简化。
至此可以得出结论:想要保证数据库和缓存一致性,推荐采用「先更新数据库,再删除缓存」方案,并配合「消息队列」或「订阅变更日志」的方式来做。
主从库延迟和延迟双删问题
到这里,还有 2 个问题没有重点分析。
第一个问题:前面提到的「先删除缓存,再更新数据库」方案导致不一致的场景,我们再复习一下。
2 个线程并发「读写」数据,可能出现:
- 线程 A 要更新 X = 2,原值 X = 1
- 线程 A 先删除缓存
- 线程 B 读缓存,发现不存在,从数据库中读取到旧值,X = 1
- 线程 A 将新值写入数据库,X = 2
- 线程 B 将旧值写入缓存,X = 1
最终,X 在缓存中是 1,旧值;在数据库中是 2,新值,发生不一致。
第二个问题:关于「读写分离 + 主从复制延迟」情况下,缓存和数据库的一致性问题。
在「先更新数据库,再删除缓存」方案下,「读写分离 + 主从库延迟」其实也会导致不一致:
- 线程 A 更新主库 X = 2,原值 X = 1
- 线程 A 删除缓存
- 线程 B 查询缓存,没有命中,查询「从库」得到旧值,从库 X = 1
- 从库「同步」完成,主从库 X = 2
- 线程 B 将「旧值」写入缓存,X = 1
最终,X 在缓存中是 1,旧值;在主从库中是 2,新值,也发生了不一致。
这两个问题的核心都是:缓存都被回种了「旧值」。
怎么解决这类问题?
最有效的办法就是,把缓存删掉。
但是不能立即删,而是需要「延迟删」。这就是业界给出的方案:缓存延迟双删策略。
按照延迟双删策略,这两个问题的解决方案如下:
解决第一个问题:线程 A 删除缓存、更新完数据库之后,先「休眠一会」,再「删除」一次缓存。
解决第二个问题:线程 A 生成一条「延时消息」,写到消息队列中,消费者延时「删除」缓存。
这两个方案的目的,都是把缓存清掉。这样一来,下次就能从数据库读到最新值并写入缓存。
但问题来了:这个「延迟删除」缓存,延迟时间到底设置多久?
- 问题 1:延迟时间要大于「主从复制」的延迟时间
- 问题 2:延迟时间要大于线程 B 读取数据库 + 写入缓存的时间
但是,这个时间在分布式和高并发场景下,其实很难评估。
很多时候,我们都只能凭经验大致估算,例如延迟 1 到 5 秒,尽可能降低不一致的概率。
所以你看,采用这种方案,也只是尽可能保证一致性而已。极端情况下,还是可能发生不一致。
实际使用中,我还是建议采用「先更新数据库,再删除缓存」的方案,同时尽可能保证「主从复制」不要有太大延迟,以降低出问题的概率。
可以做到强一致吗?
看到这里你可能会想:这些方案还是不够完美,我就想让缓存和数据库「强一致」,到底能不能做到?
其实很难。
要做到强一致,最常见的方案是 2PC、3PC、Paxos、Raft 这类一致性协议,但它们的性能往往较差,实现也比较复杂,还要考虑各种容错问题。
换个角度想一下:我们引入缓存的目的是什么?
没错,性能。
一旦决定使用缓存,就必然要面对一致性问题。性能和一致性就像天平的两端,很难同时满足。
而且,就拿前面提到的方案来说,在操作数据库和缓存完成之前,只要还有其它请求能进来,就都有可能查到「中间状态」的数据。
如果非要追求强一致,就必须要求所有更新操作完成前,不能有「任何请求」进来。
虽然可以通过加「分布锁」来实现,但付出的代价很可能会超过引入缓存带来的性能提升。
所以,既然决定使用缓存,就必须容忍「一致性」问题。我们只能尽可能降低问题出现的概率。
同时也要知道,缓存都有「失效时间」。就算这期间存在短期不一致,我们仍然有失效时间兜底,这样也能达到最终一致。
总结
最后总结一下这篇文章的重点。
- 想提高应用性能,可以引入「缓存」来解决。
- 引入缓存后,需要考虑缓存和数据库一致性问题。可选方案有:「更新数据库 + 更新缓存」、「更新数据库 + 删除缓存」。
- 更新数据库 + 更新缓存方案,在「并发」场景下无法保证缓存和数据一致性,而且存在「缓存资源浪费」和「机器性能浪费」的情况。
- 在更新数据库 + 删除缓存方案中,「先删除缓存,再更新数据库」在「并发」场景下仍然存在数据不一致问题。解决方案是「延迟双删」,但延迟时间很难评估,所以更推荐「先更新数据库,再删除缓存」。
- 在「先更新数据库,再删除缓存」方案下,为了保证两步都成功执行,需要配合「消息队列」或「订阅变更日志」来做,本质是通过「重试」保证最终一致。
- 在「先更新数据库,再删除缓存」方案下,「读写分离 + 主从库延迟」也会导致数据不一致。缓解此问题的方案是「延迟双删」,凭经验发送「延迟消息」到队列中延迟删除缓存,同时也要控制主从库延迟,尽可能降低不一致概率。
后记
本以为这个老生常谈的话题写起来会很简单,没想到还是挖出了不少以前没有深度思考过的细节。
这里分享 4 点心得:
- 性能和一致性不能同时满足。为了性能,通常会采用「最终一致性」方案。
- 掌握缓存和数据库一致性问题,核心有 3 点:缓存利用率、并发、缓存 + 数据库一起成功问题。
- 失败场景下要保证一致性,常见手段是「重试」。同步重试会影响吞吐量,所以通常采用异步重试。
- 订阅变更日志的思想,本质上是把权威数据源,例如 MySQL,当作 leader 副本,让其它异质系统,例如 Redis、Elasticsearch,成为 follower 副本,通过同步变更日志,保证 leader 和 follower 之间一致。
很多一致性问题,都会采用这些方案解决。希望这些心得对你有启发。
 发表于 2 小时前
|
查看: 1|
回复: 0


