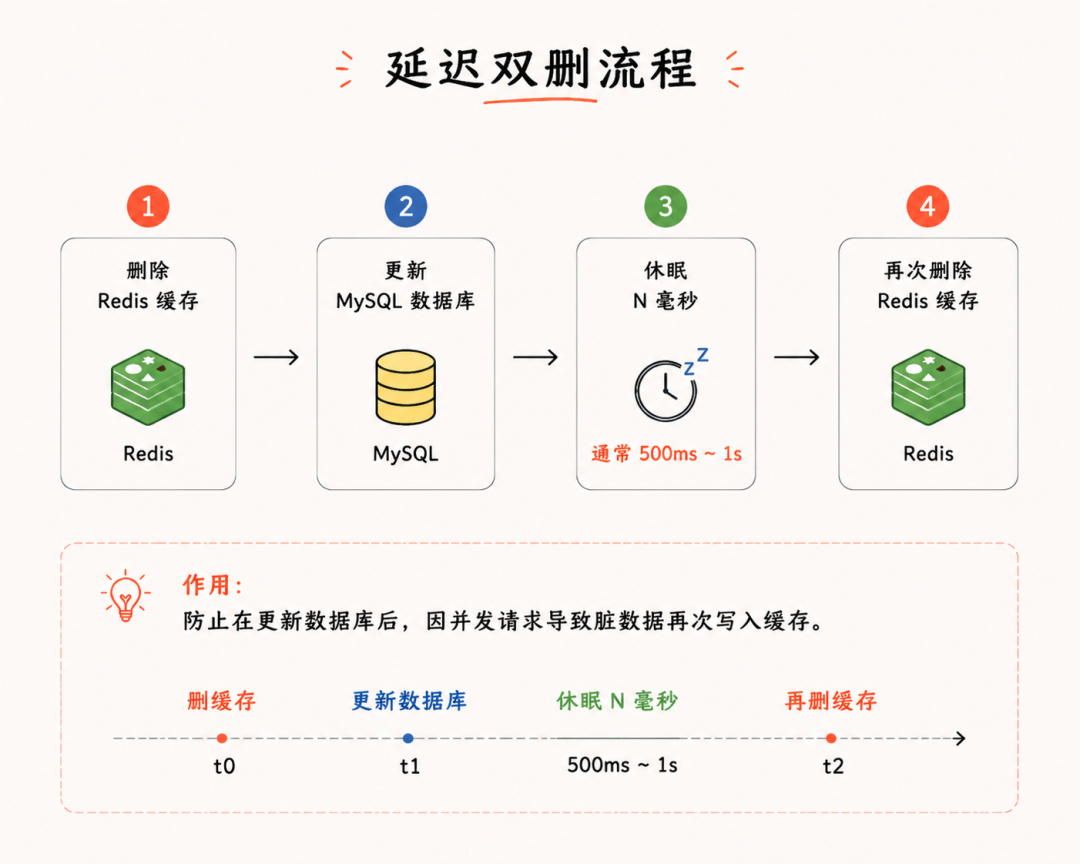
如何保证 Redis 和 MySQL 的数据一致性?标准八股文的答案是:先删缓存,再更新数据库,然后延迟一段时间再删一次缓存。
听起来逻辑挺顺,步骤也不复杂。可在高并发生产环境里,这个方案到处都是坑。
要删两次,是因为在「删缓存」和「更新数据库」之间有一个时间窗口。这期间,另一个读请求可能恰好查到数据库里的旧值,又把它写回缓存。第二次删除就是为了清掉这个被回填的脏缓存。
逻辑上似乎没毛病,但问题都藏在细节里。
延迟时间不好定
休眠 N 毫秒,这个 N 究竟该定多少?
设得太短,可能还没等读请求把旧值写回缓存,第二次删除就已经执行了,等于白干;设得太长,休眠期间所有读请求都会读到脏缓存,脏缓存迟迟不会刷新。
通常建议把 N 设为「读请求耗时 + 几百毫秒」。但读请求耗时在高并发下波动很大:平时 50ms,高峰期可能飙到 500ms。定一个固定值,要么平时浪费,要么高峰期根本兜不住。
更要命的是,这个延迟值一旦确定,往往会硬编码在代码里。数据库换了、网络抖了、机器扩容了,全都得重新评估。
线程 sleep 阻塞业务
最直接的实现就是在业务线程里 Thread.sleep(500)。
高并发场景下,业务线程是非常宝贵的资源。一个写请求进来,处理完数据库更新,随后线程就傻等 500ms。假设每秒有 1000 个写请求,就有 1000 个线程同时 sleep,线程池很快被占满,后面的请求只能排队甚至超时。
那换异步?用 MQ 发个延迟消息来做第二次删除?
可以是可以,但 MQ 的复杂度也随之而来:消费失败怎么办?消费延迟了怎么办?为了一个缓存一致性,反而引入一整套消息中间件的运维成本。
第二次删除也可能失败
网络又不是 100% 可靠,第二次删除 Redis 的操作可能因为网络抖动、Redis 短暂不可用、超时等原因失败。失败了怎么办?加重试?重试几次?间隔多久?
每一层兜底都会带来新的复杂度。最后你会发现,为了保证一个删除操作的可靠性,自己写了一堆重试 + 补偿逻辑。
并发写的坑
延迟双删只考虑了「一个写请求 + 一个读请求」的并发场景。那如果两个写请求同时到来,会怎样?
假设有两个写请求 A 和 B,按照这个时间顺序执行:
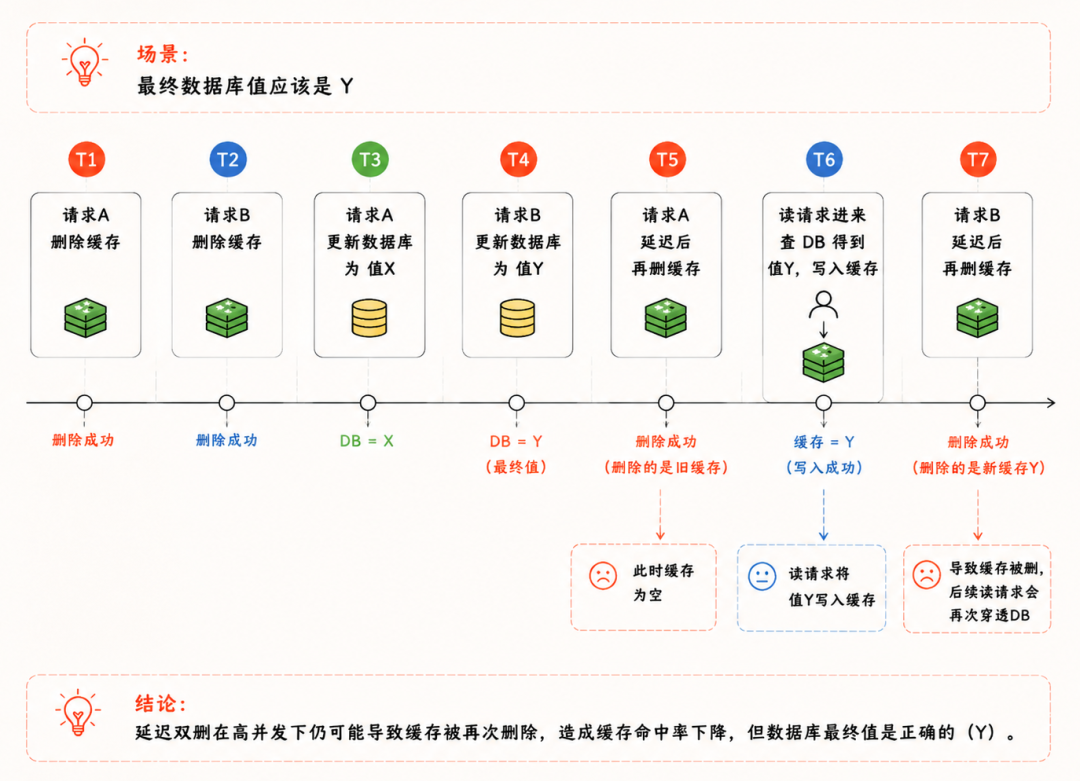
这个场景下,数据库最终值是 Y,缓存顶多被误删一次,后续读请求还能回源加载,所以看上去问题不大。
但如果时序稍微变一下:
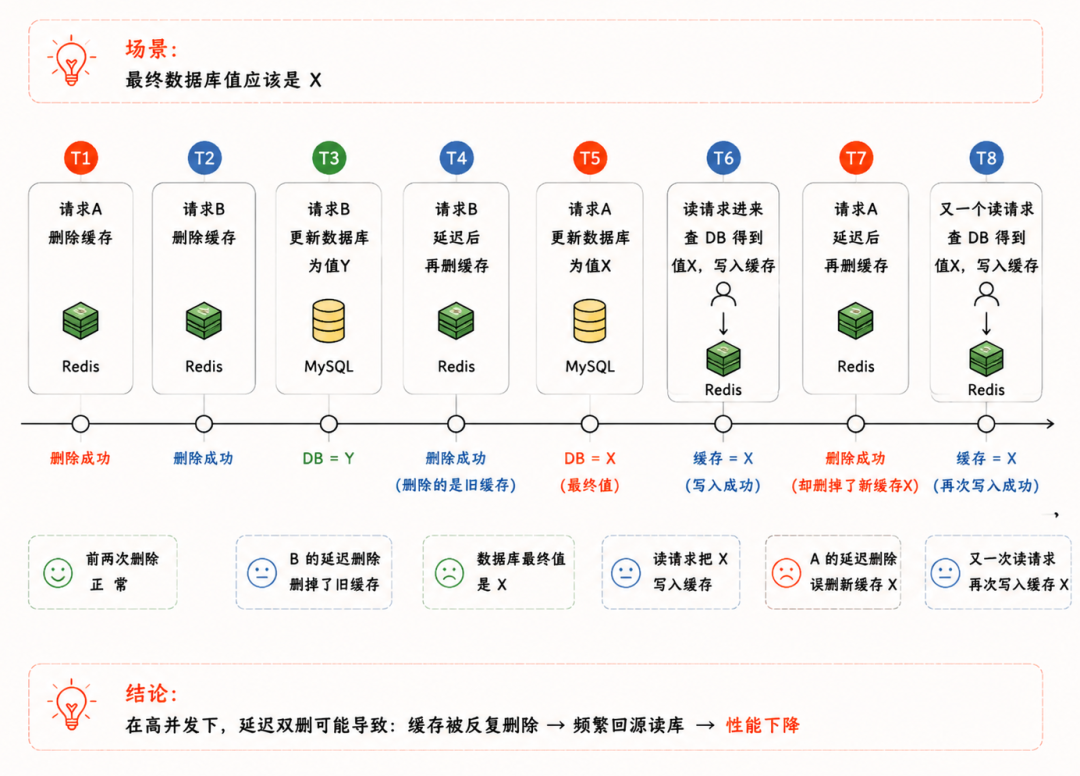
请求 B 是后发起的,业务语义上最终值应该是 Y,但数据库里存的却是 X。
这其实已经不是缓存一致性的问题了,而是数据库本身的并发写顺序问题,延迟双删根本管不了。
推荐的方案
旁路缓存策略的核心就两句话:先读缓存,缓存没有就读数据库,读完写入缓存;先更新数据库,再删除缓存。
注意:是先更新库再删缓存,不是先删缓存再更新库。
为什么这个顺序更好?因为数据库更新和缓存删除之间的时间窗口通常极短(微秒级),在这个窗口内恰好有读请求命中旧缓存的概率很低。而先删缓存再更新库的时间窗口(数据库写入耗时)要大得多。
如果还想要更强的一致性保证,可以参考下面的方案:
- Cache Aside(先更新库再删缓存),适用于大多数业务场景
- Cache Aside + TTL 兜底,适用于允许短暂不一致的场景
- Canal 监听 binlog + MQ 异步更新,适用于高一致性要求的场景
- 写请求加分布式锁串行化,适用于并发写冲突严重的场景
延迟双删不是完全不能用。在低并发、对一致性要求不高的场景下,它确实简单好理解。可一旦并发上来,它的每一个假设都可能被打破。
如果对一致性的要求高到需要延迟双删,那说明你该换更靠谱的方案;如果要求没那么高,那单纯的先更新库再删缓存就足够了。延迟双删刚好卡在一个尴尬的位置上。
 发表于 1 小时前
|
查看: 4|
回复: 0


