1. 背景
在 Redis 的日常运行中,AOF 文件重写、RDB 备份文件生成以及主从全量同步等场景,都需要通过系统调用 fork 的方式来创建一个子进程,从而拿到内存数据的快照。问题在于,当内核执行 fork() 创建子进程时,父进程的「页表」需要复制一份给子进程。随着内存数据量增大,页表体积也随之膨胀,复制页表带来的耗时越来越长。在此期间,业务请求访问 Redis 的读写延迟会被显著拉高。
最近,阿里云联合上海交大在数据库顶级会议 VLDB 上发表了一篇题为《Async-fork: Mitigating Query Latency Spikes Incurred by the Fork-based Snapshot Mechanism from the OS Level》的论文。论文提出了一种新的 fork 实现方案——Async-fork,核心思路是把 fork 调用过程中最耗时的页表拷贝环节从父进程挪到子进程去完成。父进程因此能够快速返回用户态继续处理业务请求,而页表拷贝则交由子进程异步执行。这样一来,fork 期间到达请求的尾延迟就能大幅降低,对于 Redis 这类内存数据库来说效果尤为明显。
2. 基本概念
在深入 Async-fork 的原理之前,先回顾几项与 fork 相关的基础概念。
2.1 物理内存地址
物理内存地址就是机器实际配备的物理内存所对应的地址空间,是真实存在的硬件地址。
2.2 虚拟地址空间
虚拟地址空间(Virtual Address Space)是每个程序被加载运行后,操作系统为其分配的虚拟内存。它为进程制造了一种假象——每个进程都仿佛独占整块主存。
每个进程能够访问的最大虚拟地址空间,取决于计算机的硬件平台,具体来说就是 CPU 的位数。例如 32 位 CPU 对应的就是我们常说的 4GB 虚拟内存空间。
程序访问内存时使用的是虚拟地址,操作系统负责将这个虚拟地址映射到合适的物理内存地址上。只要操作系统处理好映射关系,不同程序最终访问的物理内存区域就能彼此隔离,不会互相重叠,从而实现内存地址空间的隔离。
进程创建后,各自拥有一份独立的 4GB 虚拟地址空间。需要注意的是,这个 4GB 空间是"虚拟"的,并非真实存在。每个进程只能访问自己地址空间中的数据,无法越界读取其他进程的数据,这就是进程间地址隔离的由来。
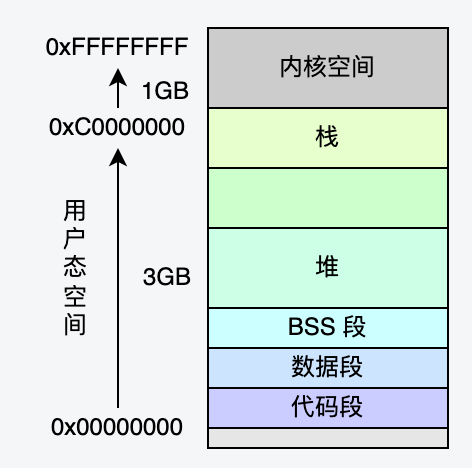
对于 Linux 系统,4GB 的虚拟地址空间分为用户态虚拟内存空间和内核态虚拟内存空间两部分,默认分配如下:
2.3 内存页表
「页表」保存的是虚拟内存地址与物理内存地址之间的映射关系。
当 CPU 访问数据时,它发出的是虚拟地址。CPU 内部的内存管理单元(MMU)通过查询页表,把虚拟地址转换为物理地址,然后再去访问物理内存。
2.3.1 内存分页
分页机制把整个虚拟和物理内存空间切成固定大小的块,这样一批连续且尺寸固定的内存空间就被称为页(Page)。在 Linux 下,每一页的大小通常是 4KB。
在 32 位环境下,虚拟地址空间总共 4GB。假设一个页的大小是 4KB(即 2^12),那么大约需要 100 万(2^20)个页。每个「页表项」需要 4 个字节来存储,那么整个 4GB 空间的映射就需要 4MB 的内存来存放页表。
4MB 的单进程页表看起来不算太大,但问题是每个进程都拥有自己的虚拟地址空间,也就都有自己的页表。一台机器上同时运行着大量进程,页表占用的内存总量就相当可观了。
2.3.2 多级页表
为了解决单级页表占用内存过高的问题,多级页表(Multi-Level Page Table)方案应运而生。
思路是把 100 多万个「页表项」的单级页表再次分页:将一级页表拆分为 1024 个二级页表,每个二级页表中包含 1024 个「页表项」,形成二级分页结构。这样,一级页表虽然能够覆盖整个 4GB 虚拟地址空间,但如果某个一级页表的页表项没有被用到,就不必创建它对应的二级页表。换句话说,内存中只需要保留一级页表以及实际使用到的二级页表,大量未使用的二级页表无需分配内存。这样就达到了节省页表所占内存空间的目的。
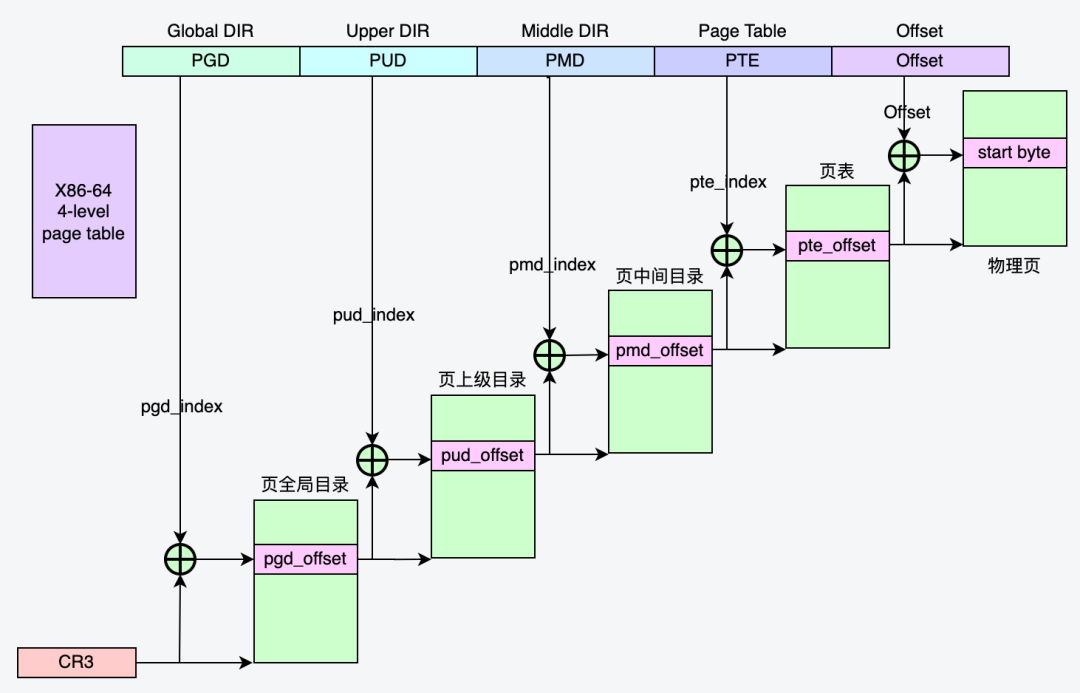
对于 64 位系统,页表层级扩展为四级分页目录,分别是:
- 页全局目录项 PGD(Page Global Directory)
- 页上级目录项 PUD(Page Upper Directory)
- 页中间目录项 PMD(Page Middle Directory)
- 页表项 PTE(Page Table Entry)
2.4 虚拟内存区域(VMA)
进程的虚拟内存空间由一段一段的虚拟内存区域(Virtual Memory Area,简称 VMA)组成。每个 VMA 描述了虚拟内存空间中的一段连续区域,而每个 VMA 又由大量虚拟页组成,也就是说,每个 VMA 内包含大量页表项 PTE。
3. Fork 原理
在默认 fork 的调用过程中,父进程需要把许多进程元数据(例如文件描述符、信号量、页表等)复制到子进程,其中页表的复制是其中最耗时的部分(占据 fork 调用耗时的 97% 以上)。
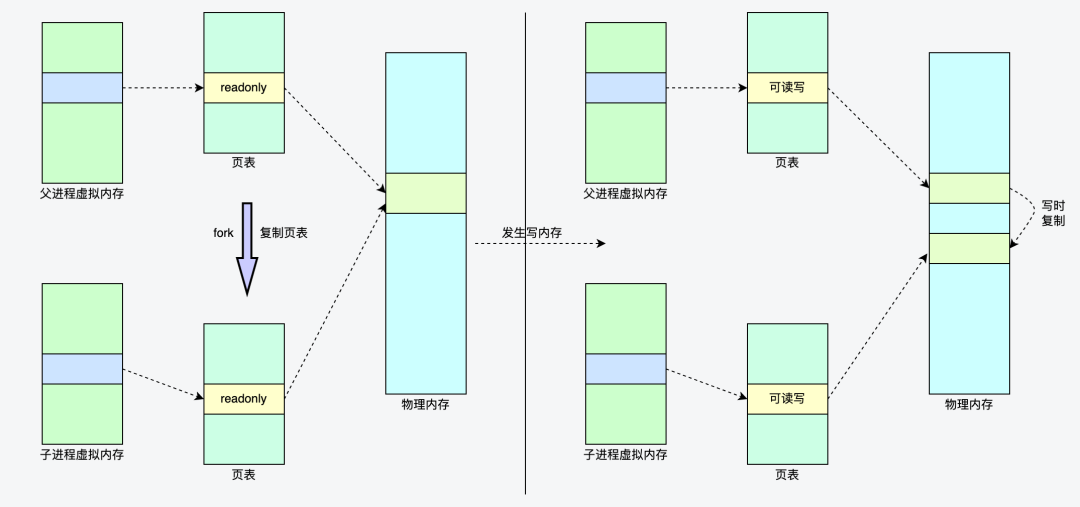
Linux 的 fork() 采用写时拷贝(Copy-On-Write)的方式实现。写时拷贝是一种可以推迟甚至完全避免数据复制的技术。在创建子进程时,操作系统会把父进程的「页表」复制一份给子进程,这份页表记录了虚拟地址与物理地址的映射关系。但此时操作系统并不会复制整个进程的物理内存,而是让父子进程共享同一块物理内存。同时,内核把所有共享内存页的权限都设为只读(read-only)。
那什么时候才会发生真正的物理内存复制呢?
当父进程或子进程向共享内存发起写操作时,MMU 检测到该内存页是只读的,于是触发缺页中断异常(page-fault)。处理器会从中断描述符表(IDT)中找到对应的处理程序。在中断处理过程中,内核会把触发异常的物理内存页复制一份,并重新设置映射关系,将父子进程对该内存页的读写权限改为可读写。此后父子进程各自拥有独立的内存页,进程才能继续执行写操作。这个过程就是写时复制(Copy On Write)。
4. Fork 的痛点
原生 fork 虽然使用了写时复制的优化手段,但在 fork() 调用期间,父进程依然需要复制页表,这会导致父进程出现短暂的阻塞。阻塞时间与页表大小直接相关——页表越大,阻塞时间越长。
在实际测试中,我们很容易观察到 fork 引发的阻塞现象,以及随之而来的 Redis 访问抖动。
4.1 测试环境
Redis 版本:优化前 Redis-server
机器操作系统:无 Async-fork 特性的系统
测试数据量:21.63G
127.0.0.1:6380> info memory
# Memory
used_memory:23220597688
used_memory_human:21.63G
4.2 阻塞现象复现
使用 redis-benchmark 压测的过程中,手动执行 bgsave 命令,观察 fork 耗时和压测指标 TP100。
通过 info stats 返回的上次 fork 耗时为 latest_fork_usec:183632,可以看到 fork 耗时达到了 183 毫秒。
在压测过程中分别不执行 bgsave 和执行 bgsave,结果如下:
# 压测过程中未执行 bgsave
[root@xxx bin]# redis-benchmark -d 256 -t set -n 1000000 -a xxxxxx -p 6380
====== SET ======
  1000000 requests completed in 8.15 seconds
  50 parallel clients
  256 bytes payload
  keep alive: 1

99.90% <= 1 milliseconds
100.00% <= 1 milliseconds
122669.27 requests per second

# 压测过程中执行 bgsave
[root@xxx bin]# redis-benchmark -d 256 -t set -n 1000000 -a xxxxxx -p 6380
====== SET ======
  1000000 requests completed in 13.97 seconds
  50 parallel clients
  256 bytes payload
  keep alive: 1

86.41% <= 1 milliseconds
86.42% <= 2 milliseconds
99.95% <= 3 milliseconds
99.99% <= 4 milliseconds
99.99% <= 10 milliseconds
99.99% <= 11 milliseconds
99.99% <= 12 milliseconds
100.00% <= 187 milliseconds
100.00% <= 187 milliseconds
71561.47 requests per second
从压测数据可以看到:单机环境下,未执行 bgsave 时 TP100 约 1 毫秒;一旦手动执行 bgsave 触发 fork 操作,TP100 飙升至 187 毫秒。
4.3 Strace 跟踪 fork 过程耗时
strace 常用来跟踪进程执行时的系统调用和所接收的信号。
$ strace -p 32088 -T -tt -o strace00.out
14:01:33.623495 clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7fbe5242fa50) = 37513 <0.183533>
14:01:33.807142 open("/data1/6380/6380.log", O_WRONLY|O_CREAT|O_APPEND, 0666) = 60 <0.000018>
14:01:33.807644 lseek(60, 0, SEEK_END) = 8512 <0.000017>
14:01:33.807690 stat("/etc/localtime", {st_mode=S_IFREG|0644, st_size=528, ...}) = 0 <0.000010>
14:01:33.807732 fstat(60, {st_mode=S_IFREG|0644, st_size=8512, ...}) = 0 <0.000007>
14:01:33.807756 mmap(NULL, 4096, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7fbe52437000 <0.000009>
14:01:33.807787 write(60, "35994:M 21 Mar 14:01:33.807 * Ba"..., 69) = 69 <0.000015>
14:01:33.807819 close(60) = 0 <0.000008>
14:01:33.807845 munmap(0x7fbe52437000, 4096) = 0 <0.000013>
Linux 中 fork() 底层通过 clone() 系统调用实现。从 trace 结果可以看到,clone 系统调用耗时 183 毫秒,与 info stats 统计的 fork 耗时一致。
5. Async-fork
面对 Linux 原生 fork 系统调用的上述痛点,对于 Redis 这类高性能内存数据库来说,fork 期间的访问延迟上升是不可忽视的。论文提出的 Async-fork 正是为了解决这一问题。
Async-fork 的核心设计思想是将 fork 调用中最耗时的页表拷贝工作从父进程转移到子进程,从而缩短父进程陷入内核态的时间。父进程可以迅速返回用户态处理查询请求,而子进程则在此过程中完成页表拷贝。与 Linux 默认的 fork 相比,Async-fork 显著降低了 Redis 快照期间到达请求的尾延迟。
5.1 Async-fork 的挑战
不过,Async-fork 的实现并不像说起来那么简单。页表的异步复制操作可能引发快照不一致的问题。以下图为例:Redis 在 T0 时刻保存内存快照,而某个用户请求在 T2 时刻向 Redis 插入了新的键值对(k2, v2),这将导致父进程修改它的页表项(PTE2)。假如 T2 时刻这个被修改的 PTE2 还没有被子进程复制完成,这个修改后的页表项及对应内存页后续就会被复制到子进程,新插入的键值对将被写入硬盘,从而破坏快照一致性——快照文件本应记录的是拍摄快照那一刻的内存数据。
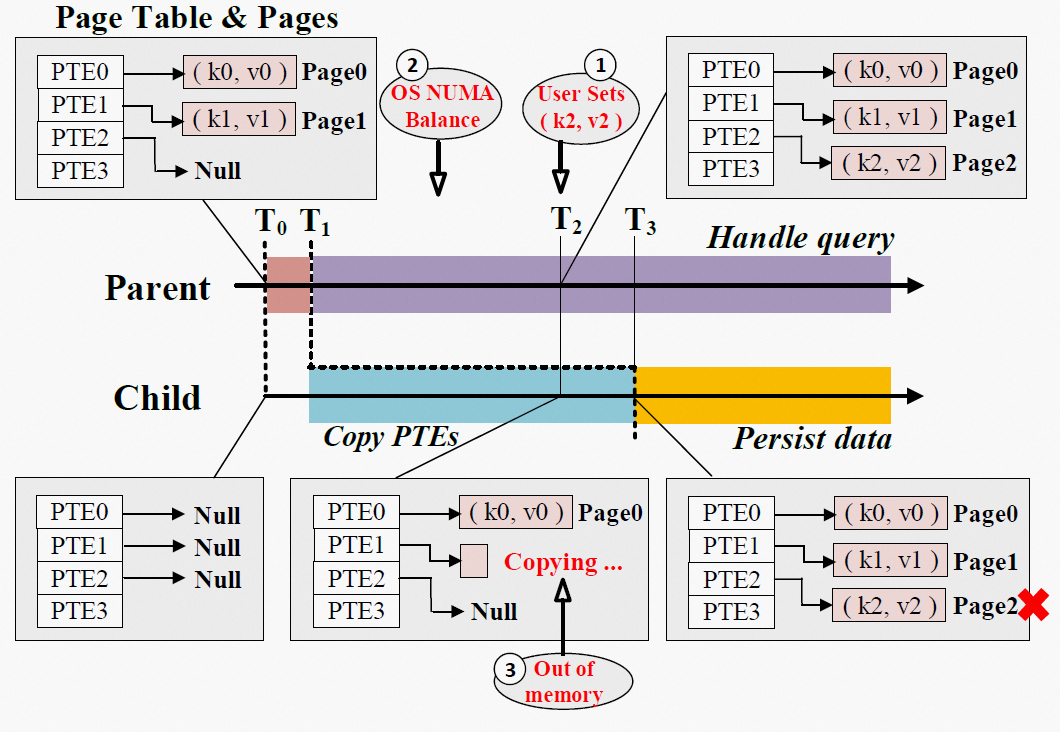
图片来源于:参考资料[1] 第 8 页
5.2 Async-fork 详解
前面提到,每个进程都有自己的虚拟内存空间,Linux 使用一组 VMA 来描述进程的虚拟内存空间,每个 VMA 包含大量页表项。
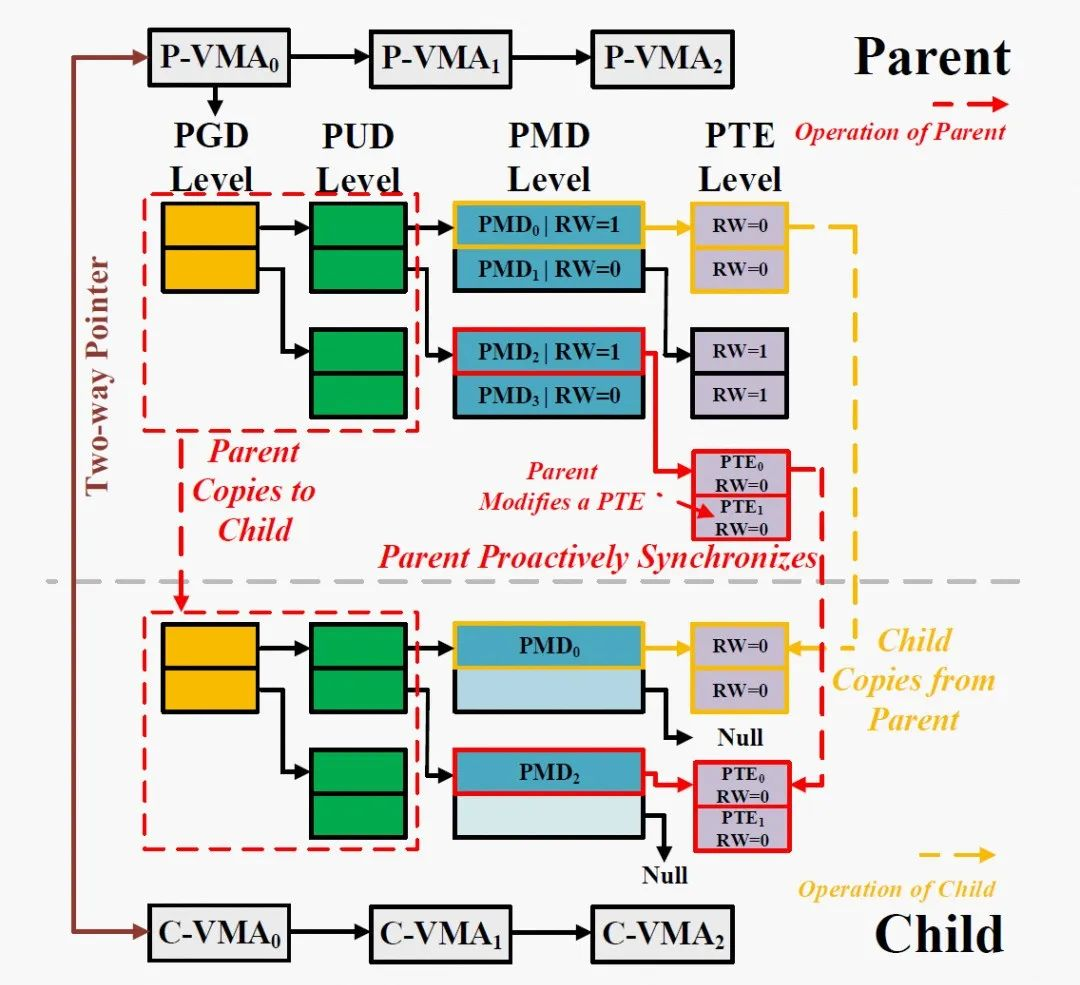
在默认 fork 中,父进程遍历每个 VMA,把每个 VMA 复制到子进程,并自上而下地逐级复制该 VMA 对应的页表项。对于 64 位系统,四级分页目录(PGD、PUD、PMD、PTE)全部由父进程逐级复制完成。而在 Async-fork 中,父进程同样遍历每个 VMA,但只负责把 PGD 和 PUD 这两级页表项复制到子进程。
随后,父进程将子进程调度到某个 CPU 上开始运行,自己则返回用户态继续响应用户请求。剩下的 PMD 和 PTE 两级页表复制工作,交由子进程来完成。
图片来源于:参考资料[1] 第 7 页
那么问题来了:父进程返回用户态后,在子进程复制页表期间,如果父进程需要修改尚未完成复制的页表项,该如何避免前面提到的快照不一致问题?
5.2.1 主动同步机制
父进程返回用户态后,它的 PTE 随时可能被修改。如果在子进程复制页表期间,父进程检测到 PTE 被修改,就会触发主动同步机制:父进程也加入页表复制的行列,主动完成被修改页表项的复制工作,确保 PTE 在修改之前已经被复制到子进程。
当一个 PTE 即将被修改时,父进程不只是复制这一个 PTE,而是同时把同一张页表上的所有 PTE(共 512 个)连同它的父级 PMD 项一起复制到子进程。
父进程中的 PTE 发生修改时,如果子进程已经复制过这个 PTE,父进程就不需要再复制了,否则会造成重复复制。那么如何区分某个 PTE 是否已经被复制过呢?
Async-fork 使用 PMD 项上的 RW 位来标记复制状态。具体来说,当父进程第一次返回用户态时,它所有的 PMD 项都被设置为写保护(RW=0),表示这个 PMD 项以及它指向的 512 个 PTE 尚未复制到子进程。当子进程复制某个 PMD 项时,通过检查该 PMD 是否为写保护即可判断是否已经复制。如果尚未复制,子进程就会复制这个 PMD 及其指向的 512 个 PTE。
完成复制后,子进程将父进程中的该 PMD 设置为可写(RW=1),表示这个 PMD 及其指向的 512 个 PTE 已经复制到子进程。父进程触发主动同步时,同样通过检查 PMD 项的写保护位来判断复制状态。此外,在复制 PMD 项和 PTE 时,父子进程都会锁定 PTE 表,避免同时复制同一 PMD 项指向的 PTE 而引发竞态。
在操作系统中,PTE 的修改分为两类:
- VMA 级修改。例如创建、合并、删除 VMA 等操作,作用于特定 VMA 上。这类修改通常会导致大量 PTE 变动,因此涉及大量 PMD。
- PMD 级修改。仅涉及单个 PMD 的改动。
5.2.2 错误处理
Async-fork 在复制页表时涉及内存分配,错误在所难免。例如,由于内存不足,进程可能无法申请到新的 PTE 表。一旦发生错误,需要把父进程恢复到调用 Async-fork 之前的状态。
在 Async-fork 执行过程中,父进程的 PMD 项 RW 位可能已经被修改。因此错误发生时,必须将所有 PMD 项回滚为可写状态。
6. Redis 优化实践
6.1 Async-fork 阻塞现象
在支持 Async-fork 的操作系统(即 Tair 专属操作系统镜像)上进行测试。理论上,按照论文的预期,用户无需任何代码修改——Async-fork 复用了原生 fork 的接口,没有新增系统调用——就能直接受益。然而,使用 Redis 实际测试的结果并不符合预期:在 Redis 压测过程中手动执行 bgsave 触发 fork,依然观察到了 TP100 抖动。
测试环境
Redis 版本:优化前 Redis-server
机器操作系统:Tair 专属操作系统镜像
测试数据量:54.38G
127.0.0.1:6679> info memory
# Memory
used_memory:58385641120
used_memory_human:54.38G
问题现象
现象是:fork 耗时正常,但压测过程中执行 bgsave 时 TP100 异常。
压测过程中执行 bgsave,info stats 返回的上次 fork 耗时为 latest_fork_usec:426。TP100 结果如下:
# 压测过程中执行 bgsave
[root@xxx ~]# /usr/bin/redis-benchmark -d 256 -t set -n 1000000 -a xxxxxx -p 6679
====== SET ======
  1000000 requests completed in 7.88 seconds
  50 parallel clients
  256 bytes payload
  keep alive: 1

100.00% <= 411 milliseconds
100.00% <= 412 milliseconds
100.00% <= 412 milliseconds
126871.35 requests per second
也就是说,fork 耗时看起来正常了,但压测过程中 Redis 仍然出现了明显的尾延迟,这显然不符合预期。
追踪过程
使用 strace 命令进行分析,结果如下:
$ strace -p 32088 -T -tt -o strace00.out
14:18:12.933441 clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7f461c0daa50) = 13772 <0.000380>
14:18:12.933884 open("/data1/6679/6679.log", O_WRONLY|O_CREAT|O_APPEND, 0666) = 60 <0.000019>
14:18:12.933948 lseek(60, 0, SEEK_END) = 11484 <0.000013>
14:18:12.933983 stat("/etc/localtime", {st_mode=S_IFREG|0644, st_size=556, ...}) = 0 <0.000016>
14:18:12.934032 fstat(60, {st_mode=S_IFREG|0644, st_size=11484, ...}) = 0 <0.000014>
14:18:12.934062 mmap(NULL, 4096, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f461c0e4000 <0.358768>
14:18:13.292883 write(60, "32088:M 21 Mar 14:18:12.933 * Ba"..., 69) = 69 <0.000032>
14:18:13.292951 close(60) = 0 <0.000014>
14:18:13.292980 munmap(0x7f461c0e4000, 4096) = 0 <0.000019>
再单独追踪内存相关的系统调用:
$ strace -p 11559 -T -tt -e trace=memory -o trace00.out
14:18:12.934062 mmap(NULL, 4096, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f461c0e4000 <0.358768>
14:18:13.292980 munmap(0x7f461c0e4000, 4096) = 0 <0.000019>
可以看到,clone 耗时 380 微秒,确实已经大幅降低,也就是说 fork 快速返回了用户态。但紧接着出现了一个 mmap 调用,耗时高达 358 毫秒,与 TP100 数据非常接近。
为什么一次 mmap 会这么慢?原因在于 mmap 系统调用需要在当前进程的虚拟地址空间中寻找一段满足大小要求的虚拟地址,并为此分配一个虚拟内存区域(vm_area_struct 结构),这会触发 VMA 级虚拟页表变化。这样一来,父进程的主动同步机制被触发,父进程被迫帮助子进程完成相应页表的复制。VMA 级虚拟页表变化需要把对应的三级和四级页目录都复制到子进程,因此耗时相当高。
那么,这个 mmap 调用又是从哪里来的呢?
定位问题
perf 是 Linux下的一款性能分析工具,能够进行函数级与指令级的热点查找。
通过 perf trace 可以查看响应调用堆栈及耗时,分析结果如下:
$ perf trace -p 11559 -o trace01.out --max-stack 15 -T
616821913.647 (358.740 ms): Redis-server_4/32088 mmap(len: 4096, prot: READ|WRITE, flags: PRIVATE|ANONYMOUS) = 0x7f461c0e4000
                                       __mmap64 (/usr/lib64/libc-2.17.so)
                                       __GI__IO_file_doallocate (inlined)
                                       __GI__IO_doallocbuf (inlined)
                                       __GI__IO_file_overflow (inlined)
                                       _IO_new_file_xsputn (inlined)
                                       _IO_vfprintf_internal (inlined)
                                       __GI_fprintf (inlined)
                                       serverLogRaw (/usr/local/Redis/Redis-server)
                                       serverLog (/usr/local/Redis/Redis-server)
                                       rdbSaveBackground (/usr/local/Redis/Redis-server)
                                       bgsaveCommand (/usr/local/Redis/Redis-server)
                                       call (/usr/local/Redis/Redis-server)
                                       processCommand (/usr/local/Redis/Redis-server)
                                       processInputBuffer (/usr/local/Redis/Redis-server)
                                       aeProcessEvents (/usr/local/Redis/Redis-server)

616822272.562 ( 0.010 ms): Redis-server_4/32088 munmap(addr: 0x7f461c0e4000, len: 4096) = 0
                                       __munmap (inlined)
                                       __GI__IO_setb (inlined)
                                       _IO_new_file_close_it (inlined)
                                       _IO_new_fclose (inlined)
                                       serverLogRaw (/usr/local/Redis/Redis-server)
                                       serverLog (/usr/local/Redis/Redis-server)
                                       rdbSaveBackground (/usr/local/Redis/Redis-server)
                                       bgsaveCommand (/usr/local/Redis/Redis-server)
                                       call (/usr/local/Redis/Redis-server)
                                       processCommand (/usr/local/Redis/Redis-server)
                                       processInputBuffer (/usr/local/Redis/Redis-server)
                                       aeProcessEvents (/usr/local/Redis/Redis-server)
                                       aeMain (/usr/local/Redis/Redis-server)
                                       main (/usr/local/Redis/Redis-server)
调用栈清晰地指向了 serverLogRaw 函数——在 bgsave 执行逻辑中,有一处打印日志的 fprintf 调用了 mmap。这应该就是 fork 返回父进程后,父进程中的某个日志输出操作触发的。
6.2 Async-fork 适配优化
找到了问题代码位置,就可以做针对性优化。针对此处的日志影响,有两个选择:屏蔽日志,或者把日志打印移到子进程中执行。通过同样的分析手段,如果发现其他类似影响,也都可以做对应优化。
完成适配优化修改后,再次进行测试。
测试环境
Redis 版本:优化后 Redis-server
机器操作系统:Tair 专属操作系统镜像
测试数据量:54.38G
127.0.0.1:6680> info memory
# Memory
used_memory:58385641144
used_memory_human:54.38G
现象
在压测过程中执行 bgsave,fork 耗时和 TP100 均正常。
info stats 返回的上次 fork 耗时为 latest_fork_usec:414。TP100 结果如下:
# 压测过程中执行 bgsave
[root@xxx Redis]# /usr/bin/redis-benchmark -d 256 -t set -n 1000000 -a dRedis123456 -p 6680
====== SET ======
  1000000 requests completed in 7.50 seconds
  50 parallel clients
  256 bytes payload
  keep alive: 1

99.99% <= 1 milliseconds
99.99% <= 2 milliseconds
100.00% <= 2 milliseconds
133386.69 requests per second
跟踪验证
再次使用 strace 和 perf 工具进行验证。strace 跟踪父进程只看到 clone 调用,耗时仅 378 微秒:
# strace -p 14697 -T -tt -o strace04.out
14:42:00.723224 clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7fa5340d0a50) = 15470 <0.000378>
perf trace 跟踪父进程同样只观察到 clone 调用:
# perf trace -p 14697 -o trace04.out --max-stack 15 -T
618249694.830 ( 0.423 ms): Redis-server/14697 ... [continued]: clone()) = 15470 (Redis-server)
                                       __GI___fork (inlined)
                                       rdbSaveBackground (/usr/local/Redis/Redis-server)
                                       bgsaveCommand (/usr/local/Redis/Redis-server)
                                       call (/usr/local/Redis/Redis-server)
                                       processCommand (/usr/local/Redis/Redis-server)
                                       processInputBuffer (/usr/local/Redis/Redis-server)
                                       aeProcessEvents (/usr/local/Redis/Redis-server)
                                       aeMain (/usr/local/Redis/Redis-server)
                                       main (/usr/local/Redis/Redis-server)
既然优化方案是把触发 mmap 的日志移到子进程中,再用 perf trace 跟踪 fork 产生的子进程就能验证。使用以下命令跟踪子进程:
strace -p 14697 -T -tt -f -ff -o strace05.out
通过 Redis 日志文件确认子进程 pid 为 15931,打开对应生成的子进程 strace 信息文件 strace05.out.15931(父进程的信息保存在 strace05.out.14697 中):
# 以下为子进程 strace 信息
14:47:40.878387 mmap(NULL, 4096, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7fa5340da000 <0.000008>
14:47:40.878415 write(6, "15931:C 21 Mar 14:47:40.878 * Ba"..., 69) = 69 <0.000015>
14:47:40.878447 close(6) = 0 <0.000006>
14:47:40.878467 munmap(0x7fa5340da000, 4096) = 0 <0.000010>
14:47:40.878494 open("temp-15931.rdb", O_WRONLY|O_CREAT|O_TRUNC, 0666) = 6 <0.000020>
14:47:40.878563 fstat(6, {st_mode=S_IFREG|0644, st_size=0, ...}) = 0 <0.000006>
14:47:40.878584 mmap(NULL, 4096, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7fa5340da000 <0.000006>
在子进程中看到了 mmap 调用。子进程中的这些操作不会影响父进程响应业务请求,问题就此解决。
7. 性能测试
修改 Redis 代码并对 Async-fork 进行适配优化后,我们针对原生 fork 与 Async-fork 做了性能对比测试。测试涵盖不同数据量下 fork() 命令的耗时,以及 fork() 操作对压测过程中 TP100 的影响。
7.1 fork() 命令耗时
fork() 命令耗时,即在 Redis 中执行 bgsave 命令后,通过 info stats 看到的 latest_fork_usec 用时。
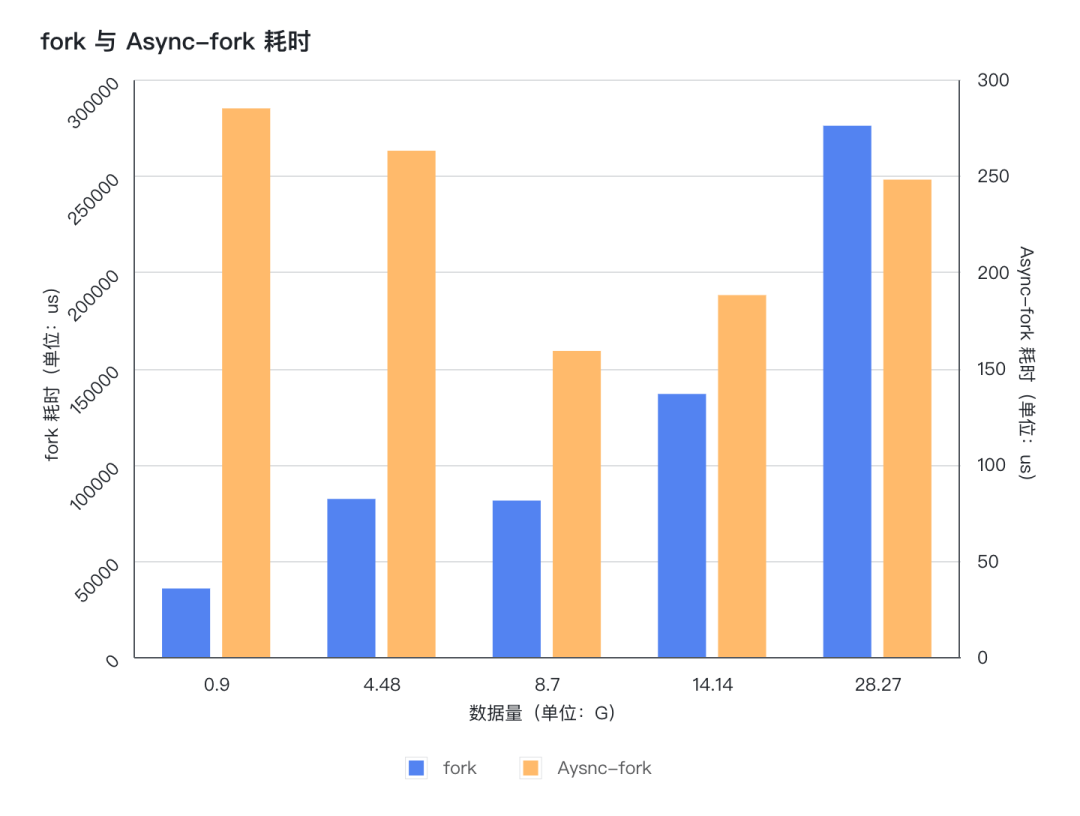
注:由于 fork 与 Async-fork 系统下 fork() 操作产生的 latest_fork_usec 数据差距非常悬殊,使用单纵轴会导致 Async-fork 的数据在图表中显示不明显,不方便查看,因此该图表使用了双纵轴。虽然 Async-fork 的柱形看起来不低,但实际右纵轴范围很小,所以数据其实很小。
从图表可以看出,使用支持 Async-fork 的操作系统后,fork() 操作产生的耗时极低。不管数据量多大,耗时都相当稳定,基本维持在 200 微秒左右。而原生 fork 产生的耗时会随着数据量增长而攀升,从几十毫秒一路涨到几百毫秒。
7.2 TP100 抖动
在使用 redis-benchmark 压测过程中,手动执行 bgsave 命令触发操作系统 fork(),观察不同数据量下原生 fork 与 Async-fork 对 Redis 压测 TP100 的影响。
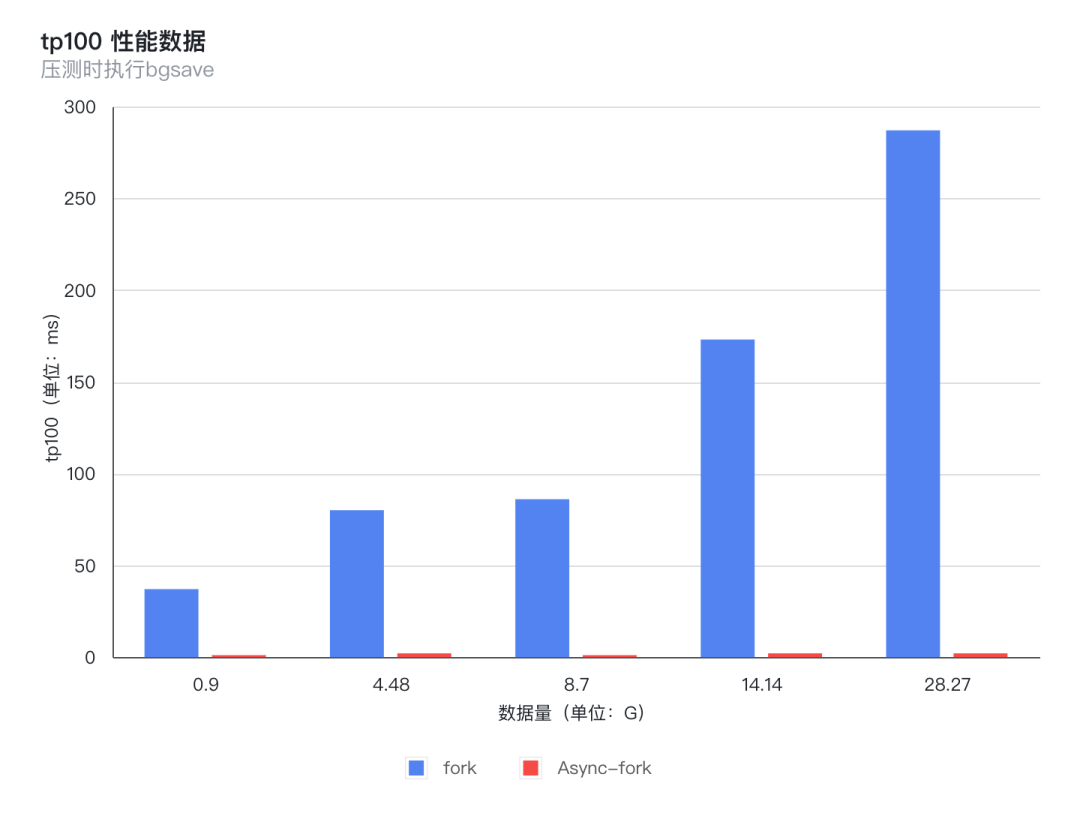
从图上可以看出,使用支持 Async-fork 的操作系统后,fork() 操作对 Redis 压测产生的性能影响非常小,提升相当明显。不论数据量多大,耗时都稳定在 1-2 毫秒左右。而原生 fork 产生的抖动时间随数据量增长而增长,TP100 从几十毫秒上升到几百毫秒。
8. 总结
通过不同数据量下的对比测试,Async-fork 相比原生 fork 的阻塞时间大幅减少,性能提升十分显著。更重要的是,阻塞时间非常稳定,不会随数据量增长出现倍数级恶化。
在单机测试场景下,8G 数据量规模时,TP100 和 latest_fork_usec 的耗时均降低了 98% 以上。
基于论文中 Async-fork 的设计思想,Tair 专属操作系统镜像已经支持该特性,并将其集成进原生 fork 中,没有新增系统调用接口。理论上用户只需要使用支持 Async-fork 的操作系统,程序无需任何改动即可享受性能红利。对于 Redis 来说,也只需稍加适配——比如把可能触发 VMA 级页表变化的日志操作移到子进程——就能充分获得这项技术带来的收益。
在 Redis 的典型应用场景中,比如添加从节点、RDB 文件备份、AOF 持久化文件重写等操作,部署在支持 Async-fork 的操作系统上,都能极大降低对业务请求的影响。如果你对 fork 的底层机制和内核优化方向感兴趣,也欢迎在云栈社区与更多开发者交流讨论。
参考资料
[1] 《Async-fork: Mitigating Query Latency Spikes Incurred by the Fork-based Snapshot Mechanism from the OS Level》
 发表于 1 小时前
|
查看: 0|
回复: 0


