FastRPC 是什么
10 月 1 日,高通发布骁龙 X2 的 Linux 开发者预览,Hexagon NPU 第一次通过上游化的 FastRPC 驱动暴露给用户态。要理解这件事,得先弄清 FastRPC 是什么、它怎样让 CPU 调用 NPU,以及高通这套 NPU 生态长什么样。
FastRPC 是高通的远程过程调用框架,作用是让 CPU 上的程序调用 Hexagon DSP 或 NPU 上的函数,写起来就像调用本地函数。CPU 运行 Linux,Hexagon 运行自己的实时系统 QuRT,两者指令集不同、地址空间也不同。FastRPC 把跨处理器的通信细节藏了起来,程序员面对的是 IDL 接口定义语言描述的一组函数签名。
IDL 文件写清楚 CPU 能调哪些函数、每个参数怎么传。高通的 QAIC 编译器读取这份 IDL,生成两段胶水代码:Stub 链接进 CPU 端,负责把参数打包成 RPC 消息;Skel 链接进 Hexagon 端,负责解包参数并调用真正的实现。参数有方向,in 表示 CPU 序列化后发给 Hexagon,rout 表示 CPU 先预分配一块空 buffer,Hexagon 直接把结果写进去。
一次远程调用的流程
一次完整的远程调用中,数据从 CPU 进程出发,进入 stub 转成 RPC 消息,经内核驱动排队,再由 GLINK 这条处理器间通道发到 Hexagon 侧的 FastRPC 框架,分派给 skel。skel 解包参数、调用实现,算完再原路打包返回。整个过程对 CPU 进程透明,它只看到函数返回了结果。每个会话用一个不透明的 64 位 handle 标识。DSP 开始前后,驱动还要做缓存 flush 和 invalidate,保证两边看到的内存一致。
真正要紧的是内存。Hexagon 和 CPU 共享同一块物理 DRAM,FastRPC 用 SMMU 给 Hexagon 划出一块共享地址空间,用 ION 或 DMA-BUF 做零拷贝。CPU 侧用 rpcmem_alloc 在远程堆上分配 buffer,两边看到的是同一块物理页,不用来回拷贝。所以大模型推理时,权重 buffer 可以在 NPU 和 CPU 之间共享,没有独立显卡那种“拷到显存”的步骤。骁龙这种统一内存架构,正是 FastRPC 零拷贝能成立的前提。
Hexagon NPU 和它的软件生态
Hexagon 这条线从手机 DSP 一路演进过来。早期 V65、V66 只做标量和向量,V68 在骁龙 888 上引入 HTA,也就是 Hexagon Tensor Accelerator,专门做矩阵乘。往后几代陆续加入 INT4 支持、直连内存等能力。现在的 Hexagon NPU 是三级计算单元拼起来的:HTA 跑大规模矩阵运算,HVX 跑 1024 位向量和自定义算子,Scalar 核跑控制流。骁龙 X Elite 标称 45 TOPS,X2 达到 85 TOPS。
软件生态的关键在 QNN。QNN 是高通统一的底层推理接口,把不同硬件后端抽象成一套 API,同一份模型能部署到 NPU、GPU、CPU 或 DSP 上。往上是 ONNX Runtime 的 QNN execution provider、llama.cpp 的 QNN 后端、微软 Foundry Local 这类本地推理运行时。这几层叠起来,开发者只要写好 ONNX 或 GGUF 模型,就能落到 Hexagon NPU 上运行。手机上的音频、影像、传感器融合,走的是同一套 FastRPC 在向 Hexagon 派活。
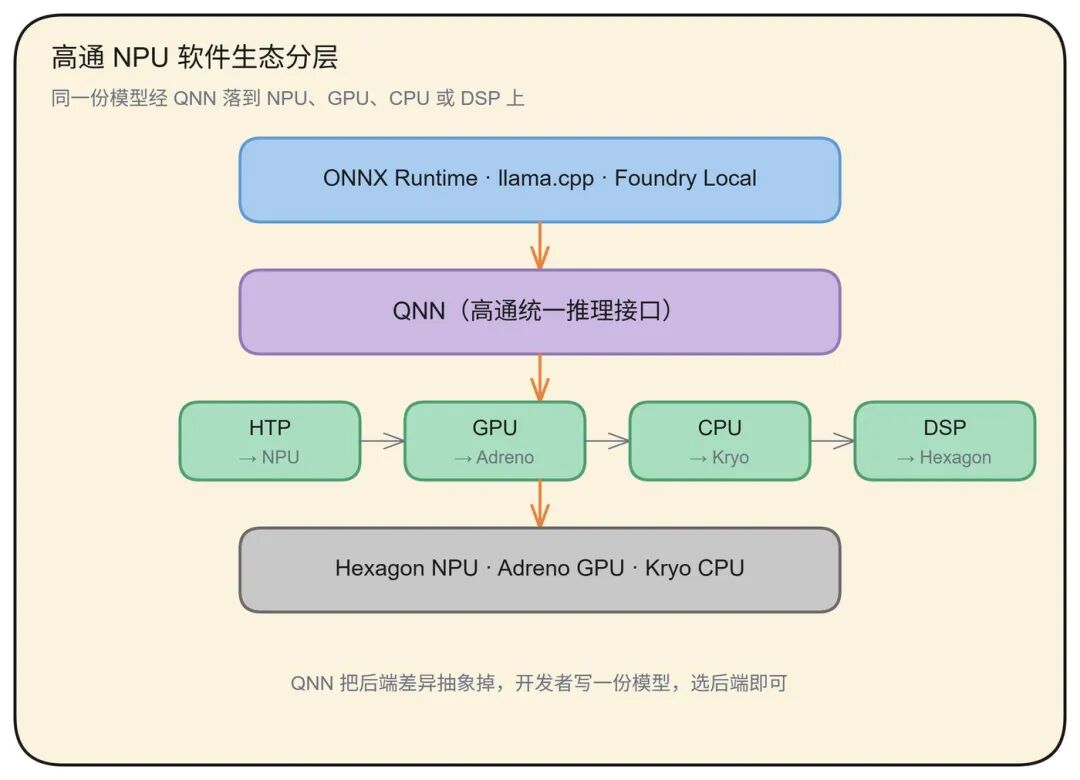
在这套生态上,Llama 3.2 3B 的 INT4 量化版能跑到每秒 30 个 token 上下。模型要先经 QNN 转换器编成 context binary,NPU 才能执行,GGUF 不能直接喂进去。
为什么这次要合主线
FastRPC 在手机上是老技术,但它一直待在 out-of-tree。闭源的 DSP 固件、专有的守护进程,再加上发行版私打的补丁,把 Hexagon 挡在主线之外。骁龙 X Elite 一代在 Linux 上就吃了这个亏:固件要从 Windows 分区里提取,摄像头、扬声器缺失,做 Linux 笔记本的 TUXEDO 半途放弃。
这次高通把 FastRPC 驱动上游合入主线,等于在标准内核里打开了一条从用户态到 NPU 的通路。推理框架调 NPU 不再经过专有 daemon,也不依赖某个发行版的补丁。对开发者来说,这等于能像调 CPU 一样调 NPU,ONNX Runtime 和 llama.cpp 这些开源运行时可以在主线内核上直接对接 Hexagon,不用再维护一套私有驱动栈。
什么时候能用
现在放出的是早期预览。Debian 13 用户空间配一个定制内核,能启动、能走 USB 和 PCIe、能点亮屏幕,但电源、睡眠、音频还没到位。路线分三阶段:11 月底关闭主要外设缺口,2027 上半年 Canonical 推出认证的 Ubuntu,华硕 Zenbook A14、A16 和惠普跟进。想开箱即用,得等到明年上半年;想现在动手,就要自己编译内核和设备树。虽然只是预览,但 FastRPC 驱动已经在主线里,NPU 推理这条路的骨架已经通了。
信源:Qualcomm FastRPC 文档 · DeepWiki adsprpc 源码 · vdesmond Hexagon deep-dive · 高通端侧 AI 实战
 发表于 2 小时前
|
查看: 1|
回复: 0


