多 Agent 系统里,同步调用链越长越脆。Kafka 用事件流把调用关系换成发布订阅,承接任务解耦、行为审计与多 Agent 协作。本文拆清它与任务队列的边界,以及什么时候才值得上量。
一、同步链路撑不起多 Agent 协作
多 Agent 系统的第一反应往往是把流程串成一条 HTTP 链,A 调 B,B 调 C。看起来直观,隐患从第二个节点就开始埋。链路上任何一环超时,整条链作废重来,故障半径等于链长;重试一层层叠加,高峰期的重试风暴能把下游打穿;想加一个新 Agent 进流程,得改上游代码重新发版,扩展成本随节点数上涨。这些都指向同一个结论:同步调用把本该独立的几个 Agent 焊成了一根绳上的蚂蚱。
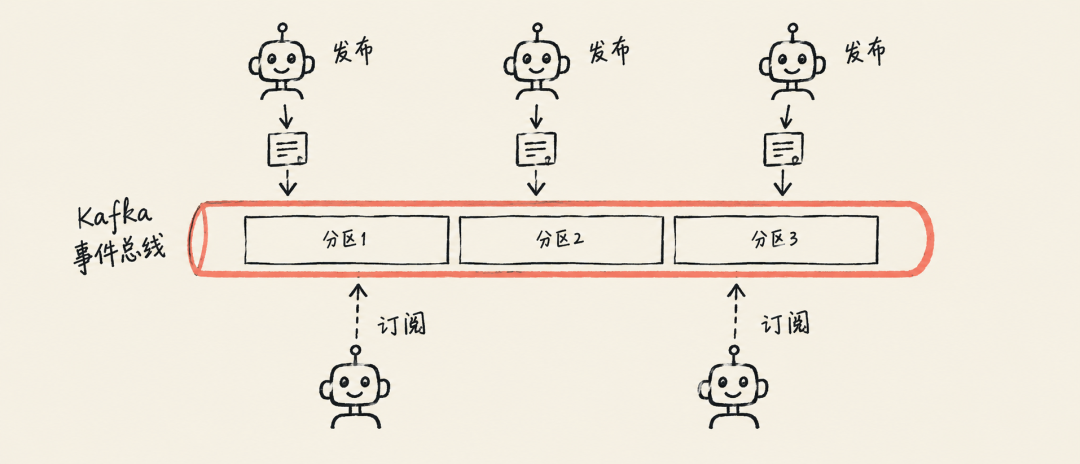
换成事件流的思路,关系就变了。Agent 完成一步,往主题里发一条事件,发完就回来继续干活;下游的 Agent 订阅自己关心的主题,看到事件再处理。上游只管发布"发生了什么",谁来消费、何时消费,与它无关。新增一个 Agent 变成多加一个订阅者,扩展从改代码变成加配置。Kafka 的位置由此确定——它是事件流的载体,不是又一个消息队列的替代品。这两件事的边界第三节细说。
削峰和故障隔离是同步架构给不了的两重能力。见过一个真实场景:每天凌晨的批量巡检任务,几百个 Agent 同时开工,同步架构下下游接口直接被打挂。换成事件流之后,这些请求先进主题排队,下游按自己的消费能力匀速处理,高峰被平滑掉。故障隔离更明显——某个下游 Agent 短暂宕机,事件在主题里安安静静等着,它恢复后接着消费,上游全程无感。这种容错在同步链路里要靠一层层重试逻辑硬挨出来。
二、主题、分区、消费组,三个概念够用了
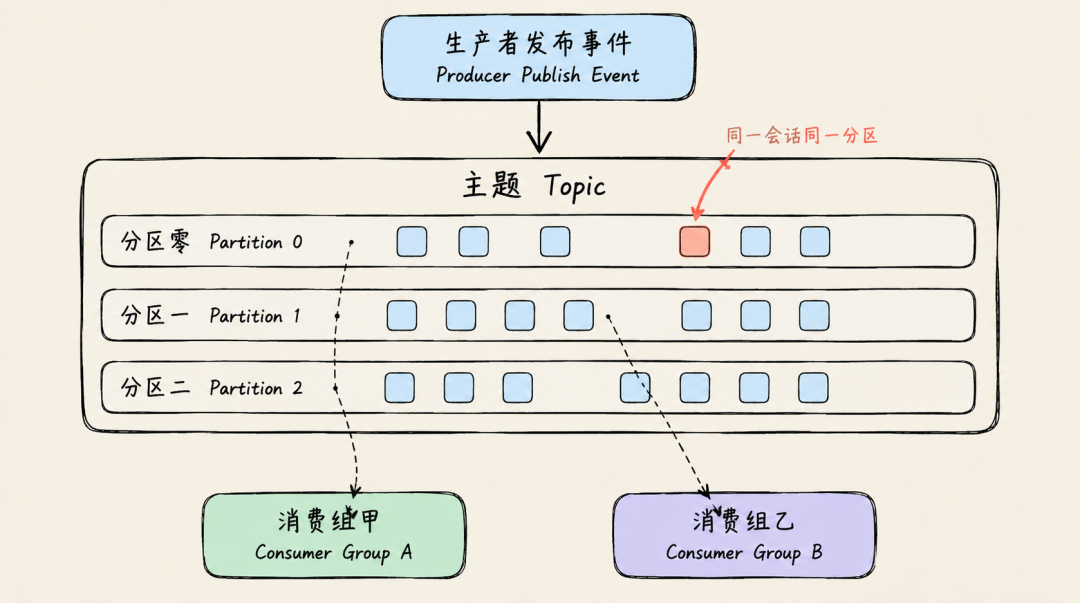
Kafka 的概念不少,撑起 Agent 场景的核心是三个。主题按业务语义切:agent.lifecycle 放会话和任务的生死事件,tool.calls 放工具调用记录,human.review 放需要人介入的审批事件。名字清晰,订阅关系才不乱。分区决定并行度和顺序性,生产者按业务键路由,会话 ID 或者任务 ID 做键。分区内有序,分区间无序,按业务键选分区,同一个会话的状态变更顺序才有保障——乱序的状态事件会让下游状态机错乱。
消费组是横向扩容的单位。一组消费者分摊一个主题的全部分区,消费能力不够就加实例,Kafka 自动把分区分给新成员。重平衡会带来短暂停顿,消费逻辑写得重的话,抖动期间会积压,容量规划时这点要留余量。
还有一条容易被跳过的纪律:消费必须幂等。Kafka 的投递语义默认 at-least-once,网络抖动、消费者重启都可能让同一条事件被消费两次。下游的状态更新和台账写入必须能扛住重复投递,上一篇讲的幂等键在这里原样适用。做事件驱动之前,先把消费端的防重能力练出来。
消费位移是 Kafka 的记账本,消费者每处理完一条消息就提交位移,重启后从上次位置接着消费。提交时机有讲究:先处理后提交,代价是崩溃后可能重复消费一条,配合幂等没毛病;先提交后处理,代价是可能丢一条。Agent 场景宁重复不丢失,前者是默认选择。重平衡期间,位移未提交的分区会被重新分配,这也是重复消费的高发时刻,消费逻辑的幂等设计会在这些时刻被反复验证。
三、解耦任务之前,先分清总线和队列
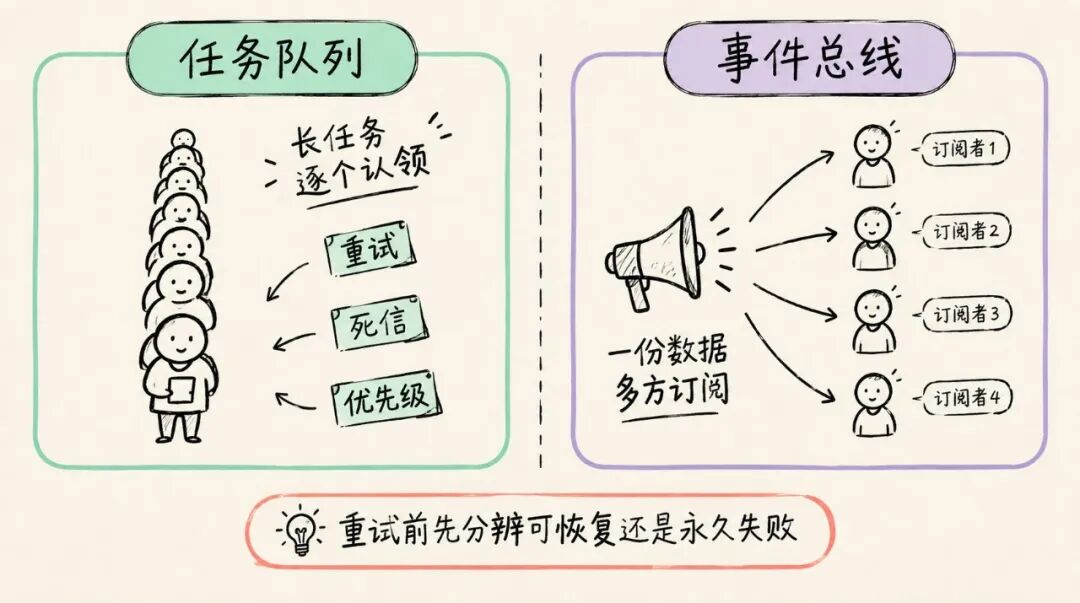
消息总线和任务队列经常被混为一谈,关注点其实不同。队列关心单个任务被执行且只被执行一次,重试、死信、优先级是它的核心语义。长耗时的工具调用——跑测试、爬数据、生成报告——放进队列由消费者逐个认领。总线关心事件的流动与广播:状态通知、结果发布、跨团队的数据分发。两者用 Kafka 一套兼任能跑,但重试这类语义最好分开设计。混在一个主题里,下游很难区分这是要认领的任务,还是仅需要知晓的通知。
重试语义值得展开说。工具调用失败可能是超时、限流,也可能是参数写错、权限不够。前者退避后重试有意义,后者重试一万次也不会成功。重试策略不区分失败类别的队列,迟早会在坏任务上空转,消耗的是真金白银的 token 和下游配额。可恢复的失败按指数退避重试三次,仍然失败就进死信主题等人工介入;永久失败直接落死信并记录原因。这套规则不复杂,缺了它,系统的自我修复能力就是伪命题。
死信主题不是垃圾桶,是待办清单。每条死信带着失败原因、原始载荷和上下文进去,配一个专门的消费组做归纳统计,失败原因聚合成报表,哪类错误占比高就优先修哪类。见过不少团队的死信主题积压几十万条没人看——那不是 Kafka 的问题,是运维纪律的问题。死信积压量应该和业务告警同级对待,进了死信的任务要有台账、有认领人、有处理时限,逾期未处理要有人接手。
四、多 Agent 协作靠事件编排而不是互相调用
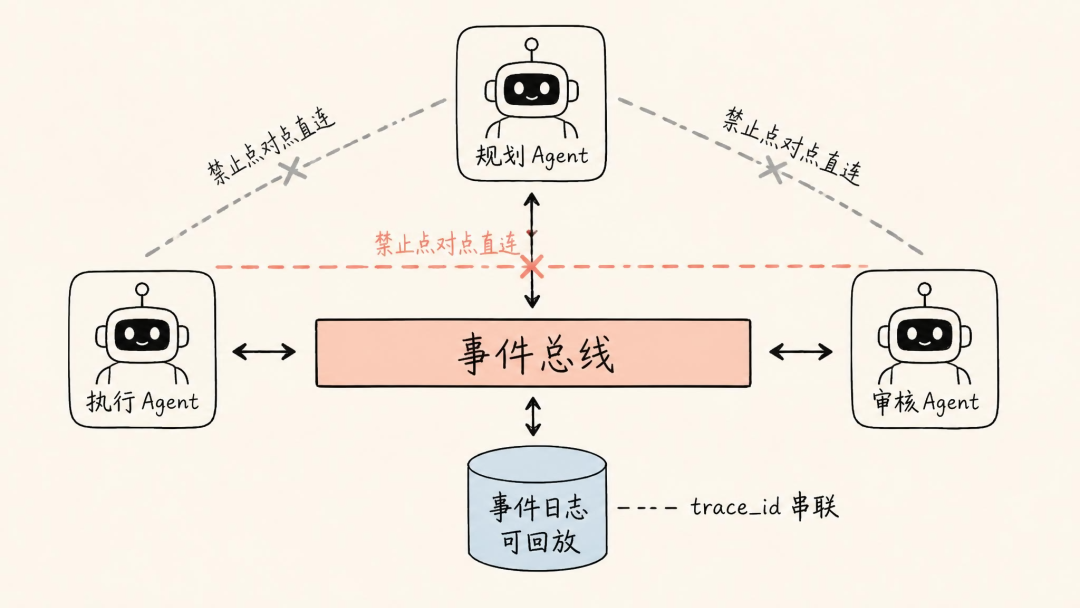
多 Agent 协作有两种主流姿势。编排模式留一个中心化的指挥者,主 Agent 把任务拆解成分步指令,逐步派发并收集结果,流程清晰好调试,缺点是指挥者自己成了单点。事件编排模式去掉指挥者,每个 Agent 订阅自己关心的事件,看到输入就自主产出,产出再作为新事件发布,协作关系从调用图变成一张事件拓扑。小规模下编排模式开发快,Agent 数量上到五六个、流程出现分支并行之后,事件编排的扩展优势开始明显。
事件编排的调试比调用链难,事件散在各个主题里,没有一处能看到完整流程。补偿的办法有两个:给每个任务分配 trace_id 并放进事件头,任何一环的日志都能串起来;再就是事件日志本身。事件日志是 Agent 系统最完整的行为审计记录——哪条消息触发了哪个动作、由哪个版本消费、耗时多少,按主题回放就能复原整个决策过程。金融和运维场景敢把 Agent 放上生产,这份可回放性是前提之一。
schema 是另一个必须提前管的事。事件结构变了,下游消费逻辑没跟上,整套协作就静默崩坏。Avro 加 schema registry 或者 Protobuf 加版本号,演进规则提前定好,向后兼容作为铁律,这些投入在第一次改事件结构时就会回本。
拿一个客服场景把拓扑串起来。用户消息进来,意图 Agent 发布一条意图识别结果;检索 Agent 订阅到它,召回知识库内容后发布一条证据事件;生成 Agent 汇合对话历史和证据生成回复;审核 Agent 检查合规后放行。四个 Agent 互不认识,全靠主题里的事件接龙,任何一个环节升级换代,其他三个完全无感。这套模式在内部工具链、数据流水线、审批流里都能原样套用,差别只在主题划分和事件粒度。如果你正在搭建类似的 AI Agent 管道,Kafka 的事件接龙思路可以直接复用到模型调用链路里。
五、上 Kafka 之前的三个自问
上 Kafka 之前值得自问三件事。第一,事件边界定了吗?哪些状态变化算事件、事件里带多少信息、谁有资格发谁需要收,这张清单比集群规模重要得多。先设计事件边界,再回头选组件,顺序反了多半要推翻重来。第二,回放需求真实存在吗?保留策略按天按周定,需要回溯的紧凑主题和纯流水主题分开配置。第三,规模撑得起吗?三节点的集群撑住日千万级事件不成问题。多数团队不是死于集群太小,是死于主题泛滥——什么事件都往里发,三个月后没人说得清一百多个主题各自谁在消费。
运行期的核心监控指标是消费延迟:消费组的位移落后最新消息多少条。这个数字直接反映下游处理能力是否健康,延迟持续上涨就是扩容或降级的明确信号,比用户投诉早得多。主题的磁盘水位、分区流量倾斜也要盯着。单个分区流量异常集中,多半是业务键选得不好——热点会话把一个分区打满了,其余分区闲着看戏。
反模式也提一嘴。把 Kafka 当数据库用,指望紧凑主题长期存状态,查询一多遍历效率就难受,状态查询还是回 MySQL 或 Redis;在事件里塞大报文,几百 KB 的 payload 让页缓存命中率下跌,事件里放引用,报文进对象存储。这些坑都不深,踩一次就是一次线上事故。
收尾留一个观察:Kafka 的价值在多 Agent 协作那一刻才开始凸显,单个 Agent 的世界里它多半是过度设计。总览篇那句"别在流量起来之前引入用不上的中间件",在这里同样作数。技术选型的时机比选型本身重要——这个判断在云栈社区的架构讨论里已经反复验证过,后续系列还会继续出现。
 发表于 3 小时前
|
查看: 2|
回复: 0


