一、为什么这件事值得关注
2026 年 9 月 15 日,Aiven、Confluent、Redpanda、StreamNative、Ververica 五家公司在赫尔辛基、慕尼黑、山景城、旧金山同步发布了一条公告:成立 Streamhouse 工作组,首次在跨厂商层面就“实时数据架构”这一类别给出共同命名,并配套发布公开 GitHub 仓库与永久免费的商标使用承诺。
数据库行业上一次出现“跨厂商统一类别”是 2020 年前后 Lakehouse 的成型。彼时 Databricks、Iceberg 社区、Netflix 工程团队、Dremio 等用了大约一年时间,把 湖仓一体 从一个营销词沉淀成可被招聘 JD、技术会议、行业报告反复引用的架构术语。
Streamhouse 工作组的成立,是 Lakehouse 之后第二次有这种量级的“跨厂商定义”事件。区别在于:
- Lakehouse 的命名更接近“对既有 Hadoop + 数据湖 + 数仓的整合表述”,是从已有形态抽象出来的概念。
- Streamhouse 命名指向的是一个新的、正在被 AI agent 与实时业务催生的架构形态,是面向未来而非复盘过去。
如果你是国产数据库 / 数据平台方向的从业者,这件事值得认真拆解一遍。
二、Streamhouse 三要素的拆解
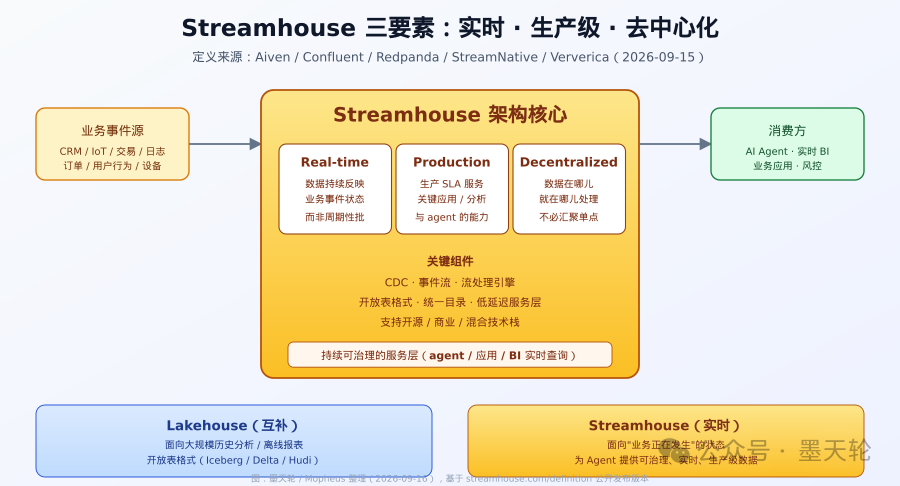
按工作组的官方定义(发布在 streamhouse.com/definition,并由 Ververica 贡献术语“Streamhouse”),一个 Streamhouse 系统必须同时满足三要素。
1. Real-time(实时)
数据需要持续反映业务事件的状态,而不是按小时、按天做周期性的批处理。传统数据仓库架构里,5 分钟到 1 小时的延迟常被视为“近实时”,Streamhouse 的定义则把它进一步推到“业务事件发生即可被消费”的级别。
落地表现包括:
- 业务事件通过 CDC(change data capture)从 OLTP 系统抽取,不再走 T+1 的 ETL 链路。
- 流处理引擎持续维护“业务当前状态”,下游消费者查到的总是最新切片。
- 延迟以秒级、亚秒级为单位;分钟级批被认为是上一时代的妥协。
2. Production-native(生产级)
这是把 Streamhouse 与“流处理 demo”“事件溯源玩具”区分开的关键。生产级意味着:
- 系统必须按业务关键应用的 SLA 运行,不是按“分析系统”的标准。
- 多租户、高可用、容灾、审计、配额、计费、按用户授权等运维能力是必备项。
- AI agent 通过 Streamhouse 读取数据时,等同于它在访问生产系统,权限与可观测性必须就位。
Ververica(Flink 商业化公司)、Confluent(Kafka 商业化公司)、Redpanda(Kafka 兼容流存储)三家本质上是流式系统里最强调生产级的厂商。它们共同把 production-native 写进定义,其实是在向市场传递一个信号:这不是给 ETL 工程师做的实验,而是给 CEO 的看板用的系统。
3. Decentralized(去中心化)
数据不必汇聚到单一系统就可以被消费。Streamhouse 不要求把数据集中到一个数仓或一个湖里,而是允许数据在产生地就近处理,并通过开放表格式(Iceberg / Delta / Hudi)、统一目录、低延迟服务层等机制,把分布式数据对外提供成“逻辑上的单一视图”。
这一点与 Snowflake / Databricks 倡导的“集中式云数仓”路线在哲学层面是对立的:
- 集中式路线认为:数据必须先集中到一个地方,才能被高效分析。
- Streamhouse 路线认为:数据不动、查询算力下沉;网络与目录才是关键。
三、与 Lakehouse 的关系:互补而非替代
Streamhouse 工作组明确把 Lakehouse 列为“互补”而非“替代”。这背后是一种架构分工:
| 维度 |
Lakehouse |
Streamhouse |
| 主导时间窗 |
历史 / 周 / 月 / 年 |
实时 / 当下 / 分钟级 |
| 主要负载 |
大规模历史分析、离线报表、合规审计 |
业务决策、风控、agent 实时查询 |
| 数据组织 |
开放表格式 + 文件系统 |
事件流 + 状态 + 开放表格式 |
| SLA 目标 |
分钟到小时 |
秒到亚秒 |
| 典型用户 |
数据分析师、BI 工程师、合规 |
业务运营、agent、实时风控、产品经理 |
为什么是互补?原因在于业务决策同时需要“已发生”和“正在发生”两个视图。例如:
- 一笔贷款的风险评估:需要历史还款记录(Lakehouse 强项)+ 当前账户异常行为(Streamhouse 强项)。
- 一次电商促销:需要历史销量与品类结构(Lakehouse)+ 当前分钟级库存与流量(Streamhouse)。
- 一个 AI agent 回答“为什么上周转化率掉了”:需要历史维度(Lakehouse)+ 当前正在发生的事件流(Streamhouse)。
把两者绑在一起看,“现代数据栈”才完整。这也是 Databricks 一直强调 Lakehouse + Mosaic AI、Snowflake 强调 Dynamic Tables + Cortex AI、Confluent 强调 Kafka + Flink + Tableflow 的根本原因——各家都在往“既覆盖历史、又覆盖当下”的方向走,只是 Streamhouse 工作组把“当下”这件事单独命名了。
四、关键组件:Streamhouse 由哪些技术组成
按工作组发布的技术栈清单,Streamhouse 不是单一产品,而是由若干开源 / 商业组件组合而成的架构模式:
- CDC(change data capture):把 OLTP 系统的变更事件抽取出来。代表项目:Debezium、Maxwell、PolarDB CDC、OceanBase CDC、TiCDC 等。
- 事件流平台:承载持续事件流。代表项目:Apache Kafka、Apache Pulsar、Redpanda、AutoMQ 等。
- 流处理引擎:在流上做状态化计算。代表项目:Apache Flink、Apache Spark Streaming、Materialize、RisingWave 等。
- 开放表格式:把流处理结果沉淀为可被多引擎消费的表。代表项目:Apache Iceberg、Delta Lake、Apache Hudi、Paimon 等。
- 统一目录:提供跨流与表的元数据与权限。代表项目:Apache Gravitino、DataHub、Unity Catalog、Hive Metastore 等。
- 低延迟服务层:对外提供亚秒级查询。代表项目:Apache Pinot、Apache Druid、ClickHouse、Doris、StarRocks 等。
有意思的是,列表中没有任何一个项目是这五家发起公司独家拥有的。这与工作组“开放商标、公开定义、GitHub 维护”的动作一致——Streamhouse 不是要造一个新数据库,而是要把上述六层技术按“实时 + 生产级 + 去中心化”的方式组装成一个新的架构模板。
五、为什么是现在:AI agent 催生的“实时数据刚需”
Streamhouse 工作组的成立时间并非偶然。2026 年 7 月到 9 月这一窗口,几个趋势同步收紧:
- MCP 协议成熟:Model Context Protocol 已成为 agent 接入数据源的默认通道。MongoDB Atlas、Confluent、WarpStream、Materialize、CockroachDB、Neon、KeewanoDB 等在过去两个月里集中发布了自己的 MCP server。
- agent 直接读原始数据:传统 OLAP 走“ETL → Cube → 看板”路径延迟以小时计;agent 等待分钟级的批处理结果被认为是不可接受的。
- Snowflake 提出 “intelligence efficiency”:2026 年 8 月 18 日,Snowflake 把 AI 经济学的衡量单位从“每 token 成本”升级为“每单位算力的业务价值产出”,倒逼数据基础设施从“集中后处理”转向“实时可消费”。
- AWS 收编 DuckLabs:DuckDB 团队加入 AWS,AWS 把 DuckDB 写进 DynamoDB 零 ETL 模板,意味着嵌入式 OLAP 与事件流的结合被云厂商当作战略动作。
也就是说,当 AI agent 需要“业务正在发生的状态”作为输入时,传统数仓 / Lakehouse 都无法直接供给。Streamhouse 工作组的成立,正是行业对这一供需缺口给出的统一答复。
六、给国产数据库的启示
从国产数据库(OceanBase、PolarDB、TiDB、StarRocks、Doris、SelectDB、openGauss、GaussDB 等)视角看,Streamhouse 工作组带来三个层面的机会与压力。
6.1 命名层面的压力
国产数据库在过去几年里已经基本完成“对标海外”的命名阶段(HTAP、云原生、向量、Lakehouse),但对“实时 / agent 原生 / Streamhouse”这个新类别的话语权还没有建立。如果国产厂商不主动给“实时数据架构”提供自己的命名与定义,海外工作组的标准就会被默认采用,进而影响国产数据库在出海客户那里的认知。
可参考动作:
- 由头部几家共同发布中文版“Streamhouse 定义”,避免翻译滞后。
- 在国产数据库峰会上把“实时数据架构”作为主论坛话题,至少占据命名先机。
6.2 技术栈层面的机会
Streamhouse 工作组公开的六层技术栈里,国产数据库在每一层都有可落点:
| 技术栈层级 |
海外代表 |
国产代表 |
适配 Streamhouse 的难度 |
| CDC |
Debezium |
OceanBase CDC / TiCDC / PolarDB CDC |
低,已有生产实践 |
| 事件流 |
Kafka / Pulsar |
AutoMQ / RocketMQ |
低 |
| 流处理 |
Flink / Spark |
Apache Flink(国产分支)/ 阿里实时计算 |
低 |
| 开放表格式 |
Iceberg / Delta / Hudi |
Paimon(阿里开源)/ Iceberg(中文社区) |
中 |
| 统一目录 |
Gravitino / Unity Catalog |
Gravitino(国产)/ Hive(中文社区) |
中 |
| 低延迟服务层 |
Pinot / Druid / ClickHouse |
Doris / StarRocks / SelectDB |
低 |
国产阵营在 CDC、流处理、服务层三个层级上都不弱,但在目录层与跨引擎互操作上仍有差距。如果国产厂商能在 Streamhouse 框架下推出一两个“开箱即用”的端到端组合(例如 Doris + Paimon + Gravitino + 阿里实时计算),就能在出海客户那里形成“中国版 Streamhouse”的产品印象。
6.3 产品定位层面的调整
Streamhouse 工作组的定义里,生产级(production-native)被列为三要素之一。这意味着:
- 不能再把“实时”当作分析系统的小特性,而需要把它当作主产品线来投资。
- AI agent 访问数据的可观测性、权限、配额、计费都要进入 1.0 GA 能力。
- 多租户 / 跨 region 容灾 / 合规审计这些传统“非实时”特性,会变成“实时数据架构”进入企业采购名单的硬门槛。
国产数据库如果只把“接了多少模型”当作 AI 集成的全部,会很快落后——真正的 AI 集成在于把 agent 视为一种新的生产负载,并为之提供专属的 SLA、权限与可观测性。
七、给技术人的结论
- Streamhouse 工作组的成立是数据库行业第二次出现跨厂商类别共识事件(第一次是 Lakehouse)。它对应的不是营销概念,而是 AI agent 时代对“业务正在发生的状态”这一新型数据需求的统一回答。
- 三要素(real-time、production-native、decentralized)里,production-native 是国产数据库最容易补齐、也最难忽视的一条。具备生产级 SLA 是参与这场定义的前提。
- 国产阵营在 CDC、流处理、服务层三个层级已有可用组件,差距集中在目录与跨引擎互操作。下一步的关键是把“端到端组合”做出来,而不是只盯着单点性能。
- AI agent 不会等批处理结果。如果你的数据库还以“分钟级延迟”为荣,建议现在就把“亚秒级实时”提上 roadmap——Streamhouse 工作组已经把这条线划出来了。
读者可继续关注:
- 官方定义仓库:
https://streamhouse.com/definition
- 工作组商标承诺:
https://streamhouse.com/trademark
- Confluent 官方公告:
https://www.confluent.io/blog/aiven-confluent-redpanda-streamnative-and-ververica-form-streamhouse-working-group/
参考:
- Aiven、Confluent、Redpanda、StreamNative、Ververica 联合公告(2026-09-15)
- streamhouse.com/definition 公开发布版本
- Snowflake Dynamic Model Routing 公告(2026-08-18)
- AWS DuckDB + DynamoDB 零 ETL 集成方案(2026-09-10)
- Apache Doris / StarRocks 公开技术博客
更多实时数据架构与大数据实践内容,可访问 云栈社区。
 发表于 5 天前
|
查看: 2|
回复: 0


