一、基准回顾:1.185 亿 QPS 不是孤立数字
2026 年 9 月 11 日,PlanetScale 发布了一篇详细技术博客,公开了 Neki(新分片 Postgres 平台,处于 platform preview 阶段)的基准数据:持续 16 分钟 1.185 亿 QPS(118,538,803)、峰值 1.187 亿(118,747,267)QPS、数据规模 1.22 PiB、480 个 Neki 路由器、512 个 Postgres primary 分片。
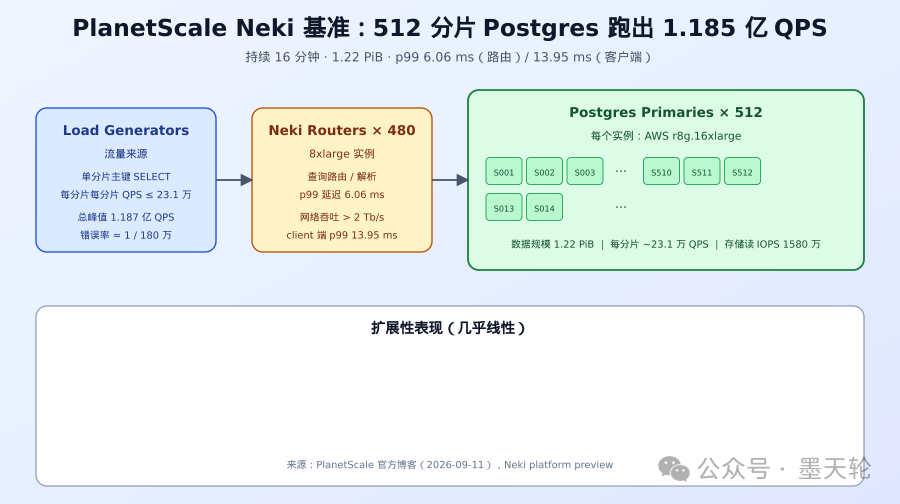
关键参数(来自 PlanetScale 官方博客):
- Workload:单分片主键 SELECT,每查询一行,按主键点查。只读、无写、无 JOIN、无跨分片。
- 配置:每个 Postgres primary 跑在 AWS r8g.16xlarge 上(ARM Graviton4 + 内存优化实例);每个 Neki router 跑在 8xlarge 实例上;分片仅 primary,无副本。
- 结果指标:峰值 1.187 亿 QPS;网络吞吐 > 2 Tb/s;存储读 IOPS 1580 万;客户端 p99 延迟 13.95 ms、路由端 p99 6.06 ms;错误率约 67 errors/s,即约 1 / 180 万。
但要让这组数字真正具备“工程意义”,还得把它放回扩展性曲线中去审视:
- 5 分片 → 50 分片 → 512 分片的过程中,每分片 QPS 仅在 5→50 区间下降 0.8%;到 512 分片时反而升至 23.1 万(仍低于负载发生器上限)。
- 客户端 p99 延迟从约 10 ms 漂到 13.95 ms,整体平稳。
- 没有任何一次主节点切换发生在 16 分钟测量窗口内。
简单说,PlanetScale 展示的是“加机器就能加吞吐”——这条分布式数据库最朴素也最难做到的目标。
二、为什么这件事不只是又一个基准
公开层面的分片 Postgres基准此前一直很少见。原因在于 Postgres 的水平扩展在工程上长期被认为“比 MySQL 难做”——MVCC、shared buffer、vacuum、复制槽等机制,让分片改造比 MySQL(Vitess 已跑通路径)更棘手。PlanetScale 这次做到 1.185 亿 QPS 的工程意义可以拆成三层:
第一层:分片 Postgres 在工程上不再“纸上谈兵”
把 512 个 Postgres primary 拼成一个“逻辑数据库”,且每分片都跑标准 Postgres(不魔改内核),这件事在 2022 年之前基本要靠 Citus / Greenplum 这类 fork 完成。现在 PlanetScale 用 Neki 路由器 + 标准 Postgres primary + Vitess 复用工程经验,做到这件事的同时不破坏 Postgres 生态。
第二层:扩展性曲线接近“线性”
5→50→512 分片的过程里,每分片 QPS 在 50 分片时只比 5 分片低 0.8%;到 512 分片反而比 50 分片还高。这意味着水平扩展的边际成本(路由器层、连接管理、监控、负载均衡)是可控的。在工程拐点的判断标准里,“能不能加机器”比“加一台机器能加多少吞吐”更关键。
第三层:延迟与错误率都在生产可用区间
p99 13.95 ms 的客户端延迟意味着绝大多数请求都在 14 ms 内完成;67 errors/s 对应 1/180 万的错误率,对照金融支付、广告竞价、电商查询等典型场景,已经跨过“工程拐点”。如果只看“扩展到 1 亿 QPS”这件事,1/180 万的错误率比很多单库 InnoDB / Postgres 在 10 万 QPS 时的表现都更稳定。
三、关键工程细节拆解
3.1 Neki 路由层
PlanetScale 将 Neki 定位为“Postgres 的智能路由器层”,其职责包括:
- 查询解析与目标分片定位(基于 Vitess 复用经验)。
- 连接池管理、负载均衡、健康检查。
- 把“跨分片查询”在路由层拆解后并发下推(本次基准没有跨分片,但路由层为此预留能力)。
- 多租户隔离、配额、审计(未在本次基准中体现)。
480 个 router 是按 512 分片 + 预留 + 多 AZ 容错的工程比例设计的;r8g.16xlarge 单实例约 64 vCPU / 512 GB 内存,刚好能扛住约 25 万 QPS 的纯路由压力。
3.2 Postgres primary 层
每个分片跑标准 Postgres(未确认具体大版本,按 PlanetScale 公开信息推断为 PG 16+),单分片约 23 万 QPS 的点查吞吐意味着:
- 内存足够大:16xlarge 的内存能装下大部分热数据。
- 共享缓冲区 + OS page cache 命中率高:点查 + 大内存环境下,磁盘 IO 反而不是瓶颈(虽然基准披露 1580 万 IOPS,但更多是为“扩展到更大数据集”准备的)。
- 没有跨分片事务、没有跨分片 JOIN、没有写入热点:基准的“单一工作负载”假设让单分片性能达到上限。
3.3 可观测性与故障容忍
虽然本次基准“零故障切换”,但 PlanetScale 之前已公开 Neki 的运维能力:
- 每个分片自动健康检查,routed 流量自动避开不健康分片。
- router 层多副本,故障时上层负载均衡可以摘除。
- 主从切换 / 流复制配置按 Postgres 标准方式工作(不在 Neki 中魔改)。
四、与 CockroachDB / YugabyteDB 的路线对比
PlanetScale 走的是“标准 Postgres + 智能 router”路线,与 CockroachDB、YugabyteDB 的“重写存储层 + 兼容 Postgres 协议”路线形成鲜明对比:
| 维度 |
PlanetScale Neki |
CockroachDB |
YugabyteDB |
| 存储引擎 |
标准 Postgres primary |
自研 Pebble(基于 RocksDB) |
自研 DocDB |
| 分片方式 |
路由层逻辑分片 |
内部按 range 自动分片 |
内部按 tablet 自动分片 |
| 水平扩展 |
加 router + primary |
加节点 |
加节点 |
| SQL 兼容性 |
原生 PG SQL |
PG 兼容但有差异 |
PG 兼容(较弱) |
| 跨分片事务 |
受限,需 router 拆解 |
完整分布式事务 |
完整分布式事务 |
| 单分片延迟 |
与 PG 一致 |
略高于 PG |
略高于 PG |
| 运维复杂度 |
router 集群需要专门团队 |
标准分布式数据库运维 |
标准分布式数据库运维 |
PlanetScale 的优势在于“标准 Postgres + Vitess 复用”——客户可以复用既有的 PG 工具链、监控、备份策略,DBA 转岗成本低;缺点是 router 层引入了新的故障域与运维负担。
CockroachDB / YugabyteDB 的优势在于“全自动分布式”——不需要客户理解分片、路由、reshard 策略;缺点是 PG 兼容性是“近似”,跨方言的迁移需要重新测试。
五、对国产数据库的三点启示
5.1 “分片 + 强 schema”路径在 AI 时代仍有生命力
国产数据库过去几年普遍走“重写内核 + 分布式原生”路线(TiDB、OceanBase、CockroachDB 风格),PlanetScale 这次基准展示了一条“标准内核 + 智能路由”的替代路径。对国产数据库而言,这意味着:
- 可以在不重写 Postgres / MySQL 内核的前提下,把“分片 + 路由”做到生产可用。
- 老牌 PG 系国产数据库(PolarDB、GaussDB、openGauss 等)可以借鉴这条路线,把“兼容 PG + 水平扩展”作为对外卖点。
5.2 “基准数字”本身是产品力的一部分
PlanetScale 选择公开 1.185 亿 QPS 这类具体数字,本质上是在用工程基准建立“产品力”的话语权。国产数据库厂商如果只发“性能大幅提升”这种定性表述,会在与海外厂商的工程说服力上吃亏。具体到数字 + 具体配置 + 可复现条件是更有效的对外沟通方式。
5.3 “国产版 PlanetScale”是有可能的产品形态
国内目前还没有与 PlanetScale 同形态(标准 PG + 智能 router + 分片即服务)的产品。考虑到 PG 在国产阵营的渗透率(PolarDB、GaussDB、openGauss、KingbaseES 等都基于 PG),做一款“PG 分片 SaaS”或“PG 分片一体机”在出海客户与大型国企客户那里都有空间。
六、给工程团队的具体行动建议
如果你的团队正在评估“是否上分片 Postgres”,PlanetScale Neki 这次基准透露了三条可直接借鉴的工程判断标准:
1. 先确认工作负载能否拆成“单分片主键查”
1.185 亿 QPS 之所以成立,是因为工作负载是“按主键 SELECT 一行”。如果你的核心场景大量涉及跨分片事务、跨分片 JOIN、跨分片聚合,那分片 Postgres 的延迟收益会被拆解成本吃掉。建议先用 pg_stat_statements 把生产 SQL 按“主键点查 vs 跨实体 JOIN vs 聚合扫描”做一遍归类,看看点查占比能否超过 80%——这是 Neki 类方案的甜蜜区。
2. 评估 router 层的运维能力是否在团队内
标准 Postgres 的运维对 DBA 已经很熟悉,但 Neki 的 router 层是新的故障域:480 个 router 的部署、监控、滚动升级、热点 router 排查都是新工程问题。如果你的运维团队规模不到 5 人,优先考虑托管型分片 Postgres(如 PlanetScale 自身、Aiven PG、AWS RDS Proxy + Aurora Limitless)而不是自建。
3. 不要把分片当作“性能问题的万能药”
分片提升的是水平扩展能力,不一定提升单查询性能。很多团队的“性能问题”其实来自:缺索引、统计信息不准、长事务、prepared statement 计划缓存错位。在考虑分片之前,先用 EXPLAIN ANALYZE 把慢查询的真因查清楚——很多时候答案在 schema 或 query plan 里,不在架构里。
七、读者应关注的下一步
- 第三方独立基准复现:PlanetScale 的数字目前来自官方博客,需要第三方(如 PGSQL Perf、pgconfig.org、Percona 等)做对比复现。
- 混合工作负载表现:本次基准仅覆盖“只读 + 单分片点查”,实际生产必然涉及写、跨分片、跨 region、长事务。PlanetScale 是否能保持同等扩展性待后续披露。
- router 层稳定性:480 个 router 长时间运行下的内存泄漏、连接池漂移、热点 router 等问题,需要等生产客户跑出来才知道。
- 价格透明度:1.22 PiB 数据 + 512 r8g.16xlarge + 480 8xlarge router,单是这个硬件池的 AWS 月费就在百万美元量级。PlanetScale 商业定价与价值主张是否对等,会决定它能否扩大客户群。
参考
- PlanetScale 官方博客:“We ran a massive, sharded Postgres database at 118.5 million queries per second...”(2026-09-11)
- PlanetScale 官方博客:“Follow a SQL query through the router, across four Postgres shards, and back”(2026-09-10)
- PlanetScale 官方博客:“Postgres presents pretty predictable performance problems when dealing with large tables. Sharding solves this.”(2026-08-25)
 发表于 5 天前
|
查看: 1|
回复: 0


