一、事件背景:以色列团队 Keewano 一次同时拿下钱和产品
2026 年 9 月 15 日,PR Newswire、SiliconANGLE 等渠道同步发布了 Keewano 的公告:
- 完成 1200 万美元种子轮,Hetz Ventures 领投,a16z speedrun、Remagine Ventures、DIG Ventures 及天使投资人跟投。
- 同步 GA 发布 KeewanoDB,官方定位是“第一台为机器推理而生的数据库”(the first database built for machine reasoning at scale)。
按官方表述,这是一次典型的“产品 + 融资 + 创始团队”三件套同步落地的发布动作。公司 2024 年由 Mark Kardashov(CEO)、Dima Karger、Pavel Bibergal、Vitaly Bukhovsky 共同创立,注册在以色列。
种子轮规模在 AI 数据基础设施赛道上不算最大。在 Keewano 之前,Keebola、ApertureDB 等同类项目也都在种子轮到 A 轮区间,但 Keewano 切入的角度与已有玩家有明显差异。
如果你对这类围绕 AI 场景展开的数据基础设施、模型训练与推理链路感兴趣,也可以顺带关注人工智能方向的技术资料,里面覆盖了 Agent、RAG、Fine-tuning、Deep Learning 等相关主题。
二、产品定位:为什么自称“为机器推理而生”
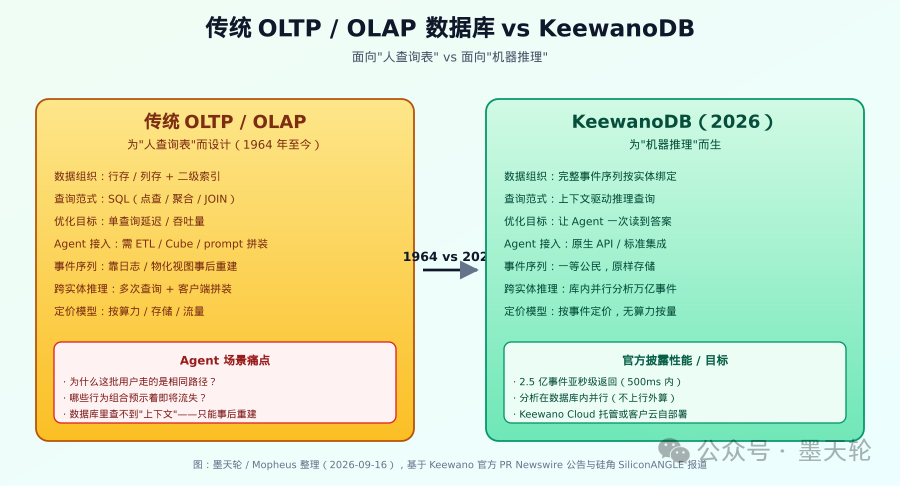
Keewano 在与媒体沟通时反复强调一点:现有数据库是为“人查询表”而设计的,AI agent 的工作模式与此完全不同。CEO Mark Kardashov 给出的原话是:
“1964 年,日本没有尝试让火车跑得更快,而是建了一条新干线。数据库现在正处在那个分叉口。AI agent 需要一个根本不同的数据架构,我们把 KeewanoDB 建成了那条新干线。”
这段话有两层含义需要拆开看。
第一层:传统数据库假设的“人查询”模型
过去 60 年的关系型数据库,以及列存 OLAP、KV 库,几乎都建立在同一组假设上:
- 客户端发起一次具体的查询,例如点查、聚合、JOIN。
- 数据库优化“这一次查询”的延迟、吞吐、并发。
- 业务答案由人在 BI 工具里“看”出来,或者由后端代码“拼”出来。
这一组假设在过去是合理的——人是查询的主体,查询是离散动作,数据库只需要把“那一次查询”做好。
第二层:AI agent 的“推理”模型完全不同
Agent 的工作模式是:
- 持续消费大量“事件序列”,例如用户行为、设备动作、外部信号。
- 需要的是“跨多条记录的连续推理”,而不是“点查一行”。
- 答案往往以“行为路径 / 风险信号 / 用户分群”等组合形式出现,对应的是“事件级”而非“行级”的查询。
Kardashov 给的另一个例子更能说明问题:
“我们想用 AI agent 回答这种问题:‘哪些用户和上个月流失的那批用户走的是同一条路径?’任何 dashboard 都能告诉你发生了什么,但为什么发生,传统数据库够不到那个上下文。”
把这两层放在一起看,Keewano 的产品假设是:当查询主体从“人”变成“agent”时,数据库的存储格式、查询接口、优化目标都应当跟着改变,而不是在传统数据库之上做插件。
三、KeewanoDB 的关键技术点
按官方披露及 PR 文本,KeewanoDB 的设计选择主要落在以下几处。
3.1 存储格式:实体绑定的事件序列
KeewanoDB 把每个用户 / 设备 / agent 的“完整事件序列”作为一等公民存储,而不是把事件作为离散行打散到一张通用表里:
- 完整:保留事件的全部字段,包括动作、来源、上下文。
- 有序:事件按发生顺序排列,不重排、不打散。
- 带上下文:实体级上下文,如实体属性、外部参考,随序列一起可查。
这种存储方式让 agent 的“行为路径”查询,从“事后 JOIN 多张表”变成“在单个实体序列上做连续推理”。
3.2 分析路径:库内并行,不上行外算
Keewano 官方披露,KeewanoDB 让“分析在数据库内并行处理”,最终把“压缩过的、带上下文的答案”返回给 agent,而不是把整个事件流拖到 Python / Spark 里再做后处理。
披露的核心性能数字:
- 单查询可扫描 2.5 亿事件,即 quarter of a billion events。
- 在 亚秒级,即小于 500 ms 内返回。
- 处理规模按“万亿事件并行”为目标。
注意,这些数字来自官方 PR,目前没有第三方独立基准复现,需要等 Hetz Ventures 后续引入的企业客户做实测验证。
3.3 定价模型:按事件,不按算力
Keewano 官方明确:“无 per-event 定价之外的费用”——按事件数定价,而不是按 CPU 时长、存储 GB、出口流量。这与传统云数仓“按算力 + 存储”的双轴计费有明显区别。
对 agent 工作负载来说,事件数与 agent 的“推理密度”直接挂钩,比“算力小时”更可预测。
3.4 部署形态:Keewano Cloud 与可插拔代理
Keewano 提供两条部署路径:
- Keewano Cloud:官方托管服务,按事件计费。
- 客户云自部署:可以接在企业现有数仓旁边作为“事件序列加速层”,或替代部分数仓场景。
Agent 接入方面:
- 企业可以接自己的 AI agent。
- 也可以直接用 Keewano 自带的 agent 产品。
四、与已有“实时事件 / 行为”方案的横向对比
把 KeewanoDB 放到 2026 年的实时数据栈里看,它的位置介于以下几个相邻类别之间:
- Flink / Kafka Streams 等流处理引擎:适合对事件流做窗口聚合、模式匹配,但状态通常按 topic 维护,跨实体的复杂查询需要外部存储配合。
- Materialize / RisingWave 等流式数仓:把流处理结果沉淀为可 SQL 查询的物化视图,擅长增量聚合,但跨实体的“行为路径”语义仍偏弱。
- ClickHouse / DuckDB 等列存 OLAP:擅长聚合查询,但事件序列的“按实体绑定”不是默认假设,需要在 schema 设计阶段就为它服务。
- 图数据库,如 Neo4j / Memgraph:把行为建模为图上的路径,擅长“路径 / 子图”查询,但高写入吞吐与万亿事件规模不是它的设计目标。
- 专用玩家,如 Keebola、ApertureDB、Memverge 等:与 Keewano 同期出现的“AI 原生数据基础设施”,各自切入“实体序列 / 多模态 / 内存层”等不同侧面。
KeewanoDB 的定位可以总结为“实体级事件序列上的高频跨实体推理”:在 ClickHouse 的列存性能与图数据库的路径语义之间,找一个为 agent 量身定做的存储 / 查询组合。
如果把这套技术栈放回更通用的数据层来看,它与 数据库/中间件/技术栈 中的 ClickHouse、Kafka、Redis 等方案形成了互补关系,尤其是事件序列存储和实时查询这条线,值得持续观察。
五、目标用户与典型场景
KeewanoDB 官方列出的目标场景集中在“高密度行为事件 + 跨实体推理”区间:
- 行为分析,即 Behavioral Analytics:用户为什么流失、哪些行为组合预示风险。
- 用户分群,即 Segmentation:把走相同路径的用户聚在一起。
- 早期信号识别,即 Emerging Risks:从事件序列里找“先兆”。
- 游戏规模分析,即 Gaming-scale analytics:每秒上百万事件的实时推理。
可以理解为,传统 OLAP 拿来做 dashboard 的那部分,被 Keewano 切到了“agent 拿来做决策依据”的那部分。
六、为什么是现在:AI agent 数据访问的“新轨道”
Keewano 的 1200 万种子轮能在一个相对拥挤的赛道里切出来,背后是 2026 年 AI 数据基础设施的几个同步趋势。
1. MCP 协议成为 agent 接入数据源的默认通道
过去两个月里,MongoDB Atlas、Confluent、WarpStream、Materialize、CockroachDB、Neon、StreamNative 等集中发布了自己的 MCP server。Agent 与数据库之间已经形成一个新的“标准接口层”。Keewano 的事件序列查询完全可以走 MCP 暴露给 agent。
2. 现有数据栈对 agent 不友好
传统 OLAP 走“ETL → Cube → 看板”路径,agent 等待小时级的批处理结果被认为不可接受;走“实时流 + 状态计算”路径,则需要 Flink/Kafka 等较重的工程。Keewano 把自己定位为“中间层”:保留事件序列的细节,同时让 agent 拿到可直接消费的答案。
3. 资本对“agent 原生数据库”的明确偏好
2026 年 6 月以来,海外已出现 Keebola、ApertureDB、Chroma、Pinecone、Weaviate、Qdrant 等一系列“agent 原生 / AI 原生”数据基础设施的种子 / A 轮融资。Keewano 是这一波里第一个明确把“机器推理”作为产品核心的数据库项目。
七、给国产数据库与数据平台的三点启示
7.1 “AI 原生”不能只是“接几个模型”
过去一年,国产数据库与 AI 的集成大多停留在“接 LLM 接口 / 跑向量检索”的层面。Keewano 的产品思路提示了一个更彻底的方向:把 agent 当作新的生产负载,从存储格式、查询接口、定价模型就为它设计。
国产厂商如果想跟进,需要在存储引擎、查询优化、定价模型三个层面都做调整,而不是只发一个新 feature。
7.2 事件序列存储是一个被低估的赛道
关系型数据库擅长点查与事务,时序数据库擅长指标聚合,但“按实体绑定的完整行为序列 + 跨实体推理”这个场景,在国产阵营里还没有明确的产品占位。
OceanBase、PolarDB、TiDB、Doris / StarRocks 等都有 HTAP 或实时分析能力,但“实体级事件序列 + 跨实体连续推理”是一个空白。Keewano 1200 万种子轮的估值不算高,但它切的口子可能比想象中更深。
7.3 定价模型创新是出海 / 企业落地的关键
按事件定价、不按算力定价,这种“与 agent 工作负载直接挂钩”的定价模型,会让国产数据库在出海客户那里遇到新的选择压力。如果国产厂商仍然只提供“按 vCPU / 按存储”的双轴计费,会在与 Keewano 类项目的对比中处于结构性劣势。
八、读者应关注的下一步
- 第三方独立基准:Keewano 披露的 2.5 亿事件亚秒级返回,需要第三方如 ClickHouse、Timescale 等做对比复现。
- 首批企业客户:种子轮之后通常 6-12 个月内会公布首批付费客户,这些客户的实际 workload 决定 KeewanoDB 的真实适用边界。
- 生态集成:是否提供原生 MCP server,是否与主流 agent 框架如 LangChain / LlamaIndex / OpenAI Agents / Anthropic MCP 做开箱即用集成。
- 开源策略:当前 KeewanoDB 是闭源 + 托管 + 自部署双轨,未来是否开源内核,将决定它在云时代的扩展速度。
参考
- Keewano 官方 PR Newswire 公告(2026-09-15)
- SiliconANGLE 报道:“Startup Keewano launches agent-focused database and pulls in $12M in funding”(2026-09-15)
- Finsmes 报道:“Keewano raises $12M in seed funding”(2026-09-15)
- Calcalist Tech 报道(2026-09-15)
 发表于 5 天前
|
查看: 1|
回复: 0


