字节Seed团队连放三篇论文。它们并非三个孤立工作,而是围绕 Closed-Loop RSI(Recursive Self-Improvement)的一套组合拳。
把 RSI/Self-evolving Agents 这个口号拆成三个可测量的问题,逐一给出答案。
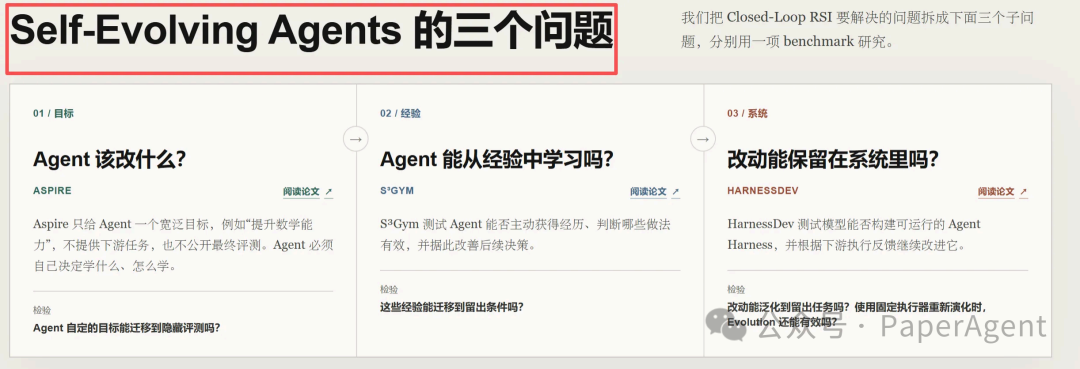
- Aspire:只给一句模糊目标,模型能自我进化吗?
- S3Gym:自测试、自评判,能转化成自我改进吗?
- HarnessDev:模型能给自己造、并进化 Agent harness 吗?
三篇论文,共用项目页 self-developing-agents.github.io 。
一、Aspire:模糊目标下,练得出来,留不住
问题:现有自进化工作都先把"提升数学推理"操作化成"在 AIME 上提分",Agent 只需搜索"怎么改进"。
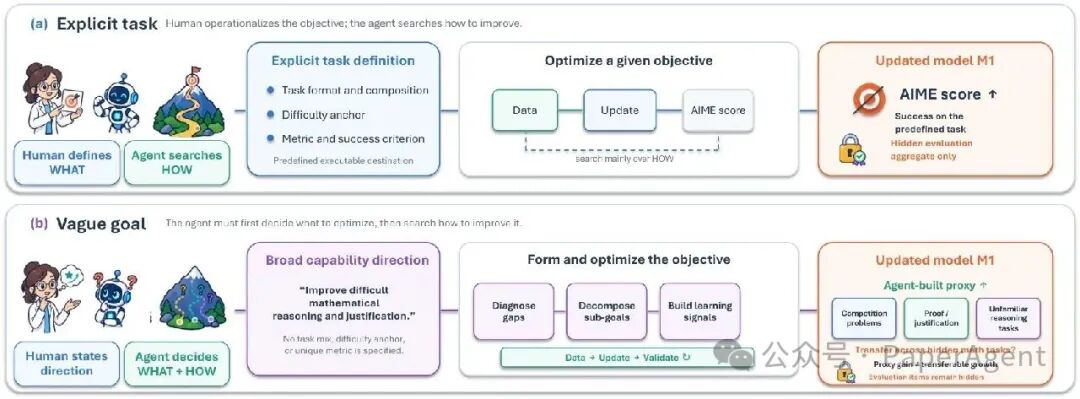
Figure 1:显式任务下人类定义 WHAT、Agent 搜索 HOW(a);模糊目标下 Agent 要先决定优化什么(b),且评测题始终密封
Aspire 抽掉这层人工结构,只给一句自然语言能力目标,评测集(专家新编 520 题、六个目标)完全保密,Agent 必须自己完成目标操作化:诊断缺口、造数据、定训练方案、决定何时评测。
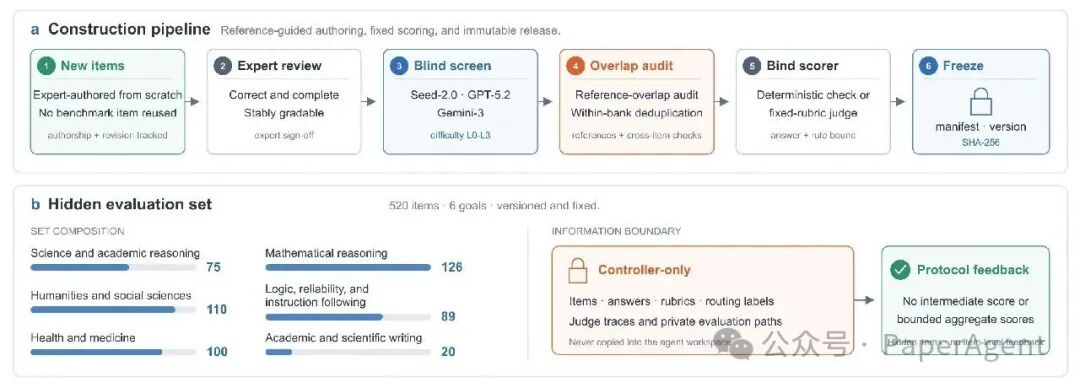
Figure 2:隐藏评测集的构造与信息边界
环境上 Agent 不碰 shell,通过统一工具接口完成"数据 → SFT/GRPO 训练 → 自查 → 分支/回滚",分 final-only(全程无中间分数)和 adaptive-feedback(可查少量聚合分数)两种协议。
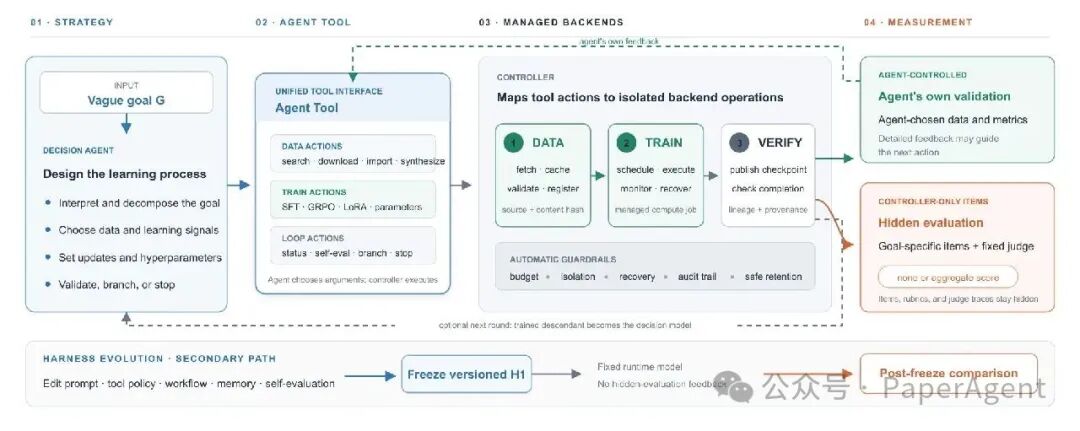
Figure 3:最小交互环境与两种结果协议
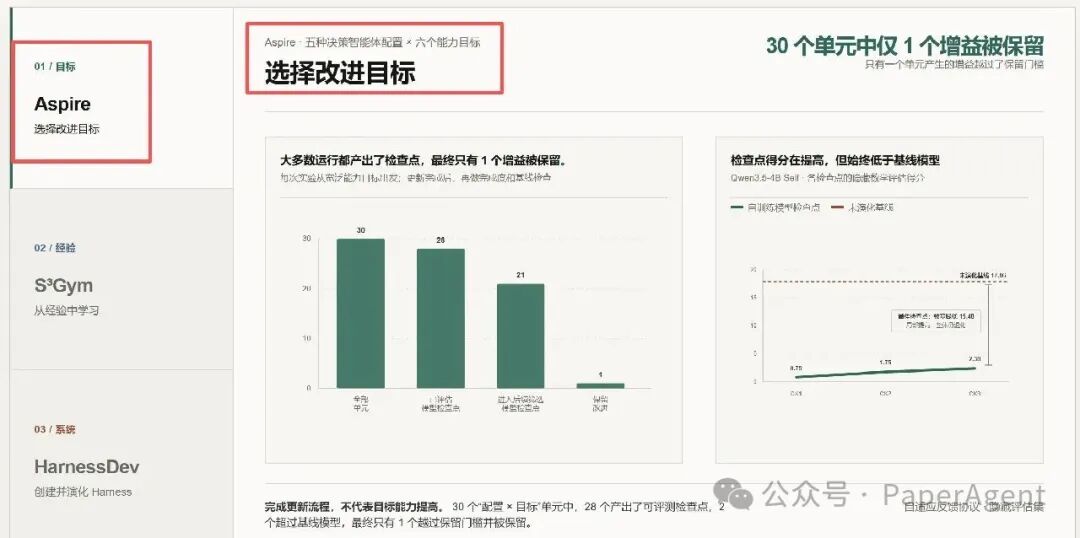
Aspire 理论小结:选择改进目标
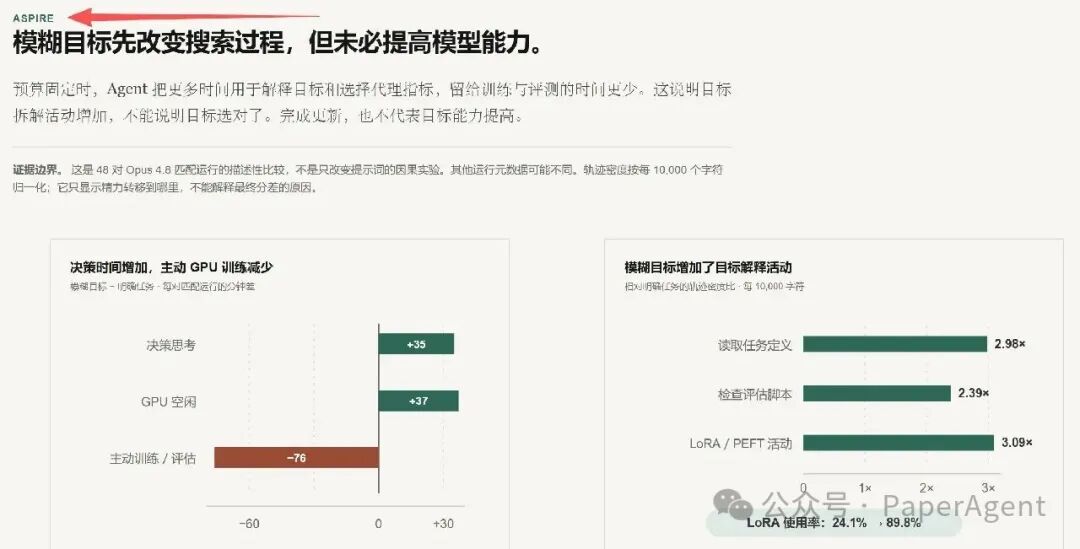
RQ1(模糊目标 vs 显式任务):把 PostTrainBench 的显式任务换成宽泛目标后,Opus 4.8 总分 27.07(官方参考 32.90),GPT-5.6 为 29.58(参考 36.23)。轨迹显示差距主要来自"解读目标"本身:多花 2,109 秒思考、活跃训练时间反而更少;每次训练启动只配 0.57 次评测(官方 2.63 次),反馈密度差 4.6 倍。
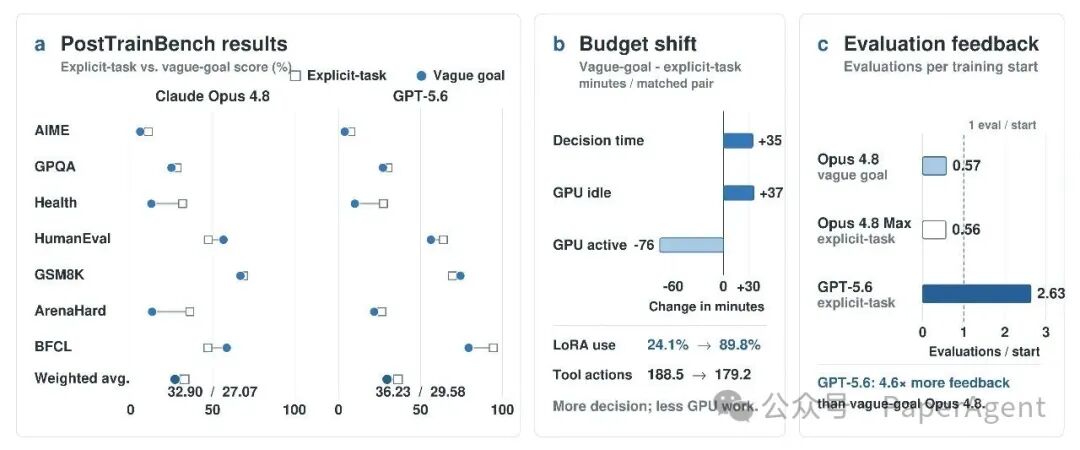
Aspire Figure 4:模糊目标 prompting 下的总分(a)与轨迹对比(b)(c)
RQ2(权重进化):40 GPU 小时预算,让 Agent 自己决定数据、算法(SFT/GRPO、LoRA)和评测时机。结果近乎残酷:final-only 下 24 个 run 全部跑通闭环,但按双运行均值只有 1/12 个模型—目标对超过基线(9B 科学推理 +2.67);单 run 层面 3/24,其余全被安全回滚打回。adaptive-feedback 下 30 个格子里也只有 1 个增益保留(Terra 把 4B 数学从 17.86 拉到 20.10)。
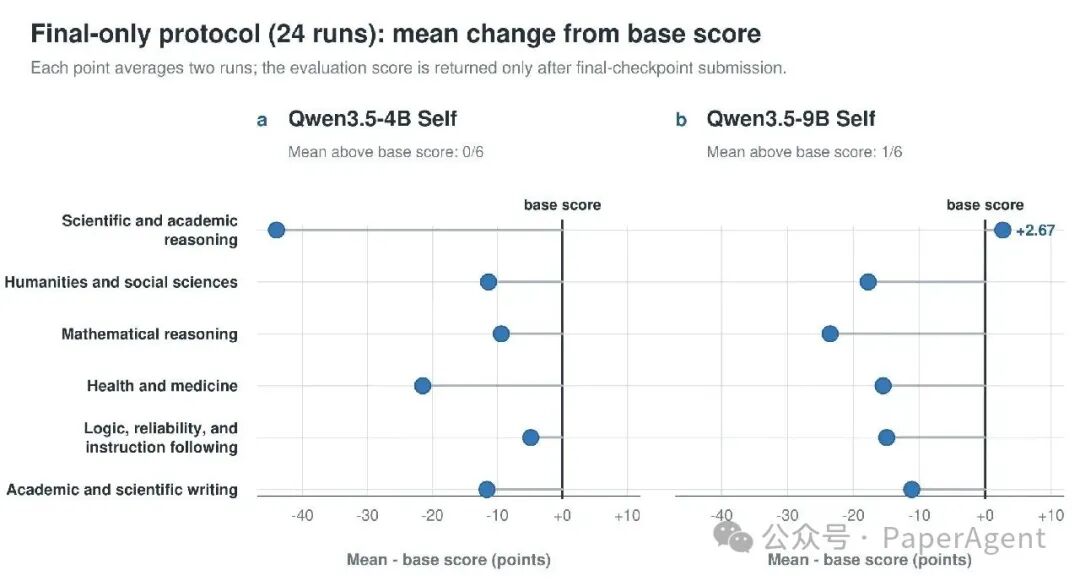
Aspire Figure 5:final-only 协议下各模型—目标对的两次运行均值(回滚前)。唯一越过基线的是 9B 科学推理
Table 5:final-only 最终 checkpoint 结果(回滚前)。12 个模型—目标对里只有 1 个均值为正。
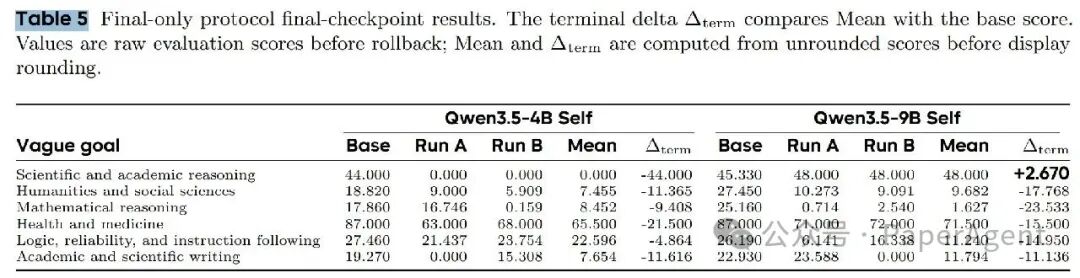
Table 5:final-only 最终 checkpoint 结果(回滚前)。12 个模型—目标对里只有 1 个均值为正
三个典型失败模式:表观进步可能只是从退化中恢复,搜得多 ≠ 搜得好,还有答案格式崩塌。
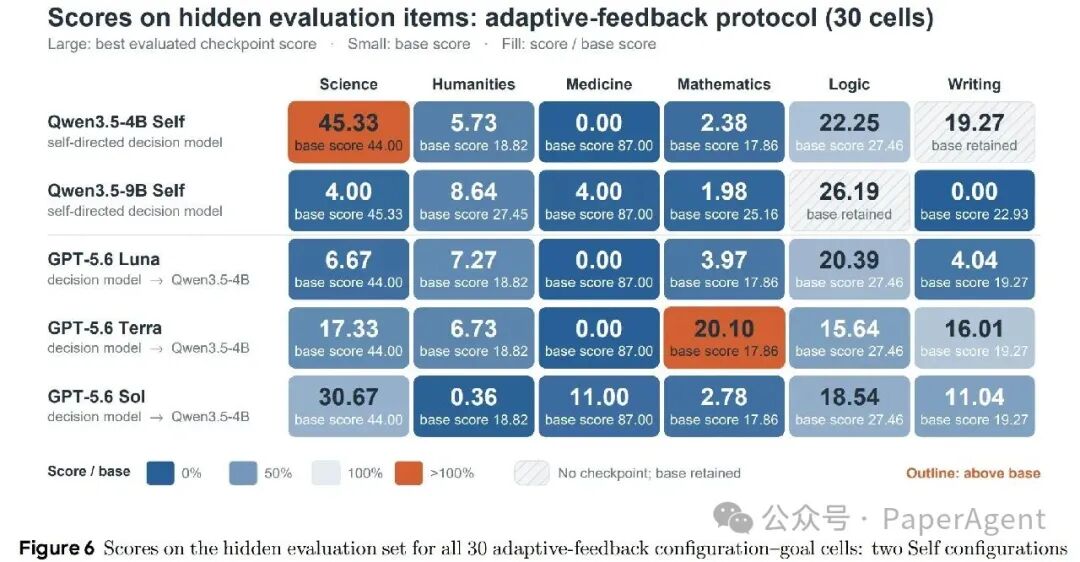
Aspire 一句话:模糊目标把搜索努力重新引向"解读目标",训练闭环执行得很熟练,但保留增益依然稀有——closing the training loop ≠ closing the capability loop。
二、S3Gym:认得出好动作,不等于能变成好策略
问题:现有基准只回答"评测这一刻模型多强",不回答"模型能不能用自己的经验变强"。
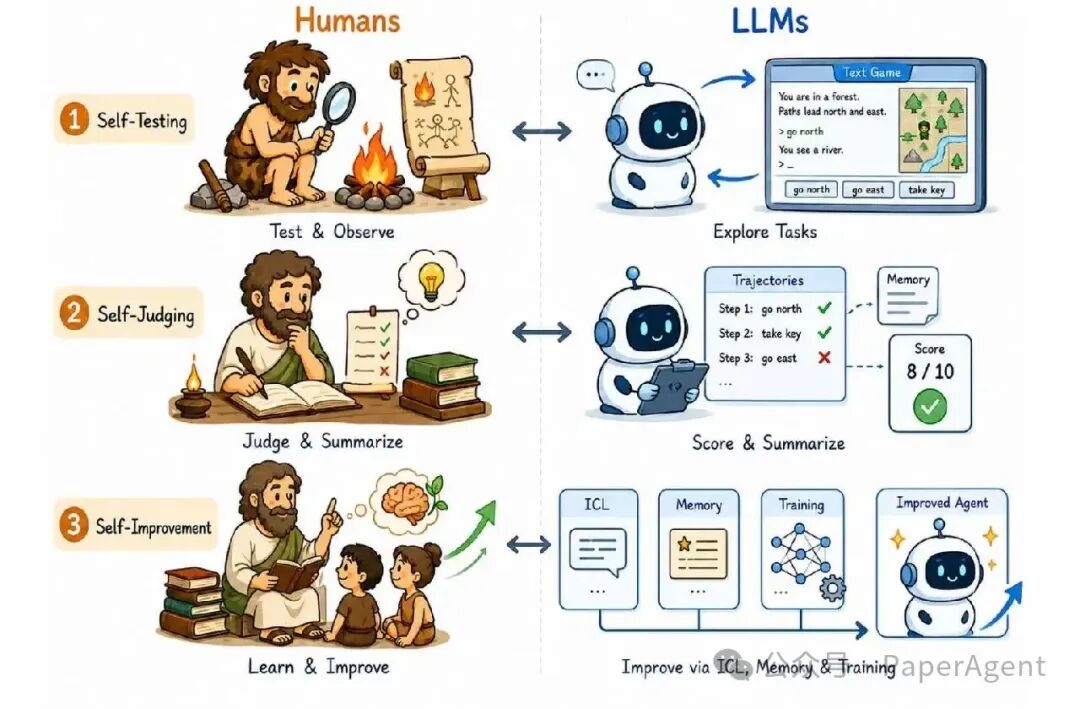
S3Gym 把经验学习拆成三个耦合环节:Self-Testing(收集证据)、Self-Judging(给自己的动作打分)、Self-Improvement(经验改变未来行为)。
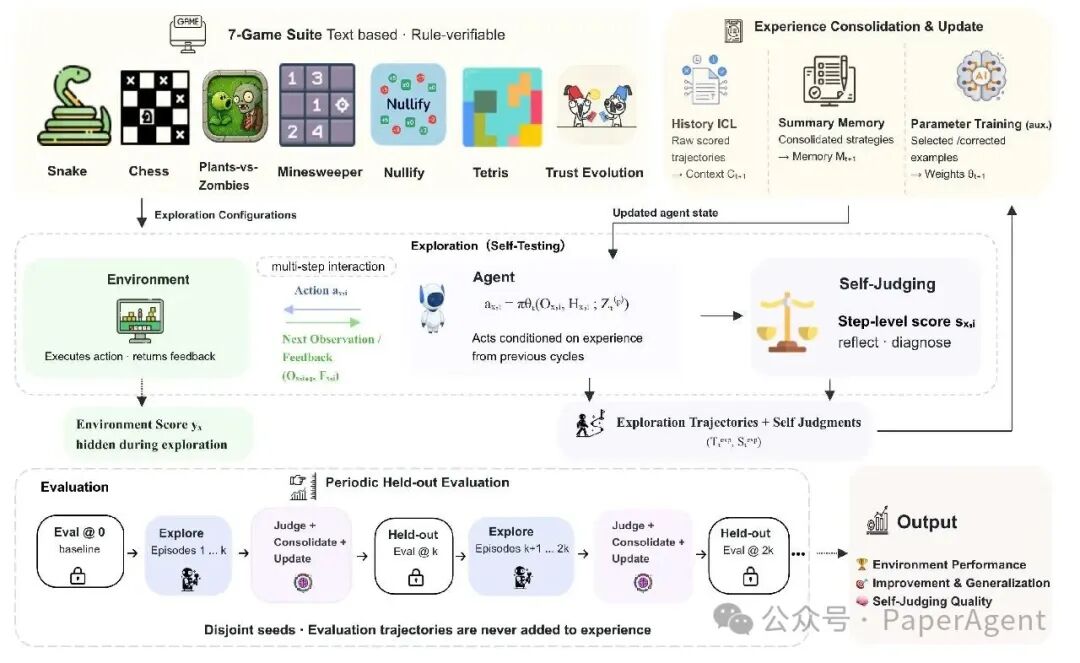
Figure 2:探索轨迹经评判后经三条路径之一被吸收
环境真值奖励在探索阶段对 Agent 不可见,Agent 只能靠自评分组织经验,benchmark 在暗处拿真值对照——由此可以分别测"自评判准不准"和"评判对了能不能变成改进"。
S3Gym 小结:从经验中学习
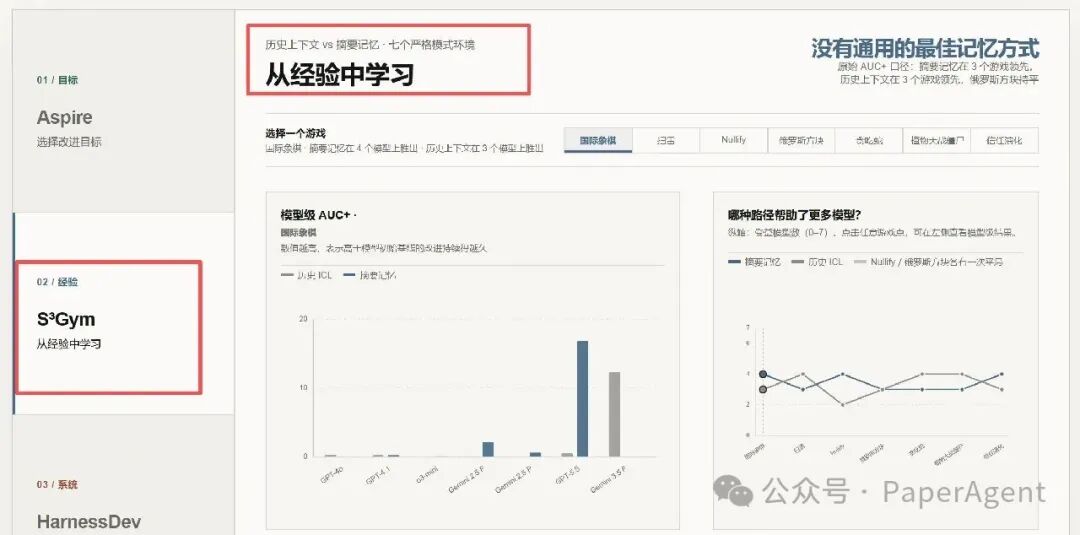
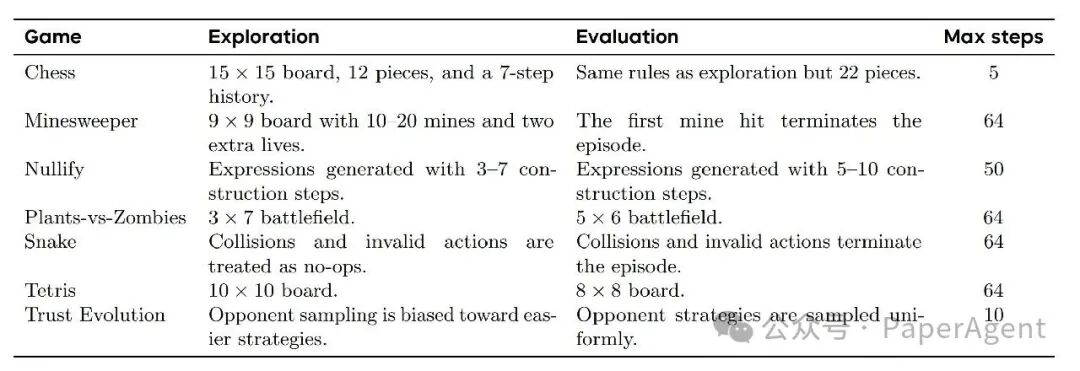
设置:七个文字游戏(Chess、Minesweeper、Snake、Tetris、PvZ、Nullify、Trust),宽松配置探索 → 评判固化 → 严格 held-out 配置评测,评了 7 个主流模型。指标除均值/最高分外,关键的是 AUC⁺:初始基线上方持续改进的正面积,用来区分"持续变强"和"孤立峰值"。
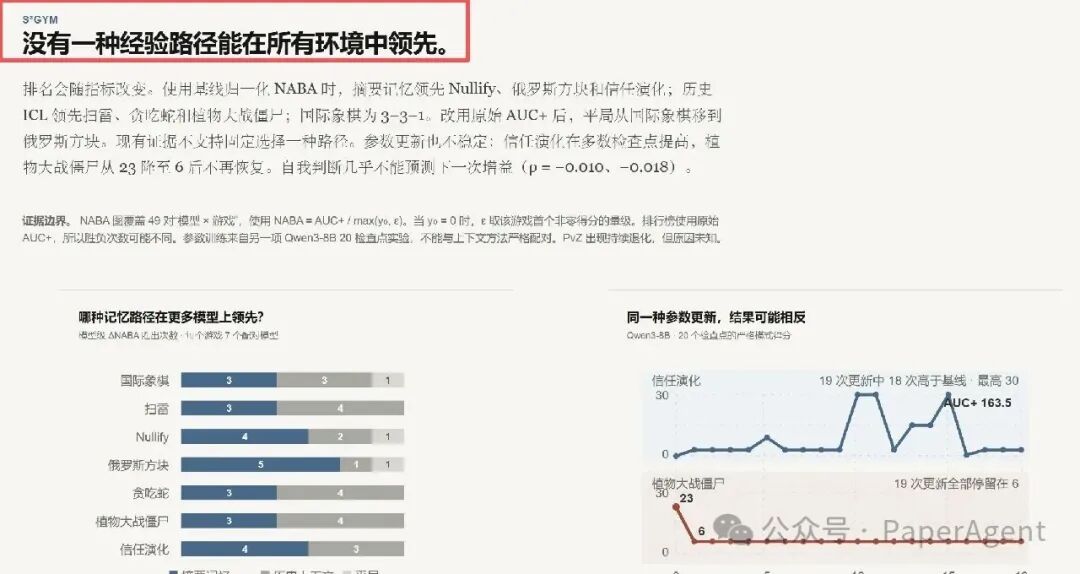
路径对比(结论很"看任务结构"):总结记忆对长轨迹难直接用的模型是质变——Gemini-2.5-Flash 的 Minesweeper AUC⁺ 从 0 提到 7.79,PvZ 从 24.4 提到 238.5;但对 GPT-5.5 的 PvZ 是灾难(548.5 跌到 33.2)。没有一个模型全游戏占优:History ICL 下 Gemini-3.5-Flash 领跑 Chess/Snake/Trust,GPT-5.5 领跑 Minesweeper/Nullify/Tetris。底座能力强 ≠ 会用自己的经验。
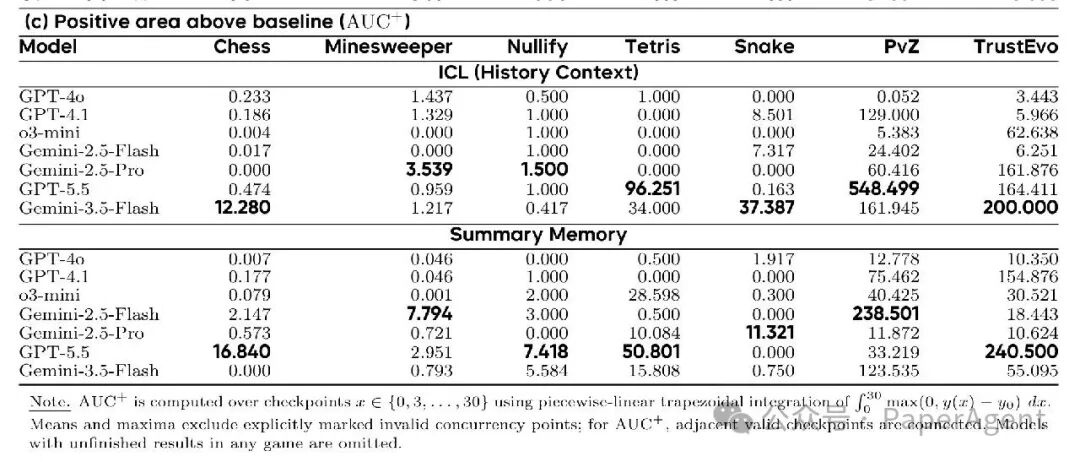
S3Gym Table 4c:AUC⁺(基线上方持续改进正面积),粗体为游戏内最佳。跨游戏比较应看游戏内名次
参数训练:把轨迹和自评判转成 SFT 样本直接改 Qwen3-8B 参数。Trust 上交互经验确实能内化(19 个更新 checkpoint 里 18 个超基线);但 PvZ 是最吓人的负迁移:初始 23 分,每一个更新后的 checkpoint 都只有 6 分——参数更新直接覆盖了原有有效行为。
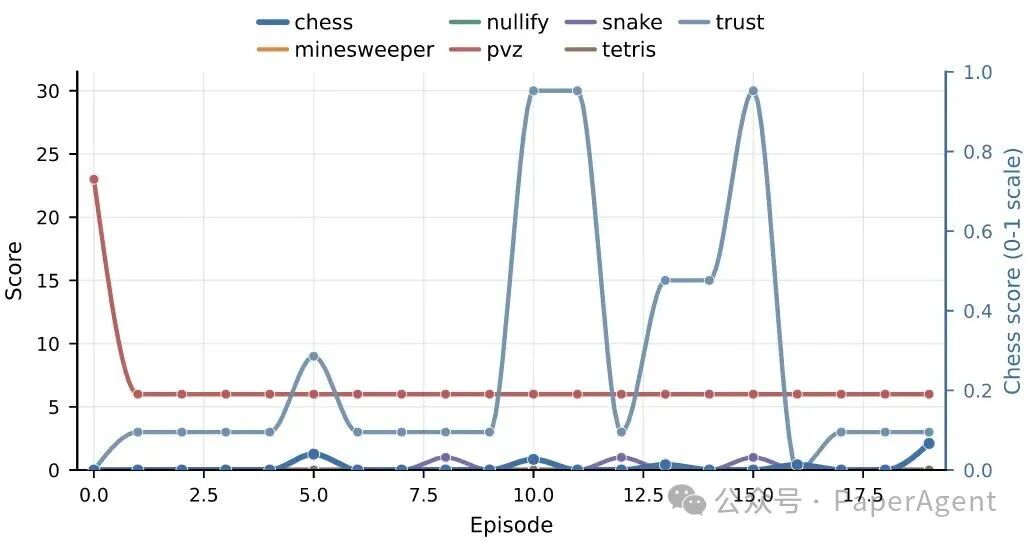
S3Gym Figure 7:Qwen3-8B 20 个训练 checkpoint 的严格模式表现。PvZ 全线低于初始,Minesweeper/Nullify/Tetris 全程为零
自评判可靠吗(最扎心的部分):用 98 个 run、11.6 万条转移对比自评分与环境真值——PvZ 二元一致率 0.881,但 NMAE 也高达 0.882:模型知道动作"看起来有用",却严重估错其价值;Chess 和 Trust 上自评判接近失效。更关键的是,评判准不准与下一步涨分几乎零相关(run 级 r=-0.23):局部打分对改进没有预测力。
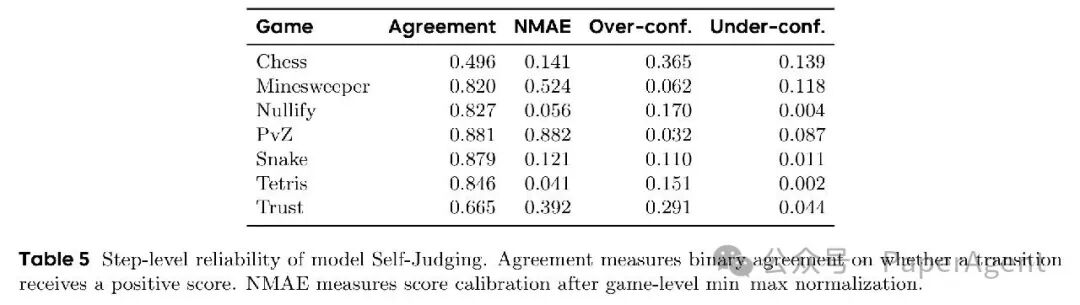
S3Gym Table 5:自评判的步级可靠性。一致率高不等于估值得准
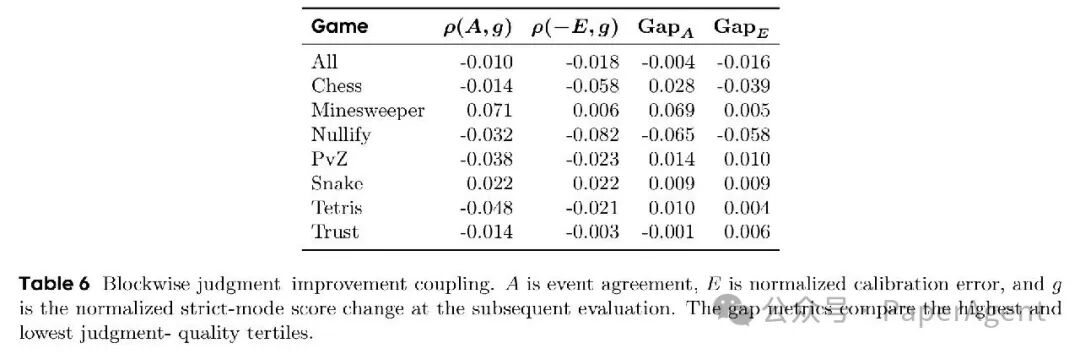
S3Gym Table 6:评判—改进耦合。事件一致率与下一步分数变化几乎无关
什么样的总结才有效:经验能压缩成紧凑规则的环境(Nullify、Tetris、Trust)总结占优;依赖局部精确细节的(Minesweeper、PvZ、Snake)原始历史占优。论文的正反例很传神——有效总结(GPT-5.5/Trust):"收益结构持续偏向背叛时就永远背叛",ΔNABA +66.9;无效总结(GPT-4o/Snake):"朝食物移动,避开墙和身体",方向全对但缺安全导航的几何精度,ΔNABA -22.0。合理而粗糙的建议,不如不给。
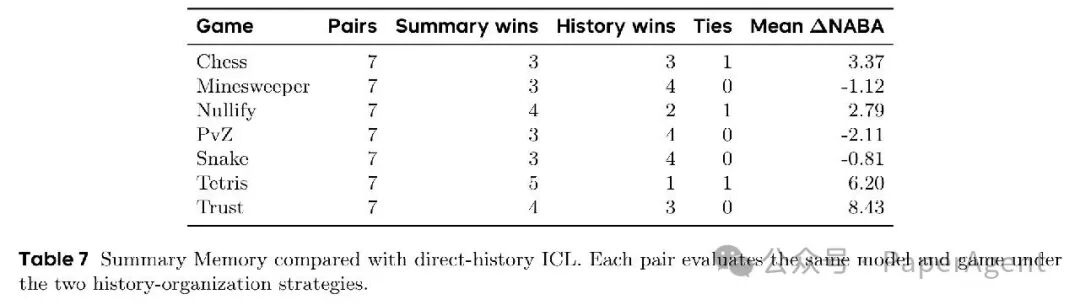
S3Gym Table 7:Summary Memory 与原始历史 ICL 的逐对比较。
S3Gym 一句话:认得出成功的动作,不等于能把反馈变成可执行、可迁移的策略。自我改进既不自动也不均匀,需要的是更好的评判校准、记忆筛选和轨迹过滤,而不是更多交互数据。
三、HarnessDev:能造 harness,但鲁棒进化还是难题
问题:同一 GPT-5 权重,在 Terminus 2 里解 Terminal-Bench 2.1 只有 35.2%,放进 Codex CLI 是 49.6%——harness(执行循环、工具协议、上下文管理、失败恢复这一圈模型之外的软件)对能力的影响可以超过模型换代。但主流评测只把 harness 当实验配置。
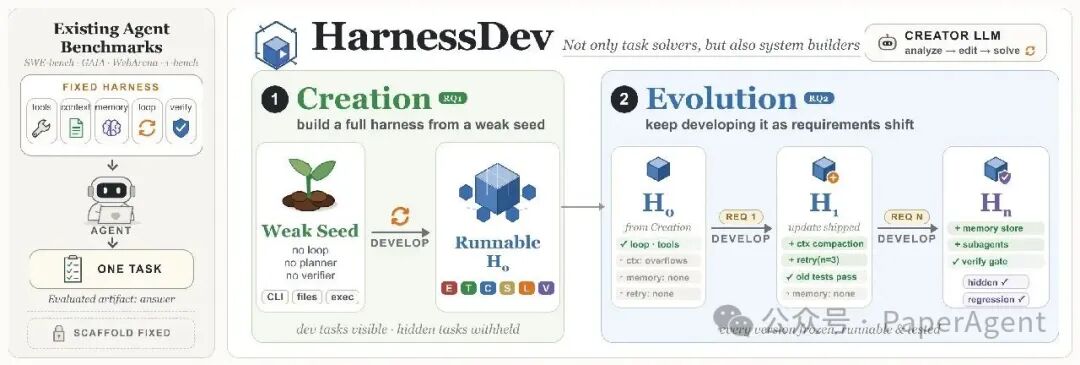
Figure 1:Creation 与 Evolution 两阶段,评测的都是跨任务持久存在的可运行基础设施
HarnessDev 把评测单位换成"可运行的基础设施",测两个阶段:Creation(从削弱的弱种子 + 1–3 个开发样例造出完整 harness)和 Evolution(拿下游执行反馈持续迭代)。六位创作者:Opus 4.8、GPT-5.5、Gemini 3.1 Pro、DeepSeek V4、Qwen 3.7 Max、Seed 2.0 Pro,开发环境统一 Claude Code。
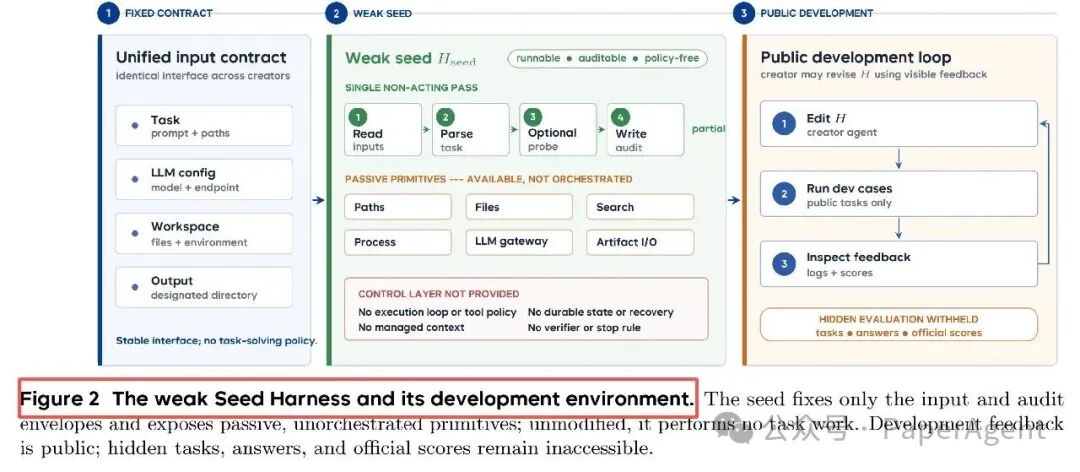
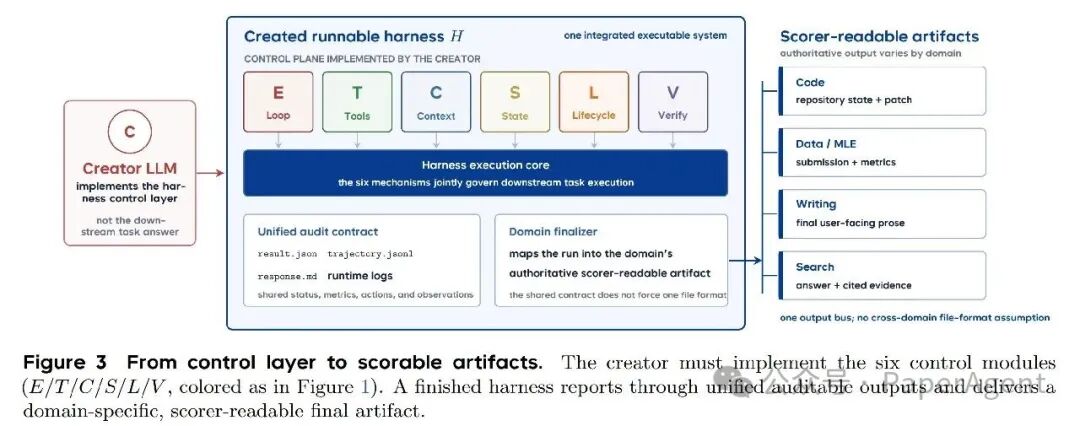
HarnessDev:创建并演化 Harness
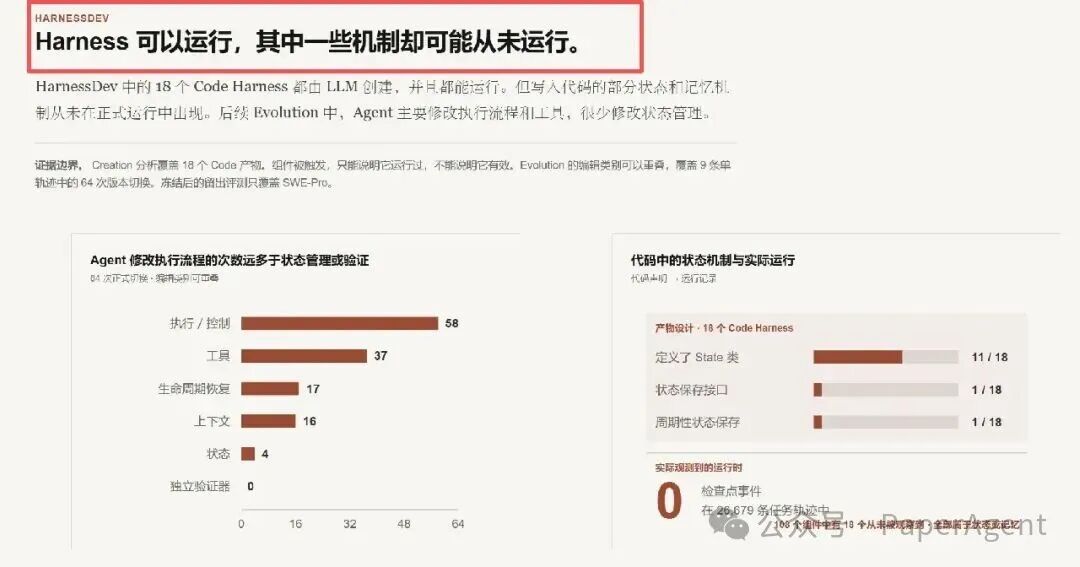
RQ1(能造,但造得好不好强烈分领域):Self-Eval 下 Opus 平均最高(67.8,人类工程参考 86.2),但分领域很不对称:MLE-bench 反超人类(32.9 vs 24.0)、写作追平(84.6 vs 83.7),差距最大在搜索(52.4 vs 92.2)和终端(64.8 vs 88.8)。而且排名依赖执行者:换统一执行者 Gemini 后 Opus 的 SWE-Pro 从 69.3 崩到 33.0——它给原执行器硬编码了 120 步上限;反过来 Qwen 的 harness 在 Gemini 下 BrowseComp +17.6、MLE +12.9。同一个 harness 换执行者结果可能反转:能跑 ≠ 能力跟着走。
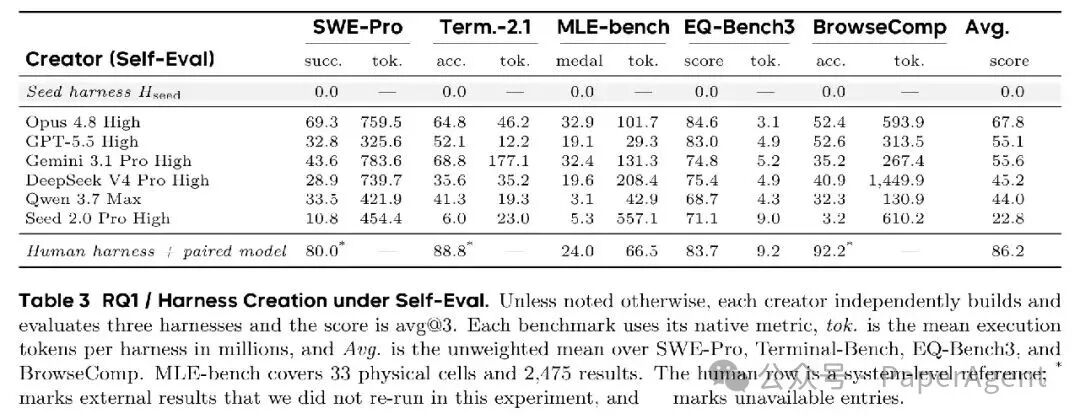
Table 3:Self-Eval 下的 Creation 结果(avg@3)。* 为外部已验证结果
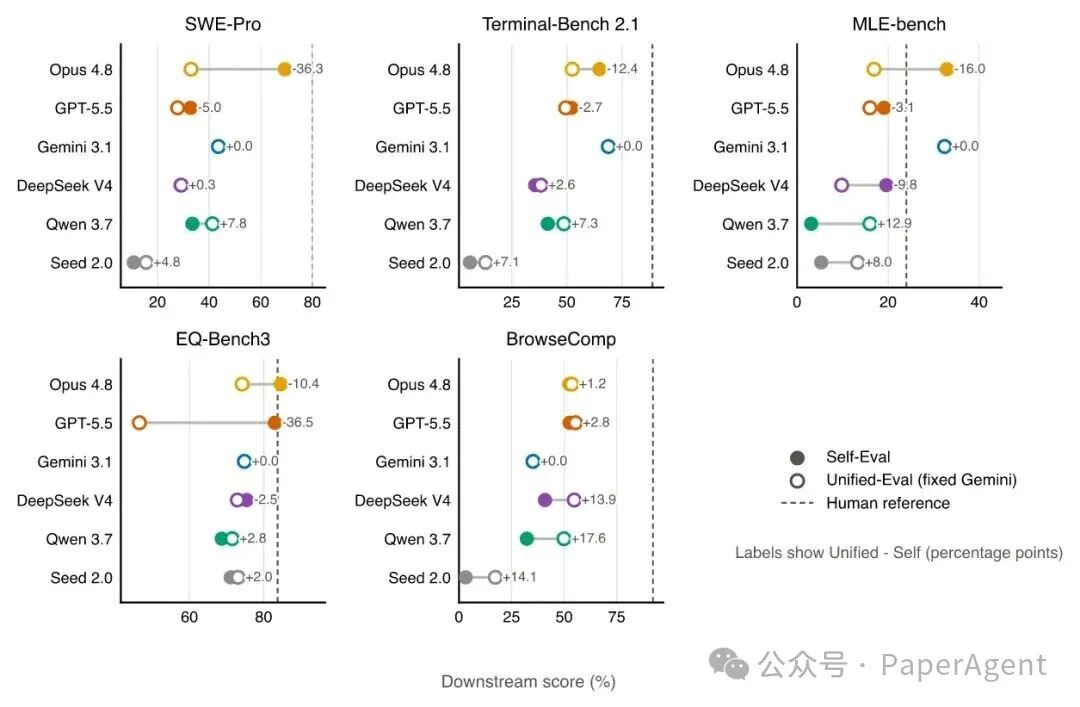
HarnessDev Figure 6:固定 Gemini 执行者下,同一 harness 的得分反转。
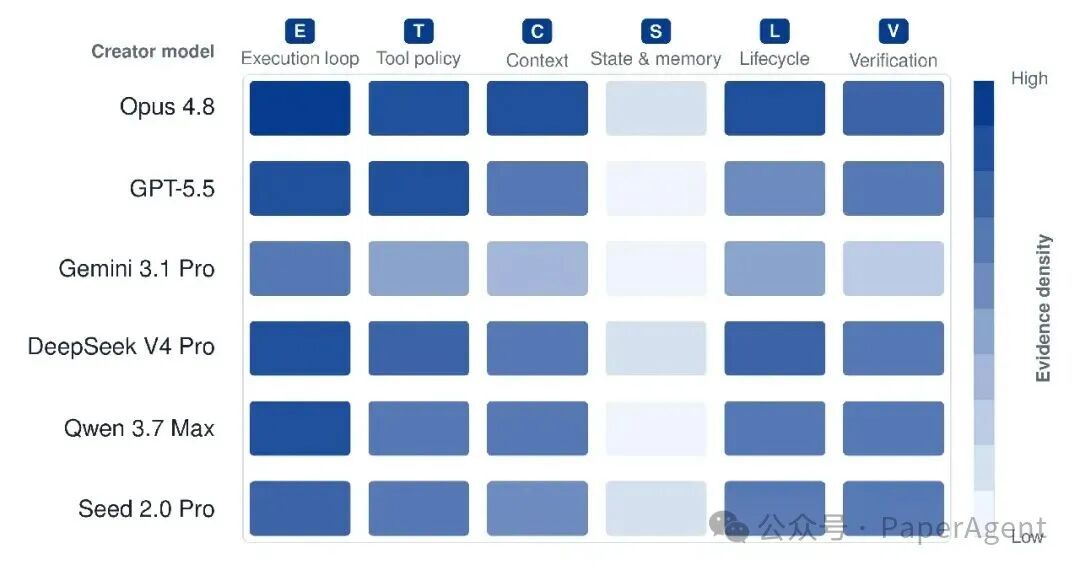
HarnessDev Figure 5:六类机制的证据密度。
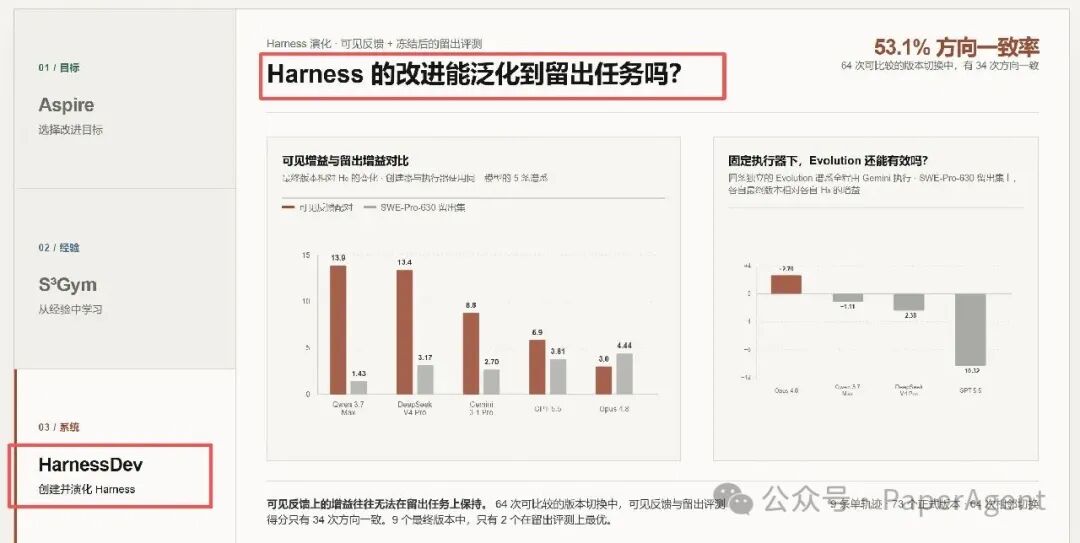
RQ2(进化 harness:局部能改好,全局留不住):从自己的 Code harness 出发,只用 100 题 SWE-Pro + 89 题 Terminal-Bench 的可见反馈迭代。9 条谱系在反馈集上都涨分,self-runtime 的在 held-out 上也都有 +1.43~+4.44 的净增益;但换固定 Gemini 执行者后情况就变了。
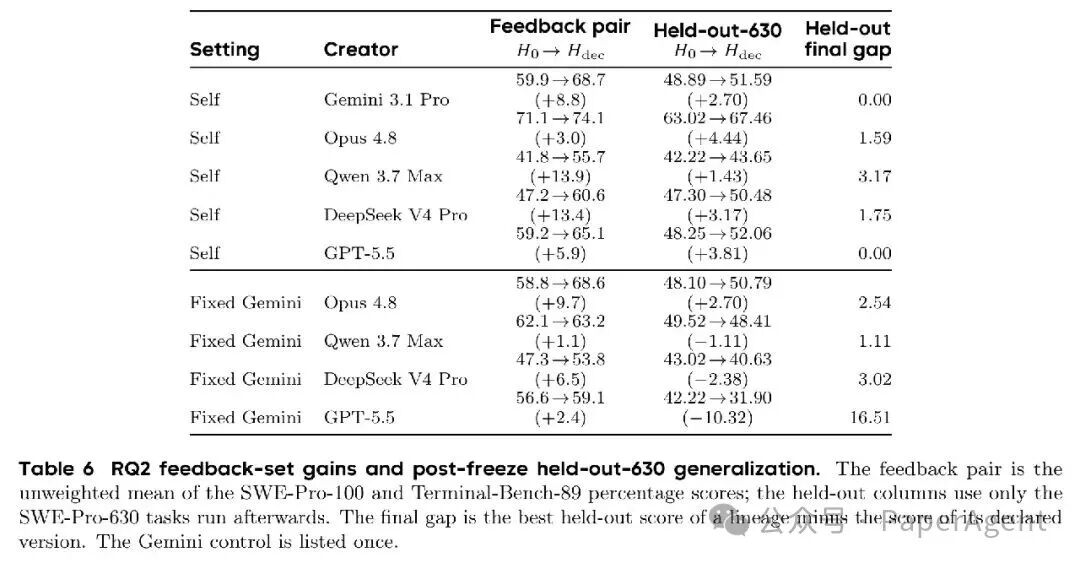
HarnessDev Table 6:反馈集增益与冻结后 held-out 泛化。
后三条谱系 held-out 直接转负(GPT-5.5 -10.32)。落差很说明问题:Qwen 反馈集 +13.9,held-out 只剩 +1.43——很大一部分"进化"是在适应反馈集本身。
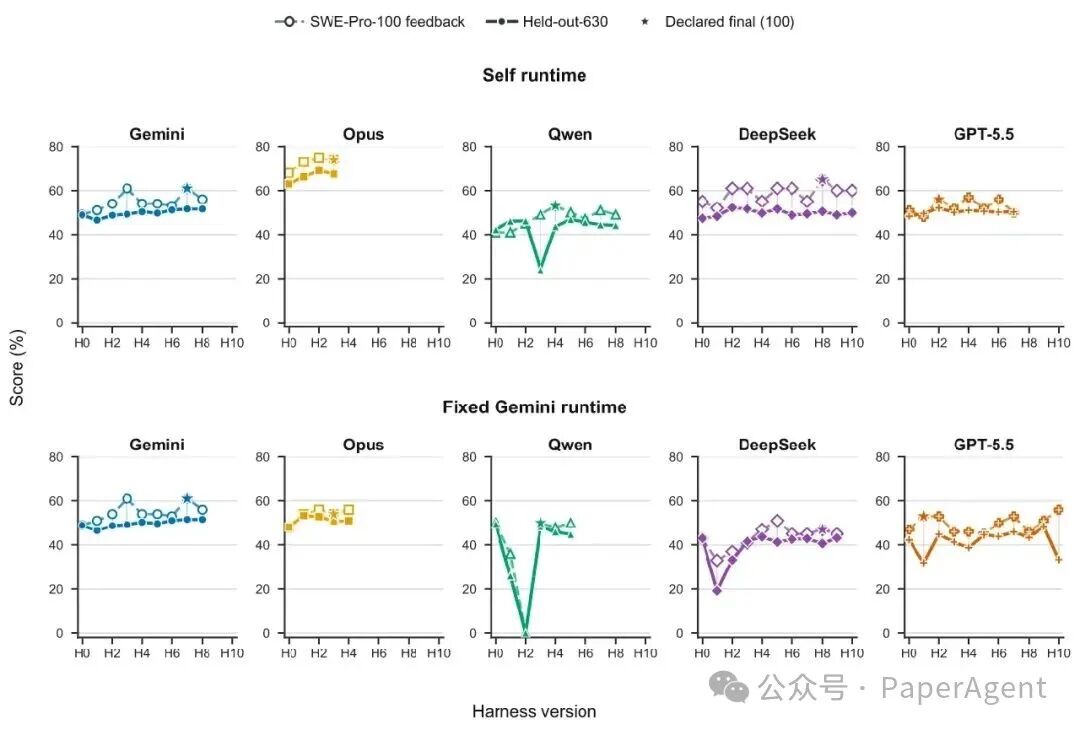
HarnessDev Figure 8:可见反馈轨迹(实线)与 held-out 轨迹(虚线)叠加。可见反馈上的峰,经常对应 held-out 上的谷
HarnessDev 一句话:模型权重是智能积累的一个地方,harness 是另一个——显式、可检查、可测试、可复用。今天的模型能造出可运行的执行系统、做出有用的局部改进,但跨未见任务、跨执行模型的鲁棒进化仍是开放难题。
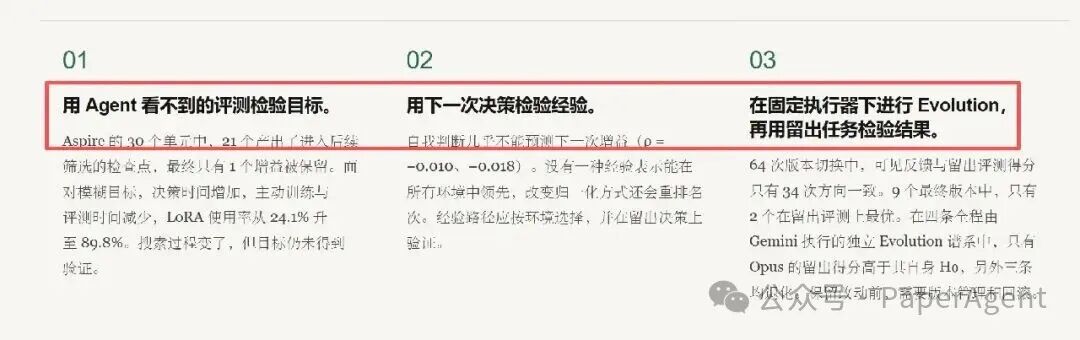
哪些改动值得保留?
- Aspire:用 Agent 看不到的评测检验目标。
- S³Gym:用下一次决策检验经验。
- HarnessDev:在固定执行器下进行 Evolution,再用留出任务检验结果。
https://arxiv.org/pdf/2608.31111
Aspire: Can Models Self-Evolve from Vague Goals?
https://arxiv.org/pdf/2608.31100
S3Gym: Can LLMs Turn Self-Testing and Self-Judging into Self-Improvement?
https://arxiv.org/pdf/2609.01437
HarnessDev: Can LLMs Create and Evolve Their Own Agent Harness?
 发表于 7 天前
|
查看: 0|
回复: 0


