面试官提问:从在浏览器地址栏输入一个 URL 并按下回车,到最终页面渲染呈现,整个系统链路中底层经历了哪些步骤?请结合网络协议、Linux 内核协议栈、反向代理与后端应用容器详细阐述。
回答这个问题,只列出“DNS 解析、TCP 握手、HTTP 请求、Nginx 转发、Tomcat 处理”还不够。进一步追问时,关键在于能否把网络、Linux 内核、中间件和 Web 容器连接起来,并说明请求在哪些地方排队、如何被唤醒,以及怎样进入业务代码。
下面以 HTTPS 请求通过 Nginx 转发至 Tomcat 和 Spring MVC 为例,梳理从客户端发起请求到服务端响应、浏览器渲染的主要链路。实际过程会因缓存、协议版本、代理和应用架构而有所不同。
1. 全链路心智模型:五大阶段
从客户端发起请求到服务端生成响应,可以先分成五个阶段。响应返回后,浏览器再解析资源并渲染页面。
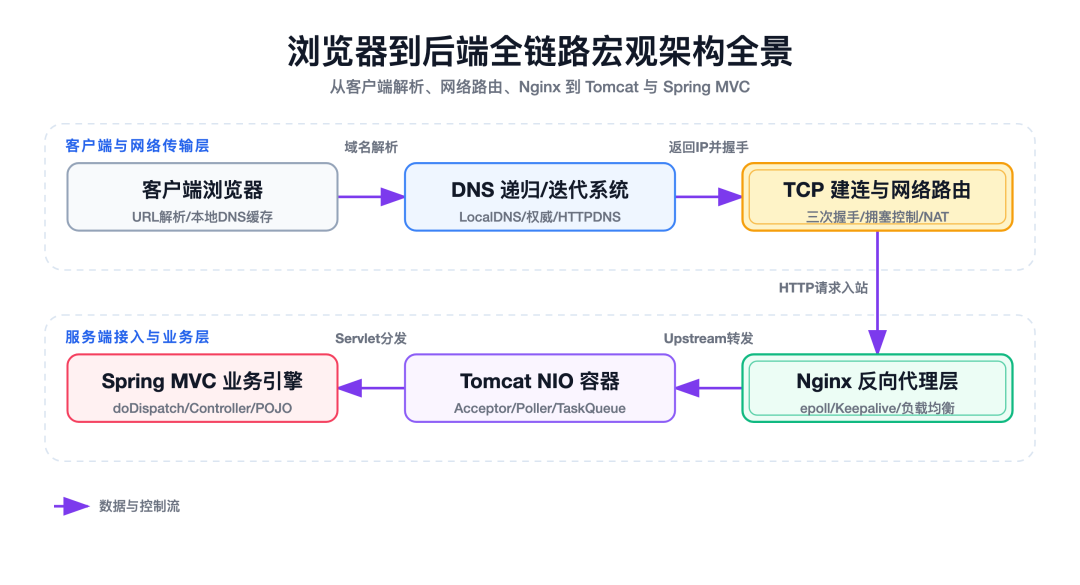
| 阶段 |
核心组件或层次 |
核心职责与关键动作 |
关键参数与关注点 |
| 第一阶段 |
客户端与 DNS 系统 |
URL 解析、分级缓存查找、递归与迭代查询、获取目标 IP |
DNS 缓存 TTL、HTTPDNS |
| 第二阶段 |
传输层建立连接 |
TCP 三次握手、同步双向初始序列号(ISN)、交换窗口等信息 |
半连接队列、全连接队列、tcp_syncookies |
| 第三阶段 |
Linux 内核网络协议栈 |
网卡 DMA、Ring Buffer、NAPI 轮询、协议栈处理 |
ksoftirqd、Socket 接收队列、epoll_wait |
| 第四阶段 |
Nginx 反向代理层 |
Master-Worker、I/O 多路复用、负载均衡与反向代理 |
keepalive、连接复用和资源占用 |
| 第五阶段 |
Tomcat 容器与 Spring MVC |
Acceptor 接收连接、Poller 监听事件、工作线程处理请求 |
TaskQueue、HandlerMapping、拦截器链 |
2. 阶段一:客户端发起与 DNS 解析
当用户输入 https://api.mall.com/order/detail?id=1024 并回车,浏览器会先解析 URL,识别协议、主机名、路径和查询参数,再根据缓存与连接状态决定是否需要解析域名、建立新连接并发起请求。
2.1 浏览器本地分级缓存排查
需要解析域名时,客户端可能先检查以下位置;具体顺序取决于浏览器、操作系统及其配置:
- 浏览器 DNS 缓存:Chrome 等浏览器维护自己的 DNS 缓存。Chrome 可通过
chrome://net-internals/#dns 查看相关信息;缓存期限受浏览器实现及 DNS 记录等因素影响。
- 操作系统解析配置、Hosts 与缓存:浏览器可能调用系统解析接口,例如
getaddrinfo。系统可根据配置检查 /etc/hosts、Windows 的 C:\Windows\System32\drivers\etc\hosts,以及 systemd-resolved、nscd 等提供的缓存。
浏览器也可能使用安全 DNS 等自身配置,因此不一定完全按照系统解析路径执行。
2.2 LocalDNS 的递归与迭代查询
如果未命中可用缓存,客户端通常向配置的本地 DNS 解析器发起查询。该解析器可能由 DHCP 下发,也可能是手动配置的公共 DNS,例如 114.114.114.114 或 8.8.8.8。
一个未命中解析器缓存的简化流程如下:
- 客户端向 LocalDNS 发起递归查询,请求其返回最终结果。
- LocalDNS 查询根域名服务器,获取
.com 对应的服务器信息。
- LocalDNS 查询
.com 顶级域名服务器,获取 mall.com 的权威服务器信息。
- LocalDNS 查询权威服务器,获取
api.mall.com 的解析结果,并返回给客户端。
递归查询要求解析器代表客户端完成后续查询;迭代查询则是解析器根据收到的转介继续询问其他服务器。最终结果可能包含 A 记录(IPv4)或 AAAA 记录(IPv6);如果存在 CNAME 等记录,解析过程还会继续。
2.3 生产实践:移动端为什么引入 HTTPDNS?
依赖普通 LocalDNS 时,可能遇到以下问题:
- 域名劫持与缓存污染:某些网络设备或解析服务可能篡改结果,将用户导向非预期地址。
- 调度不精准与跨网访问:DNS 调度可能参考解析器的网络位置;用户使用距离较远的公共 DNS 时,返回的 CDN 节点未必适合客户端。
- TTL 未被遵守:部分解析器可能长时间保留旧记录,使切流或容灾结果生效延迟。
HTTPDNS 是一种常见方案:移动端 App 通过 HTTPS/HTTP 协议向 HTTPDNS 服务请求解析结果,例如 https://httpdns.example.com/d?dn=api.mall.com。它绕过传统 DNS 的部分解析路径,可结合客户端出口地址辅助调度。
需要注意,HTTPDNS 并不自动保证解析安全或切流时效:明文 HTTP 仍可能被篡改;使用 HTTPS 时还需要正确处理服务地址解析、证书校验和域名信息。
3. 阶段二:TCP 握手与内核队列
拿到目标 IP 后,如果没有可复用的连接,浏览器可能建立新的连接。对于基于 TCP 的 HTTPS,通常先完成 TCP 握手,再进行 TLS 握手。HTTP/3 则使用基于 UDP 的 QUIC,连接建立过程不同。
3.1 三次握手的本质与状态演进
TCP 三次握手用于同步双方初始序列号,并确认双方能够参与双向通信;握手报文也会交换窗口及部分 TCP 选项。它本身并不提供加密或身份认证。
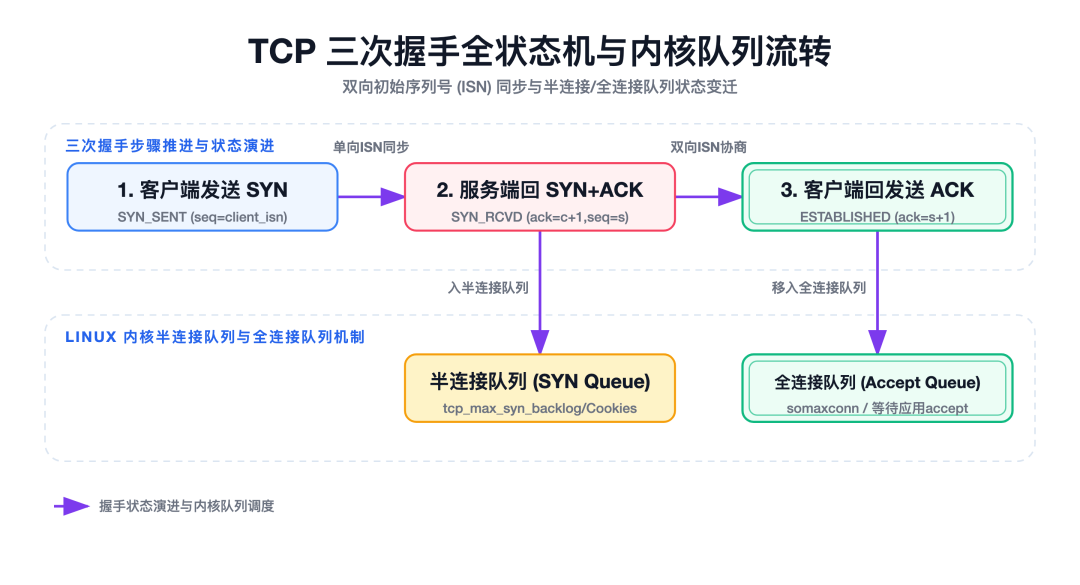
- 客户端发送 SYN:携带
seq=client_isn,客户端进入 SYN_SENT。
- 服务端回复 SYN+ACK:携带
seq=server_isn 和 ack=client_isn+1,服务端通常进入 SYN_RCVD。
- 客户端发送 ACK:携带
seq=client_isn+1 和 ack=server_isn+1。客户端发送 ACK 后进入 ESTABLISHED;服务端收到有效 ACK 后进入 ESTABLISHED,连接等待应用程序接受。
3.2 为什么不能只握手两次?
- 降低历史连接请求造成的资源占用:旧 SYN 可能因网络延迟晚到。如果服务端在发送第二次握手后就认为连接已经完全建立,可能为客户端不再需要的连接分配资源。第三次握手要求客户端对服务端的响应作出确认,有助于识别此类失效请求。
- 完成双向序列号同步的确认:前两次报文使双方分别获得对方的初始序列号,但服务端还需要客户端的 ACK,才能确认自己的初始序列号已被客户端接收。
3.3 Linux 半连接队列与全连接队列
高并发场景下,要关注 TCP 握手过程中两个与监听 Socket 相关的队列:
- 半连接队列(SYN Queue):服务端收到 SYN 后,通常会为处于
SYN_RCVD 状态的请求保留信息。net.ipv4.tcp_max_syn_backlog 等参数会影响可容纳的未完成握手请求,实际行为还与内核版本和配置有关。
- 全连接队列(Accept Queue):握手完成后,连接等待应用程序调用
accept()。队列上限通常受 listen() 的 backlog 与 net.core.somaxconn 共同约束,常用表达为 min(backlog, net.core.somaxconn)。
生产故障:SYN Flood 与 SYN Cookies
SYN Flood 攻击中,攻击者发送大量 SYN,却不完成后续握手,可能耗尽半连接相关资源,影响正常用户建连。
- 防御配置:
net.ipv4.tcp_syncookies = 1。
- 运行机制:在需要启用 SYN Cookies 时,内核将连接相关信息编码到服务端初始序列号中,回复 SYN+ACK,而不按通常方式为每个请求保留完整的半连接状态。收到客户端 ACK 后,内核验证 Cookie,再尝试建立连接并放入接受队列。
SYN Cookies 是资源紧张时的防护手段,不应替代容量规划和对流量来源的排查。
4. 阶段三:Linux 内核收包,从网卡到用户态
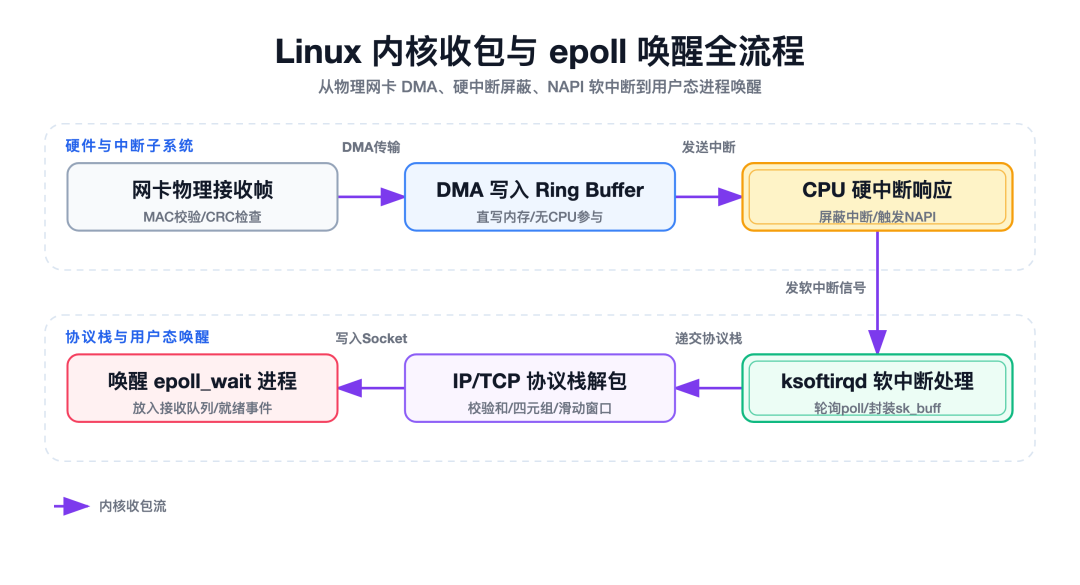
TCP 连接建立后,请求数据到达服务端。以常见以太网和 Linux NAPI 收包路径为例,数据要经过网卡、驱动、内核协议栈和 Socket,才能被用户态程序读取。
4.1 网卡 DMA 写入 Ring Buffer
数据帧到达网卡后,硬件通常会执行以下动作:
- 根据配置过滤目标 MAC 地址,并检查帧校验序列。混杂模式、多播等场景下,接收规则有所不同。
- 通过 DMA(Direct Memory Access) 将接收数据写入主机内存中预先准备的缓冲区。驱动通过接收环(RX Ring)管理相关描述符与缓冲区,数据传输不需要 CPU 逐字节搬运。
4.2 硬中断通知与 NAPI
网卡需要通知系统处理到达的数据。典型 NAPI 路径包括:
- 网卡触发硬中断,CPU 执行驱动注册的中断处理程序。
- 驱动通常暂时屏蔽或抑制该队列的接收中断,并调度 NAPI 轮询。
- 后续通过网络接收软中断批量处理数据,降低高流量下逐包中断的开销;轮询结束后再按驱动逻辑恢复中断。
实际时序还会受到中断合并、驱动实现和网卡配置影响。
4.3 软中断轮询与协议栈处理
NAPI 轮询可以在软中断上下文执行;当处理预算不足等情况出现时,也可能由 ksoftirqd 线程继续处理。驱动将接收数据关联到 sk_buff(Socket Buffer),再递交网络协议栈。
- 链路层接收:通过
netif_receive_skb 等路径处理数据,根据以太网协议类型交给 IPv4、IPv6 等上层协议。
- 网络层处理:IPv4 路径中,
ip_rcv 参与首部校验和路由判断;分片重组等操作取决于报文与具体处理路径。转发数据包时会处理 TTL,本机接收并不意味着一律执行 TTL 减一。
- 传输层处理:
tcp_v4_rcv 等路径根据源 IP、源端口、目的 IP、目的端口查找对应 TCP Socket,处理校验和、序列号、接收窗口及数据重组。
- 写入接收队列并通知应用:有效数据进入对应 Socket 的接收缓冲区;等待该 Socket 的
read 或事件通知机制可以获知数据已就绪,唤醒相应的用户态执行线程。
5. 阶段四:Nginx 接入层的高性能处理
经过内核协议栈,请求到达 Nginx 反向代理层,再由它根据配置转发给后端。
5.1 epoll 事件驱动与连接接入
Nginx 通常采用 Master-Worker 多进程架构:
- Master 进程负责加载配置、管理 Worker 进程及处理信号。
- Worker 进程处理连接和请求。Worker 数量通常参考 CPU 核心数;是否使用
worker_cpu_affinity 绑定核心取决于部署配置。
- 在 Linux 上,Worker 可以使用基于 epoll 的 I/O 多路复用事件循环。Socket 可读时,
epoll_wait 返回就绪事件,Worker 再通过非阻塞 I/O 将数据读入用户态。
5.2 生产关键决策:Keepalive 长连接复用
频繁创建和关闭连接会增加握手、系统调用和连接状态维护的开销,也可能产生大量 TIME_WAIT。是否发生端口耗尽,需要结合主动关闭方、连接速率和可用端口范围分析,不能仅凭 TIME_WAIT 数量判断。
| 链路节点 |
连接情况 |
配置示例 |
收益与风险 |
| Client ↔ Nginx |
现代浏览器通常支持连接复用 |
keepalive_timeout 65s;、keepalive_requests 10000; |
减少重复握手;需合理限制空闲时间和请求数 |
| Nginx ↔ Upstream(Tomcat) |
默认行为与 Nginx 版本及配置有关,不能假定已启用上游连接复用 |
配置 upstream keepalive,并按版本和代理协议配置 HTTP 版本及连接头 |
减少反复建连和关闭;连接池也会占用资源 |
例如,可按以下方式为上游配置连接复用:
upstream backend {
    keepalive 32;
}

proxy_http_version 1.1;
proxy_set_header Connection "";
其中 keepalive 32 表示每个 Worker 可缓存的上游空闲连接数,不是对上游连接总数的限制。是否生效还取决于上游配置、后端响应及其他代理设置。
Nginx 匹配反向代理规则后,还可能根据配置完成 TLS 终止、限流等操作,再将请求转发给后端应用服务器,例如 Spring Boot 内嵌的 Tomcat。
6. 阶段五:Tomcat 容器与 Spring MVC 分发引擎
请求抵达 Spring Boot 服务后,Tomcat 容器负责接入连接和处理 HTTP,Spring MVC 再将请求分发到对应的业务方法。
6.1 Tomcat NIO 线程模型:Acceptor、Poller 与 Worker
Tomcat NIO 连接器将连接接入、事件监听和请求处理分工:
- Acceptor 线程:调用服务端 Socket 的
accept() 接收新连接,将连接配置为非阻塞模式,并交给 Poller 注册。具体线程数量和分配方式取决于 Tomcat 版本与配置。
- Poller 线程:使用 Java NIO
Selector 监听已注册的 Socket Channel。发生读就绪等事件时,将对应的 SocketProcessor 任务交给执行器处理。
- Worker 工作线程:读取和解析 HTTP 数据,处理请求行、请求头、查询参数和请求体,并通过 Servlet API 将请求与响应交给应用。
6.2 Tomcat 线程池与 JDK 默认排队策略有何不同?
考虑一个配置:corePoolSize=10、maxThreads=200、queueCapacity=10000。当第 11 个请求到达时,究竟是入队还是创建新线程?答案取决于现有线程是否空闲、线程池和队列实现,而不能只看请求编号。
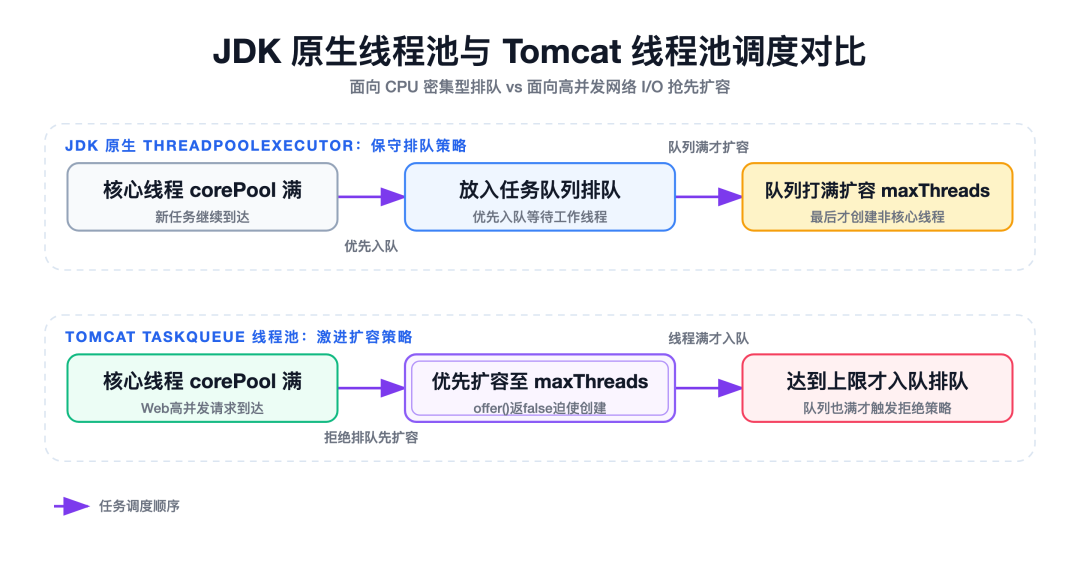
- JDK
ThreadPoolExecutor 的常见策略:核心线程数已达到时,先尝试入队;入队失败后再尝试创建线程,直至最大线程数;仍无法接收时执行拒绝策略。这一通用机制并不只适用于 CPU 密集型任务。
- Tomcat 的网络 I/O 场景:如果请求长时间在大队列中等待,客户端可能先超时。Tomcat 使用定制的线程池和
TaskQueue,在满足条件时倾向于先扩容,再排队。
TaskQueue.offer() 的关键思路:当已有线程不足以处理已提交任务、且线程数仍可增长时,队列可以返回 false,促使执行器尝试创建新线程。已有空闲工作线程、并发竞争或线程数达到上限时,行为会有所不同。
以下是原理示意,并非完整源码:
// 示意:需要更多工作线程,且当前线程数尚未达到上限时
if (parent.getPoolSize() < parent.getMaximumPoolSize()) {
    return false; // 促使线程池尝试创建新的工作线程
}
实际判断还涉及已提交任务数、当前线程数以及并发下的重试处理。Tomcat 也可能使用外部配置的执行器,因此应以具体版本和配置为准。
6.3 Spring MVC DispatcherServlet 分发全链路
Worker 线程经过 Tomcat 的 Engine、Host、Context、Wrapper 等容器处理链,调用 Servlet 的 service() 方法,随后进入 Spring MVC 的 DispatcherServlet.doDispatch()。
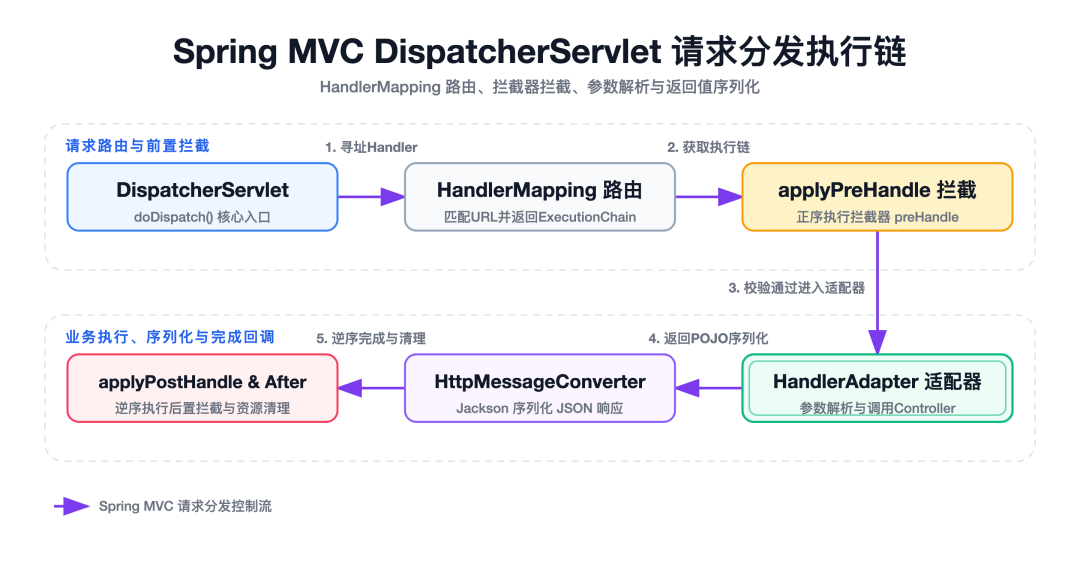
典型同步请求的处理过程如下:
- 查找处理器:
getHandler(request) 遍历适用的 HandlerMapping。例如,RequestMappingHandlerMapping 根据 URL、HTTP Method 等条件匹配方法,返回包含处理器与拦截器的 HandlerExecutionChain。
- 查找适配器:
getHandlerAdapter(...) 找到支持该处理器的 HandlerAdapter,例如 RequestMappingHandlerAdapter。
- 执行前置拦截器:
applyPreHandle() 按顺序调用 interceptor.preHandle();如果某个拦截器返回 false,后续处理会中断。
- 调用处理器:
ha.handle() 使用 HandlerMethodArgumentResolver 解析 Query、Header、Path 变量和 JSON Body 等参数,调用 Controller 及其 Service、DAO 等业务逻辑,再通过 HandlerMethodReturnValueHandler 处理返回值。对于 @ResponseBody,可使用配置的 HttpMessageConverter,例如通过 Jackson 将对象序列化为 JSON。
- 执行后置拦截器:正常处理路径中,
applyPostHandle() 逆序调用 interceptor.postHandle()。
- 完成回调:请求完成或发生异常等情况下,对此前
preHandle() 成功执行的拦截器,逆序触发 afterCompletion(),可用于资源清理或审计。异步请求还有额外的生命周期处理。
业务处理完成后,响应数据经 Servlet 容器写入网络连接,由内核封装为 TCP 报文段,再经过网卡和网络返回浏览器。HTTPS 场景下,TLS 加密与解密发生在对应的 TLS 终止端。
6.4 浏览器如何呈现页面?
浏览器收到响应后,会根据响应类型处理内容。对于 HTML 页面,通常需要解析 HTML 构建 DOM、解析 CSS 构建 CSSOM,结合样式形成渲染所需的结构,再进行布局、绘制和合成。解析过程中还可能发现并请求 CSS、JavaScript、图片等资源;脚本执行和资源加载也可能影响渲染时机。
如果示例接口返回的是 JSON,浏览器或前端应用还需要用这些数据更新页面,才能呈现相应内容。
7. 面试回答:从总览到关键细节
回答全链路问题时,可以先说明整体路径,再根据面试官的追问展开内核队列、中断处理或容器线程模型:
- 总览:浏览器解析 URL 并检查缓存;需要访问网络时,解析域名、建立或复用连接、发送请求。请求可经过 Linux 内核、Nginx 和后端容器,响应返回后由浏览器处理并渲染。
- DNS:解析可能经过浏览器缓存、系统 Hosts 与缓存、本地 DNS 解析器,再由解析器迭代查询根、顶级域和权威服务器。部分移动应用会使用 HTTPDNS 改善解析与调度问题。
- TCP 与 TLS:基于 TCP 的新连接通过三次握手同步初始序列号;HTTPS 通常还要进行 TLS 握手。Linux 需关注半连接和全连接队列,SYN Cookies 可在特定场景下缓解半连接资源压力。
- 内核协议栈:网卡通过 DMA 接收数据,驱动借助中断和 NAPI 调度收包;数据经过网络层、传输层处理后进入 Socket 接收队列,再通知等待的应用。
- Nginx:Worker 通过事件驱动和非阻塞 I/O 处理连接,根据配置完成 TLS 终止、路由及反向代理。合理复用客户端和上游连接,可以减少频繁建连的开销。
- Tomcat 与 Spring MVC:Acceptor 接收连接,Poller 监听事件,Worker 处理请求。Tomcat 定制线程池可在一定条件下优先扩容;Spring MVC 则通过
DispatcherServlet、处理器映射、拦截器和适配器调用业务方法并生成响应。
- 浏览器渲染:浏览器解析 HTML 和 CSS,执行相关脚本并加载资源,完成布局、绘制与合成;实际请求也可能命中缓存或使用 HTTP/3 等不同协议路径。
8. 课后练习与迁移思考
- 如果客户端与服务端之间存在 NAT 网关,TCP 握手期间的 MSS 协商与路径 MTU 如何共同影响报文分段?哪些情况下仍可能发生 IP 分片?
- 线上排查网络抖动时,使用
netstat -s | grep "overflowed" 发现全连接队列溢出,应从哪些内核参数、监听 backlog 和应用处理能力入手排查与调优?
来源
作者:码哥
 发表于 昨天 10:47
|
查看: 16|
回复: 0
 /1


