最近本体领域有两个进展值得记录。一个是用于推理的 Graph 序列化形式对比实验,这属于工程经验的系统整理;另一个是 open-ontologies 这个项目,近段时间受到不少关注,定位为本体的可信检查。可以把它理解成本体界的 CI 检查:写本体像写代码,光写完不够,还要有语法检查(validate)、有 lint、有测试(SHACL 约束)、有可复现的构建证明(certificate)。它不替代建模,它保证建出来的东西能验证、能治理、能举证。
对于 open-ontologies,先说一个结论:它最独特的证明携带能力,恰恰也是它最不普适的地方。对绝大多数只是建个本体、跑个查询的人来说,这套独立复核显得多余,Protégé 加 rdflib 已经够用;它的价值只在一个特定场景里——当你需要向审计、监管或合作方证明“这个推理结论不是我拍脑袋出来的,是可验证的”,别的工具给不出这种保证,它能做些事情。
技术本身还是很有趣的,值得持续跟进。
一、用于 LLM 推理的 Graph 序列化形式消融对比
这项工作把图序列化从一个静态 prompt 细节提升为模型感知、任务感知的动态编排决策,对做 KG-grounded LLM 系统的团队而言,有直接的工程指导价值。
说到底这是序列化问题:把知识图谱/本体序列化成文本喂给 LLM,格式选择会带来几十个百分点的性能波动,所以值得做一轮消融对比实验。
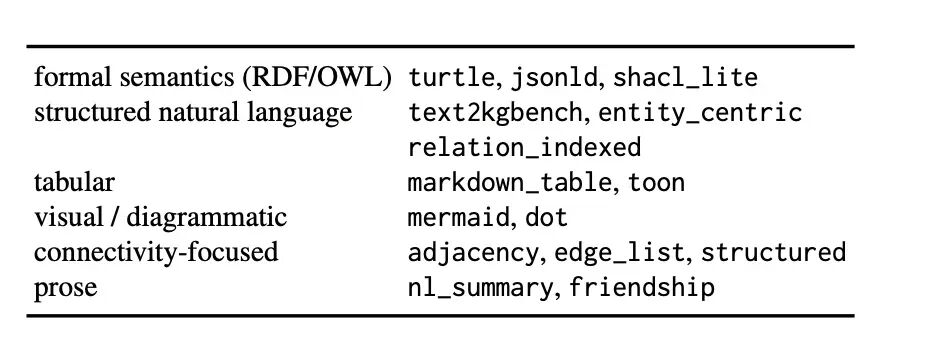
相关论文为《Graph Serializations for Reasoning LLMs: A Study Across Knowledge Extraction and Structural Reasoning》(https://arxiv.org/abs/2610.22734),可以快速看几个要点。
从实现方式上看,评测覆盖 15 种格式(Turtle、JSON-LD、SHACL 简化、Markdown 表、Mermaid、DOT、邻接表、边列表、自然语言摘要等 6 个家族)× 9 种前沿 LLM 配置(GPT-5.4 系列、o3、Claude Sonnet 4.6、Haiku、Grok 4 等),在两类任务上展开:基于本体的知识抽取(Text2KGBench,19 个 WebNLG 本体)与结构图推理(GraphQA 扩展)。
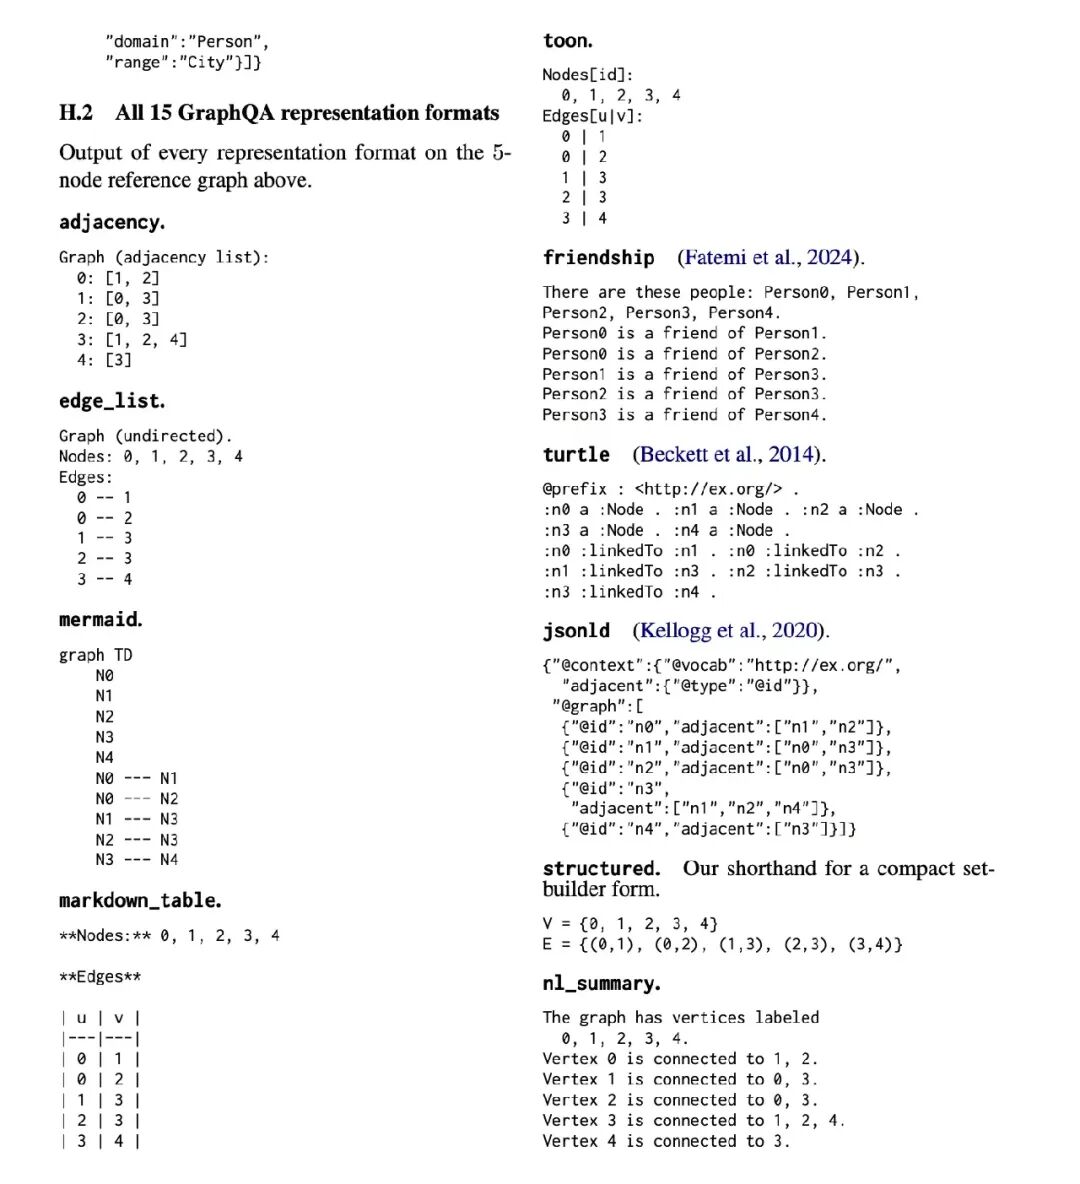
得到的结论相当清晰:知识抽取对格式相对不敏感——差异只有 1.3% 到 3.9%,收益主要来自模型自身能力;结构推理却对格式高度敏感,最难任务上的格式差异最高达 28.4%,而且推理能力越弱的模型越敏感。没有任何单一格式能在所有模型、所有任务上占优。论文据此提出了“自适应选择器”:逐查询动态选格式,比最优固定格式还有提升,但代价是计算资源消耗不小。
实际上这里有个更朴素的判断:最优格式高度依赖具体模型版本,结论会随着模型迭代快速失效。
二、本体验证引擎 open-ontologies 的一些思路
还是本体推理方向的进展,但这次锚定在可信阶段。项目地址:https://github.com/fabio-rovai/open-ontologies
先做个定位。它不是一个画本体的工具,也不是 reasoner 推理工具,而是一个验证本体和数据、让结论可被复核的工具。它管的是本体推理对不对、数据合不合规、推出来的结论可不可信。
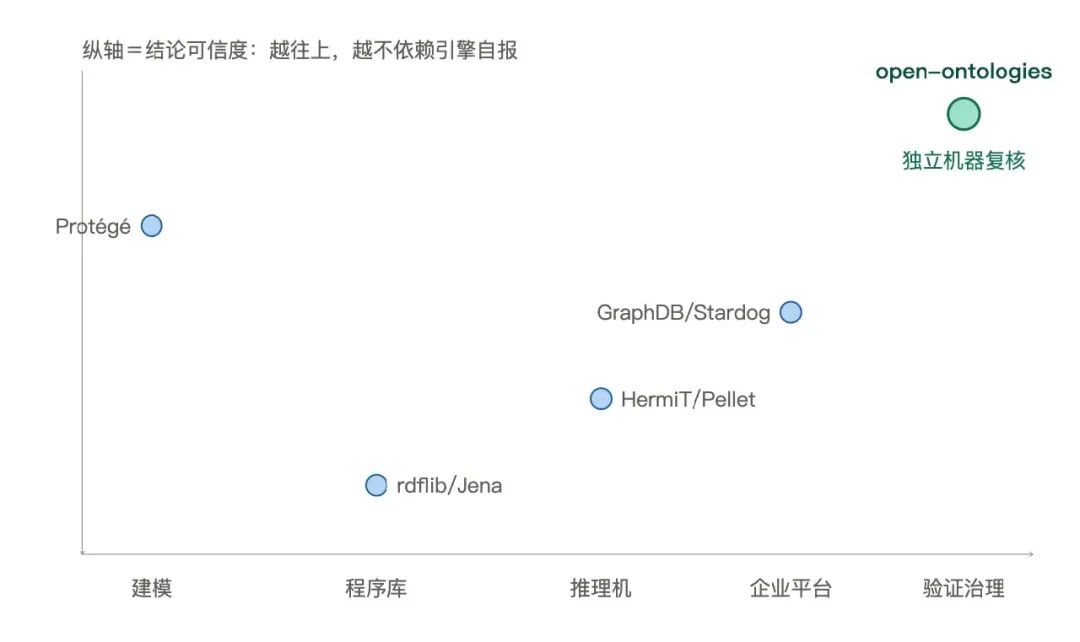
对应到本体工程,它是验证与治理层,不是建模器、不是推理机、不是图数据库。打个比方:Protégé 是画本体的 CAD,HermiT/Pellet 是算结论的计算器,GraphDB/Stardog 是存本体的仓库,那 open-ontologies 就是本体界的 CI 流水线,负责验证、治理,并把结论做成可被独立复核的产物。
与现有工具的区别,可以拆成几点来看。
其一,结论可信,靠的是谁判的,不是谁算的。
这是最根本的分界点。HermiT、Pellet、Stardog 这类推理机给出的结论,是引擎自己算出来的;信结论,等价于信这套引擎实现没有 bug。open-ontologies 把“算”和“判”拆开:Rust 引擎负责算,一个用 Lean 4 写的、健全性被机器证明过的检查器负责判。引擎算错了、证书被篡改了,检查器会直接拒绝。源码里有 10 个以上的独立检查器(oo-horn、oo-refute、oo-shacl、oo-lrat 等),全部 core Lean、无 Mathlib,把信任面压到最小。
其二,角色是治理层,不是建模、存储或推理。
其他工具各自占一个角色:Protégé 负责建模,rdflib/Jena 面向写代码的库,HermiT/Pellet 做推理,GraphDB/Stardog/TopBraid 是存储加推理加治理的整套平台。open-ontologies 只做验证+治理+举证这一层,而且采用 Terraform 风格的声明式生命周期(plan、apply、drift、enforce),把本体当作需要治理的资产,而不是画完就搁置的文件。它不替代任何建模工具,而是在已有建模和存储之上,补一道可验证、可追溯的治理层。
其三,信任面被显式列出来,而不是默认全信。
绝大多数工具不会告诉你它究竟信任了什么。open-ontologies 把它的信任计算基(TCB)枚举成 30 条可检查属性,逐条标明哪些已被形式化证明、哪些仍是有界模型检查、哪些还是假设。
1、为什么要单独验证?
涉及可信问题时,核心矛盾在于:推理结果被信任,是因为“引擎”被信任。
一个本体推理器(reasoner)的工作,是从“断言的三元组”(asserted graph)出发,用规则推导出“蕴含的三元组”(entailed triples)。问题在于:这些规则是人写的代码,人会写错。
可以看一个具体例子。2026 年 9 月 13 日,发现两条规则是不健全(unsound)的:cls-svf1 从某个类的“限制超类”反向推出成员关系——这正是那条公理的逆命题——还把对象位置上的类 IRI 当作该类的实例。这两条规则从“扩展 profile”写出之日起就存在,不是靠测试套件发现的,而是逐条追问“什么语义条件能让这条规则 sound”时,发现答不上来。
这个例子点出了本质:测试套件只能抓住“有人想到过的 bug”。真正缺的,是一个不依赖引擎开发者提前想到这个 bug 的检查机制。所以问题就变成了:如何让验证更加健壮。
2、具体怎么做?
open-ontologies 的核心主张是:对生产本体的每一次变更,都能在“不信任引擎、不信任作者、不信任生成本体的模型”的前提下,被任何人独立复核。也就是说,把“推理结果可信”这个问题,从“信任 reasoner 的作者”转译成“信任一个更小、可读、且被机器检查过的验证器”。
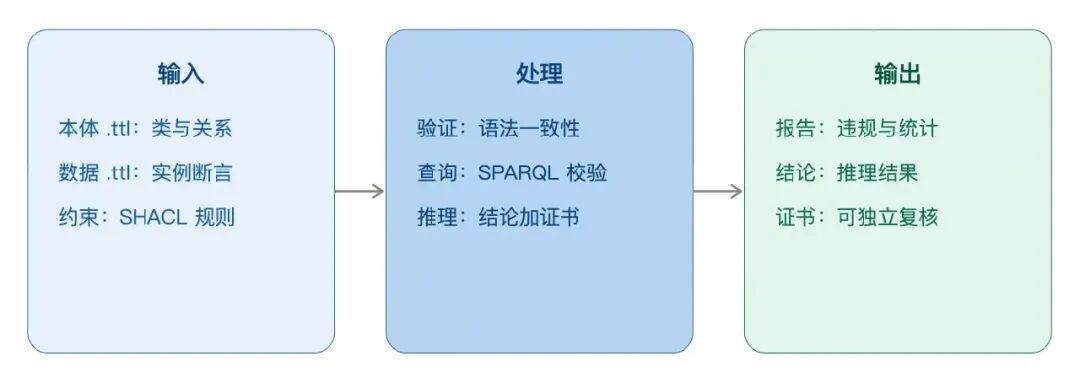
在实现上,当你写了一堆本体和数据,这个工具做三点判断:这本体逻辑对不对、这批数据合不合约束、推出来的结论凭什么让人信。对应到工具就是三件事:验证(查一致性)、治理(跑约束出违规清单)、举证(出可独立复核的证书)。然后是把算和判做成两个独立进程,中间用一份证书文件当接口,最后用 Rust 的类型系统保证 certified 这个词只能靠挣、不能靠写。
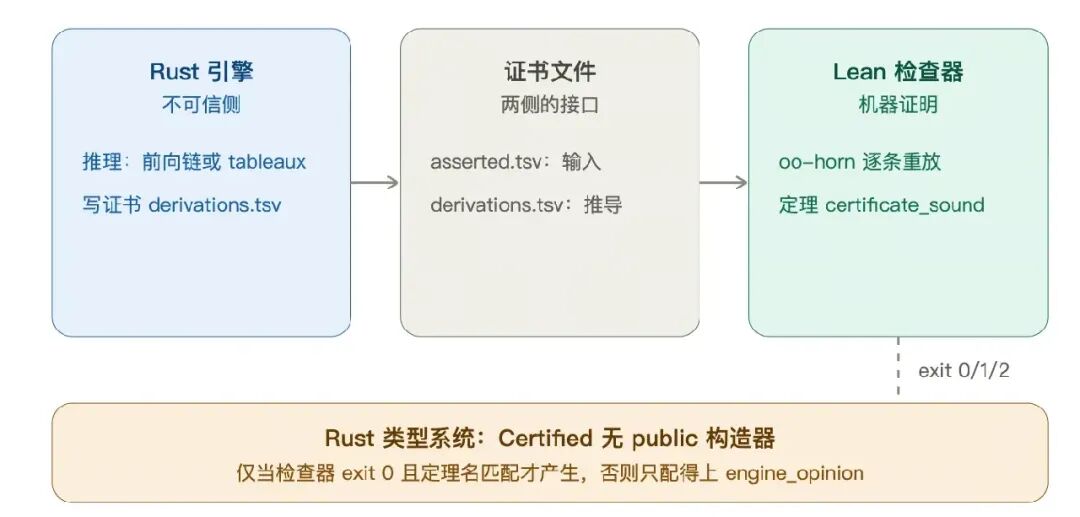
第 1 步:引擎算结论,顺带把怎么算的记下来(不可信侧)
本体(Turtle)先进 Oxigraph 三元组存储。reason --profile owl-dl --certificate DIR 启动推理:rdfs/owl-rl/owl-rl-ext 走前向链,owl-dl 走 SHIQ tableaux。关键不在算,而在算的同时把每一步推导写成证书:每推出一个三元组,就记录结论是什么、用了哪条规则、读了哪些前提。落到磁盘是两个文件:asserted.tsv(输入断言)和 derivations.tsv(推导,每行一步)。如果推理发现矛盾,还会多写一个 refutation.tsv。
第 2 步:证书文件当接口。
derivations.tsv 就是 Rust 侧和 Lean 侧之间的合同。Rust 只管写,Lean 只管读,两边不共享任何代码、不共享任何内存,只有这份文件在中间。
第 3 步:Lean 检查器逐条重放(可信侧)。
lake exe oo-horn check RAD 跑起来的是一个用 Lean 4 写的检查器,core Lean、无 Mathlib、几百行。它不重新推理,只逐条重放证书:验证每条记录的前提确实在断言集里、规则确实合法。它的健全性是一条机器证明过的定理 OOCert.certificate_sound。退出码是硬判词:0 全过、1 拒绝、2 输入不可读。这跟很多形式化验证项目的区别在于:检查器不搜索、只检查,因为找结论贵,验证结论便宜。
3、怎么用?
看两个常用场景。
场景 1:验 AI 生成的本体自不自洽。
输入:一个 LLM 生成的本体文件。
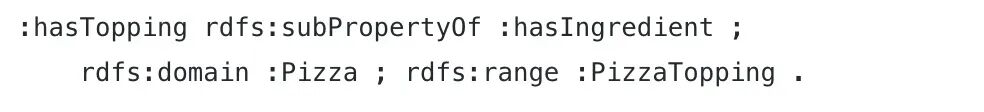
处理:validate(语法与 OWL 一致性)加 reason --profile owl-dl(推理,检查会不会推出矛盾)。
输出:consistent / inconsistent。一旦有矛盾,reason --certificate 还会额外吐出一份 refutation.tsv(反证证书),告诉矛盾具体卡在哪几条公理上。这是当前 LLM 生成本体场景最稀缺的能力:模型能产出海量本体,但没人知道哪些自相矛盾。
场景 2:数据治理与合规核验(最典型的用法)。
输入:本体加实例加约束,三样一起喂。仓库 investment-fund-ontology 案例里,约束 ifo-shapes.ttl 有一条很直白的规则:
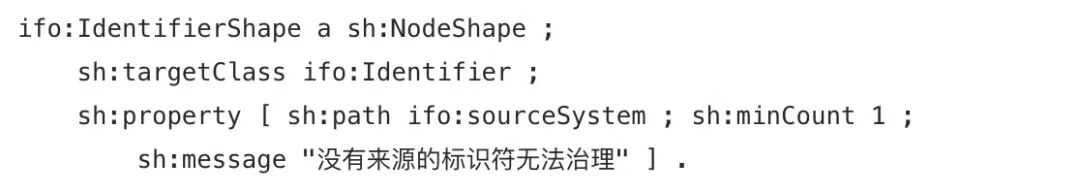
处理:shacl ifo-shapes.ttl。
输出:一份违规清单,每条带严重级别和原因。真实结果是 37 个 findings,其中有报价但无可解析交易场所这一类被形状自己标成 Warning 而非 Violation——因为它是需要拍板的治理缺口,不是记录本身错了。注意这个细微处:约束里怎么写,输出就怎么判,工具不替人下结论。
可信验证与图序列化这两个方向,后续还有不少可以深挖的地方。相关讨论可以到云栈社区继续交流。
 发表于 2 小时前
|
查看: 12|
回复: 0


