大模型会说话,早已不算稀奇。真正稀奇的是——当它开始“动手”之后,麻烦才刚刚开始。
ChatGPT 刚出现的那两年,我们跟大模型(LLM)打交道的方式,基本就是守在网页对话框里打字。彼时的 LLM 像一个被关在密室里的聪明大脑:知识储备扎实,既会写文案也会写代码,称得上“才华横溢”。
可一旦让它查“今天南京下不下雨”、查数据库里订单 1024 有没有发货,或者真的把那封邮件发出去,它就开始一本正经地胡说八道。原因很简单:它没有眼睛,也没有手。
LLM(大语言模型)本质上仍是一台根据上下文预测下一个 Token 的机器。让它算 1000 × 729,它不是在脑内掏出计算器,而是在用语言直觉“猜”答案;让它执行一段 Python,代码可以写得花枝招展,但它并不会真的去点下运行按钮。
而 Agent(智能体),就是给这个大脑装上感官、四肢、工具箱,以及一套自主行动的“循环神经系统”。
Agent 的灵魂,其实是一个 while 循环
Agent 这个词并不是大模型时代的发明。早在 1950 年代,图灵在思考机器智能时就已经埋下种子;1980 年代,马文·明斯基在《心智社会》(Society of Mind)中提出,智能是由许多微小、无意识的 Agent 协作涌现出来的;到 1995 年,Stuart Russell 和 Peter Norvig 在经典教材《人工智能:一种现代方法》中给出了标准定义:Agent 是任何能够通过传感器感知环境,并通过执行器作用于环境的事物。
但在大模型爆发之前,传统 Agent(如强化学习系统、基于规则的专家系统)普遍缺乏通用常识与泛化推理能力。下围棋的 AlphaGo 没法帮你订机票,扫地机器人也写不了代码,规则一多还容易互相打架。直到大模型出现,机器终于能听懂人类那些不那么规整的需求,这个老架构才算真正翻身。
本文不讲高深理论,只从底层代码工程视角来看:Agent 并不是某种神秘的新型神经网络,而是一套以大模型为推理引擎、通过“感知-思考-行动-观察”构成的自主控制循环(Autonomous Control Loop)。
如果把各种框架、模型 SDK、参数校验和错误处理都删掉,一个最小化的 Agent 核心大概长这样:
loop {
    let reply = llm.chat(memory, tools).await?;
    memory.push(reply.clone());

    if let Some(calls) = reply.tool_calls {
        for call in calls {
            let result = tools.execute(call).await;
            memory.push(tool_message(call.id, result));
        }
    } else {
        return reply.content;
    }
}
没错,核心就是一个循环。
ReAct 与 Function Calling
代码层面看,这件事没有想象中玄乎。核心就三步:模型做决定,程序执行工具,执行结果再塞回上下文。真正关键的问题是——怎么让模型在不知道答案时别硬编,而是自己主动去调用合适的工具,查完再回来告诉你结果。
2022 年 10 月,普林斯顿大学和 Google 联合发表了论文《ReAct: Synergizing Reasoning and Acting in Language Models》。这篇论文做的事情,说白了就是把“推理”和“行动”拧到了一起。此前模型要么只会思考,要么直接行动,几乎没有中间态。ReAct 的想法很简单:让模型想一步,做一步;做完之后看结果,再决定下一步。
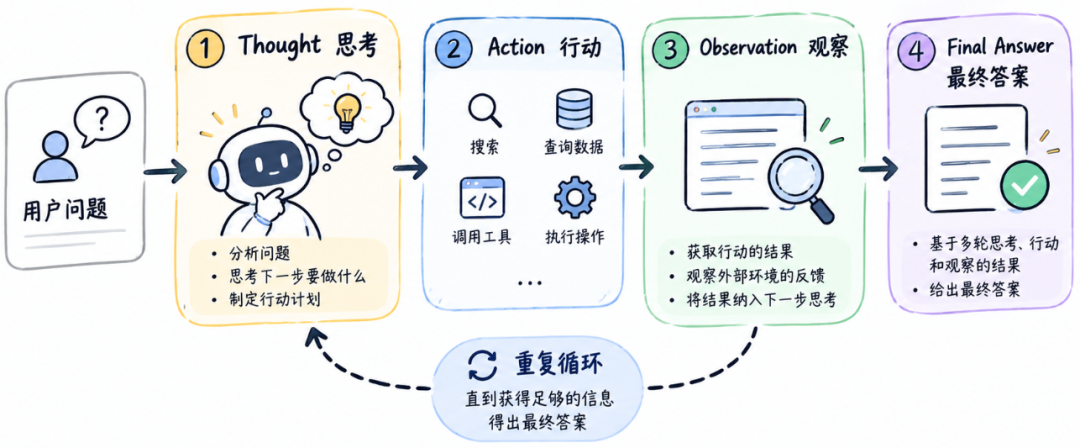
它的基本循环是这样的:Thought(思考)→ Action(行动)→ Observation(观察结果)→ Thought(根据结果重新思考)→ 继续行动,或给出最终答案。看起来确实有点像人类办事。
Thought(思考):模型先感知用户需求,并自行决定要不要调用工具、调用哪个工具。比如它会想:“用户问北京现在几度,我并不知道,但手里有个查天气的函数,应该先调用它。”
Action(行动):模型不再直接回答用户,而是按照约定格式输出一条指令:
{
  "tool": "get_weather",
  "arguments": {
    "city": "Beijing"
  }
}
注意:模型只是提出了调用请求,这就是 Function Calling。真正去请求天气 API 的,是外部宿主程序,也就是开发者写的那部分后端代码。Function Calling 的出现,让 LLM 从一个“只能聊天的离线大脑”,进化为“拥有双手、能使用工具的智能体”。
另外在早期的提示词工程里,我们通常要写上一句:“请只输出合法的 JSON,不要输出任何多余的解释”。但模型偶尔还是会多吐一句“好的,这是你要的 JSON:”,导致后端的 json.parse() 直接崩溃报错。
从 2023 年中开始,OpenAI 等厂商把这件事纳入模型协议和训练:针对函数调用模式做专门微调和约束解码。开发者不再只丢给模型一段自然语言指令,而是把工具的名字、用途、参数和类型用 JSON Schema 描述清楚。这样一来,模型能生成严格符合预定义 Schema(参数格式)的 JSON,大模型也得以无缝嵌入到现有的工业级代码与企业系统架构中。
Observation(观察):外部宿主程序拦截到这条指令,真正去请求气象局 API,拿到结果 "22°C, 晴",再把这个结果作为系统消息塞回给大模型。
为什么一定要有 Observation?因为现实世界不会按照模型的想象运行。模型可能判断应该查天气,但工具也可能报错:城市名不认识、接口超时、服务暂时不可用,甚至北京当天根本没有返回完整数据。如果没有 Observation,它可能说“我已经查到天气了”,可实际上后端请求压根没发出去。有了 Observation,模型才会知道外部世界的真实反馈。查到了就继续回答;查不到就换参数重试,或者老老实实告诉用户暂时无法获取。
Loop(循环):大模型看到 Observation 后,再次进入 Thought:“我已经拿到答案了,现在可以组织语言回答用户了。”
但这里也埋着一个坑:循环不是越长越好。查天气最多走一两步,问题不大;一旦任务变复杂,每一轮都可能出错。模型可能反复调用同一个工具,也可能忘记前面已经做过什么,甚至在工具失败后一本正经地宣布任务完成。所以一般还需要设置最大轮数、错误处理、参数校验、权限控制和人工确认。
规划和任务分解
ReAct 可以把 Agent 的基本动作串起来:模型先判断当前情况,再调用工具,拿到工具返回的结果,然后根据结果决定下一步。这个循环特别适合处理短任务——查天气、搜一个网页、算一笔账,基本都是几步之内结束。模型看一眼目标,选一个工具,拿到结果,回给用户。
但是任务一旦变长,问题就出来了。你让它“把贪吃蛇写出来”,它可能先创建文件;你让它“打包发布”,它还得理解项目结构、安装依赖、运行测试、处理构建错误、确认产物位置,最后再考虑发布环境。这不是一个动作,而是一条很长的链。
如果 Agent 每次只盯着眼前这一小步,就很容易出现一种局部看似合理、整体却越来越离谱的状态。这就是 ReAct 常见的短视问题,也可以理解成一种局部贪心:眼前哪个动作最方便,就先做哪个;眼前哪个错误最刺眼,就先修哪个。我们往往会发现,每一步都没有明显犯错,但走着走着,就把自己送进了死胡同。
所以 agent 需要提前 Planning(规划)。就像我们程序员遇到复杂任务时,通常不会一上来就敲第一行代码,至少会在脑子里过一遍:先做什么、后做什么、哪里最容易出问题、最后怎么确认它真的完成了。Planning 就是把这个过程显式化。
比如 Agent 接到“写一个贪吃蛇并发布”的任务后,不是直接进入工具调用,而是先把目标拆开:
- 确认运行环境与发布方式
- 创建项目骨架
- 实现游戏画面与基础逻辑
- 加入键盘控制、计分和结束条件
- 运行测试并修复错误
- 构建生产版本
- 检查构建产物
- 发布并验证线上页面
这样一来,大模型就有了干活的地图,一步步完成即可。这也正是任务分解(Task Decomposition)的价值:将复杂的大目标拆成多个可检查的子目标,模型每次处理的范围变小,整体方向也不容易丢。
Memory
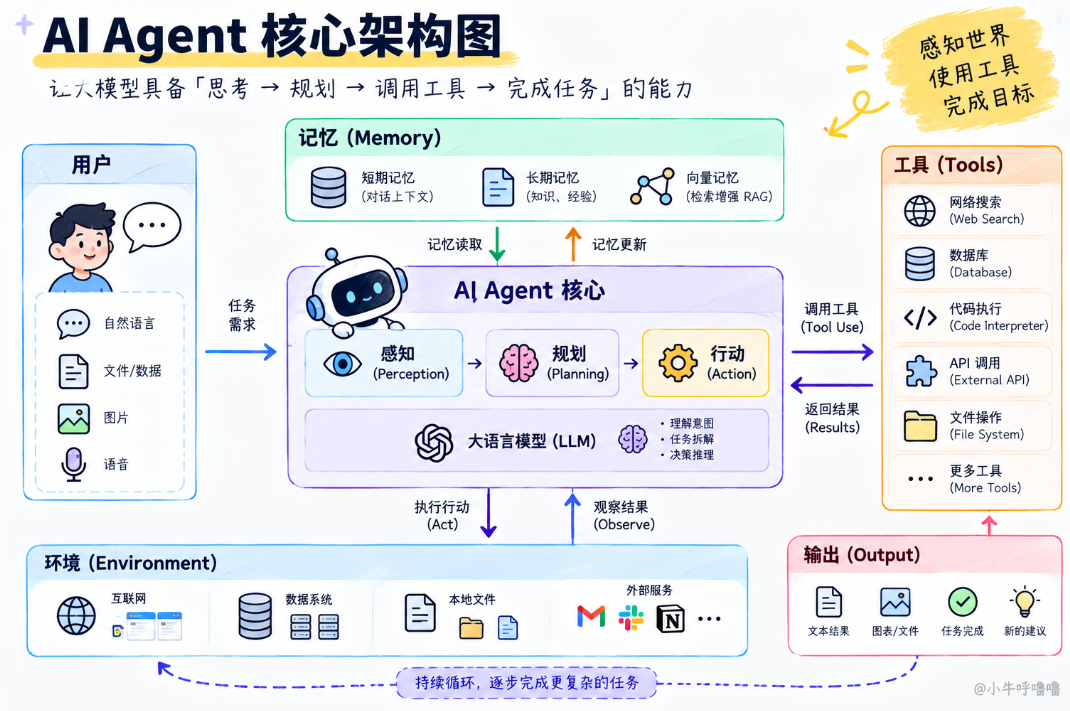
如果上一轮用户说了什么、模型做了什么、工具回了什么,下一轮 Agent 全忘了,那自然也不行。所以我们还需要给 Agent 添加记忆的能力。
然而 LLM 本身其实是无状态的。它所谓的“记得”,不是真的把故事存进了脑子,而是有人把聊天记录又递给了它。因此我们需要建立一个记忆系统,通常分两层:短期记忆和长期记忆。模型在当前对话里能不能看到信息,和它几天后换个任务时还能不能找回信息,完全是两回事。
Agent 当前这一轮能看到的对话、系统指令、工具返回结果,基本都属于 Working Memory,也就是短期记忆或工作记忆。你可以把它理解成模型面前摊开的那张桌子:用户刚说了什么、工具刚返回了什么、模型正在执行第几步,都暂时放在这张桌子上。在技术上,这张桌子通常就是 Context Window(上下文窗口),也包括动态拼进 Prompt 的各种信息,以及 ReAct 循环里不断出现的 Thought、Action 和 Observation。
它的优点是快,但上下文窗口是有限的。你让 Agent 连续执行十几步任务,每一步都把完整历史塞回上下文,很容易撑爆上下文,token 费用也跟着往上窜。
长期记忆是持久化存储的外部知识库,通常通过外挂数据库、向量检索引擎或图数据库实现。完整的历史记录、原始日志和大批量领域材料都可以放进去,容量大、成本低,但每次检索需要更多时间。
记忆系统不是几个数据库表拼在一起就完成了。更重要的是:一段新信息,什么时候被提取,什么时候被压缩,什么时候被找回来,什么时候应该被遗忘。整理下来大致是:先写进去,再提炼出重点;再通过反思,把碎片压成规律;到需要的时候,再把记忆唤醒。
所以一个现代化的 AI Agent 核心架构大致如下图所示:
最后那道坎:权限
Agent 一旦能读文件、查数据库、发邮件、下单甚至删除数据,它出错的代价就不再是一句答错的话。恶意网页还可能藏着 Prompt Injection(提示词注入):网页内容试图诱导 Agent 忽略原有要求,转而泄露信息或调用危险工具。模型读到这段话,不代表它就该照做;外部内容必须被当作不可信输入来处理。
高风险操作要有权限边界,发邮件、付款、删数据这类动作,至少应该考虑人工确认;运行代码要限制可访问的文件和网络;工具只拿完成任务所需的最低权限。
现在流行把 Agent 放进沙盒,但沙盒不是万能护身符,配置错了照样挡不住风险。
说到底,Agent 的本事来自“能行动”,它的风险也来自“能行动”。如果你也在折腾 Agent 开发,欢迎来云栈社区一起交流踩坑经验。
 发表于 昨天 23:16
|
查看: 3|
回复: 0


