
Graphify 简介
Graphify 是一个面向 Claude Code 的技能插件,能够读取指定目录下的代码、PDF、Markdown、截图等多种格式文件,自动提取其中的概念与关系,构建出结构化的知识图谱。它解决了开发者在面对大量异构资料时难以快速理解全局关联的问题,通过图结构替代原始文件阅读,大幅降低 AI 查询时的 Token 消耗。
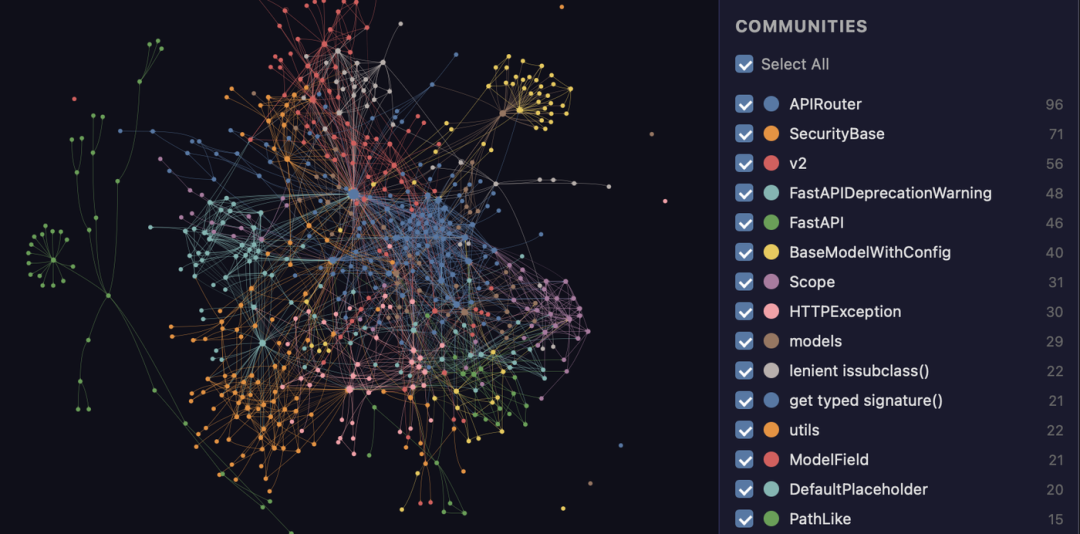
它支持交互式可视化、Obsidian 笔记库导出以及 Wiki 风格文章生成,所有处理均在本地完成,无需依赖外部图数据库。无论是梳理复杂代码库、整理研究论文,还是聚合碎片化笔记,Graphify 都能帮助用户发现隐藏的结构和意想不到的联系。
亮点特性
01 全模态输入支持
结合 tree-sitter 解析代码 AST,并利用 Claude 视觉能力从 PDF、截图、甚至其他语言的图片中提取概念与关系。
02 极致的 Token 压缩率
在包含 52 个文件的混合语料库测试中,相比直接读取原始文件,每次查询可减少 71.5 倍的 Token 消耗。
03 关系透明度
图谱中的每一条边都被明确标记为 EXTRACTED(提取)、INFERRED(推断)或 AMBIGUOUS(模糊),让用户清楚区分事实与猜测。
04 丰富的输出生态
一键生成交互式 HTML 图谱、Obsidian 兼容库、Wiki 文章、JSON 持久化数据,并支持导出至 Gephi 或 Neo4j。
05 自动化同步机制
提供 --watch 后台监听模式和 Git post-commit 钩子,代码保存或提交后自动触发图谱增量更新。
使用场景
场景 1:大型代码库架构梳理
将多语言混合的代码仓库转化为调用图和概念图,帮助新成员或 AI Agent 快速理解模块间的依赖关系与核心节点。
场景 2:跨模态研究资料聚合
将 PDF 论文、技术博客截图、白板照片和 Markdown 笔记放入同一文件夹,自动提取引用关系和核心概念,形成统一的研究知识网络。
场景 3:AI Agent 知识库构建
通过 --wiki 参数生成维基百科式的 Markdown 文章,让其他 AI Agent 能够通过读取文件直接导航和检索知识,而无需解析复杂的 JSON 数据。
使用环境
快速上手
环境要求
安装步骤
# 注意:PyPI 包名目前为 graphifyy
pip install graphifyy && graphify install
注:macOS 若遇环境变量管理报错,或 Windows 下命令未识别,建议使用 pipx install graphifyy。
基本用法
在任意目录下打开 Claude Code,输入以下命令即可开始构建图谱:
# 对当前目录进行图谱化
/graphify .

# 对特定文件夹进行深度提取(挖掘更多推断关系)
/graphify ./raw --mode deep

# 仅更新发生变化的文件并合并到现有图谱
/graphify ./raw --update
高级功能示例
# 添加在线论文或推文到图谱
/graphify add https://arxiv.org/abs/1706.03762

# 基于图谱进行自然语言查询
/graphify query "what connects attention to the optimizer?"

# 查找两个概念之间的路径
/graphify path "DigestAuth" "Response"

# 开启监听模式,文件变化时自动同步图谱
/graphify ./raw --watch

# 导出为 Neo4j Cypher 语句或 GraphML 格式
/graphify ./raw --neo4j
/graphify ./raw --graphml
替代方案
对比 1:Obsidian + 手动双向链接
Obsidian 擅长 Markdown 笔记的网状组织,但需要人工建立链接;Graphify 则能全自动从代码和图片中提取关系并直接导出为 Obsidian Vault。
对比 2:Neo4j / 传统图数据库
Neo4j 适合企业级大规模图数据存储与复杂查询,但部署和维护成本高;Graphify 完全本地运行,开箱即用,且可通过 --neo4j 参数无缝导出数据。
相关资源
- 项目地址:github.com/Graphify-Labs/graphify
- 文档:raw.githubusercontent.com/safishamsi/graphify/v1/skills/graphify/skill.md
 发表于 半小时前
|
查看: 10|
回复: 0


