早些年大模型刚出来的时候,LLM 本身只具备「输入 → 输出」这种单向流程,还没有办法像人一样多步骤、有策略地完成任务。Agent 工程化的目的,正是让原本的 LLM 具备像人一样的综合问题解决能力。
ReAct(Reasoning + Acting)
传统 LLM 调用是:你问 → 它答,而在 ReAct(Reasoning + Acting) 推理范式的设想中,LLM 的问答会变成下面这样的流程:
Thought(思考)→ Action(调用工具)→ Observation(观察结果)
→ Thought → Action → ... → Answer
举一个具体的例子:
- Thought: 我需要知道北京今天的天气
- Action: 调用天气 API,参数 city=北京
- Observation: 晴,25°C,微风
- Thought: 温度舒适,我可以给出建议
- Answer: 建议穿薄长袖或 T 恤……
在这个案例里,有几个重点步骤:
- “Reasoning”让它显式写出推理过程(Chain-of-Thought 的延伸)
- “Acting”让它能调用外部工具(搜索、计算器、数据库、代码执行)
- 通过 Observation 把真实世界的结果反馈回模型,纠正幻觉
在真实场景的 AI 工程实践中,这是最基础、也最常被使用的 Agent 范式。LangChain、LlamaIndex 里的 AgentExecutor,本质上就是在跑 ReAct 循环。它特别适合步骤数不确定、需要边执行边观察的任务。
基于 LangChain4j 实现 ReAct 范式
在大多数实际应用场景里,基于 ReAct 推理范式的 Agent 工程是最常见的。比如下面这段代码:
// 一个简单的工具,供 Agent 调用
public class WeatherTool {
    @Tool("查询指定城市的天气")
    public String getWeather(@P("城市名") String city) {
        return city + ":晴,25°C,微风";
    }
}

// 模型(以 OpenAI 为例,也可换 Ollama、Qwen 等)
ChatLanguageModel model = OpenAiChatModel.builder()
        .apiKey(System.getenv("OPENAI_API_KEY"))
        .modelName("gpt-4o-mini")
        .build();

// 定义一个助手
interface Assistant {
    String chat(String userMessage);
}

// 助手实现类,注入工具、模型以及对话上下文
Assistant assistant = AiServices.builder(Assistant.class)
        .chatLanguageModel(model)
        .tools(new WeatherTool())          // 注册工具
        .chatMemory(MessageWindowChatMemory.withMaxMessages(20))
        .build();

String answer = assistant.chat("北京今天适合穿什么?");
System.out.println(answer);
上面这段代码是我用 LangChain4j 实现的一个基于天气查询的 Agent。这里你会发现,LangChain4j 官方 1.8.0 版本提供的这套写法,其实和早期 LangChain4j 的写法相比已经有了非常大的变化。
这套实现最方便的地方在于:只要把工具交给 AiService,它内部就会自动跑 ReAct 循环(Thought → Tool Call → Observation → … → Answer)。
它背后做的事(等价于手写 ReAct):
- 把工具描述塞进 prompt
- 模型返回“我要调用 getWeather(北京)”
- 框架执行工具,把结果作为 Observation 再喂回模型
- 循环直到模型给出最终答案
不过可能有人会问:循环逻辑怎么控制边界?是否可以手动控制 ReAct 的循环过程?LangChain4j 其实从最初出现在市面上时就提供了这方面的能力。来看下面这段代码:
String prompt = """
        你可以使用工具。按以下格式回答:
        Thought: 你的思考
        Action: 工具名[参数]
        Observation: 工具返回
        ...(循环)
        Final Answer: 最终答案

        可用工具:getWeather(city)
        问题:%s
        """.formatted(question);

while (true) {
    String output = model.generate(prompt);
    if (output.contains("Final Answer:")) return output;
    // 解析 Action,执行工具,拼接 Observation 回 prompt
    String observation = executeTool(output);
    prompt += "\n" + output + "\nObservation: " + observation;
}
上述代码片段中,就是通过每次调用工具后判断返回结果是否符合预期,从而控制循环的边界逻辑。
到这里,你已经入门了如何基于 LangChain4j 这类框架实现一个简单的 ReAct 范式 Agent。接下来我们引入更多实际落地过程中会遇到的问题点。
成本与权限控制
在 LangChain4j 的 ReAct 实现里,框架帮你处理了「循环调用工具」的基本骨架,但生产环境下的稳定性、成本与答案质量,取决于你如何设计工具、约束循环、处理异常以及管理上下文。下面从工程落地角度,挖几个真正实用的技巧。
工具最大调用次数
在 LangChain4j 中,maxSequentialToolsInvocations 用于限制单次 LLM 请求中可连续调用工具的最大次数,防止模型陷入无限循环调用或过度依赖工具的情况。这一参数在涉及多轮工具调用(比如先调用搜索工具,再调用数据处理工具)时尤为重要。
Assistant assistant = AiServices.builder(Assistant.class)
        .chatLanguageModel(model)
        .tools(new YourTool())
        .maxSequentialToolsInvocations(8)  // 最大上限
        .build();
最大耗时控制
底层 ChatLanguageModel 必须设置超时。网络抖动或模型服务响应慢,会拖垮整个 Agent 流程。构建模型时应当显式传入 timeout 参数:
OpenAiChatModel model = OpenAiChatModel.builder()
        .apiKey(...)
        // 单次 LLM 对话的超时时间限制
        .timeout(Duration.ofSeconds(30))
        .build();
除了控制模型对话本身的耗时,在实际企业级应用中,可能还要考虑调用 LLM 服务的完整链路。比如我曾经就遇到过这样一个流程:
用户请求 -> 系统集群的统一出口 CLB -> 内部 Nginx -> 应用服务 -> LLM 厂商接口
当时业务上线后,遇到一些长耗时任务就会表现为下游对话中断。后来调整了 LLM 的对话超时参数,还是不见效。于是向上游排查,才发现是统一对外 CLB 针对单个 HTTP 请求的 timeout 设置成了 60s。最后调整了统一对外 CLB 的 timeout 时间,链路才恢复正常。
可能有人会感觉:timeout 这个参数随便拍个数值不就行了,真有这么重要吗?
结合我过往的经历,建议还是结合实际业务场景去设置。比如你的 Agent 是做报表绘制和数据查询类业务的,一般这类场景的耗时最多 15 分钟内就结束了。但有些 Agent 要做视频渲染、剪辑、导出这类工作,可能会花费 1 到 3 小时不等。一旦因为 timeout 中断,就很可能导致用户投诉甚至流失客户。所以在设置 timeout 参数时,请三思。
控制 Token 消耗
在 LangChain4j 的 ReAct 循环中,Token 消耗的计算分为两种场景:事后获取实际消耗(用于计费或监控),以及事前预估(用于控制上下文窗口)。
事后统计
每次 LLM 调用完成后,LangChain4j 的 Response 或 ChatResponse 对象中都会携带一个 TokenUsage 实例。这是最准确的数据,因为它是模型服务商(如 OpenAI)在响应中直接返回的官方统计。
TokenUsage 类提供了三个核心方法:
inputTokenCount():输入 Token 数(你的 prompt + 历史消息 + 工具描述等)outputTokenCount():输出 Token 数(模型生成的回复)totalTokenCount():总消耗
在 ReAct 循环中,由于工具调用会触发多次 LLM 调用,你需要把每一次调用的 TokenUsage 累加起来。TokenUsage 类自带 add() 方法,可以方便地合并两次调用的统计。
事前预估
在 LangChain4j 内部有一个类叫做 dev.langchain4j.model.openai.OpenAiTokenCountEstimator,如下图代码截图所示:
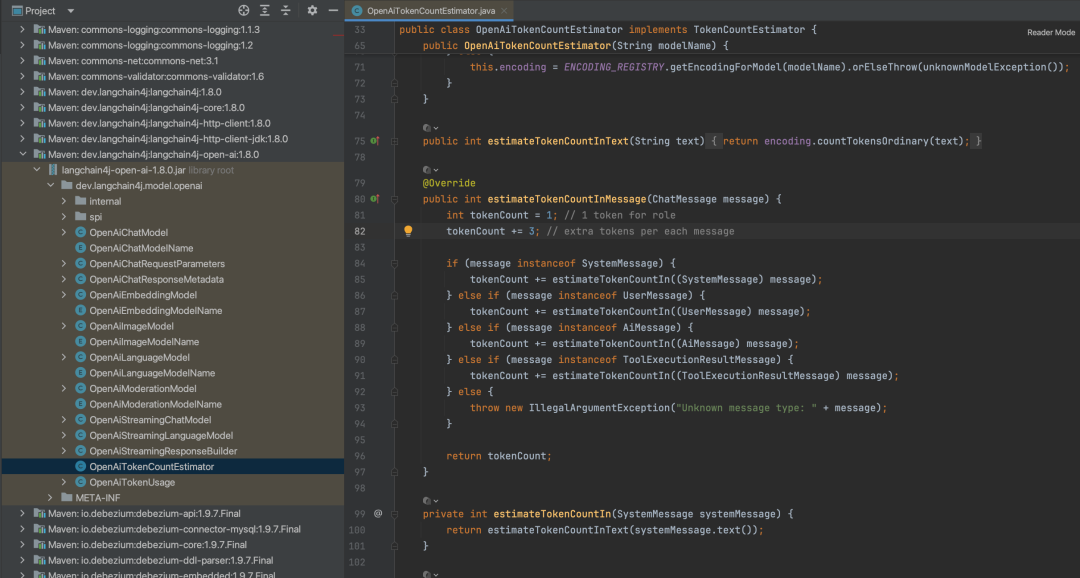
OpenAiTokenCountEstimator 底层调用的是 JTokkit 库,它实现了 OpenAI 的 BPE(Byte Pair Encoding)分词逻辑。它会根据你指定的模型名称,选用对应的编码表(例如 GPT-4 系列用 O200K_BASE),把文本真正“切”成 token 序列后再计数。下面截图的源代码就是对这一点的印证:
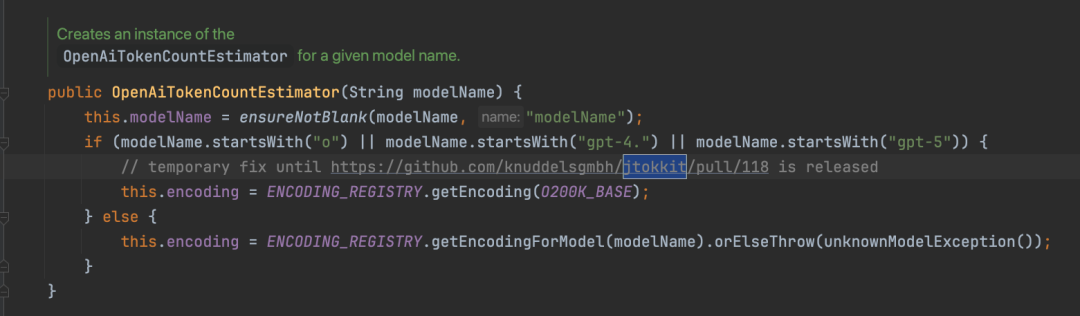
JTokkit 实现的是 OpenAI 的字节级 BPE(Byte-level BPE)算法,它把任何文本(无论中英文数字)都先转换为 UTF-8 字节序列,然后基于预训练的合并规则进行切分。
因此,中文汉字、英文单词、数字在它眼里没有本质区别——都是字节流。它们最终被切成几个 token,完全取决于该 token 在训练语料中的出现频率和合并规则,而不是代码里写了「汉字按 X 处理、数字按 Y 处理」。它的使用方式也很简单,如下:
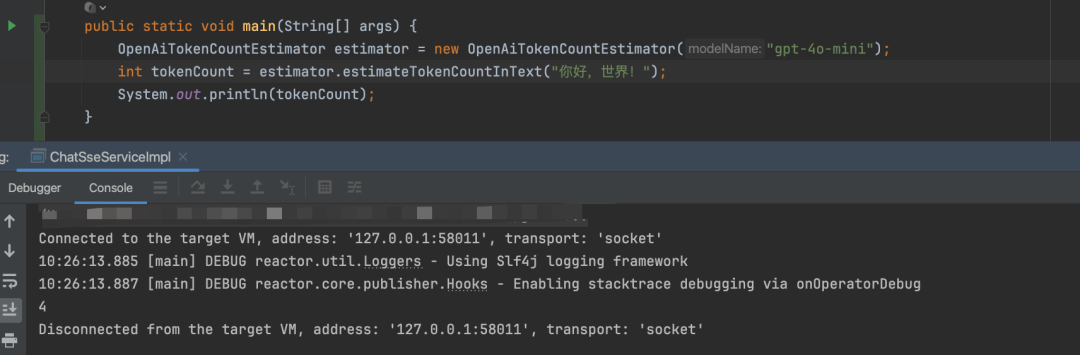
import dev.langchain4j.model.openai.OpenAiTokenCountEstimator;

public static void main(String[] args) {
    OpenAiTokenCountEstimator estimator = new OpenAiTokenCountEstimator("gpt-4o-mini");
    int tokenCount = estimator.estimateTokenCountInText("你好,世界!");
    System.out.println(tokenCount);
}
看到这里,你可能会疑惑:我知道如何直接使用这个 API 了,但在实际应用场景中,大多都是定义一个 Assistant 类去访问 LLM,那怎么在这个访问过程中控制 Token 消耗呢?这里就需要引出我们接下来要讲的上下文工具了。
对话上下文中控制 Token 上限
通过 AiServices.builder() 定义 Assistant 时,OpenAiTokenCountEstimator 本身并不会被自动“注入”到 LLM 调用流程里。它的典型用武之地是配合 TokenWindowChatMemory,让 Assistant 在管理对话记忆时,用这个预估器来精确控制上下文的 Token 预算。
所以实际使用 Token 限制器需要注入进我们的 Assistant 对象内部,例如下面这段代码:
@Bean
@ConditionalOnBean({StreamingChatModel.class, IAgentToolsService.class, SkillLoader.class, IAgentConfigService.class})
public IGreenNoteAssistant greenNoteAssistant(StreamingChatModel streamingChatModel,
                                              IAgentToolsService agentToolsService,
                                              SkillLoader skillLoader) {
    return AiServices.builder(IGreenNoteAssistant.class)
            .streamingChatModel(streamingChatModel)
            .maxSequentialToolsInvocations(3)
            .chatMemoryProvider(memoryId -> TokenWindowChatMemory.builder()
                    .maxTokens(100 * 10000, new CustomTokenCountEstimator())
                    .build())
            .tools(agentToolsService)
            .systemMessageProvider(memoryId -> {
                return agentProperties.getDefaultSystemPrompt() + BASE_CONTENT + skillLoader.getSkillBody();
            })
            .build();
}
LangChain4j 的对话上下文管理,核心是 ChatMemory 抽象。它解决一个根本问题:LLM 本身是无状态的,必须由外部把历史消息带在每次请求里。ChatMemory 就是这个「历史消息容器」,并附加了淘汰策略、多会话隔离和持久化能力。
对话上下文内部设计
ChatMemory 是对话历史的容器,主要职责是存储和检索 ChatMessage 列表。它有两个开箱即用的实现,区别在于按什么维度淘汰旧消息。
MessageWindowChatMemory
滑动窗口按消息条数保留。比如设 maxMessages(10),就只保留最近 10 条,更早的被淘汰。实现简单,但每条消息的 Token 数差异巨大,一条长工具结果可能就占满整个窗口,所以官方定位是「快速原型用」。
TokenWindowChatMemory
滑动窗口按 Token 数保留。它需要一个 TokenCountEstimator 来估算每条消息的 Token 数,超出预算就淘汰最旧的。这正是你之前用 OpenAiTokenCountEstimator 配合的那个组件。消息是不可分割的,如果一条消息放不进窗口,整条被淘汰,不会截断。
两者对 SystemMessage 都有特殊保护:一旦加入,始终保留,不会被淘汰。一般来说,在建设 Agent 的时候,我们都是将用户 ID 粒度作为对话记忆的区分粒度,实现起来和下面这段代码相似:
.chatMemoryProvider(memoryId ->
    TokenWindowChatMemory.withMaxTokens(4000, estimator))
海量对话记录存储
这里我会结合自己过往的工作经验,分享一下我曾经负责的 Agent 基座平台的一些设计思路。一般大型企业内部都会有一套自建的 Agent 基座平台,这类平台会覆盖整个业务线、甚至集团内部 Agent 的部署和使用。这也就意味着,平台上可能存在来自不同团队的成百上千个 Agent 智能体。
面对数以百/千计的 Agent 智能体,每个智能体的对话记录都需要考虑消息存储问题。这种情况下,我过往采用的是 MySQL + 分表的策略进行持久化,同时按照日期(30/60/90 天)冷备到离线环境进行归档。
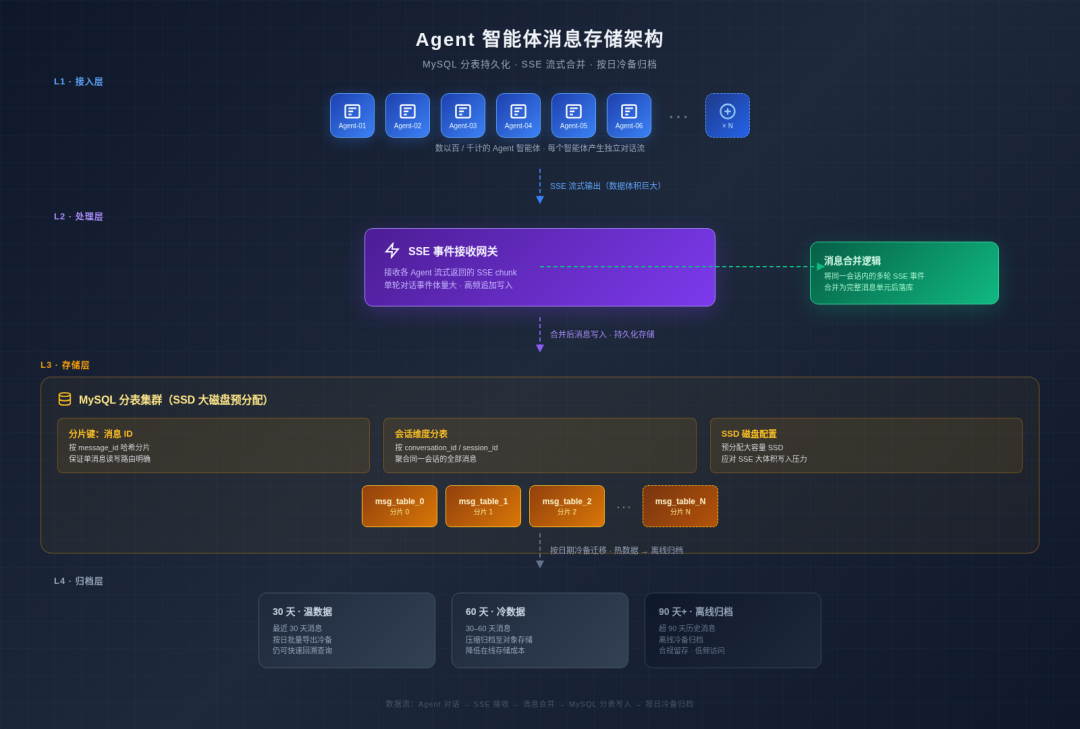
对话记录表 SQL:
CREATE TABLE `t_agent_chat_record_{0..127}` (
  `id`          bigint unsigned NOT NULL AUTO_INCREMENT,
  `chat_id`     bigint unsigned NOT NULL COMMENT '消息ID(雪花,全局唯一)',
  `relation_id` bigint unsigned NOT NULL COMMENT '会话ID(分片键)',
  `agent_id`    bigint unsigned NOT NULL DEFAULT '0' COMMENT 'agent标识/区分不同agent智能体',
  `user_id`     bigint unsigned NOT NULL DEFAULT '0' COMMENT '用户id',
  `role`        tinyint unsigned NOT NULL DEFAULT '0' COMMENT '1system 2user 3assistant 4tool',
  `type`        tinyint unsigned NOT NULL DEFAULT '0' COMMENT '内容类型',
  `content_text` text NOT NULL DEFAULT '' COMMENT '回复的纯文本内容',
  `content_full` varchar(256) NOT NULL DEFAULT '' COMMENT '完整内容的地址指针',
  `seq_no`      int unsigned NOT NULL DEFAULT '0' COMMENT '会话内序号',
  `token_count` int unsigned NOT NULL DEFAULT '0',
  `status`      tinyint unsigned NOT NULL DEFAULT '0' COMMENT '0生成中1成功2失败3中断',
  `finish_reason` varchar(32) NOT NULL DEFAULT '',
  `parent_id`   bigint unsigned NOT NULL DEFAULT '0' COMMENT '重生成父消息',
  `is_deleted`  tinyint(1) NOT NULL DEFAULT '0',
  `deleted_at`  datetime DEFAULT NULL,
  `create_time` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP,
  `update_time` datetime DEFAULT NULL ON UPDATE CURRENT_TIMESTAMP,
  PRIMARY KEY (`id`, `create_time`),
  UNIQUE KEY `uk_chat_id` (`chat_id`, `create_time`),
  KEY `idx_relation_seq` (`relation_id`, `seq_no`),
  KEY `idx_relation_time` (`relation_id`, `create_time`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
这里考虑到 Agent 的回复 SSE 事件会非常巨大,所以建议单独用一张表来存储实际的 SSE 内容,详情表设计可以参考如下:
CREATE TABLE t_agent_chat_detail_{0..127} (
  chat_id      bigint unsigned NOT NULL COMMENT '消息ID,与主表chat_id一致',
  relation_id  bigint unsigned NOT NULL DEFAULT '0' COMMENT '冗余,便于按会话归档',
  content      longtext COMMENT '完整内容(可zstd压缩后存)',
  ext          varchar(2048) NOT NULL DEFAULT '{}' COMMENT '扩展信息字段',
  created_time datetime NOT NULL DEFAULT CURRENT_TIMESTAMP,
  PRIMARY KEY (chat_id, created_time)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
在 t_agent_chat_record 表里面只保留 SSE 内部 Agent 回复的文本信息,其他的 SSE 事件单独存到详情表。SSE 事件的详情表也可以做冷热区分,部分定期归档到离线库中。
会话关系表:
CREATE TABLE `t_agent_chat_relation_{0..127}` (
  `id`            bigint unsigned NOT NULL AUTO_INCREMENT,
  `relation_id`   bigint unsigned NOT NULL COMMENT '会话ID(雪花)',
  `conversation_uuid` char(36) NOT NULL DEFAULT '',
  `tenant_id`     bigint unsigned NOT NULL DEFAULT '0',
  `agent_id`      bigint unsigned NOT NULL DEFAULT '0' COMMENT '对应Agent',
  `user_id`       bigint unsigned NOT NULL DEFAULT '0',
  `last_msg_preview` varchar(512) NOT NULL DEFAULT '',
  `last_msg_seq`  bigint unsigned NOT NULL DEFAULT '0',
  `msg_count`     int unsigned NOT NULL DEFAULT '0',
  `total_tokens`  bigint unsigned NOT NULL DEFAULT '0',
  `type`          tinyint unsigned NOT NULL DEFAULT '0',
  `status`        tinyint unsigned NOT NULL DEFAULT '0',
  `latest_msg_time` datetime DEFAULT NULL,
  `metadata`      json DEFAULT NULL,
  `is_deleted`    tinyint(1) NOT NULL DEFAULT '0',
  `deleted_at`    datetime DEFAULT NULL,
  `create_time`   datetime NOT NULL DEFAULT CURRENT_TIMESTAMP,
  `update_time`   datetime DEFAULT NULL ON UPDATE CURRENT_TIMESTAMP,
  PRIMARY KEY (`id`),
  UNIQUE KEY `uk_relation_id` (`relation_id`),
  UNIQUE KEY `uk_conversation_uuid` (`conversation_uuid`),
  KEY `idx_user_latest` (`user_id`, `is_deleted`, `latest_msg_time` DESC),
  KEY `idx_tenant_agent_latest` (`tenant_id`, `agent_id`, `latest_msg_time` DESC)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
关于 MySQL 分表存储这块,具体查询的路由策略如下:
- 消息表
t_agent_chat_record 分 128 张:分片键 relation_id,路由 shard = relation_id % 128
- 大字段表
t_agent_chat_detail 分 128 张:同分片键 relation_id,同路由(保证 relation_id 落在同一分片,跨表同库)
- 关系表
t_agent_chat_relation:数据量小,不分表(或按 user_id % 128)
这里仔细看的同学可能会有疑惑:为什么 t_agent_chat_detail 表也要按照 relation_id 分片,而不是按照 chat_id 分片呢?
我举个例子。首先来看按照 chat_id 路由分片的思路:
假设有一个用户 A,需要查看自己的某个会话历史记录,那么查询将会是:
select * from t_agent_chat_relation_{A.user_id%128}
where user_id=? order by latest_msg_time desc limit ?,?;
select * from t_agent_chat_record_{conversation_id%128}
where conversation_id=? order by id desc limit ?,?;
- 最后在内存中按照 chatId 再到 chat_detail 表并发捞详情数据。这里假设上一步查询出来的 chat_id 有 50 个,极端情况下需要路由到 50 张表下去查询。
select * from t_agent_chat_detail_1
where chat_id in (?,?);
...
select * from t_agent_chat_detail_50
where chat_id in (?,?);
即使在应用层用了多线程并发、内存加大,高并发下,这种设计还是很容易出现 OOM 问题。
现在我们回过头来看,假设一开始就按照 relation_id 对消息详情表做路由的话,那么最后的查询就只会有一次(因为一般产品交互都是先点开会话,再查看会话内的对话记录):
select * from t_agent_chat_detail_1
where relation_id =?;
这样的设计可以在很大程度上减少对 MySQL 的 IO 访问次数。
但也有可能有人会问:如果我要按照 chatId 进行详情查询呢?
问题不大,用基因法对消息路由进行优化即可。生成 chat_id 时把 relation_id % 128 编进高位,查询时解出来。例如下面这段代码:
// chat_id 64 位:高 7 位 shard(128 分片)+ 低 57 位雪花序列
int shard = (int)(relationId % 128);          // 0~127
long chatId = ((long) shard << 57) | snowflakeSeq;
查询的时候如下:
int shard = (int)(chatId >>> 57);             // 解出 shard
String table = "t_agent_chat_detail_" + shard;
SELECT content FROM table WHERE chat_id = ?;
小结
好了,写到这里,文章大概也就先告一段落了。最近工作比较忙,后续更新速度基本是一周一次。
这次重点和大家分享了我在基于 ReAct 范式的实践领域的一些调优、存储以及踩过的坑,希望能对大家有所帮助。
最后给大家留一个小思考:消息分表存储的时候,按照 100 取模和按照 128 取模有什么不一样的效果(前提条件:100 和 128 维度下空间容量都能满足业务场景)?感兴趣的朋友可以在评论区给出一些思考,也欢迎到 云栈社区 继续交流 Agent 工程化相关的话题。
 发表于 6 小时前
|
查看: 2|
回复: 0


