Trigger.dev 把工作进程从 Zod 3.x 升到 4.5 之后,处理器的需求下降了近三分之一,批处理吞吐量增加了 14%,任务触发的 p99 延迟也降了 18%。作者将收益主要归因于 JSON 解析热路径变轻——这条路径约为每秒一千一百次、每天近一亿次。另一个值得细看的取舍是:对简单的服务端 schema 试用编译后,处理器需求仅再省下约 5%;而一个裸 zod 导入混进核心包,反而让仍在使用 Zod v3 和 npm 的用户出现了冷启动延迟,最终靠 oxlint 检查兜底。
来源:trigger.dev
我们(终于)从 3.x 升级到了 Zod 4.5,worker 的 CPU 需求随之骤降,批处理吞吐量提高了 14%,任务触发 p99 下降了 18%。
我们会解析大量 JSON。任务 payload、批处理条目、队列消息、重试包装器……既有成堆的自有 schema,也有成堆包装过的用户 schema。Zod 一整天都在这条链路上运行,不停地执行 parse 和 safeParse。
在业务持续增长的过程中,这类变化其实很难衡量。微小的优化会立刻被增加的负载淹没,何况我们运行的客户工作负载波动极大。一次数据库尖峰,既可能只是少了个索引,也可能是某个大客户正在跑实验。
但这次的变化一眼就能看出来:我们的一个主要服务,CPU 需求下降了近三分之一。
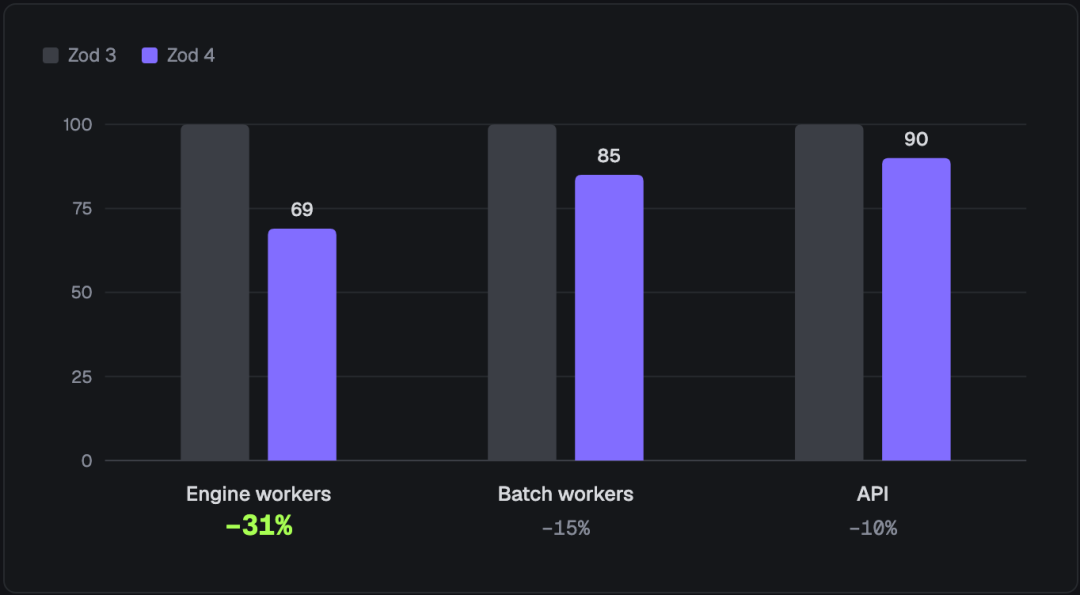
Zod 4 之后的集群 CPU 24 小时均值,以 Zod 3 为基准 100。之后 worker 处理了更高的吞吐量。
Zod 用量几何
到底一天跑了多少 Zod?说实话,很难给出精确数字。我调取了某个 worker 服务的数据,它每秒大约执行 1,100 次 parse,每天接近 1 亿次。我们实际运行的 Zod 远比这多,但我需要一张图来佐证,而这是我能找到的最直观的数据。
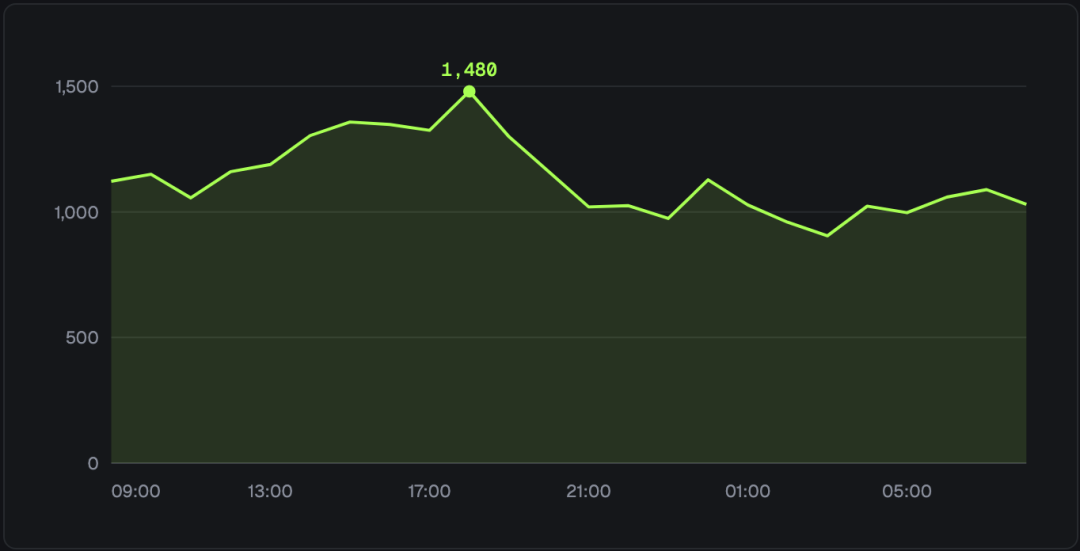
Worker 每秒 parse 次数,每天 9800 万次。一条热路径上 9 月 14 日星期一的 Zod 活动估算。
每个 job 都会执行一次 safeParse(一个很小的 schema,包含 key、run id 之类的东西)。大约一半的 job 随后会解析每条消息,每个 job 可能还要再 parse 10 次。更不用说最初让 job 跑起来的各种 API 入口,以及重试包装器、waitpoint、心跳等。
这次升级还给我们换来了一些事件循环利用率(ELU)的喘息空间。我们之前聊过,ELU 才是那个该盯住的指标吗?我们花了不少时间盯着 ELU 仪表盘,看着它缓缓下降,感觉确实不错。热路径上的解析时间更少,阻塞主循环的时间就少了,留给增长的空间自然更多。
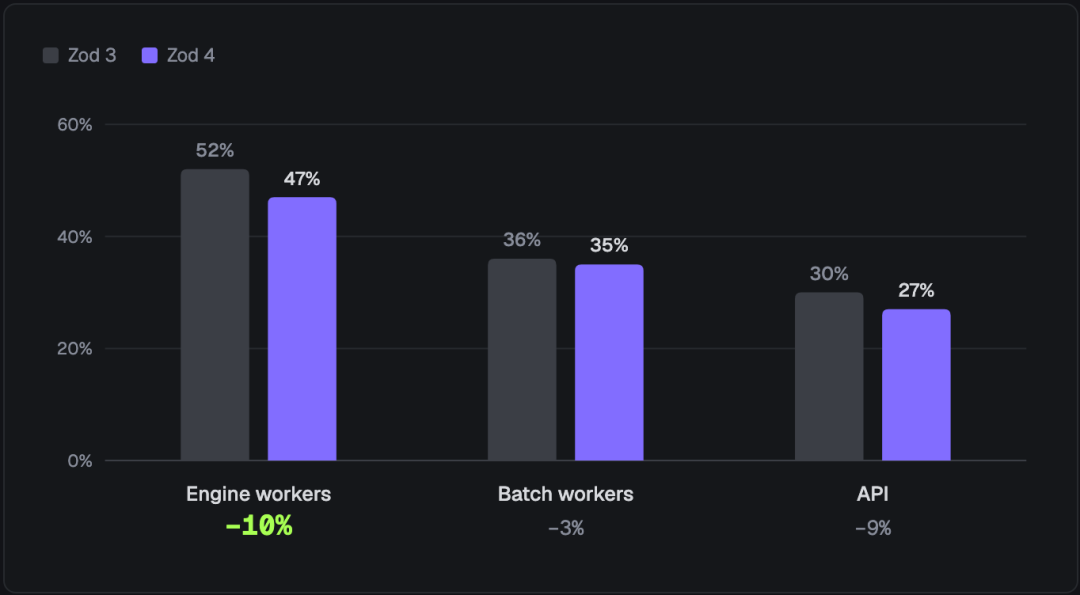
事件循环利用率。每进程 ELU 均值,越低代表余量越大。
Schema 编译效果
Zod 最近加入了 schema 编译能力,它会生成一个扁平、无循环的校验器,理论上应该更快。目前我们只拿简单的(非用户自定义)服务端 schema 做了实验:队列消息、批处理条目、触发请求体。
我又跟踪了一天生产遥测,并做了同等条件下的对比:worker CPU 大约再降低 5%,ELU 也更低。幅度不算大,但也绝对不可忽视。我们会继续在更多 schema 编译上做试验,看看能否再次推动指标。
升级附录
升级过程几乎无痛,但我们也遇到了一个类似“竞态条件”的小问题。升级中最棘手的部分在 core 包:它既被内部系统使用,也被已发布的 SDK 和 CLI 使用,而且这里常常是 Zod v3 形态与 Zod v4 形态之间的接缝。这个 core 包中的 PR 把所有导入都改为显式使用 zod/v4,以便仍在使用已停止维护的 v3 的用户能拿到正确的包。
但合并后不久,一位同事往 core 里加了一个模块,其中使用了裸 zod 导入,而我在排查时没有发现。这导致了一个棘手的问题:满足以下条件的用户,任务运行的 warm start 会被延迟:(a)已升级到这个已发布版本;(b)仍在使用 Zod v3;(c)使用 npm(而不是 pnpm 等)。我们花了一段时间才定位到根因,最终还是修复了,并添加了 oxlint 检查,防止类似问题再次发生。
类似这样的底层依赖升级,往往能带来“捡便宜”式的收益,但前提是你得先有足够的遥测数据支撑判断。这也是云栈社区上不少开发者一直在做的事情——把性能优化变成可衡量、可复盘的工程问题。
引用链接
- Zod 4 got rid of a bunch of CPUs for us
- Zod 官方文档
- Event Loop Lag
- Zod Compile
 发表于 7 小时前
|
查看: 4|
回复: 0


