一个集群一天吞吐 155 万亿 Tokens,平均每张卡按谷价每小时能收 38 美元。这是 DeepSeek 开源自家大规模推理框架 DeepInfer 时,在《DeepSeek V4.1 Flash 大规模推理部署实践》技术报告中晒出的线上营收数据。
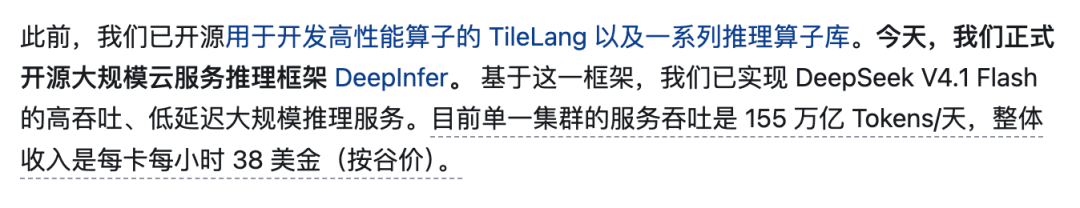
开源仓库地址:https://github.com/deepseek-ai/DeepInfer
技术报告原文:https://zhuanlan.zhihu.com/p/2095560295930508953
这篇详细的技术报告发在知乎上,X 上只给出了 DeepInfer 的仓库地址。不过不少海外开发者还是顺着链接摸到了知乎,纷纷表示 DeepSeek 在 X 上发的只是集锦,知乎上的技术报告才是精华。
很多人第一眼看到单集群一天处理 155 万亿 Tokens(折合每秒持续吞吐近 18 亿个 Token),直觉是这个集群得堆好几万张显卡。DeepSeek 在正文里确实没有直接写出总卡数,但他们给了一张非常实在的实际线上运行数据表。
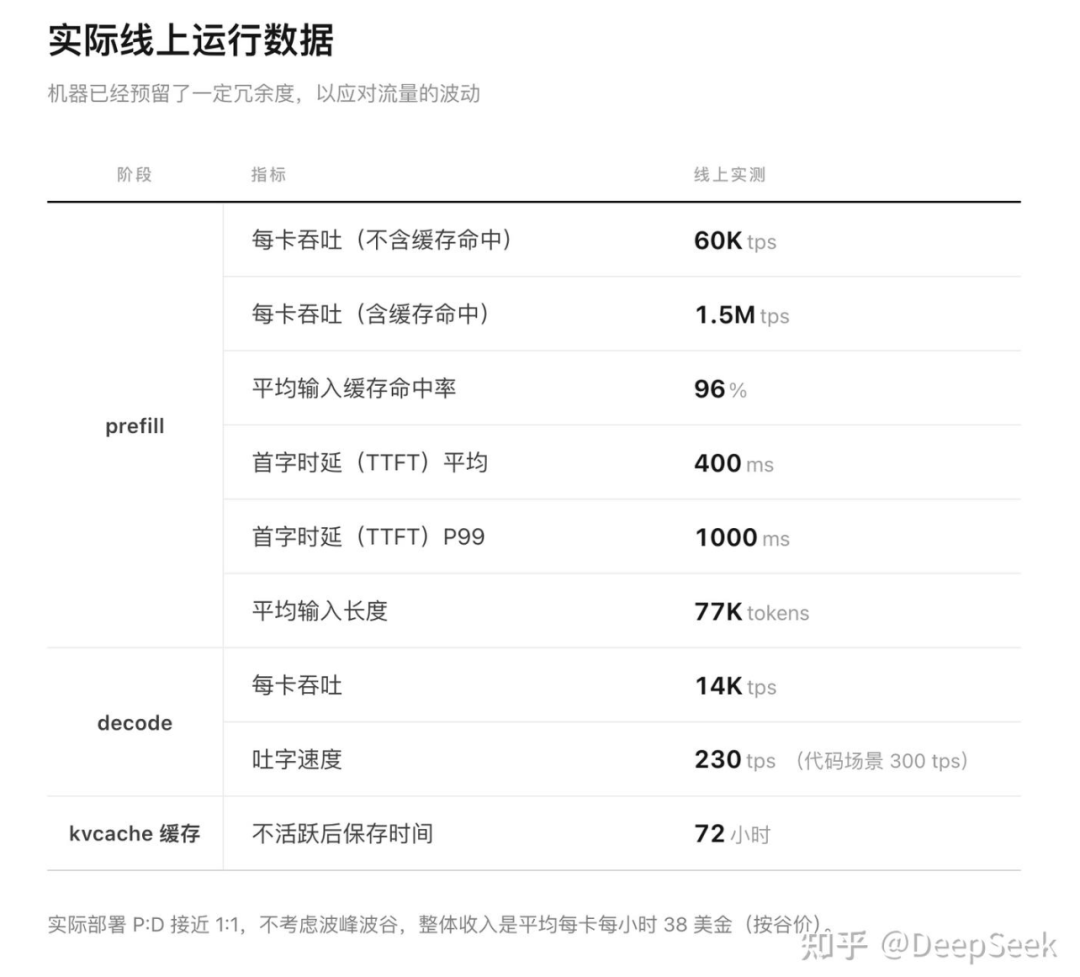
我们先算第一笔账:这个日吞吐 155 万亿 Tokens 的单集群,到底用了多少张卡?
先简单说一下大模型推理中的 Prefill 和 Decode。大模型处理请求分两步:第一步叫 Prefill(预填充),负责把你发过去的一大段提示词和历史记录一口气读完;第二步叫 Decode(解码),负责一个词一个词往外蹦回答。这两步对硬件的要求完全不同,DeepSeek 把它们拆开放在不同的机器上跑——用常见的 8 卡机器做 Prefill,用常见的 64~128 卡超节点做 Decode,并且在表格最底下留了一行关键小字:实际部署里 Prefill 卡和 Decode 卡的数量比例接近 1:1。
既然是 1:1 配对,就拿 1 张 Prefill 卡加 1 张 Decode 卡(一共 2 张卡)来看看它们一天能干多少活。
看表格上半部分,1 张 Prefill 卡在算上缓存命中的情况下,每秒能吞吐 150 万个 Token(1.5M tps)。一天 86400 秒,这张 Prefill 卡满打满算能消化 1296 亿个输入 Token。再看表格下半部分,配对的那 1 张 Decode 卡,每秒能吐出 1.4 万个 Token(14K tps),一天下来大约生成 12.1 亿个输出 Token。
把这两张卡一天的产出加在一起,1 对卡(2 张显卡)每天合计能处理 1308.1 亿个 Token,也就是 0.1308 万亿。
拿整个集群一天的总吞吐量 155 万亿,除以每对卡的 0.1308 万亿,得到约 1185 对。也就是说,1185 张 Prefill 卡配 1185 张 Decode 卡,整个单集群在线跑推理的核心计算卡一共只有 2370 到 2400 张左右。哪怕再算上文中提到为应对流量波动而预留的两成多扩容库存,整个单集群也就是 2400 到 3000 张卡的规模。
结合 DeepInfer 仓库里的硬件说明,这 2400 张主力计算卡的配置也能拼出来。它们跑在英伟达 SM100(Blackwell 架构)上,其中约 1200 张 Prefill 卡装在常规的 8 卡服务器里,差不多 150 台机器;另外 1200 张 Decode 卡则塞进 64 卡或 128 卡的高速互联超节点里(约 18 到 19 个 64 卡超节点),靠大专家并行把单用户吐字速度推到每秒 230 个 Token,写代码场景更是能飙到每秒 300 个 Token。
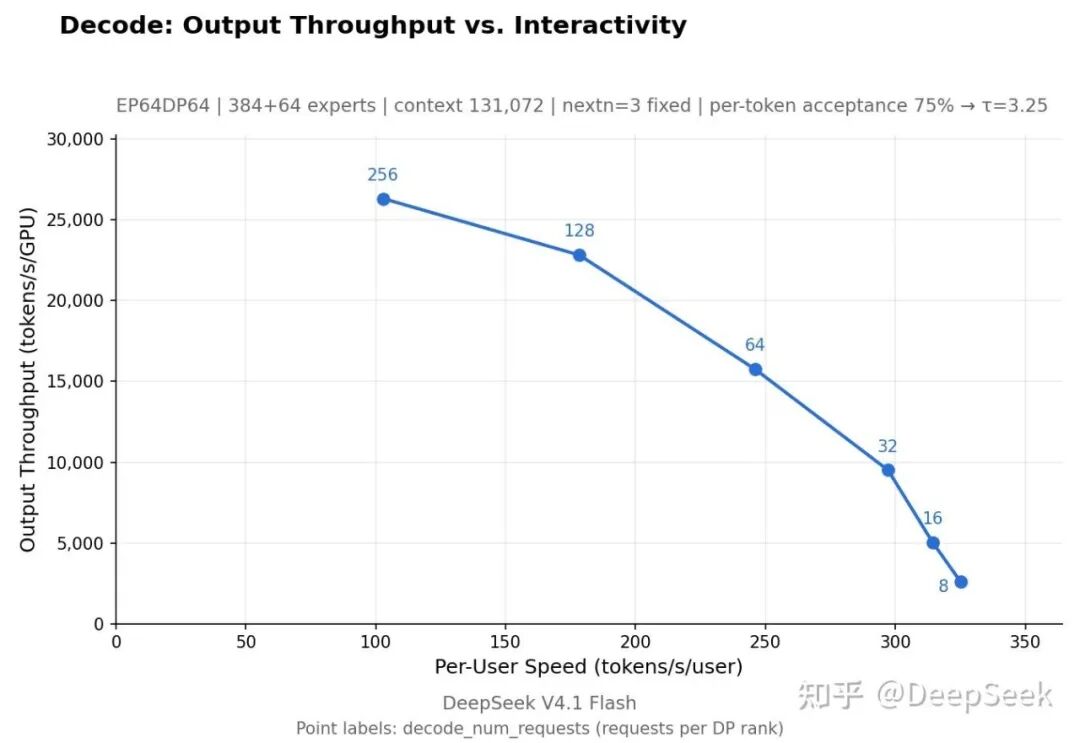
算清楚只有 2400 张卡,紧接着就可以算第二笔账:平均每张卡每小时 38 美金的收入,到底是怎么收上来的?
DeepSeek V4.1 Flash 的 API 单价非常便宜。空闲时段(也就是表格里说的谷价),缓存命中的输入只要 0.02 元/百万 Tokens,缓存未命中的输入是 1 元/百万 Tokens,模型输出是 4 元/百万 Tokens。这么便宜的谷价,是怎么跑出每卡每小时 38 美金流水的?
我们还是拿刚才那 1 张 Prefill 卡加 1 张 Decode 卡(共 2 张卡)的组合,按每秒钟进出的流量乘一下单价。
表格里写着,Prefill 卡每秒处理的 150 万 Token 里,平均输入缓存命中率高达 96%。这意味着每秒钟有 144 万 Token 命中缓存,按 2 分钱一百万算,每秒收 0.0288 元;剩下的 4%(也就是表格第一行写的每秒 6 万 Token)没命中缓存,得老老实实重算,按 1 块钱一百万算,每秒收 0.06 元。至于旁边那张 Decode 卡,每秒吐出 1.4 万个输出 Token,按 4 块钱一百万算,每秒收 0.056 元。
三项收入加在一起,2 张卡每秒合计进账 0.1448 元。平摊到单张卡上,每秒 0.0724 元,换算到每小时正好是 260.64 元人民币。按汇率折成美元,一分不差就是 38 美金。对比市面上同级别旗舰算力卡每小时 2 到 4 美金的租赁和折旧成本,这套集群的毛利空间相当可观。如果每卡每小时服务成本按 3 美元计算,DeepSeek 的毛利率可以达到 92% 以上。
更有意思的是这 38 美金的构成。虽然命中缓存的 Token 占了整个集群吞吐量的 95% 以上,但因为单价只有 2 分钱,它只贡献了不到两成(19.9%)的收入。真正撑起营收大头的是那 4% 没命中缓存的新输入(占 41.4% 收入),以及连总吞吐量 1% 都不到、但单价卖 4 块钱的 Decode 输出(占 38.7% 收入)。
看到这里,整张表格里最核心的两个数字已经很明显了:平均输入长度高达 77K tokens,平均输入缓存命中率高达 96%。
如果大家对大模型的印象还停留在打开网页跟 Chatbot 一问一答,平时手敲几句话也就几千个 Token,肯定会纳闷全网的平均单次输入怎么会飙到 7.7 万个 Token 这么长。
答案就在我们现在天天用的 Coding Agent 里。上个月我实测了一周 DeepSeek Harness,这玩意是真的费 token时,专门统计过自己本地的会话日志。那一周我用 dsh 跑了 6 个任务,其中三天只发了 27 条人工指令,结果它在后台扇出 Subagent、连续调用工具,77 个会话里一共打出 7174 次模型请求,烧掉 20 亿左右 Token。当时 dsh 平均每次请求都带着 18.4 万 Token 的上下文(同一周我的 Claude Code 平均每次请求更是带着 24.7 万 Token),而那 20 亿 Token 里的缓存命中率高达 99.43%,真正的新输入只有 745 万、输出 523 万,算下来三天花了 300 多块,如果一个都不命中得花大几千。
把自己的日志和今天 DeepSeek 公布的线上大盘数据放在一起看,就能看清现在大模型的主力流量结构。不管是 Claude Code、Codex 还是 DeepSeek Harness,Agent 干活的套路都是一步一循环:每跑完一条命令或者读完一个文件,就把结果追加到历史记录末尾,紧接着带着前面几十万字的老上下文发起下一轮请求。除了末尾新增的那一小截,前面 96% 以上全是重复的前缀。
摸清了这个流量底牌,就能看懂 DeepSeek 这套系统是怎么用 2400 张卡撑起 155 万亿吞吐的了。
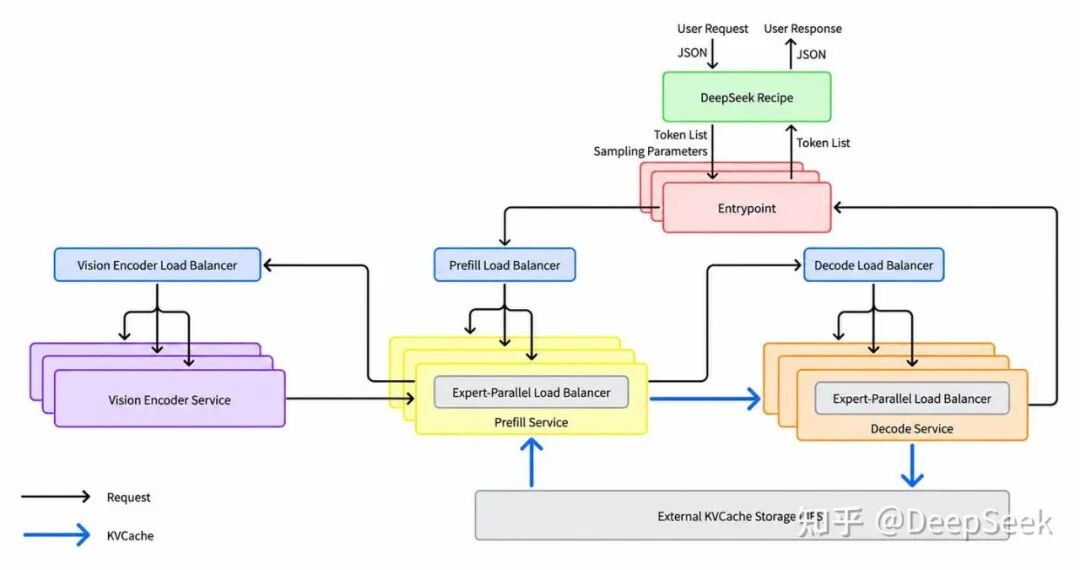
如果每次 Agent 发来 77K 的长文本,都让英伟达显卡从头算一遍,一张卡每秒只能算 6 万个 Token(60K tps),那得堆几万张显卡才能扛住现在的请求量。
DeepSeek 的解法非常干脆:在这 2400 张显卡旁边,专门配了一个容量高达 100 PiB(约 10 万个 TB)的3FS 分布式 SSD 固态硬盘集群,把用户的上下文缓存(Block KVCache)在硬盘里存上 3 到 7 天。这个闪存集群的峰值聚合读取带宽做到了每秒 10 TiB。当你的 Agent 发起下一轮请求时,前面 96% 的历史上下文根本不需要显卡重新计算,直接从 3FS 硬盘池里高速读出来,再通过 RDMA 网卡(GDR 技术)绕开 CPU、直接砸进显卡显存,全程不占用一点显卡的计算核心(SM)。
靠着这套软硬协同,单张 Prefill 显卡的有效吞吐量直接从每秒 6 万放大 25 倍,飙到每秒 150 万。简单说就是,DeepSeek 用便宜的固态硬盘容量和网卡带宽,置换掉了 96% 原本要消耗在 GPU 上的算力。这也是为什么他们敢把缓存命中的输入价格定在 2 分钱一百万 Tokens 来吸引 Agent 开发者——因为这 96% 的流量在后台走的本来就是硬盘读取账。
为了把这笔存储和算力的账算到极致,他们在工程上还主动推翻了自己上一代的设计。
在之前的 V4 技术报告里,模型前 20 层负责局部注意力的滑动窗口缓存(SWA KVCache)原本是要写进硬盘的,或者不写硬盘、等没命中的时候把 20 层网络共 2560 个 Token 从头精确重算一遍。结果到了生产环境一算账,发现这两条路都不划算:普通的 Block KVCache 可以在几天内被反复命中,但滑动窗口缓存只在当前活跃对话的几分钟内有用,进入下一轮很快就失效了,可它却占去固态硬盘将近一半容量。拿存好几天的 SSD 容量去装只活几分钟的数据,成本根本合不上。
到了这次的 V4.1 Flash,他们直接放弃了追求理论精确的方案,改用 SWA Bounded Replay(有界重放):这部分滑动窗口缓存一律不写硬盘,只在产出它的那台机器内存里留 180 秒(实测内存命中率依然超过 98%);万一没命中或者到了 Decoder 层,也不去跑那 2560 个 Token 的精确重算,只近似重算最末尾的 128 个 Token。就这么一改,不仅省出近一半 SSD 空间,还让整个 Prefill 阶段的计算量直接减半。
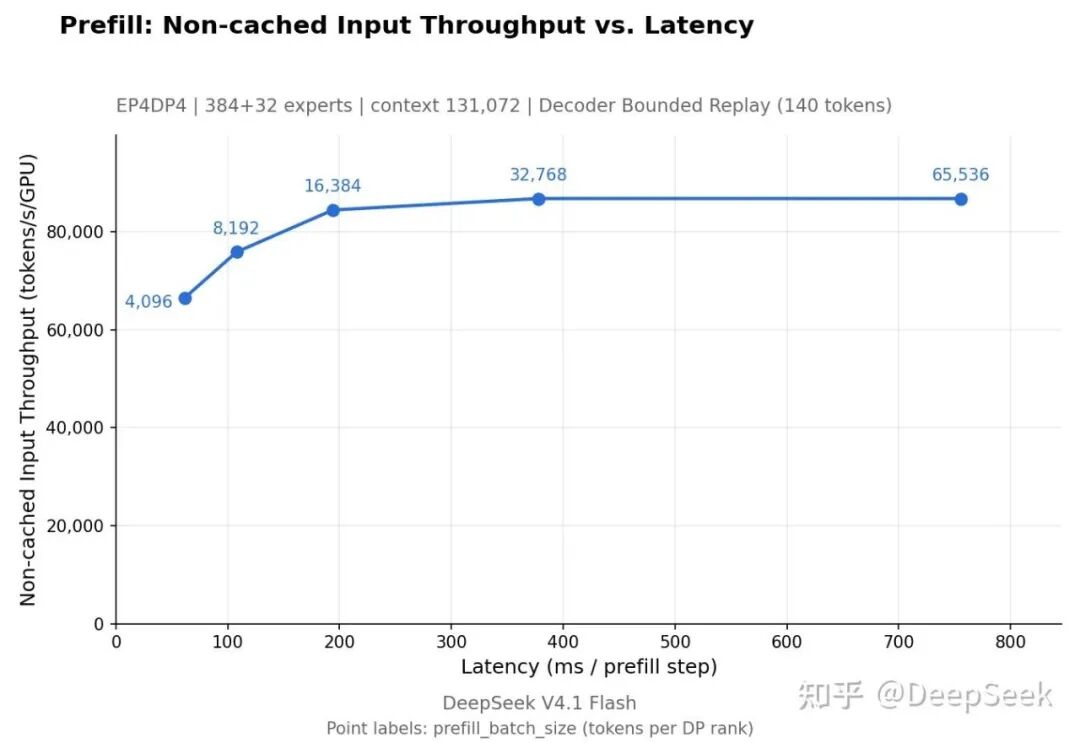
顺着这个视角再去看昨天开源的 DeepInfer 仓库和配套的 deepseek-recipe 组件,就能看清这套框架放出来之后,对开源社区和整个大模型市场降价意味着什么。
以前每次新模型权重开源,很多中小云厂商、API 中转商或者企业私有化团队拿通用的开源框架去部署,总会撞上两件头疼事。一是自己没有庞大的底层算子团队,跑出来的单卡吞吐和吐字速度跟官方 API 差一大截,算力利用率上不去,单价自然降不下来;二是协议转换和工具调用解析各家自己糊一套,开发者拿第三方平台的 API 去接 Claude Code 或者 Codex,经常遇到莫名其妙的解析中断或吞字,体验跟官方 API 完全是两码事。
这次 DeepSeek 直接把压箱底的单机和单超节点加速能力打包交了出来。DeepInfer 里不仅集成了 FlashMLA、DeepGEMM、DeepEP 和把代码吐字速度推到每秒 300 Token 的 DSpark 变长投机解码,还自带了让 Prefill 计算量直接减半的 SWA Bounded Replay;同步开源的 Rust 组件 deepseek-recipe 更是把 Chat Completions、OpenAI Responses 和 Anthropic Messages 三套协议转换、防特殊字符注入的分段并行分词、以及工具调用的跨 chunk 流式解析全做成了标准件。
对社区和第三方算力商来说,这相当于直接拿到了官方同款的推理底座。不需要自己从头抠 CUDA 算子,也不用再踩流式解析的坑,开箱就能把单卡吞吐拉高一大截,并且给用户提供跟官方 API 完全一致的工具调用体验。再加上 DeepInfer 首发就把华为昇腾 950 和英伟达 SM100 并列放在仅有的两款支持硬件里,国内云厂商和政企完全可以用国产算力集群跑出高吞吐的生产服务。硬件供给端不再只盯着单一高价显卡,底层算力的采购和租赁成本也能跟着往下走。
至于对大模型市场整体降价的推动,除了 DeepInfer 代码本身帮各家省下单卡算力成本,知乎那篇长文公开的架构方案和经济账影响其实更大。
DeepInfer 的 README 里虽然写明了 KVCache 存储管理系统、Prefill 与 Decode 分离调度、以及跨副本负载均衡器这三块因为和内部基建耦合太深,暂未随仓库开源,但技术报告已经把这套集群调度的设计思路和真实营收数据全盘托出了。
过去行业里一聊起大模型 API 降价,常有人怀疑低价是在赔本赚吆喝。现在 DeepSeek 直接拿 2400 张卡、100 PiB 固态硬盘和每卡每小时 38 美金的账单摆在台面上,算清楚了哪怕缓存命中只收 2 分钱一百万 Tokens,只要工程架构搭得合理,大规模推理照样有相当丰厚的毛利。
这笔账算明白之后,其他云厂商和模型大厂想要跟进降价就有了明确的技术路径。一方面,第三方平台直接用上 DeepInfer 和昇腾 950,单卡生成 Token 的硬件成本马上就能降下来一截;另一方面,报告里这套用廉价 SSD 容量和 RDMA 带宽置换 96% 显卡算力的方案,给全行业提供了长上下文降本的现成范本。
一旦各家云厂商照着这个思路把自家的分布式 KV 缓存池建起来,市面上针对 Coding Agent 和超长上下文的 API 价格还会继续往下走。对云栈社区里这帮天天挂着 Agent 烧 Token 的开发者来说,这显然是个实实在在的好消息。
 发表于 前天 12:09
|
查看: 8|
回复: 0


