传统 CPU 的 L2 Cache 主要面向处理器核心,承担数据缓存、未命中请求处理以及一致性维护。当矩阵引擎也要接入这套缓存体系时,原有接口能否扛住大规模数据读取,就成了一个新的架构问题。
香山在 XSAI 架构中给出的方案是:让矩阵计算引擎 CUTE 直接接入共享 L2 Cache,同时为矩阵数据增加专用的 512-bit 返回接口。CPU 与矩阵引擎共享同一套缓存一致性机制,但数据返回方式并不相同。
01|矩阵引擎为什么要接入共享 L2
不少 AI 加速器采用独立的片上存储,比如 Scratchpad,由软件或专门的 DMA 负责搬运数据。这种设计让计算单元对数据的控制更直接,但也带来了数据搬运管理以及 CPU 共享数据时的同步问题。
香山 XSAI 选择让矩阵引擎接入一致性 L2。其中控制核负责执行通用指令、管理矩阵任务;CUTE 负责矩阵运算;HBL2 则为矩阵计算提供数据访问能力。
这样做最直接的好处,是可以复用 L2 已有的缓存目录、请求处理和一致性机制。矩阵引擎读取数据时,不必另起炉灶去建立一套独立的缓存一致性系统。
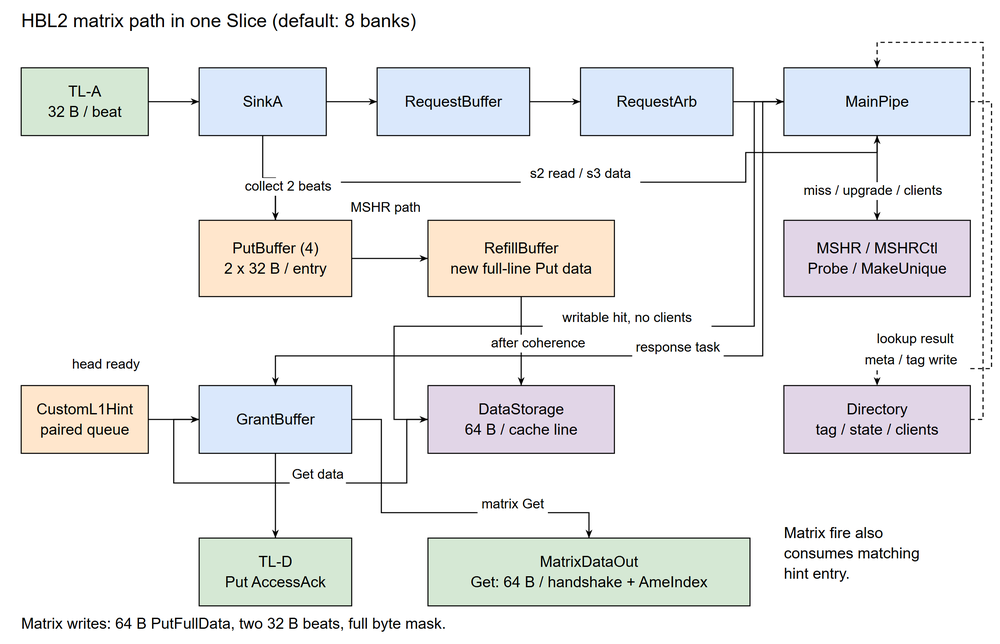
XSAI HBL2 矩阵请求与数据通路(单个 Slice):矩阵请求经 SinkA 进入主流水线,命中数据经专用 MatrixDataOut 接口整行返回|来源:香山设计文档
但共享也意味着竞争。CPU 访存、矩阵读取以及其他缓存请求可能同时涌入 L2,因此香山需要在现有缓存结构上增加一条适合矩阵计算的数据通路。
02|512-bit 接口怎样把数据送到矩阵引擎
香山 HBL2 基于 CoupledL2 扩展而来。默认矩阵配置采用 8 个 L2 Slice,每个容量 256 KiB,总容量 2 MiB,缓存行大小为 64 B。
普通的 TileLink 数据返回通道每拍传输 32 B,一条 64 B 缓存行需要分两拍完成。HBL2 为每个 Slice 增加了一个 512-bit 的 MatrixDataOut 接口,一次握手就可以返回完整的 64 B 缓存行。
矩阵引擎发起读取请求后,L2 仍然走原有流水线查询缓存目录。如果数据已经在 L2 中且无需额外一致性操作,就可以从数据阵列读取,再经专用接口送回 CUTE。
8 个 Slice 的矩阵读取接口聚合宽度达到 512 B/cycle。这个数字是持续握手、没有冲突时的接口上限,实际吞吐还会受缓存访问、请求分布和一致性事务影响。
CUTE 内部还通过 8 个独立的 TileLink 客户端组织访存请求。A、B、C 矩阵以及缩放参数等不同数据流由 LocalMMU 仲裁,再分配到相应的物理通道。
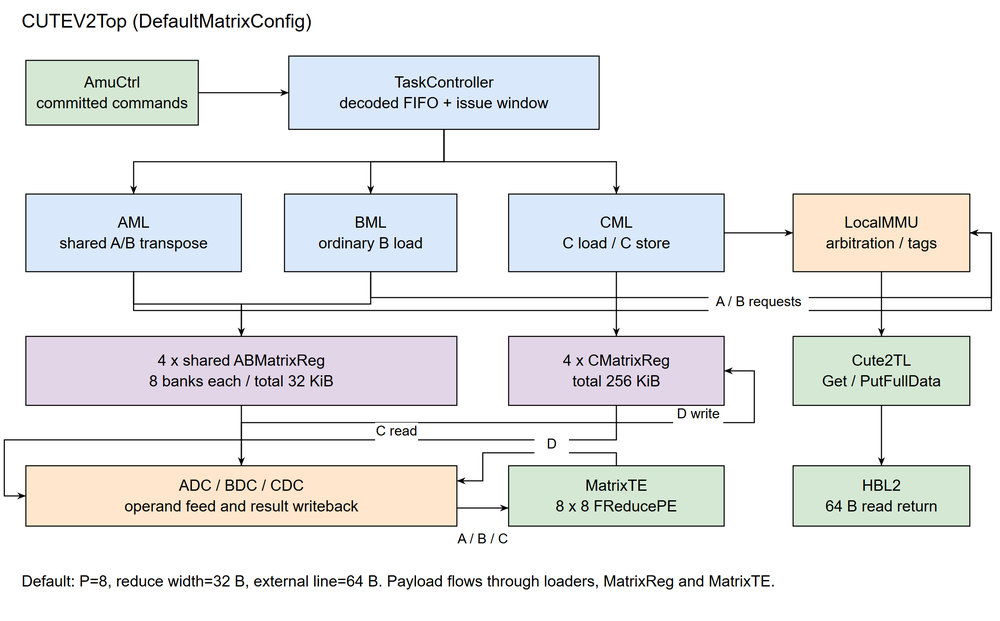
CUTE 顶层结构(DefaultMatrixConfig):A/B/C 访存流经 LocalMMU 仲裁,由 Cute2TL 发起 Get/PutFullData 请求,读数据经 HBL2 整行返回|来源:香山设计文档
因此,这套设计同时考虑了两件事:每次返回多少数据,以及多个矩阵数据流怎样并发发起请求。
03|数据通路独立了,一致性怎么办
假设 CPU 刚刚修改了一条缓存行,矩阵引擎随后要读取同一地址。如果最新数据还停留在 CPU 上层缓存里,L2 就需要先拿到正确的数据副本。
HBL2 并没有让矩阵引擎绕开这一步。
矩阵请求继续复用 CoupledL2 的 Directory、主流水线、MSHR 以及 CHI一致性机制。遇到需要获取上层最新数据的情况,L2 会发起 Probe;发生缓存未命中时,则按照原有流程向下游请求数据。
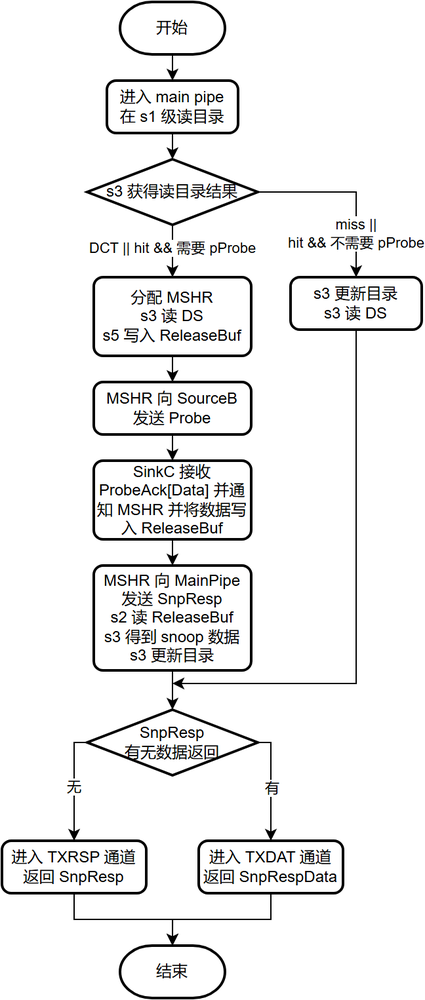
CoupledL2 的 Snoop 请求处理流程:向持有副本的上层缓存发起 Probe,收回最新数据后再响应下游|来源:香山设计文档
专用接口负责更宽的数据返回,一致性控制仍然由共享缓存体系承担。
写入路径也有明确约束。CUTE 向 HBL2 写数据时,使用完整 64 B 缓存行的 PutFullData 请求,不支持直接进行子缓存行写入。数据先进入写缓冲,再由 L2 完成必要的权限检查和缓存更新。
这种设计便于复用已有缓存机制,但也要求矩阵访存单元按照完整缓存行组织外部写入。
04|共享 Cache 的代价在哪里
独立的数据返回接口,并不意味着矩阵引擎可以无限制地访问 L2。
HBL2 每个 Slice 配置 16 个 MSHR,用来跟踪尚未完成的缓存事务。矩阵请求与其他 A 通道请求共享这些资源,但 A 通道最多只能占用其中 15 项,为其他通道保留资源余量。
另外,矩阵读取虽然走专用返回接口,但仍需遵守响应队列的顺序。如果矩阵引擎暂时无法接收数据,返回接口就会产生反压,后续请求也可能被拖累。
这意味着矩阵计算的实际效率取决于多个环节:请求能否持续发出、数据能否及时从 L2 取出、计算单元能否及时消费返回结果。
香山还设计了矩阵引导预取机制,可以根据矩阵描述符生成后续访问地址。不过,该功能在默认矩阵配置中默认关闭,需要通过专门配置启用。
05|CPU 与 AI 引擎共享缓存的一种实现
香山 XSAI 展示了通用 CPU 集成矩阵计算引擎时的一种设计取舍。
独立的 Scratchpad 可以提供更明确的数据管理方式,而共享一致性 L2 则能复用 CPU 已有的缓存基础设施。香山在后一条路线中,进一步增加专用矩阵数据接口,希望改善通用缓存返回通路与矩阵计算需求之间的匹配。
这种方案也带来了新的设计工作:需要处理 CPU 与矩阵请求之间的资源竞争、不同返回接口的顺序关系,以及缓存一致性操作对数据供应的影响。
目前的设计资料披露了接口配置和内部处理机制,但没有给出与其他缓存组织方式直接对比的端到端性能结果。所以,512 B/cycle 更适合用来理解设计目标,不能直接等同于矩阵计算的实际持续带宽。
对 SoC 架构设计而言,香山这个案例提供了一个清晰的思路:当 CPU 增加专用计算引擎时,可以继续使用共享一致性缓存,同时针对新计算单元的数据需求,重新设计访问接口与数据返回路径。对这类架构设计话题感兴趣的读者,也欢迎到 云栈社区 一起交流。
 发表于 前天 22:06
|
查看: 18|
回复: 0
 /1


