两颗裸片尺寸均约为 11.13 × 10.84 mm,单层面积约 120.65 mm²,通过铜—铜混合键合连接。极客湾的拆解与 Kurnal Insights 的裸片分析显示,这种堆叠并非简单增加一块缓存,而是改变了 CPU、GPU 等模块内部的电路布局。
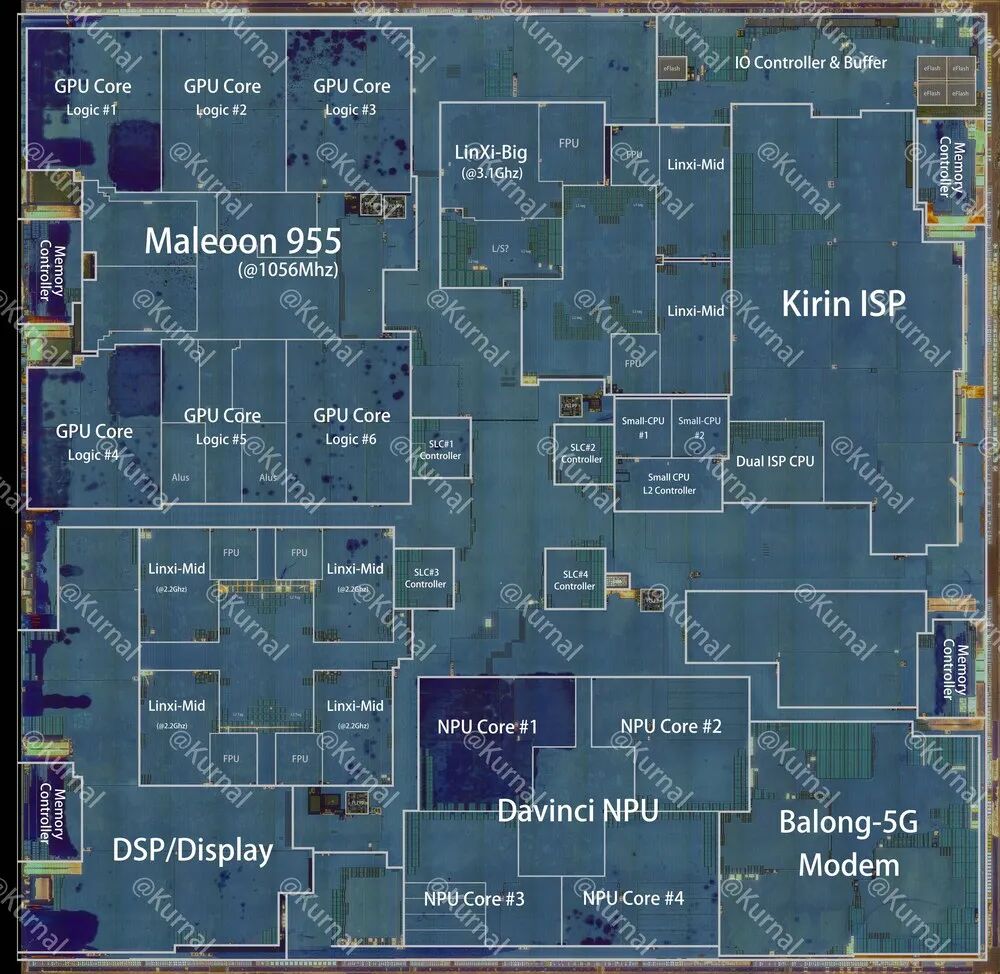
麒麟9050 Pro 上层(逻辑)裸片标注图,CPU 大核(LinXi-Big)、GPU、NPU(DaVinci)等执行单元分布清晰可见。来源:Kurnal Insights(@Kurnalsalts)
这项技术被华为称为 LogicFolding(逻辑折叠)。它试图解决的核心问题是:当晶体管制程难以继续快速缩小时,能否通过改变电路的空间布局,继续缩短信号路径、提高性能和能效。
01|CPU 和缓存,被放到了不同的硅片上
传统 SoC 中的 CPU 执行单元、L1/L2 缓存和控制逻辑通常位于同一层有源电路,通过片上金属布线连接。随着芯片复杂度提高,模块之间的距离、布线拥塞和寄生电阻电容都会影响信号传播。
麒麟9050 Pro 采用面对面堆叠结构。根据拆解分析,CPU 大核的主要执行单元位于上层,而 L1、L2 缓存被布置在下层,与上方的加载/存储单元形成垂直对应关系。GPU、NPU 等模块也存在类似的跨层布局。
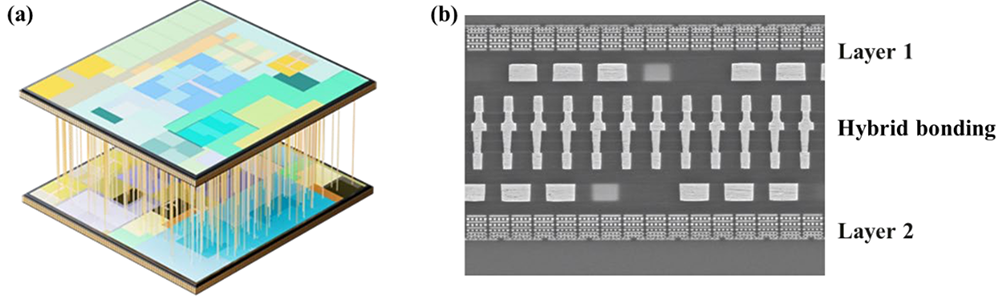
(a)下一代麒麟 SoC 平台三维示意图;(b)混合键合界面截面照:Layer 1—Hybrid bonding—Layer 2。极客湾的实拍剖面仅存在于拆解视频内,此处以华为论文 V2 中的官方截面图替代,同样展示双层结构与铜—铜混合键合界面。来源:华为论文(ChinaXiv,2026)
下层还集成共享缓存、PLL 以及部分高速接口,上层则承担较多计算逻辑。这种划分同时考虑了工艺适配、热分布与布线需求。
原本需要在同一平面上横向连接的部分电路,现在可以通过高密度垂直互连直接通信。对 CPU 而言,执行单元与缓存之间的连接长度会影响访问延迟;对 GPU 和 NPU 而言,计算阵列与本地存储之间的数据路径同样关系到能效。
但垂直距离缩短并不自动意味着整个缓存访问一定更快。最终收益还取决于键合界面的连接密度、额外的跨层布线,以及缓存内部的时序设计。
02|逻辑折叠如何缩短关键路径?
华为在 2026 年发表的《A Time Scaling Theory for Multi-Layer Electronic Systems》中,给出了 LogicFolding 更底层的设计思路。
数字电路的最高工作频率受到关键路径延迟限制。对于一条寄存器到寄存器的路径,延迟既来自逻辑门,也来自连接这些门的金属导线。随着互连电阻和寄生电容增加,即使晶体管本身足够快,信号仍可能被布线拖慢。
LogicFolding 将部分关键路径上的逻辑单元分配到不同有源层,通过混合键合形成跨层连接。对于布局布线工具而言,这相当于增加了一个可以参与电路组织的垂直维度。
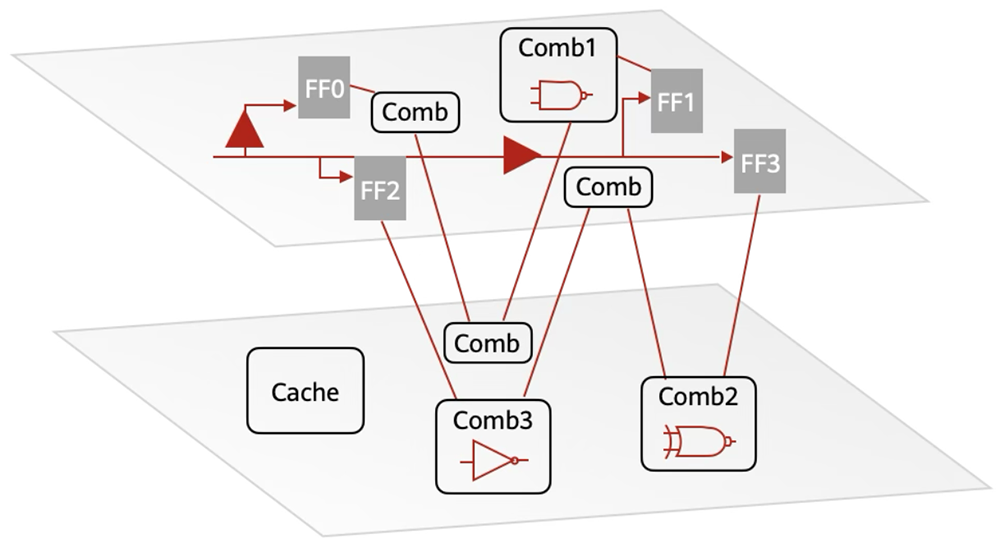
华为论文中的 LogicFolding 双层逻辑与跨层互连示意图:部分组合逻辑与缓存被分配到第二层有源层,寄存器间的路径跨越两层。来源:《A Time Scaling Theory for Multi-Layer Electronic Systems》(ChinaXiv,2026)
这里有一个重要参数:混合键合间距与顶层金属布线间距的比值。如果键合点过于稀疏,原本相邻的逻辑单元需要先通过横向布线汇聚到少数跨层连接点,再进入另一层,额外布线可能抵消垂直堆叠的优势。
论文提出,这个比值最好低于 3,越接近 1 越有利于减少跨层布线开销。华为 2026 年实现的混合键合间距达到 1.5 μm,使更细粒度的电路分割具备了工程基础。
在 Kirin 2026 平台上,晶体管密度由 155 MTr/mm² 提高至 238 MTr/mm²,性能核心能效提升 41%,最高频率提高约 13%。在代表性处理器核心中,时钟缓冲器数量减少超过 50%,时钟偏斜降低约 25%,布线长度减少约 30%。
这些数据说明了逻辑折叠希望改善的对象:通过缩短互连,降低关键路径延迟和时钟网络开销,在既定工艺条件下获得额外的性能空间。
03|8万个 TSV,也意味着新的面积成本
把两层逻辑连接起来,需要解决两类不同的垂直互连问题。
第一类是位于两层电路之间的混合键合连接点,负责高密度的跨层信号传输。第二类是硅通孔(TSV),用于将电源和信号穿过硅片,连接其他布线层及封装。
极客湾拆解分析估计,麒麟9050 Pro 具有约 8 万个 TSV,其通孔及周围禁布区域占下层裸片可用面积约 8%。
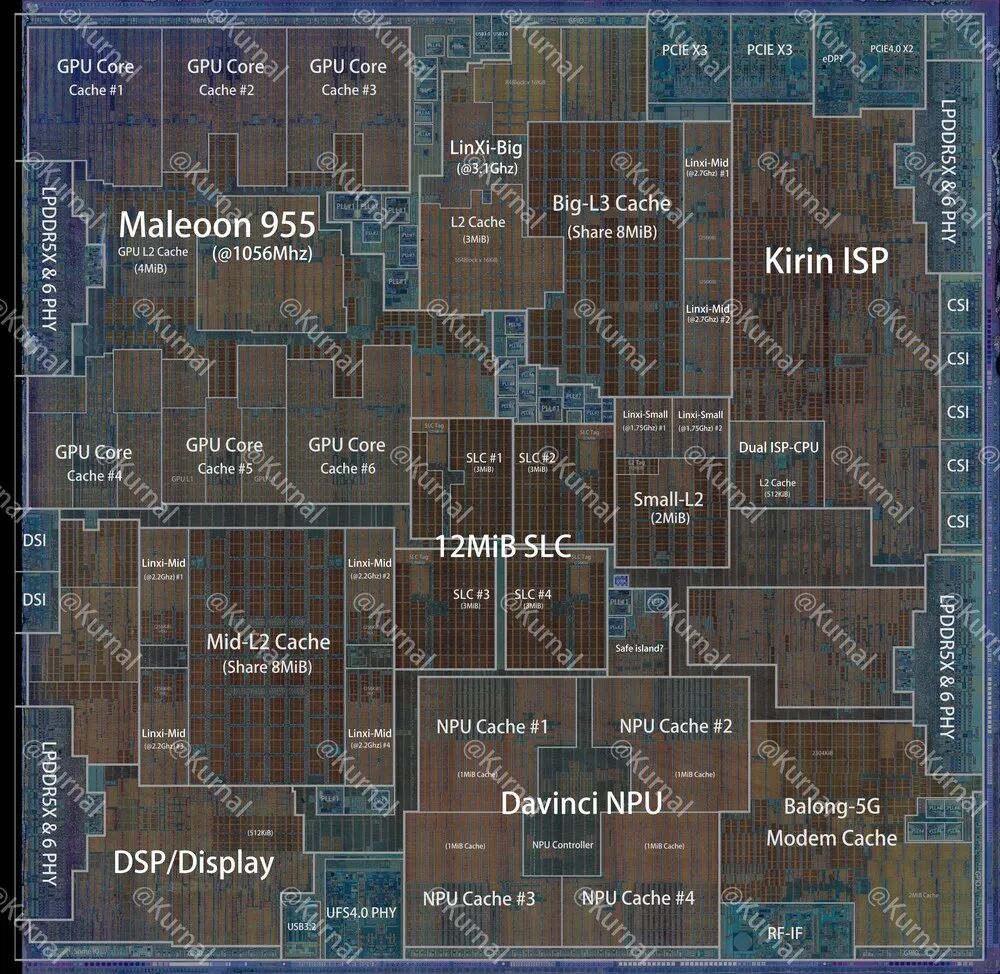
麒麟9050 Pro 下层(缓存)裸片标注图:L2/L3/SLC、GPU Cache、NPU Cache、LPDDR PHY、高速 I/O 等全部分布在这一层,计算逻辑已整体"折叠"到上层。来源:Kurnal Insights(@Kurnalsalts)
这里的 8 万个 TSV 不能直接理解为上下两层逻辑之间只有 8 万个连接点。TSV 与混合键合界面承担不同的互连任务,尺寸、密度和布线约束也不同。
垂直堆叠还会引入供电、散热与制造良率方面的挑战。上层高功率计算电路产生的热量需要穿过堆叠结构散出,下层电路的热环境也会受到影响;与此同时,跨层供电路径必须控制电压降和瞬态噪声。
在制造环节,两层晶圆的对准精度、键合界面缺陷以及垂直连接的冗余设计,都会影响最终良率。堆叠带来的性能收益,需要与这些新增成本一起评估。
04|与 3D V-Cache 相比,变化在哪里?
AMD 的 3D V-Cache 已经证明,通过混合键合把缓存堆叠在处理器上,可以在不显著扩大计算裸片平面面积的情况下增加缓存容量。Intel Foveros 等技术也早已将 3D 集成应用于不同逻辑芯片的组合。
因此,麒麟9050 Pro 的价值并不在于首次实现 3D 堆叠。
它体现的是另一种设计粒度:从把完整功能模块堆叠在一起,进一步走向将同一个功能模块内部的计算、缓存和控制电路跨层重新布局。
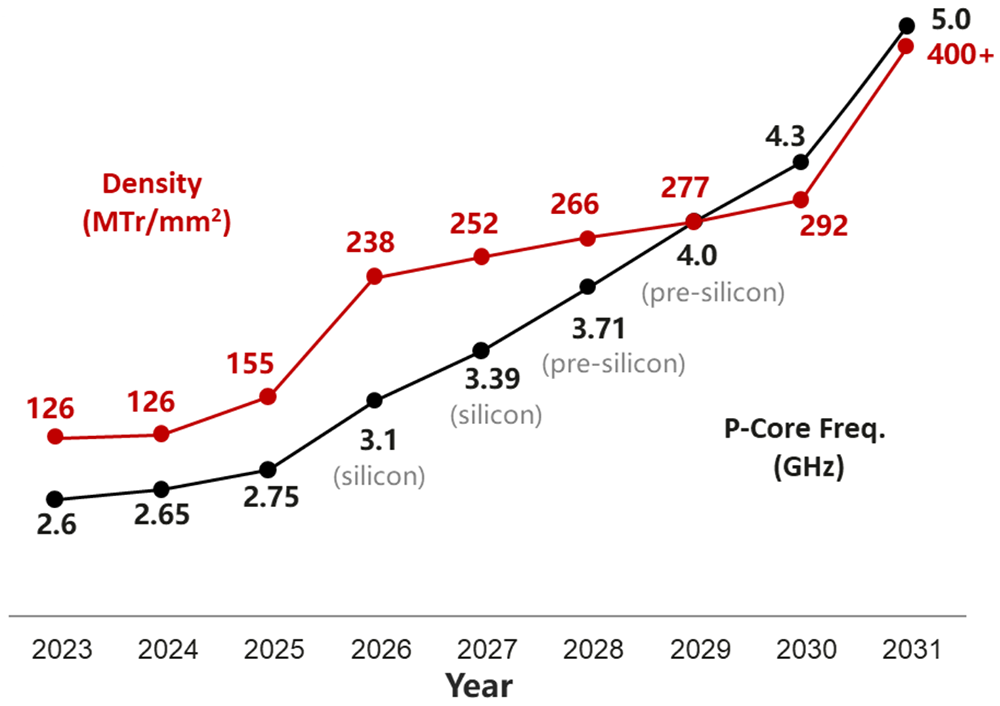
论文给出的麒麟产品晶体管密度(红)与性能核频率(黑)演进路线:2026 年凭逻辑折叠实现密度从 155 到 238 MTr/mm² 的阶跃,2031 年瞄准 400+ MTr/mm² 与 5 GHz。来源:华为论文(ChinaXiv,2026)
这也解释了为什么 LogicFolding 的目标不只是增加晶体管数量。对于复杂 SoC,布线距离、时钟树、供电网络和缓存访问路径共同决定实际性能。即使晶体管工艺没有跨代升级,重新组织这些电路仍可能释放性能空间。
华为论文提出的后续方向,是将目前针对关键路径的局部折叠扩展到更多电路区域,并逐步增加有源层数。不过,层数越多,散热、供电、测试和良率控制也会更加复杂。
05|当制程微缩放缓,芯片还能怎样变快?
麒麟9050 Pro 的拆解提供了一个很有代表性的工程案例:一颗手机 SoC 可以通过重新划分逻辑与存储的位置,改变原有的片上数据路径。
从实际设计看,这种方法并不能替代先进制程。它需要额外的键合工艺、垂直互连、跨层时序分析和热设计,整体制造与验证难度也随之增加。
但它拓展了芯片设计的优化空间。过去,工程师主要在二维布局中权衡逻辑面积、布线距离和时序收敛;现在,部分关键路径可以跨越不同有源层重新组织。
LogicFolding 最值得研究的地方,是把 3D 堆叠从封装层面的模块组合,推进到了 SoC 内部的电路布局与时序优化。
对未来 CPU、GPU、NPU 以及更复杂的 Chiplet 系统而言,晶体管如何制造仍然重要,而计算单元、缓存和互连如何在三维空间中排列,也正在成为影响性能与能效的重要设计变量。
 发表于 昨天 23:32
|
查看: 4|
回复: 0


