最近,华为麒麟 9050 Pro 又有了新消息。极客湾对它做了完整拆解,Kurnal Insights 也在社交平台公布了芯片的 Die Shot(裸片显微照片)。两份资料放在一起看,这颗搭载于 Mate 90 Pro Max 的芯片,思路相当特别。
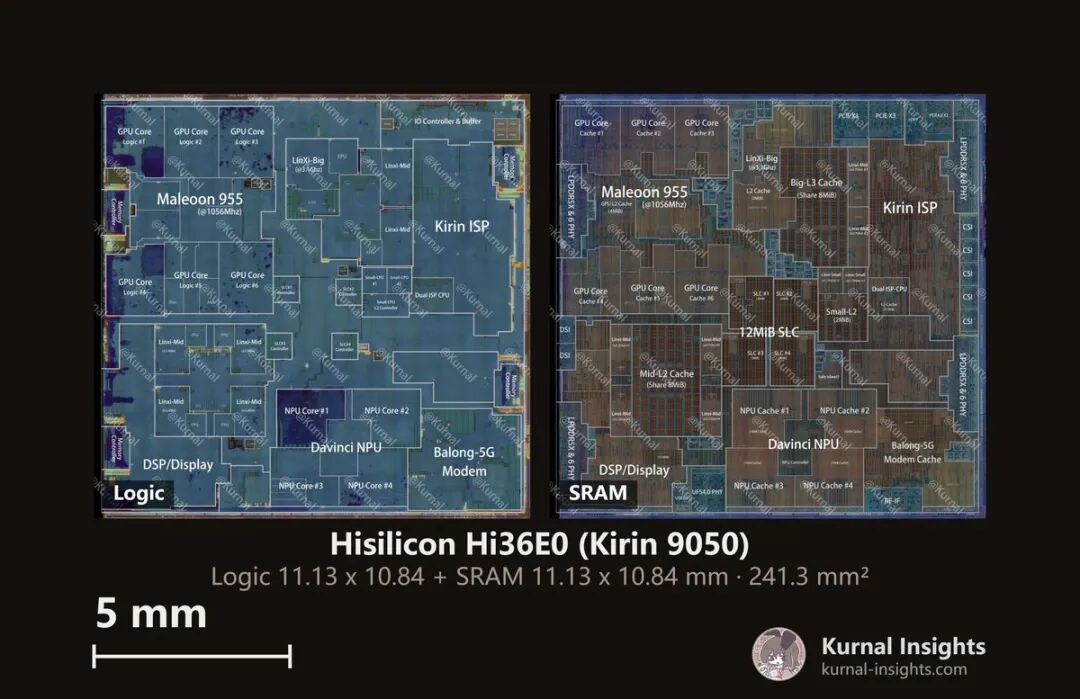
一、先看结构:两颗裸片,上下“粘”在一起
传统手机 SoC 的结构很简单:一块基板、若干金属层,再加上顶部的一层逻辑层。
麒麟 9050 Pro 则不同,它是两颗裸片垂直堆叠,通过铜对铜混合键合把两者的金属层连起来:
两颗裸片的供电和信号靠硅通孔(TSV)传输。据极客湾统计,连接芯片与基板的 TSV 大约有 8 万个,它们的禁布区占用了下层裸片约 8% 的可用面积。
二、核心技术:LogicFolding(逻辑折叠)
这套技术是整颗芯片的灵魂。
它和 AMD 3D V-Cache 有什么不同? 两者都是把缓存放到另一颗裸片上,这里的混合键合连接密度也高得多。但华为并不是简单地把整块缓存搬走,而是让每个主要模块都横跨两颗裸片,从 Kurnal 的 Die Shot 里也能看出来:
- 以超大核为例,大部分执行单元在上层,L1、L2 缓存则在下层,正好位于加载/存储单元的正下方;
- GPU、ISP、NPU 和基带也是类似的布局。
这样安排有什么好处?
- 路径更短:连接密度更高,执行单元到缓存的路径应当缩短,时延随之降低;
- 电压更低:互连变短之后,同一频率下应当可以使用更低电压;
- 各归其位:缓存、I/O 和 PLL 发热少、对工艺不那么敏感,整体放在下层;计算模块放在散热更好的上层。
需要说明的是:以上收益是按原理推断的“应当”,拆解本身并没有给出实测的降幅。
一句话概括:单个电路的晶体管密度不必提升,把电路“叠”起来,整体计算密度就能上去。
三、数据说话:尺寸与密度
两颗裸片尺寸相同,差不多都为 120 mm² 左右。密度这一项推文估算约是上一代的 2.1 倍。
四、NPU:最大的升级点
这一代 NPU 的提升最为明显:
- 两颗裸片上的 NPU 总面积比 9030 Pro 大 150%;
- 实测 INT8 算力 68 TOPS;
- 运行 30 亿参数模型时,预填充速度提升至 3 倍。
在实际应用上,搭载该芯片的手机可在端侧运行 30B-A2B 混合专家(MoE)模型,总参数 300 亿,每次激活 20 亿,负责离线相册整理、修图建议,并驱动华为的 AI 助手;修图功能还搭配一个 60 亿参数的多模态模型。
作为对比,苹果端侧用的是 20B-A4B 模型。由于所有麒麟 9050 Pro 手机都配备 16GB 内存,华为可以把更大的模型放在快速内存里。不过这颗 NPU 仍落后于最新竞品,所以华为每次只激活较小比例的参数。这也让人看到,端侧大模型的能力正在从“能不能跑”转向“怎么跑得更聪明”。
五、游戏表现:成绩亮眼
极客湾的游戏测试结果:
- 《原神》:超过部分骁龙 8 Elite Gen 5 手机,仅略逊于骁龙 8 Elite Extreme Gen 6 和苹果 A19 Pro 机型;
- 《鸣潮》:领先天玑 9500 手机;
- 《异环》:几乎与天玑 9500、骁龙 8 Elite 安卓手机持平,后者运行分辨率略高。
但有一个前提:成绩很大程度上取决于游戏是否针对鸿蒙做了适配。通过转译层运行的游戏,比如《明日方舟:终末地》,效率较低,帧率也更低。
写在最后
这次拆解让人看清的是华为的思路:不只盯着单个晶体管的微缩,而是靠 3D 堆叠和逻辑折叠,在结构上提升整体密度和效率。时延、功耗的实际收益,以及良率和量产规模,目前多为推断,还要等更多独立数据来验证。
资料来源:极客湾拆解报告、Kurnal Insights Die Shot 等。部分制程节点与数据为外界推测,以官方信息为准。 |  发表于 昨天 05:38
|
查看: 3|
回复: 0


