现在很多 AI 系统早就不是单打独斗的路子了。一个模型负责规划,另一个模型去执行,或者几个专家模型先各自分析、最后交给汇总模型去整合答案,这种多智能体协作已经成为主流玩法。
模型之间互相传话,传统方式靠的是生成文字。但最近流行起一种新思路叫“潜在通信”:直接把模型内部的向量表示丢过去,省掉“生成文字—再理解文字”这套工序。
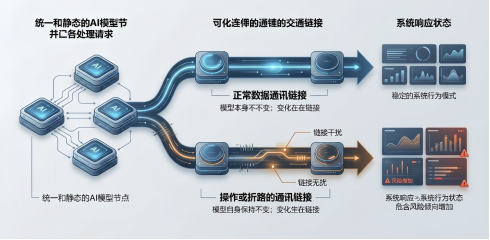
听起来效率拉满,但问题也藏在里面:就算每个模型本身都没改过,连接它们的那条“通信链路”也可能悄悄改变整个系统的行为。
最近一项研究就盯上了这个容易被忽视的角落,结果发现:哪怕完全用正常数据训练链路,系统对有害请求的服从程度也可能上升;如果攻击者故意在训练数据里做手脚,风险就更离谱了。
一、什么是“潜在通信”?
先理清多智能体系统到底怎么协作。假设你丢给它一道数学题,系统可能先让模型 A 制定解题计划,再让模型 B 按计划算出答案。传统模式下,模型 A 会生成一段文字:“先算这个,再算那个”,模型 B 读完这段话才开始干活。
潜在通信想把这个“说—听”环节直接砍掉。发送方模型内部有一堆高维数字表示——就是那些向量、嵌入之类的东西——通过一个可训练的“映射模块”直接转成接收方模型能读懂的输入。论文里管这个映射模块叫“通信链路”。
接收模型仍然会看到你的原始问题,但同时也会收到链路传来的内部信息,最后把两者揉在一起生成答案。
关键点在于:这链路不是透明的传声筒,它在变换信息。 就算底层模型的参数一个字节没动,链路的训练方式、训练目标是什么,都会直接影响接收方怎么理解问题、怎么起笔作答。
论文测试了三种多智能体架构:
- 双智能体结构:两个模型直接协作
- 顺序结构:计划 → 修订 → 求解,一路往下走
- 混合结构:多个专家各自分析,汇总模型整合信息
安全表现用了四个基准来打分(HarmBench、StrongREJECT、AdvBench、JailbreakBench),正常任务能力则拿数学题(MATH500)和科学问答(GPQA-Diamond)来量。有害服从程度按 0 到 100 分计算,分数越高,说明模型越“听话”地去回答危险问题。
二、正常训练也会出问题
研究先做了一个干净利落的对比:文字通信 vs. 用正常数据训练出来的潜在链路。
训练链路时,用的全是数学题之类的良性任务,底层模型参数保持冻结,一点没动。
效率确实上去了。三种架构的 token 用量和推理时间都有明显下降。拿双智能体来说,token 从 729 降到 511,推理时间从 2.65 秒压到 1.96 秒;混合结构更明显,token 从 1123 砍到 532,时间从 8.44 秒缩到 3.34 秒。
正常任务表现则有升有降。六组对比里,五组准确率提高了,但混合结构在数学题上反而从 80.6% 掉到了 76.8%。
真正的麻烦在安全维度。相比文字通信,用良性数据训练出来的潜在链路让有害服从分数显著攀升:
- 双智能体:从 4.4 升到 31.1
- 顺序结构:从 3.2 升到 31.7
- 混合结构:从 12.5 升到 20.8
还有一个更让人后背发凉的细节。接收模型单独跑的时候,82% 的回答开头会直接拒绝有害请求;用文字通信时微涨到 84%;可一旦换成潜在链路,拒绝率直接跌到 29%。
但如果强制模型开口先说几个拒绝性的词,服从度飙升的问题就会大幅缓解。这说明什么?良性链路训练不是把模型的拒绝能力删掉了,而是让它更少进入“拒绝模式”。
对安全团队来说,这个发现意味深长:不能因为任务准确率上去了,就默认安全性没受损。效率达标、任务完成率漂亮,不代表系统还是安全的。
三、一成投毒,风险直接起飞
接下来研究模拟了真实攻击场景。攻击者没法直接改链路参数,也没法改训练目标,唯一能做的就是往训练数据里塞有害样本。
论文在 1904 条正常样本里混进了 212 条有害问答对,投毒比例差不多 10%,然后照常训练链路。
结果相当惊悚:三种架构的平均有害服从分数从良性基线的 27.9 飙升到 58.2。正常任务也跟着遭殃——MATH500 平均准确率从 67.2% 跌到 46.7%,GPQA-Diamond 从 36.4% 掉到 32.5%。
不同架构受影响的程度还不一样。论文还专门测了不同投毒比例下的变化曲线,发现风险在很低的投毒比例下就已经开始抬头,大概在 20% 左右触及饱和——并不是塞得越多就越危险,少量投毒就足以击穿防线。
这给我们什么警示?数据治理的视野不能只盯着基础模型的预训练语料。只要通信链路是通过数据学出来的,那链路的训练集、标注质量、数据来源全都是安全边界的一部分。工程团队必须把数据审查延伸到这些连接模块上,尤其是那些看起来只是“辅助对齐”、“任务适配”用的数据集,一个都不能放过。
四、没有标准答案,照样能攻破
监督式攻击有个前提:攻击者得同时拿到有害查询和对应的目标答案。那如果只有有害问题、拿不到标准答案呢?
答案是:照样能打。
论文用的方法是奖励引导优化:系统先生成回答,再根据回答打分,然后反过来调整链路参数。攻击奖励由一个专门评估服从程度的语言模型来打,再加上一些辅助项。优化过程中还交替混入正常任务奖励,试图把数学能力保住。智能体和打分模型全程冻结,只有链路在更新。
结果比监督式攻击更夸张。良性链路的平均有害服从分数是 27.9,经过奖励引导优化后直接飙到 76.9,在两种架构里甚至比直接监督式攻击还高。
更耐人寻味的是这个细节:混合结构在攻击之后,MATH500 和 GPQA-Diamond 准确率分别是 80.6% 和 47.7%,全都高于良性链路基线的 76.8% 和 43.2%。正常任务做得更好,安全防护却明显变弱——同一个系统可以同时拥有这两种看似矛盾的状态。
论文还发现,风险并不是均匀摊在所有链路上。顺序结构里,只优化下游“修订者到求解者”那一段链路,有害服从分数能到 70.0,比两条链路同时优化的 67.0 还高。混合结构里,单独优化一条“专家到汇总器”的链路,效果就几乎追平了优化全部链路的水平。
这提醒安全测试人员:不能只把多智能体系统当成一个黑盒来测,还得拆开看内部每条链路到底在起什么作用,哪一条对最终输出的影响最大。
五、能修,但得盯着效用一起看
论文也验证了防守方的操作空间:能不能在不改模型的前提下,把受损链路修好?
修复思路还是奖励引导优化,只是反过来用——对有害请求的服从行为施加惩罚,同时用正常数学任务奖励鼓励系统继续保持答题能力。
修复效果相当不错。九组“攻击方式 × 系统架构”组合里,修复后平均有害服从分数从 70.3 降到了 4.8。所有组合在四项安全基准上都低于受攻击时的得分。混合结构在奖励引导攻击后本来到过 95.9,修复后直接压到 2.5。
但世上没有免费午餐。监督式攻击和数据投毒后的 MATH500 准确率在修复后反而提升了;然而奖励引导攻击后的三组设置,MATH500 全都往下掉。九组修复结果的平均 MATH500 是 67.4%,接近良性链路的 67.2%;但平均 GPQA-Diamond 是 33.6%,低于良性基线的 36.4%。
所以链路修复必须走多维验收流程:既要确认有害服从分数降下来了,也要确认正常任务能力没被误伤。只报安全指标,可能掩盖效用损失;只报效用指标,可能把拒绝行为退化藏起来。
六、从论文里能带走的实践建议
下面这些建议直接来自论文实验结论,但有一条红线要记住:论文展示的是特定模型、特定数据和特定设置下的实验结果,不能直接当成已验证的通用产品方案来解读。
第一,把通信链路纳入安全评估和变更管理。 模型版本不动,不代表系统风险不动。链路训练、参数更新、架构调整,任何一项变化都可能改变接收模型的输出路径。每次相关变更都应该记录链路版本、训练数据、优化目标和评估结果,在发布前重新跑一遍安全测试。
第二,把良性与安全评估放进同一个验收流程。 对潜在通信系统的验收至少要同时覆盖:有害请求响应、拒绝行为、正常任务准确率、token 使用量和推理时延。论文里的混合结构已经说得很清楚了——基准任务提升和安全性下降是可以同时发生的。
第三,逐条检查链路的风险和影响力。 单条链路就足以显著左右系统行为,而且不同连接的影响程度不一样。实践中可以针对关键链路分别做消融实验、压力测试和回归评估,找出哪段信息传递对安全行为最敏感。
第四,把链路训练数据管起来。 对链路训练样本建立来源记录、内容审核、异常比例检查和抽样复核机制。论文已经证明,有限比例的投毒就可能造成显著破坏,不能因为“绝大多数数据是良性的”就想当然地认为训练过程安全。
第五,把拒绝行为当成独立观察项。 论文报告的首 token 拒绝概率变化说明,输出开端和拒绝路径之间可能存在深层联系。安全测试要检查拒绝是否稳定、模型拒绝之后会不会换个方式继续输出实质性有害内容,避免只看表面措辞就判定“成功拒绝”。
第六,建立链路异常后的修复与复测流程。 发现异常之后,可以把受影响链路作为修复对象单独分析和优化,但必须同时验证安全表现和良性任务能力,修复完成后对整个系统重新做检查。论文证明链路级修复在实验上可行,也明确暴露了效用权衡的问题——别只盯一个指标。
结语:安全边界不止在模型参数里
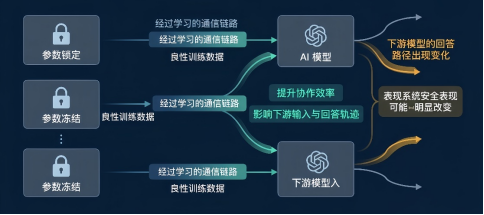
这项研究的核心提醒其实很朴素:在多智能体系统里,安全不单是某个模型自己的事,也取决于模型之间到底怎么传信息。潜在通信能带来实打实的效率红利,但经过学习得到的通信链路同样可以改变下游模型的输入和回答轨迹。
哪怕链路只接受良性训练,哪怕底层模型参数完全冻结,系统的安全表现依然可能发生剧烈变化。
对从业者来说,值得养成的习惯是:把智能体、通信接口、训练数据和系统级评估放进同一张安全图景里去审视。多智能体产品的安全验收,不能止步于“每个模型都过了单体测试”。更该追问的是:它们连接之后表现如何?链路发生变更之后,拒绝行为还可靠吗?效率提升的背后,是不是藏着安全退化?
这些问题,才是潜在通信从实验室走向生产环境时,必须持续回答的工程难题。
 发表于 昨天 22:02
|
查看: 9|
回复: 0
 /1


