关键词:递归多智能体、隐空间协作、RecursiveLink、内外循环训练、推理效率
智能体协作本身能否通过递归方式实现规模化(Scaling)?
随着大语言模型单模型能力逐渐逼近瓶颈,多智能体系统成为突破能力边界的核心方向。但传统多智能体始终受限于文本交互的底层瓶颈:每一次信息传递都需要经过编解码流程,带来巨大的延迟与 token 开销,训练时更会造成梯度消失,难以实现端到端系统优化。
递归语言模型的出现为深度推理提供了新的思路,通过复用 Transformer 层在隐空间迭代优化,单模型的推理深度得到显著提升。 但这种递归范式始终局限于单个模型内部,无法利用多智能体的能力互补优势。
RecursiveMAS 的核心洞察,就是将递归缩放的范式从单模型内部推广到整个多智能体系统,把整个系统视为一个统一的隐空间递归计算过程,通过轻量的 RecursiveLink 模块连接异构智能体,形成闭环协作。
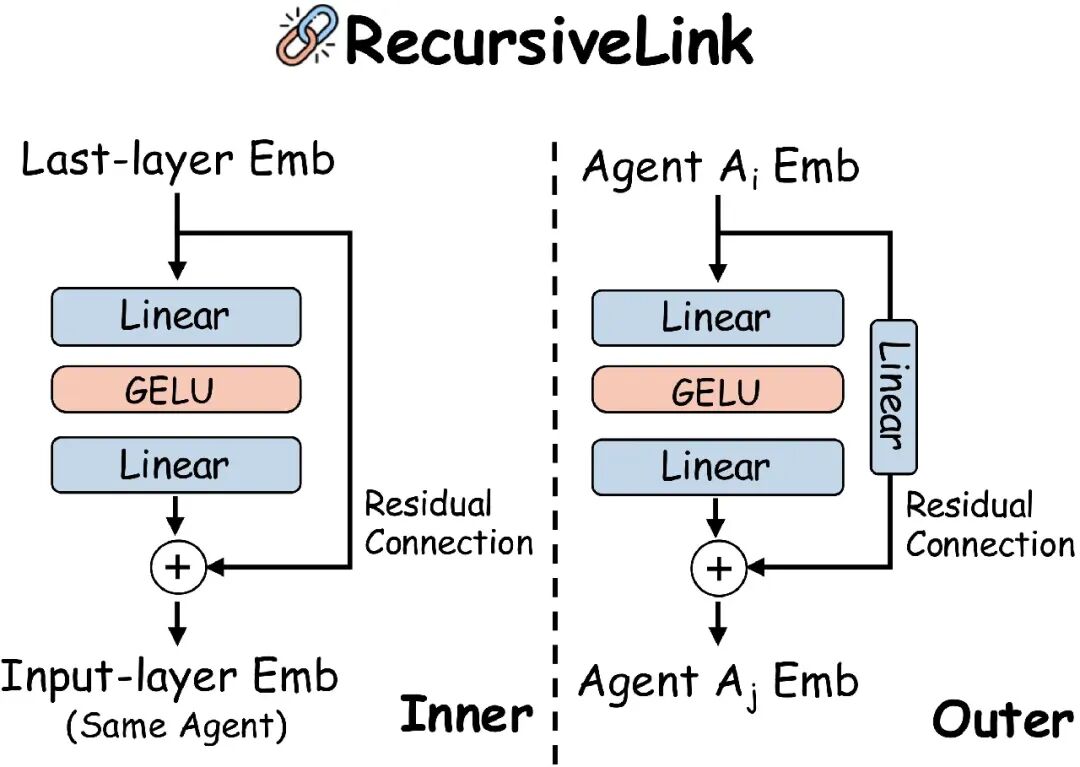
这张图展示 RecursiveLink 的两种结构:Inner 内部模块与 Outer 外部模块。Inner 针对同一个智能体,将模型最后一层嵌入,送入两层 Linear+GELU 的 MLP,通过残差连接,输出该智能体输入层嵌入,实现同主体内部表征映射。Outer 用于不同智能体间,把 Agent 的嵌入输入同款 MLP,额外增加一条线性支路做残差,输出 Agent 的嵌入,完成跨智能体的表征递归链接,以此建立不同智能体表征之间的映射关系。
实验结果显示,在数学、科学、医学、代码生成、搜索问答五大领域的 9 个基准测试中,RecursiveMAS 相比先进基线平均提升 8.3% 的准确率,同时实现 1.2 倍到 2.4 倍的端到端推理加速,减少 34.6% 到 75.6% 的 token 使用量。
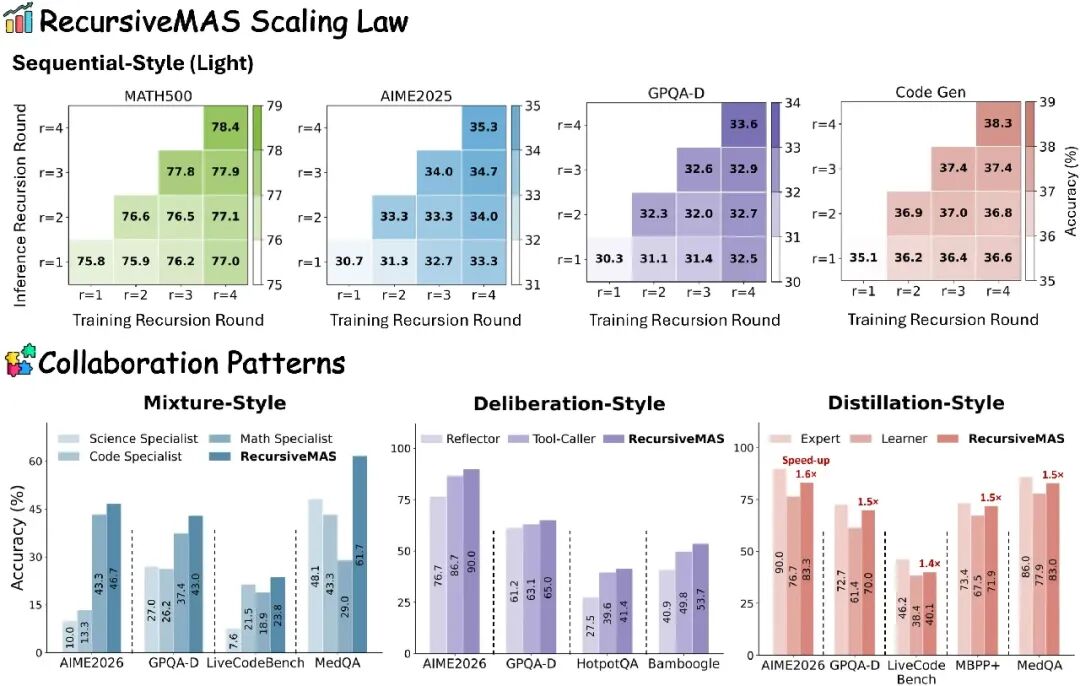
这张图展示 RecursiveMAS 多智能体系统的缩放规律与不同协作模式实验结果。上半部分 Sequential-Style(轻量串行模式),在 MATH500、AIME2025、GPQA-D、代码生成四项任务中,随着训练与推理递归轮数增加,模型准确率整体稳步提升。下半部分对比三类协作范式:Mixture 混合专家、Deliberation 审议式、Distillation 蒸馏式,RecursiveMAS 均优于普通领域专家、Reflector、Tool-Caller 等基线模型;蒸馏模式还标注了 1.4~1.6 倍加速,证明该架构既能提升任务精度,又具备推理加速优势。
这项工作为多智能体系统的规模化提供了全新的技术路径,从底层打破了文本交互的效率天花板。
本文目录
- 一、多智能体系统的缩放困境:从文本交互到隐空间革命
- 二、RecursiveMAS 核心架构:把多智能体系统做成一个递归计算环
- 三、RecursiveLink 设计:两层残差投影,打通异构模型的隐空间通道
- 3.1 内部链路:智能体内部的隐状态自回归
- 3.2 外部链路:异构智能体之间的隐空间桥接
- 3.3 残差连接的设计价值
- 四、内外循环训练范式:让整个系统像单模型一样端到端优化
- 4.1 内循环训练:单个智能体的隐思考预热
- 4.2 外循环训练:整个系统的端到端联合优化
- 五、理论验证:为什么隐空间递归比文本交互更高效?
- 5.1 运行复杂度分析:跳过词汇表解码的数量级优势
- 5.2 梯度稳定性分析:避免递归训练中的梯度消失
- 六、实验结果:横跨 9 大基准的三重性能跃升
- 6.1 递归深度的缩放效应:越深越强,越高效
- 6.2 与主流方案的横向对比:全面领先
- 6.3 跨协作模式的通用性:四种架构全部生效
- 6.4 训练成本分析:更低成本,更高效果
- 七、总结与展望:系统级递归的产业意义与未来方向
一、多智能体系统的缩放困境:从文本交互到隐空间革命
随着大语言模型能力逼近单模型瓶颈,多智能体系统成为突破能力边界的核心方向。通过将不同专长的模型组织为协作整体,多智能体能够整合规划、批判、求解、工具调用等多种能力,解决单一模型难以应对的复杂任务。
但传统多智能体系统始终面临一个底层瓶颈:智能体之间的交互完全依赖自然语言文本作为中介。 每一次信息传递都需要经过「隐状态解码为文本-文本编码为隐状态」的完整流程,不仅带来巨大的 token 开销与推理延迟,更在训练时造成梯度逐层衰减,难以实现端到端的系统级优化。
现有优化路径始终未能跳出这个底层框架。
- 提示工程方向只能调整交互指令,无法改变交互本身的效率缺陷;
- 单独训练每个智能体的方案成本高昂,且无法解决交互环节的固有损耗;
- 单模型递归方案如 LoopLM 等,通过复用 Transformer 层提升了推理深度,但局限于单个模型内部,无法发挥多智能体的能力互补优势。
受到递归语言模型的启发,研究者提出了核心设问:智能体协作本身能不能通过递归实现缩放?基于这个问题,论文提出了 RecursiveMAS 框架——将整个多智能体系统重构为一个统一的隐空间递归计算过程,让智能体之间直接在隐空间传递信息,跳过文本编解码环节,从底层解决交互效率问题。
二、RecursiveMAS 核心架构:把多智能体系统做成一个递归计算环
RecursiveMAS 的核心思想,是把每一个智能体都看作递归计算中的一层,信息在智能体内部与智能体之间持续流动,最终形成一个闭环的递归计算系统。整个过程中,中间轮次的交互完全发生在隐空间,只有最终轮次才解码为文本输出。
这种设计彻底重构了多智能体的交互模式。传统多智能体是「一次性流水线」或「多轮文本对话」,而 RecursiveMAS 是「隐空间循环迭代」——每一轮递归都能复用前一轮的隐状态信息,不断迭代优化答案质量。
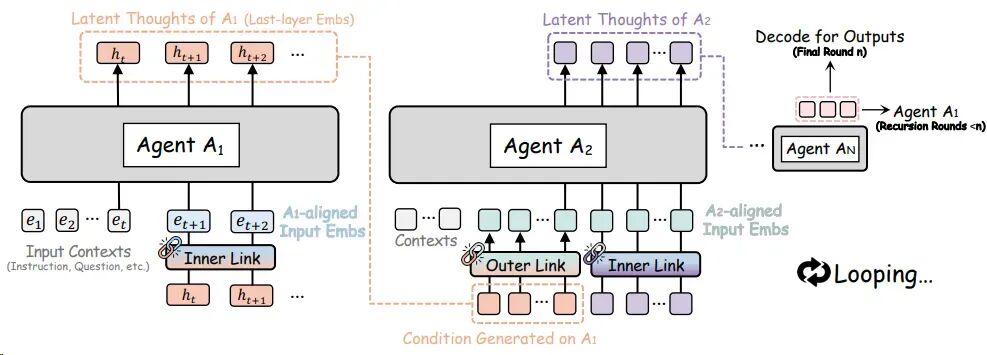
图 2:RecursiveMAS 整体架构。每个智能体首先利用内部 RecursiveLink 生成隐空间思考,再通过外部 RecursiveLink 将信息传递给下一个智能体;最后一个智能体完成生成后,其隐状态会传回第一个智能体,从而在多智能体系统内部形成递归环路。
图 2 完整展示了 RecursiveMAS 的双层递归结构:内层是单个智能体内部的隐状态自回归生成,外层是多个智能体之间的隐状态循环传递。这种嵌套的递归设计,既保留了单个模型的深度思考能力,又实现了多智能体的协作迭代,信息在闭环中持续流动、持续优化。
RecursiveMAS 对四种主流多智能体协作架构完全兼容,不需要修改智能体本身的结构,只需要通过 RecursiveLink 连接即可,具备极强的通用性。四种协作模式如下:
| 协作模式 |
核心特点 |
| 顺序式 |
由规划者、批判者、求解者三个角色组成流水线,逐步分解、评判、解决问题 |
| 混合式 |
多个领域专家并行推理,由汇总者整合输出最终答案 |
| 蒸馏式 |
大模型专家向小模型学习者传递知识,兼顾效果与推理效率 |
| 审议式 |
反思者与工具调用者配对,迭代优化方案并调用外部工具完成任务 |
三、RecursiveLink 设计:两层残差投影,打通异构模型的隐空间通道
RecursiveLink 是整个框架的核心技术组件,承担着隐空间信息转换与传递的功能。它的设计目标非常明确:用最小的参数量,实现不同嵌入空间之间的语义对齐,同时保留原始信息的完整性。
不同于全量微调或适配器方案,RecursiveLink 只做轻量的分布偏移调整,不重构语义本身。这种设计思路让训练成本极低,同时保证了信息传递的稳定性。
3.1 内部链路:智能体内部的隐状态自回归
内部 RecursiveLink 负责同一个智能体内部,将最后一层的隐状态转换为输入层的嵌入,用于下一步的自回归生成。其计算公式为:
$$
h_{\text{input}} = \sigma(W_2 \, \sigma(W_1 h)) + h
$$
其中 $h$ 是输入的最后一层隐状态,$W_1$ 和 $W_2$ 是两个线性层,$\sigma$ 是 GELU 激活函数,残差连接直接保留原始的 $h$。
比方说,内部链路就像给模型加了一个「思考续接器」,不用把想法说出来(解码成文本),直接在脑子里接着想下一步,大大提升了思考效率,也避免了表达过程中的信息损耗。
3.2 外部链路:异构智能体之间的隐空间桥接
外部 RecursiveLink 负责将一个智能体的隐状态,转换为另一个智能体可以接收的输入嵌入,解决不同模型尺寸、不同架构带来的嵌入空间不匹配问题。其计算公式为:
$$
h_{\text{out}} = \sigma(W_2 \, \sigma(W_1 h_i)) + W_3 h_i
$$
相比内部链路,外部链路在残差分支多加了一个线性层 $W_3$,用来把源智能体的隐空间维度,映射到目标智能体的输入维度。
外部链路就像不同语种之间的「同声传译」,直接把一个模型的「想法」翻译成另一个模型能读懂的格式,不需要先翻译成自然语言再转译,既快又准,还不会丢失细节。
3.3 残差连接的设计价值
残差连接是 RecursiveLink 设计中的关键选择,其核心作用是保留原始语义。RecursiveLink 只需要学习分布的偏移,不需要从零学习投影关系,这让训练更稳定,效果更好。论文通过消融实验验证了这一设计的有效性:
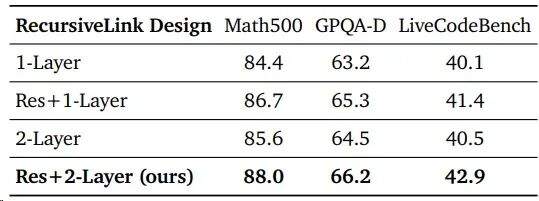
表 4:RecursiveLink 设计效果验证。对比不同架构设计在三个基准上的准确率表现。实验结果清晰表明,带有残差连接的 2 层设计效果最优。仅给单层网络加上残差分支,就能在 GPQA-D 基准上从 63.2% 提升到 65.3%,甚至超过了无残差的 2 层设计。这验证了「保留原始语义、只调整分布」的设计思路的正确性。
四、内外循环训练范式:让整个系统像单模型一样端到端优化
有了架构基础,接下来的核心问题是如何训练整个递归系统。RecursiveMAS 提出了内外循环的两阶段训练策略,先让每个智能体学会在隐空间思考,再让整个系统学会在隐空间协作。
这种训练范式的精妙之处在于,全程冻结所有基础大模型的参数,只训练轻量的 RecursiveLink 模块。 这意味着训练成本极低,同时可以无缝对接任意开源或闭源模型。
4.1 内循环训练:单个智能体的隐思考预热
内循环训练的目标,是让每个智能体适应「隐空间自回归生成」的模式,不用每次都解码成文本。
训练过程中,研究者将标准答案通过输入嵌入层得到的向量作为目标,让智能体生成的隐状态尽可能接近这个目标,损失函数采用余弦相似度:
$$
\mathcal{L}_{\text{inner}} = 1 - \frac{H \cdot \hat{H}}{\|H\| \, \|\hat{H}\|}
$$
其中 $H$ 是智能体生成的隐状态,$\hat{H}$ 是标准答案的输入嵌入,训练的目标是让两者尽可能相似。
这个过程就像教一个人「在脑子里打草稿」,不用写出来,想法就能一步步推进,而且最终的想法和标准答案是对齐的。内循环训练可以并行进行,每个智能体独立完成,训练效率很高。
4.2 外循环训练:整个系统的端到端联合优化
外循环训练的目标,是优化所有智能体之间的外部 RecursiveLink,让整个递归环路的最终输出效果最好。
训练时,将整个多智能体系统按递归轮次展开,从输入到最终输出形成完整的计算图,最终用交叉熵损失函数,将梯度反向传播回每一个外部链路。损失函数为:
$$
\mathcal{L}_{\text{outer}} = -\sum_{t} \log p(y_t \mid S^{(n)})
$$
其中 $S^{(r)}$ 是第 r 轮递归的系统状态,经过 n 轮递归后得到最终预测,和标准答案计算交叉熵损失。
这种设计的关键优势在于,梯度可以沿着递归环路一路反向传播,每一个 RecursiveLink 都能根据最终效果获得对应的优化信号,实现整个系统的联合进化。这是文本交互的多智能体系统做不到的——文本解码会让梯度几乎完全消失。
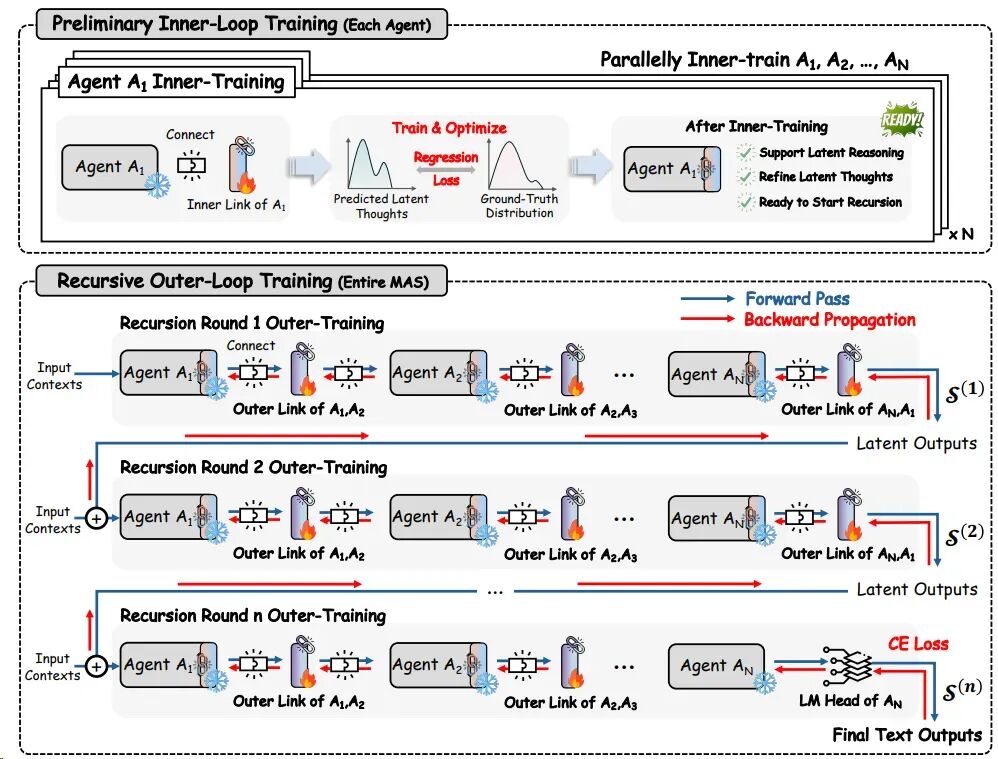
图 4:RecursiveMAS 两阶段训练流程。我们首先并行对每个智能体进行内循环训练,预热内部 RecursiveLink 以生成隐空间思考;随后进行外循环训练,在整个系统上递归优化外部 RecursiveLink。内循环并行训练每个智能体的内部链路,外循环串行训练整个系统的外部链路。这种分层训练策略既保证了单个智能体的基础能力,又实现了系统级的协作优化,同时兼顾了训练效率。
五、理论验证:为什么隐空间递归比文本交互更高效?
论文从运行复杂度和梯度稳定性两个维度,给出了严格的理论证明,解释了为什么隐空间交互的 RecursiveMAS,相比文本交互的多智能体系统拥有本质性的效率优势。
这两个理论结论也正是 RecursiveMAS 设计的底层依据,性能的提升是架构革新带来的必然收益。
5.1 运行复杂度分析:跳过词汇表解码的数量级优势
论文给出了两种方案的运行复杂度对比:
- 文本交互的递归多智能体:$\mathcal{O}(N \cdot m \cdot |\mathcal{V}| \cdot d)$
- RecursiveMAS 隐空间交互:$\mathcal{O}(N \cdot m \cdot d^2)$
其中 $N$ 是智能体数量,$m$ 是隐思考步数,$t$ 是输入长度,$d$ 是隐状态维度,$|\mathcal{V}|$ 是词汇表大小。
两者的核心差异在于交互环节的成本:文本交互每一步都要做词汇表级别的解码,复杂度是 $\mathcal{O}(|\mathcal{V}| \cdot d)$;而 RecursiveMAS 只需要做线性变换,复杂度是 $\mathcal{O}(d^2)$。在实际场景中,隐状态维度 $d$ 通常为几千,而词汇表大小 $|\mathcal{V}|$ 通常为十几万甚至几十万,因此隐空间交互的每一步成本都远低于文本解码。 递归轮次越多,这个优势就越明显。
5.2 梯度稳定性分析:避免递归训练中的梯度消失
论文定理 4.1 给出了梯度稳定性的核心结论:在输出置信度较高的情况下,文本交互的梯度范数趋近于 0,也就是出现严重的梯度消失;而 RecursiveLink 的梯度范数接近 1,可以稳定传播。
可以这么理解,文本经过 softmax 解码后,信息会变得「离散化」,梯度很难再传回去。就像传话游戏,每传一次信息就损失一点,传多了就完全变样了。 而隐空间是连续的,残差连接保证了梯度可以顺畅地一路传回去,递归多少轮都不会消失。
总之,隐空间交互从底层解决了文本中介的两大顽疾:运行时的编解码开销,与训练时的梯度消失。这也是 RecursiveMAS 能够同时实现精度提升、速度加快、token 减少的根本原因。
六、实验结果:横跨 9 大基准的三重性能跃升
研究者在数学、科学、医学、代码生成、搜索问答五大领域的 9 个基准测试上,对 RecursiveMAS 进行了全面验证,覆盖四种主流协作模式,对比了单智能体、传统多智能体、单模型递归等多种基线方案。
实验结果非常扎实:RecursiveMAS 在所有基准上都实现了一致的性能提升,同时带来了显著的效率增益,并且递归深度越深,优势越明显。
6.1 递归深度的缩放效应:越深越强,越高效
论文首先测试了不同递归轮次下的表现,验证缩放效应:
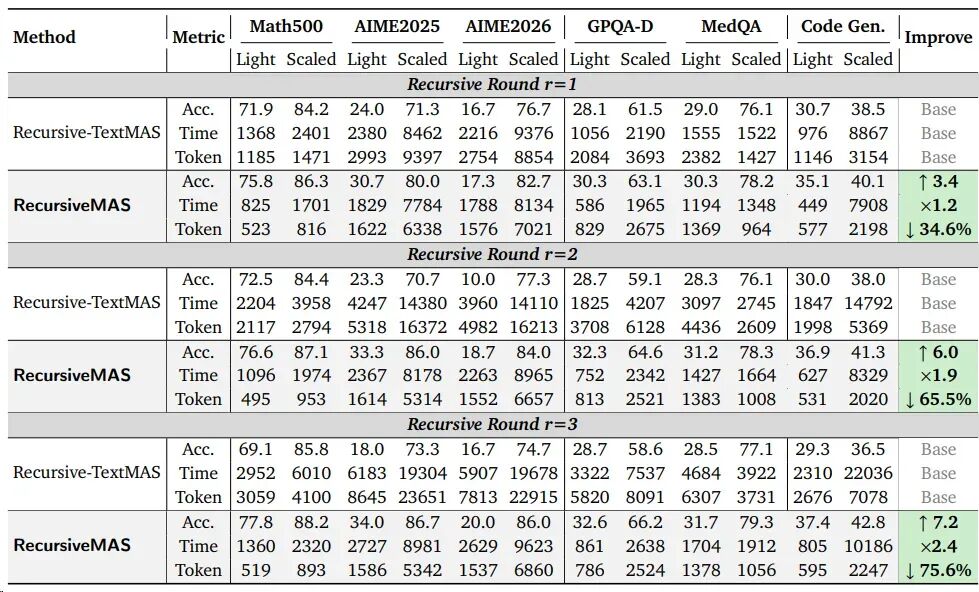
表 2:不同递归轮次下 RecursiveMAS 的核心结果。我们报告了跨领域的准确率、端到端运行时间和总 token 使用量。结果清晰展示了缩放趋势:随着递归轮次从 1 增加到 3,RecursiveMAS 相比文本基线的优势持续扩大。精度方面,从 r=1 时平均领先 3.4%,到 r=3 时平均领先 7.2%;推理速度方面,从 1.2 倍提升到 2.4 倍;token 使用量方面,缩减幅度从 34.6% 提升到 75.6%。这意味着递归深度越深,RecursiveMAS 相比文本基线的优势就越大,呈现出清晰的缩放定律。
图 5 直观展示了推理加速的变化趋势。
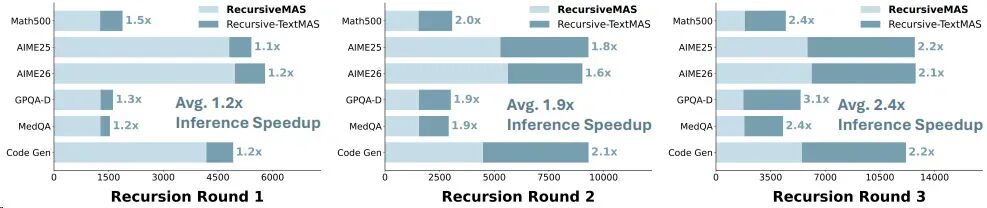
图 5:三轮递归下 RecursiveMAS 的推理加速比。随着递归深度增加,RecursiveMAS 的推理加速效果持续提升。平均来看,r=1 时加速 1.2 倍,r=2 时加速 1.9 倍,r=3 时加速 2.4 倍。递归轮次越多,文本交互的编解码开销就越大,RecursiveMAS 的效率优势就越凸显。
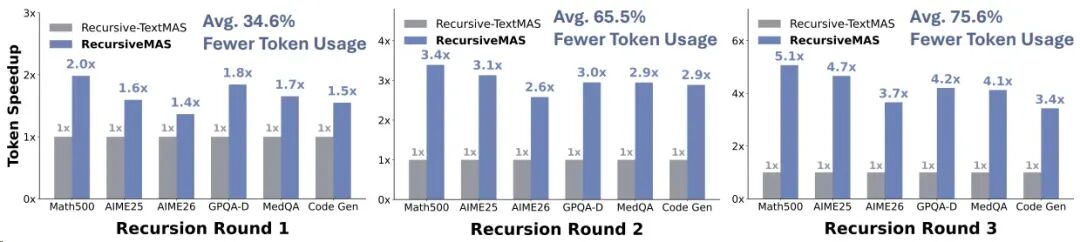
图 6:三轮递归下 RecursiveMAS 的 token 减少量。随着递归深度增加,RecursiveMAS 的 token 节省幅度持续扩大。r=3 时平均减少 75.6% 的 token 使用量,这对于部署成本的降低是巨大的——token 开销直接对应推理成本,减少四分之三的 token 意味着推理成本直接降低四分之三以上。
6.2 与主流方案的横向对比:全面领先
论文进一步将 RecursiveMAS 与多种主流方案进行横向对比,包括单智能体微调、传统多智能体框架、单模型递归等:
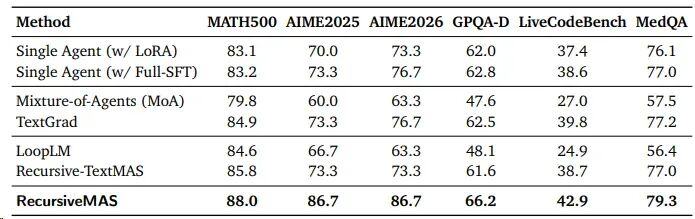
表 3:RecursiveMAS 与其他方法的对比。我们在递归轮次 r=3 下评估 RecursiveMAS,在相同训练预算和模型设置下,RecursiveMAS 始终优于先进的单智能体方法、替代多智能体框架和递归计算基线。
表 3 的结果显示,相比最强基线,RecursiveMAS 平均精度提升 8.3%。尤其在推理密集型任务上优势更显著:AIME2025 上提升 18.1%,AIME2026 上提升 13.0%,GPQA-D 上提升 5.4%。这说明隐空间递归对于需要深度思考的复杂任务,提升效果更加明显。
6.3 跨协作模式的通用性:四种架构全部生效
论文在顺序式之外,还测试了混合式、蒸馏式、审议式三种协作模式,验证 RecursiveMAS 的通用性:
| 协作模式 |
性能提升幅度 |
| 混合式 |
比最强领域专家平均提升 6.2% |
| 审议式 |
比原始工具调用智能体提升 4.8% |
| 蒸馏式 |
比小模型学习者提升 8.0%,同时比大模型专家快 1.5 倍 |
这说明 RecursiveMAS 是一种通用的系统级缩放范式,可以适配各种主流多智能体结构。
6.4 训练成本分析:更低成本,更高效果
论文还对比了不同训练方案的成本与效果:
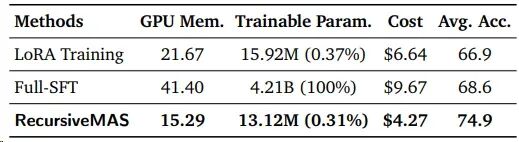
表 5:RecursiveMAS 成本分析。我们报告了峰值 GPU 显存使用量、可训练参数数量、预估成本和所有下游任务的平均准确率。
表 5 的结果显示,RecursiveMAS 的训练成本是所有方案中最低的:可训练参数仅 13.12M,占总参数的 0.31%,GPU 显存仅 15.29GB,预估成本 4.27 美元。但它的准确率却是最高的,达到 74.9%,远超 LoRA 训练的 66.9% 和全量微调的 68.6%。 这是极高的投入产出比——只用不到百分之一的参数和不到一半的成本,换来远超全量微调的效果。
七、总结与展望:系统级递归的产业意义与未来方向
RecursiveMAS 的核心贡献,是将递归缩放的范式从「单模型内部」推广到了「多智能体系统级」,用隐空间交互打破了文本中介的效率瓶颈,为多智能体系统的规模化提供了一条全新的技术路径。
它的意义在于提出了一种全新的系统设计思路:多智能体系统应该是一个统一的、可以端到端优化的递归计算整体。
从产业角度看,RecursiveMAS 带来的价值非常直接。
| 产业价值 |
说明 |
| 推理成本大幅降低 |
75.6% 的 token 减少对于大规模部署多智能体应用的企业来说,意味着直接的成本下降,同时 2.4 倍的速度提升还能显著提升用户体验。 |
| 训练门槛大幅降低 |
只需要训练轻量的 RecursiveLink,不需要微调大模型,就能实现系统级的性能提升,中小企业也能落地多智能体优化。 |
| 异构模型无缝协作 |
不同厂商、不同尺寸、不同架构的模型,都可以通过 RecursiveLink 在隐空间对接,不用考虑接口和格式问题。 |
未来,隐空间递归的思路还有很多拓展方向。更复杂的多智能体拓扑,比如图结构、层次结构的多智能体系统,都可以用这套思路优化;结合模型量化与压缩技术,RecursiveLink 本身很轻量,可以进一步提升部署效率;甚至在端侧设备上,也有可能运行轻量化的多智能体系统。
回顾一下,RecursiveMAS 用一个极其轻量的模块,实现了多智能体系统在精度、速度、成本三个维度的同时优化,本质是用隐空间的连续计算替代了文本的离散交互。这很可能成为下一代多智能体系统的基础架构方向,底层交互介质的改变,会带来整个系统能力的跃迁。
对多智能体与隐空间协作感兴趣的读者,欢迎访问云栈社区获取更多技术深度解析。
 发表于 半小时前
|
查看: 2|
回复: 0


