现有的 Coding 多智能体框架——Codex sub-agent、Claude Code agent teams、Copilot fleet、Kimi Agent Swarm——全都绕不开一个角色:中心编排器。任务分得好不好、worker 管不管得过来,全看它的脑容量。系统能扩到多大,天花板就是编排器能管多少人。
微软这篇《Agensh》的选择是:把编排器砍了。1024 个 agent 没有老板,靠一套自组织协作循环(Cooperation Loop)加三件基础设施,6 小时断网从零重建 pandoc,测试通过率从单 agent 的 33.89% 干到 55.06%。
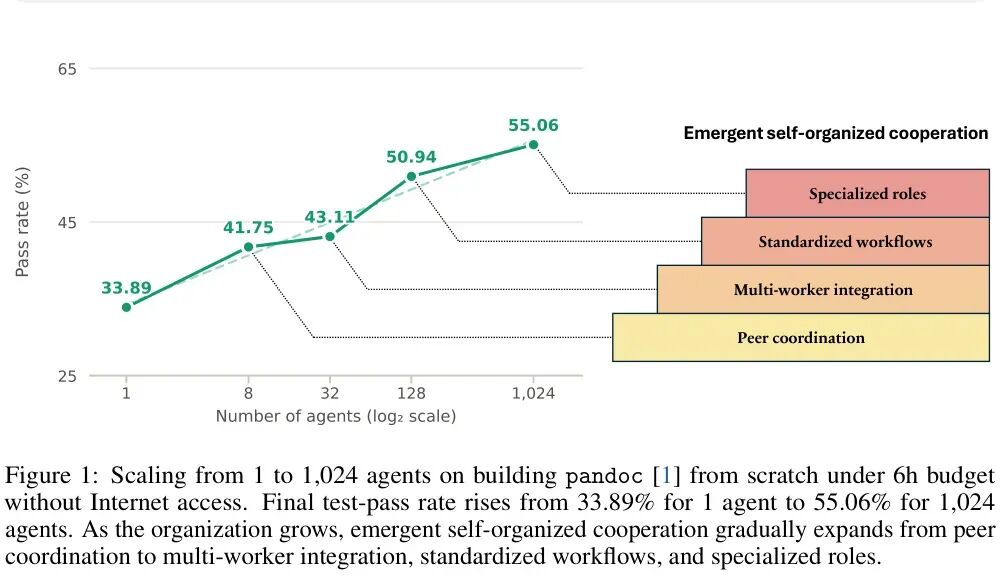
图1:pandoc 任务从 1 到 1024 个 agent 的扩展曲线,以及随规模涌现的自组织合作形态
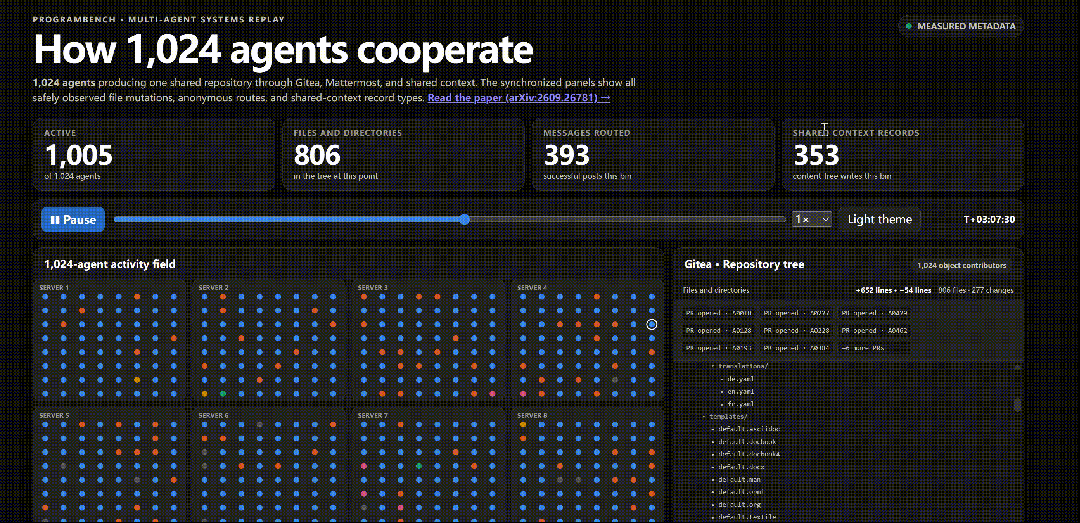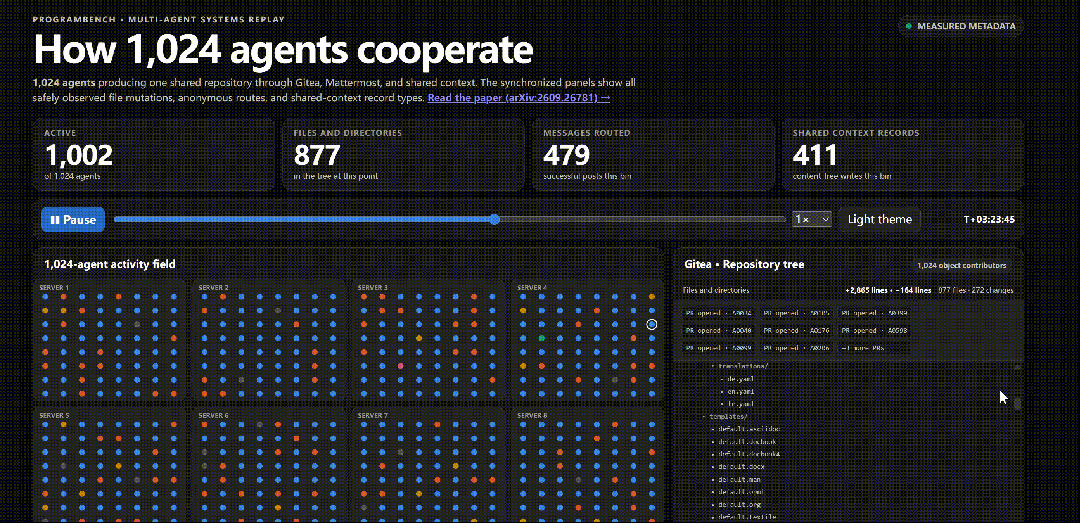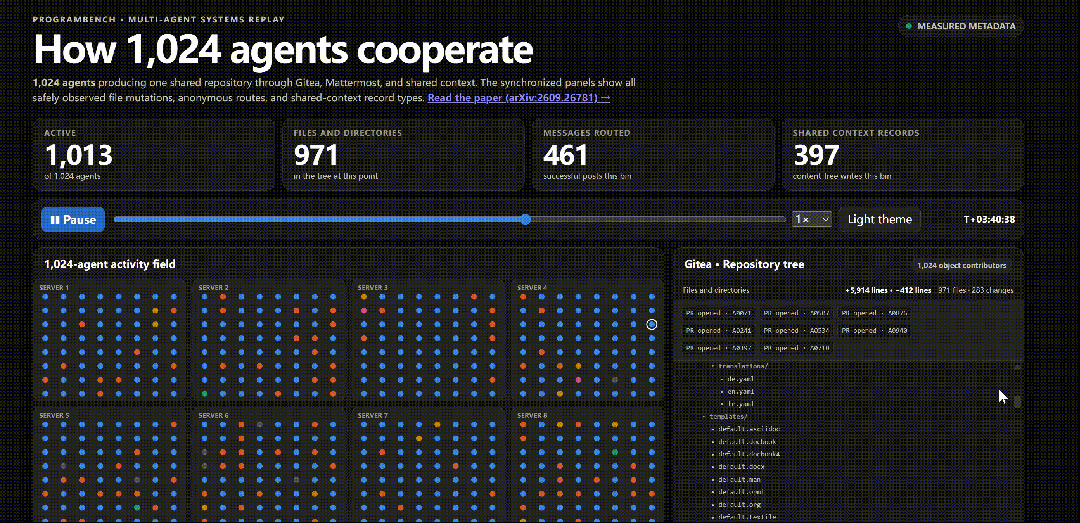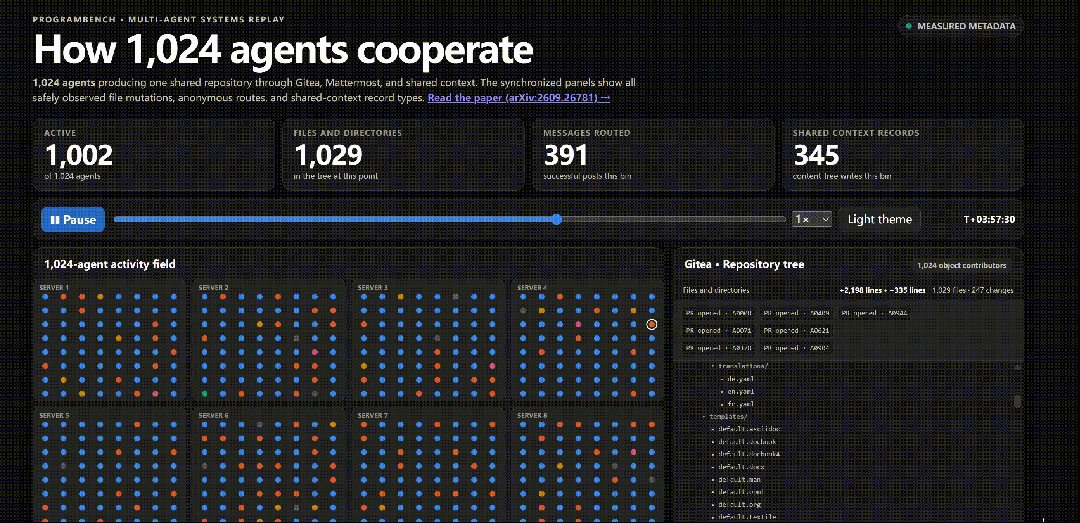
砍掉编排器,自己组织
先看范式对比。左边是旧的:编排器负责规划、分解、派活、整合,worker 只是执行手脚。这套结构还有两个隐形成本——编排器往往得专门训练,而且它的管理能力就是整个系统的规模上限。
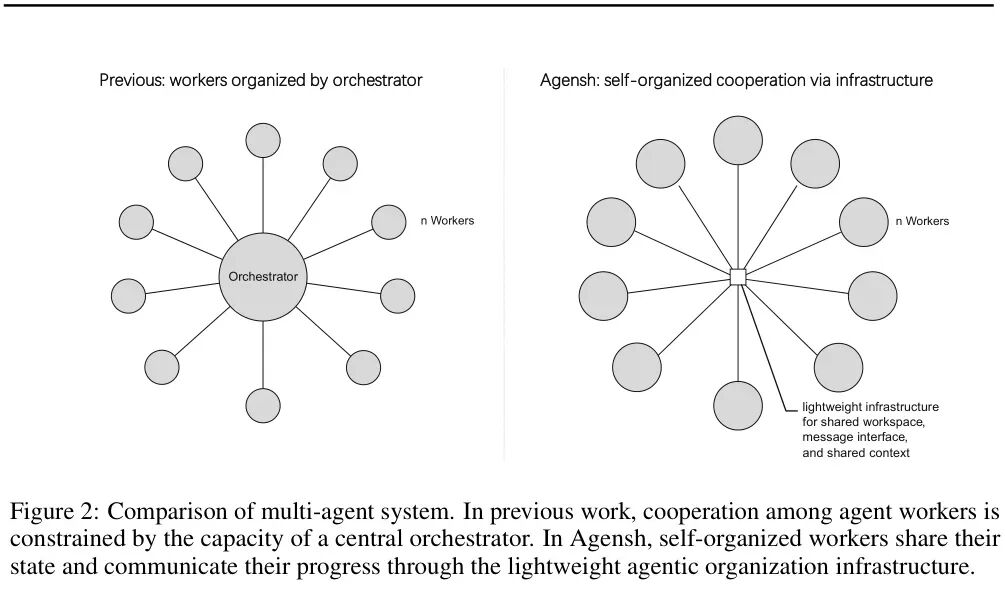
右边是 Agensh:没有中心节点,worker 之间通过一套轻量基础设施共享状态、广播进度、互相协调。任务发现和分配这件事,由 worker 群体自组织完成。
五步循环:没有老板,活怎么分
砍掉老板之后,第一个问题是活谁来分。Agensh 的答案是一个每个 worker 都在跑的五步协作循环:
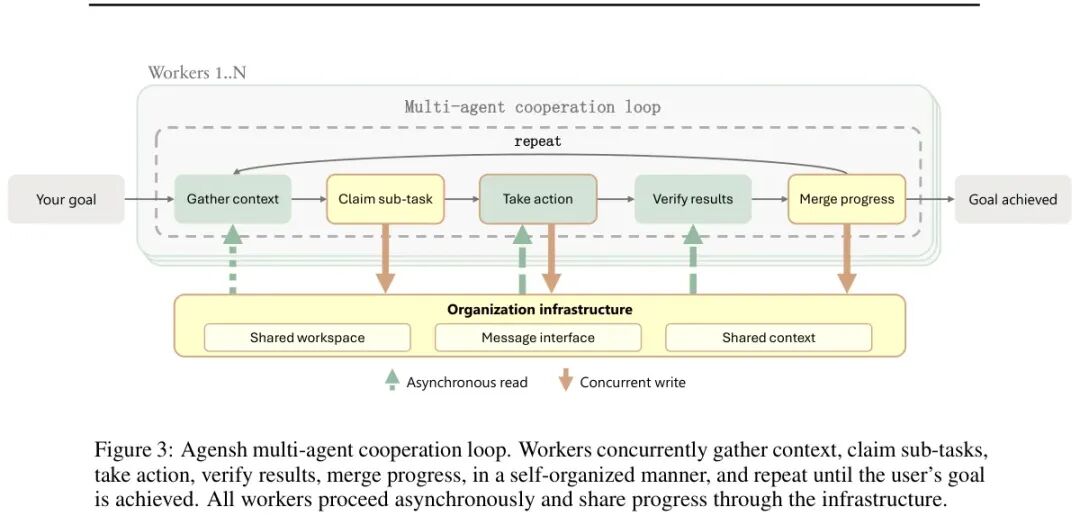
图3:Agensh 多智能体协作循环(Multi-Agent Cooperation Loop)——收集上下文、认领子任务、执行、验证、合并,异步重复
- Gather context:读共享目标、看同伴进度和留言,搞清楚什么做完了、什么还空着;
- Claim sub-task:自己提议一个子任务,往共享上下文里写一条 CLAIM 宣布认领;撞车了就用直消息私聊解决;
- Take action:本地干活,过程中一旦发现对同伴有用的结论,立刻广播出去;
- Verify results:对照验收标准自查,不达标就改到达标;
- Merge progress:合并进共享工作区,发布改动说明和验证证据;合并冲突就先同步同伴成果、解冲突、再合。
全程异步,谁也不等谁。循环跑完回到第一步,找下一块活。
三件套:Git 当办公室,聊天软件当走廊
循环要转起来,靠的是三件基础设施,而且全是现成的开源件:
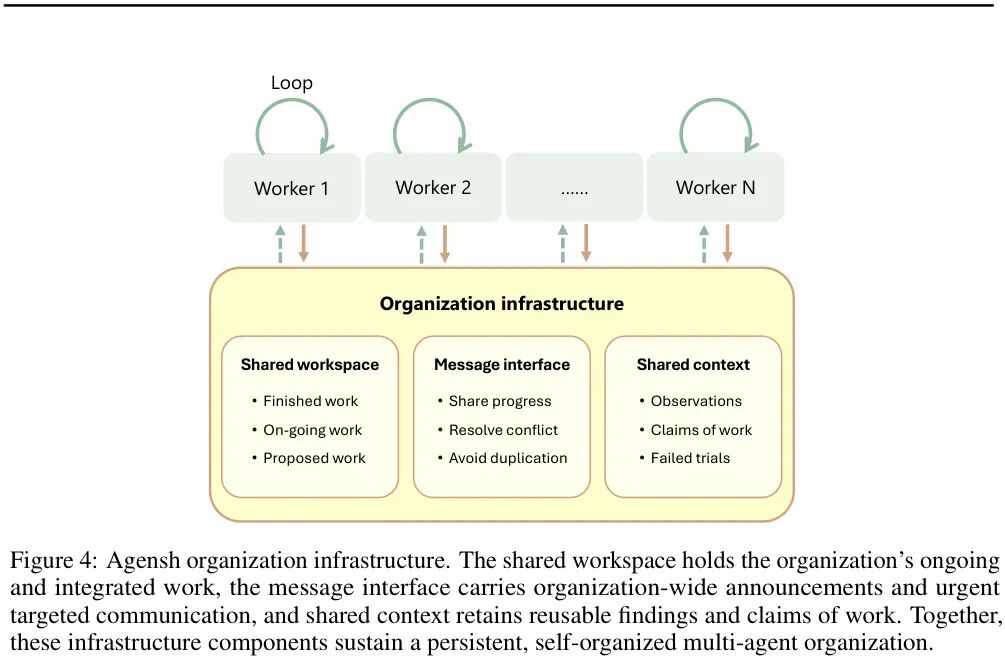
图4:Agensh 组织基础设施——共享工作区、消息接口、共享上下文
- 共享工作区 = Gitea。组织的工作成果全在 Git 里:私有分支干活,PR 合主干,冲突检测、版本历史、issue 一应俱全;
- 消息接口 = Mattermost。频道承载团队公告,直消息用于紧急一对一——直消息能插队送进对方当前回合,是平息撞车的快车道;
- 共享上下文 = 借鉴 DeLM 的上下文板。worker 发布五种短条目:OBSERVED(观察到的行为)、FACT(确认的事实)、FAIL(证伪的方案,最值钱,直接帮全组避坑)、CLAIM(认领声明)、PATCH_SUMMARY(改动摘要)。板子是 append-only 的,还配了 grep 工具翻全量历史。
最妙的是实现方式:协作循环不写死在运行时里,而是写在每个 worker 的 prompt 里。1024 个 worker 用同一份 prompt,只差 worker ID。底层单 agent harness 可插拔——实验里用的是 Copilot,换 Claude Code 只需一个轻量适配器。
实验:拿五个最难的软件开刀
考场是 ProgramBench:给一个编译好的参考二进制,断网,6 小时预算,从零重建出能通过隐藏测试的完整代码库。选了全基准最难的五道题,参考仓库都是怪物级:
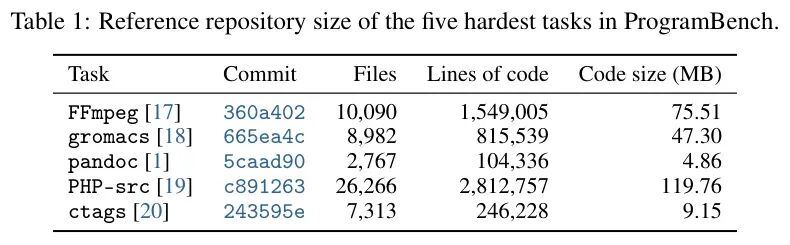
表1:ProgramBench 五个最难任务的参考仓库规模
PHP-src 两万六千个文件、281 万行代码,FFmpeg 也有 155 万行。模型统一 GPT-5.6-sol(high),底层 harness 统一 Copilot,唯一变量是 agent 数量。
结果:1 → 8 → 32 → 128 个 agent,五题平均最终通过率 19.31% → 20.68% → 26.52% → 28.78%,相对提升约 49%。pandoc 一题继续推到 1024 个:33.89% → 50.94%(128 个)→ 55.06%(1024 个)。
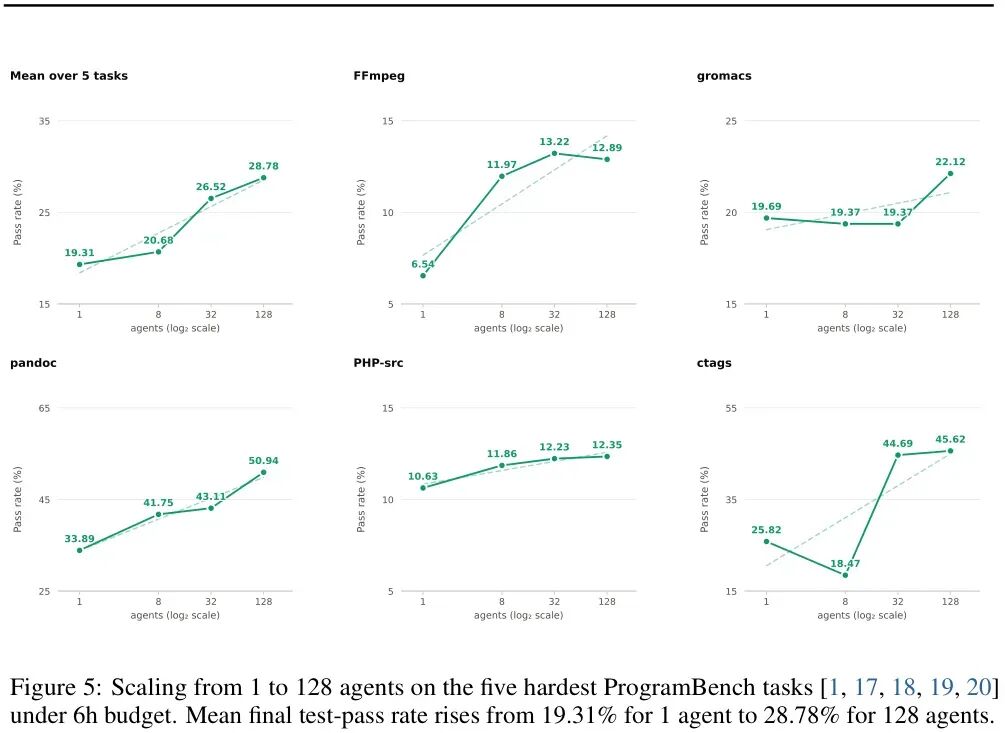
图5:五个最难任务上从 1 到 128 个 agent 的最终通过率
不只更高,还更快
前两个小时的曲线更有意思:大组织更早达到同等水平。pandoc 上 30% 通过率这条线,128 个 agent 在 30 分钟就跨过去了,32 个要 60 分钟,8 个要 90 分钟,单 agent 两小时内始终没摸到。
也就是说,agent 数量同时买到了两样东西:最终质量,和到达质量的速度。对有硬时限的任务,这是双重利好。
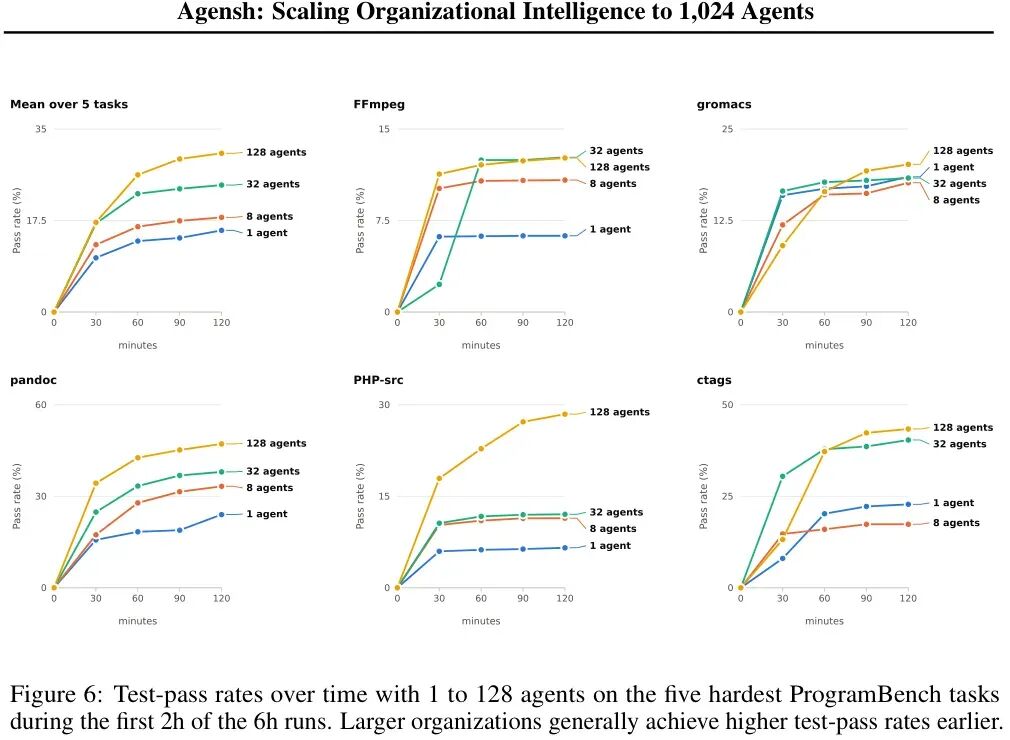
图6:前五题 2 小时内通过率随时间变化,大组织更早到达同等水平
论文信息:
Agensh: Scaling Organizational Intelligence to 1,024 Agents
arXiv:2406.16781
 发表于 1 小时前
|
查看: 4|
回复: 0


