TypeSafe 的决策模型 Jev 发布之后,谁也没料到,一周之内 arXiv 上标题带 Jev 的论文就冲到了 21 篇,GitHub 上新增 1,865 个项目。这个不写字、只做决定的模型,正在变成 Agent 系统的标配零件。
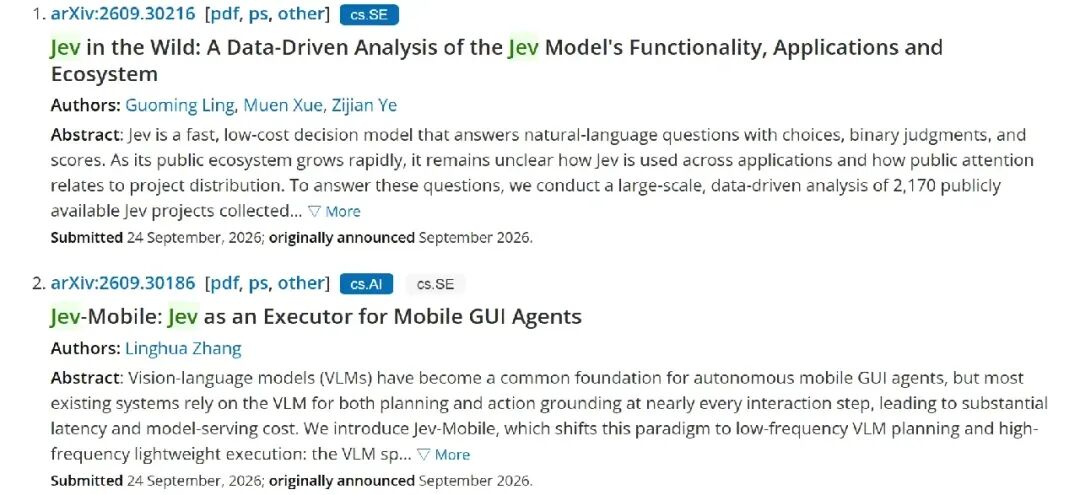
一周 21 篇:Jev 论文全景
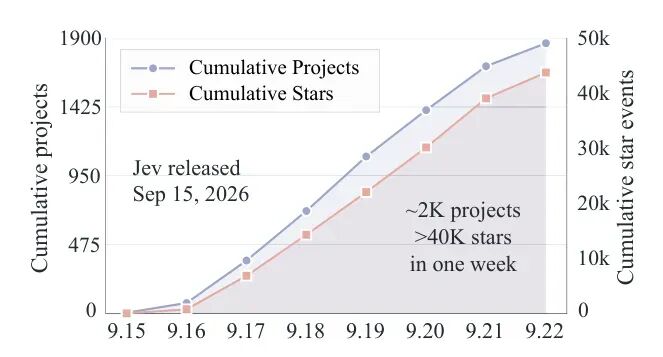
中山大学的《Jev in the Wild》扒了 2,170 个公开项目,发现属性判断和打分是用得最多的两类用法。有趣的是,关注度并不跟着项目数量走:star 集中在路由和接口代理,大家真正围观的是拿 Jev 当调度器的玩法。
21 篇论文粗粗一分,四个方向一目了然:
| 方向 |
代表论文 |
一句话看点 |
| 评测裁判 |
JEV-as-a-Judge、JEV vs. LLMs as Rubric Judges、放射科报告裁判 |
当裁判,成本是 LLM 的零头 |
| Agent 系统 |
Jev-Mem、REFLEX、Jev-Mobile、JEV-Star |
给 Agent 当反射弧 |
| 行业落地 |
德州车祸编码、诈骗电话筛查、6G 边缘编排、渗透测试 |
真刀真枪省钱 |
| 生态与安全 |
Jev in the Wild、Decision Hijacking、KITE、NumericJev |
生态爆发,攻击面跟着来 |
亮点数字先过一遍
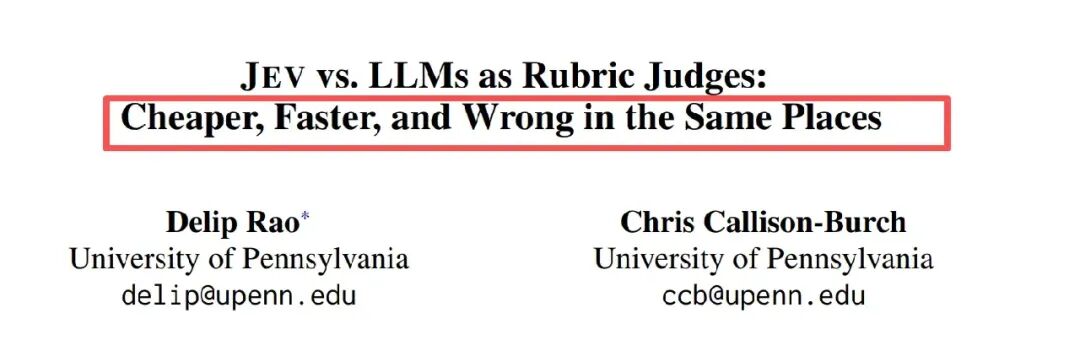
《JEV vs. LLMs as Rubric Judges》给出了一组扎眼的对比:LLM 裁判贵 29 到 325 倍、慢 30 到 220 倍,而且错的地方和 Jev 几乎一样。
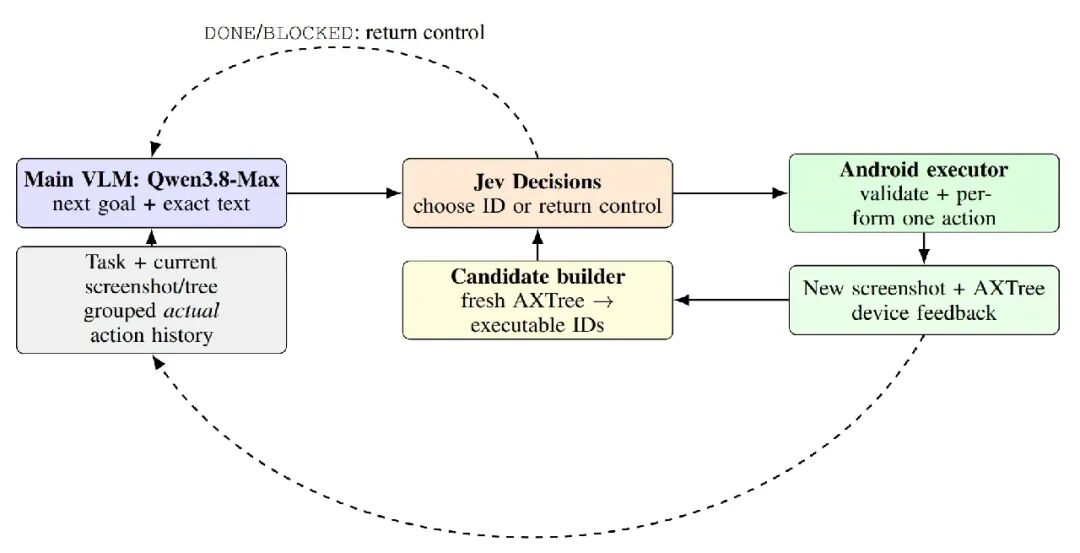
Agent 方向更热闹。Jev-Mobile 在 AndroidWorld 拿下 79% 成功率,API 成本砍掉 73.4%。
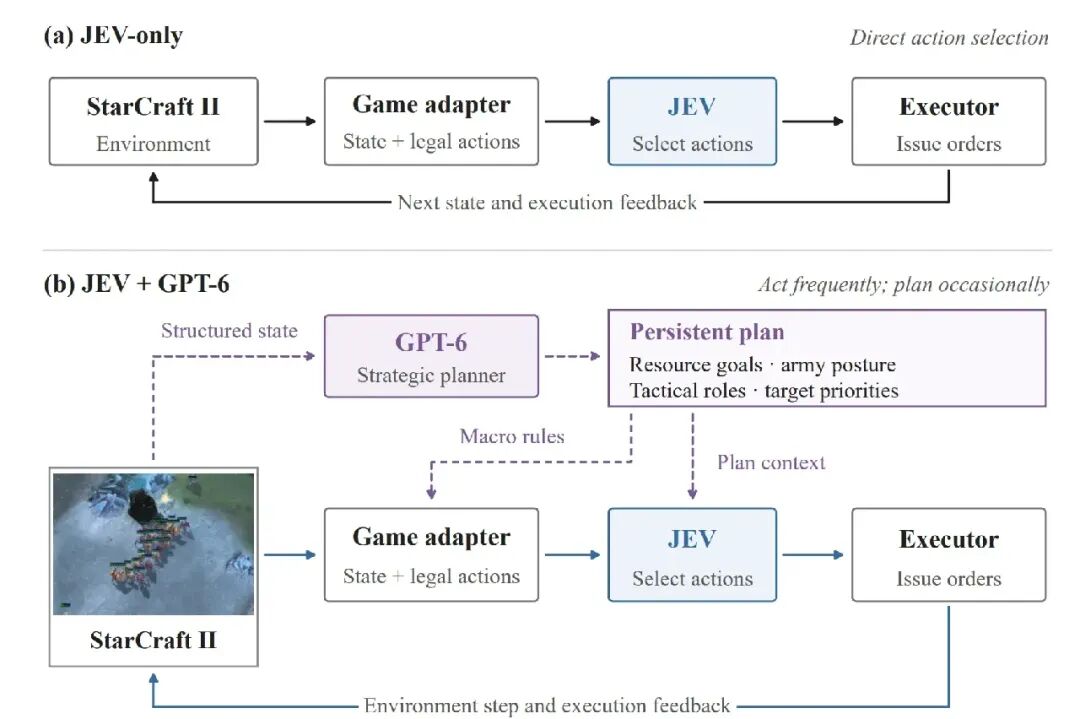
JEV-Star 让 GPT-6 做规划、Jev 做执行,打赢了星际争霸 II 内置最强 AI,每局只花 3.71 美元。KITE 让一百万个智能体跑 20 步只要 0.9 秒。
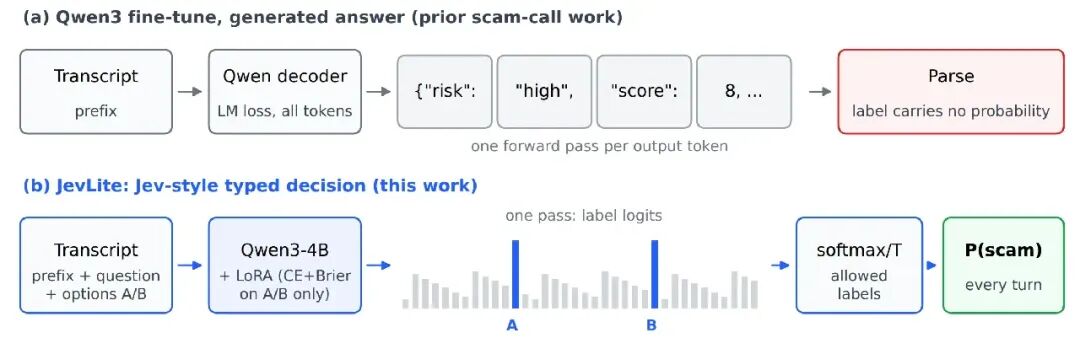
行业落地那几篇同样硬核。诈骗电话筛查用 4B 小模型微调,每轮 64.5 毫秒给出欺诈概率,AUROC 0.974,合法电话零误报。
当然也有人泼冷水。《Decision Hijacking》对 Jev 做提示注入,自适应攻击把成功率从 1.8% 抬到 3.5%。
JEV-as-a-Judge——自信的留下,没底的上报
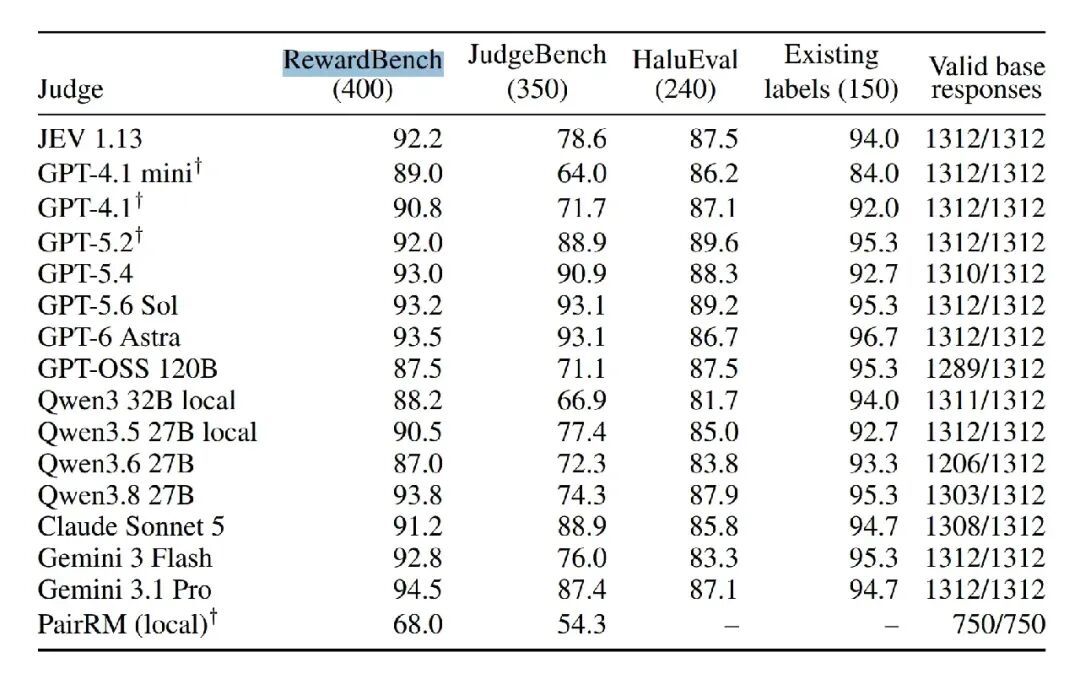
CMU 这篇算是整波论文里分量最重的评测。研究者把 Jev 和 16 个生成式裁判、奖励模型放在同一套合同下,跑了 1,312 道题,意见分歧的部分还请了盲审人工仲裁,直接堵死了"标签噪声"的借口。
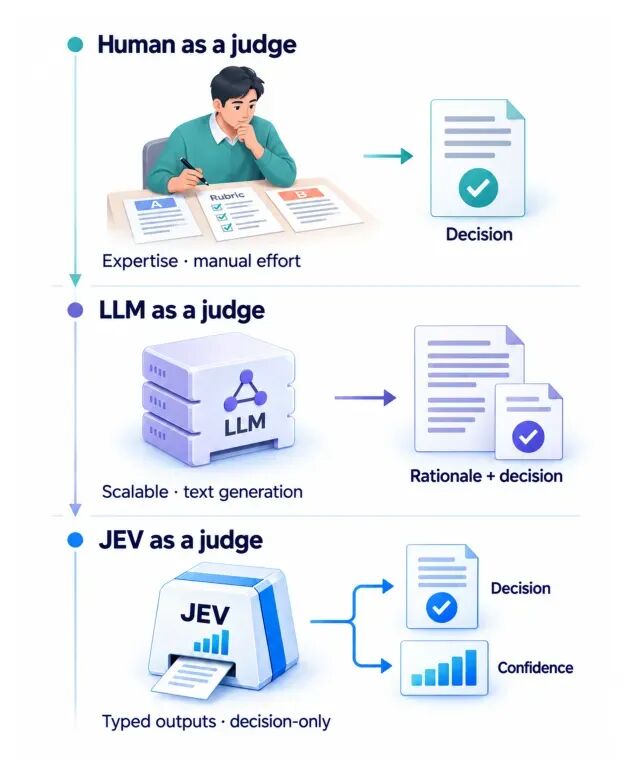
结论一句话:日常偏好和有证据撑腰的事实判断,Jev 和最强裁判 GPT-6 差距不到 3 个点,费用只有对方的 0.36%。
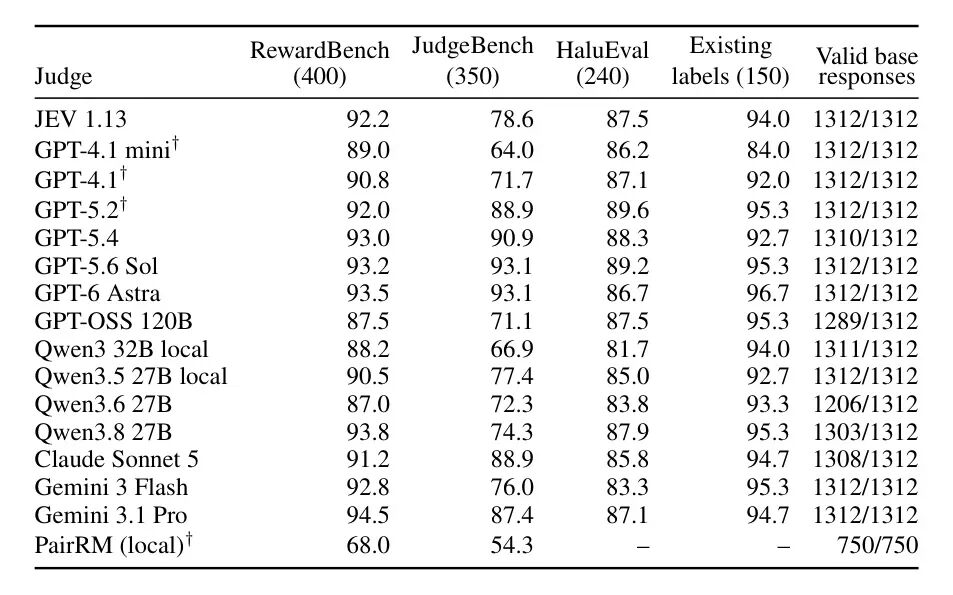
短板同样清楚。需要验算多步推导的 JudgeBench 上,Jev 落后 14.6 个点,推理子项 68.4 对 95.9。遇到"包装精美的错误答案",RM-Bench 困难对上差距拉到 19.8 个点——选得对和扛得住忽悠,是两种能力。
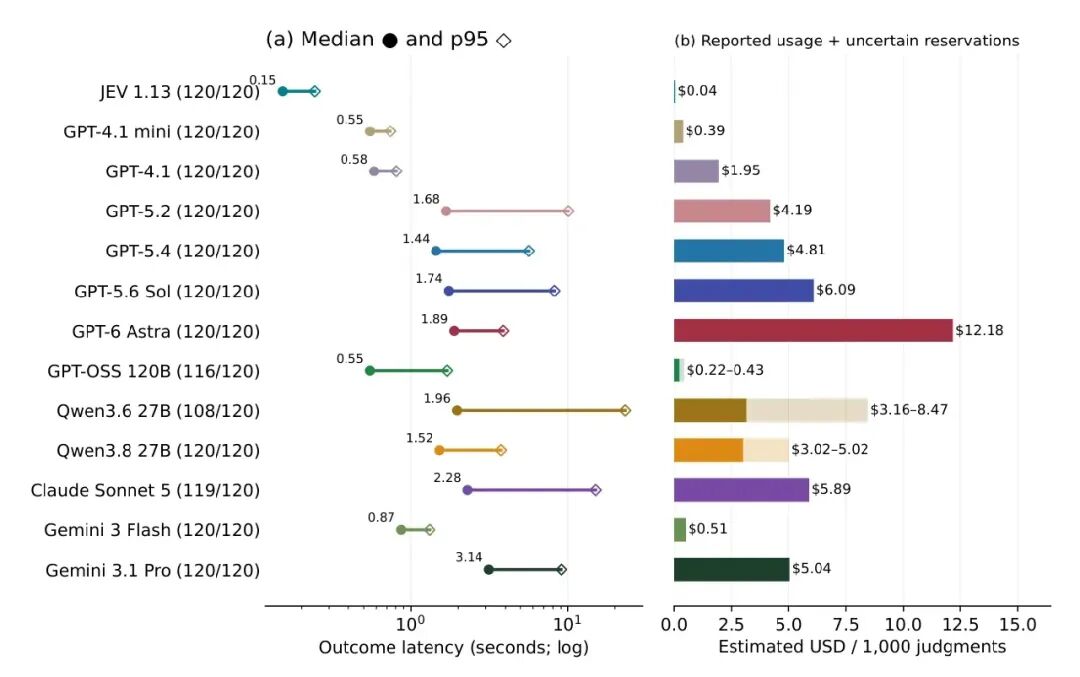
费用和延迟才是真正的杀手锏。Jev 中位延迟 0.152 秒、每千次判断 0.044 美元;GPT-6 是 1.885 秒、12.182 美元。便宜 277 倍,这就是"经济首筛"的底气。
全文精华是级联。Jev 自带置信度 q(最高标签概率):q 等于 1 时 99.1% 正确,q 低于 0.6 只剩 47.7%。拿 q 当闸门,自信的直接接受,没底的升级给 GPT-6。
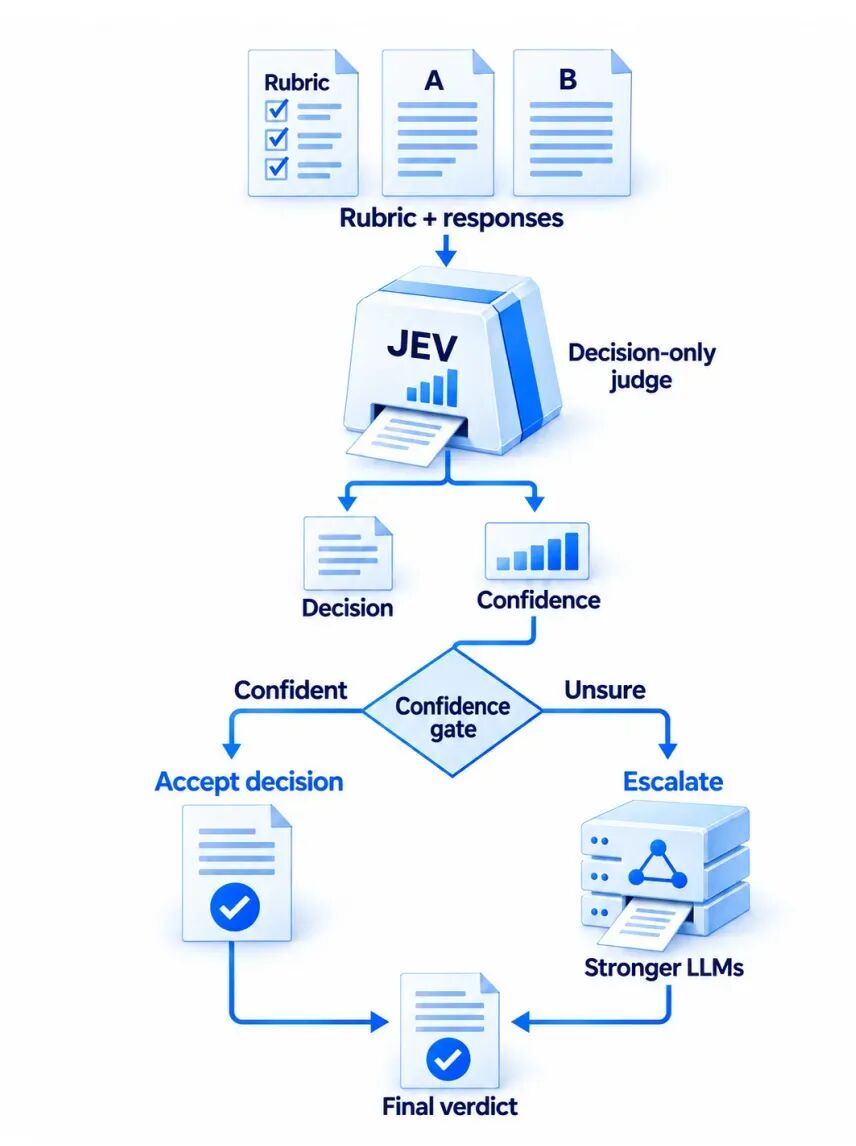
数字相当漂亮:阈值 0.9 时只升级 34% 的题,准确率 91.3% 对 GPT-6 的 91.7%,费用只有 47%。在 RewardBench 上级联甚至反超单用 GPT-6,94.0% 对 93.5%,只花 22% 的钱——因为两个裁判错的题不一样。
Jev-Mem——给 Agent 记忆装上系统一
UT Dallas 这篇解决的是另一个痛点:现在的 agentic memory 用自回归 LLM 管记忆的存、取、停,生成压在关键路径上,又慢又贵。
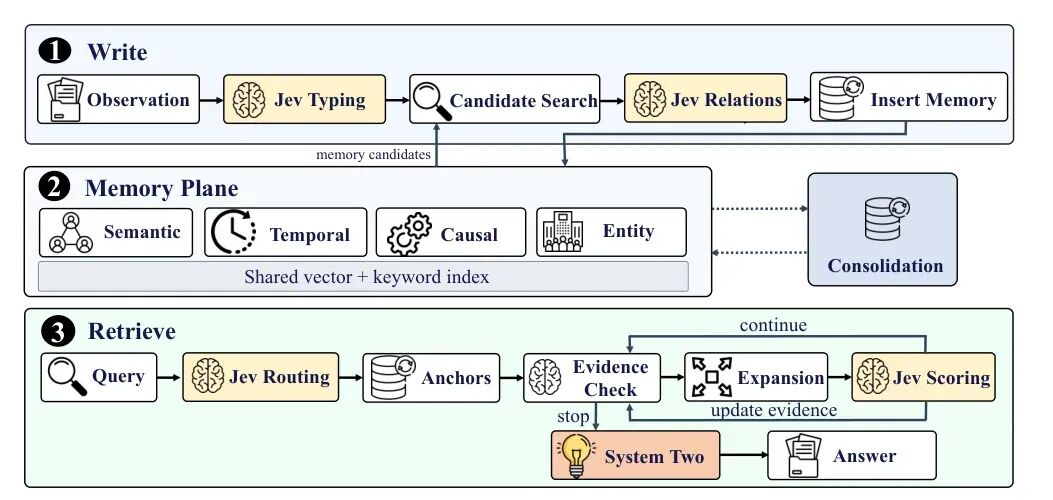
思路借自双系统认知。系统一(Jev)做高频结构化决策,系统二(LLM)只做复杂推理和答案合成。写路径上,Jev 给记忆打情节、语义、程序、偏好四类标签,先由确定性检索圈出至多 Kw 个候选,再判断语义、因果、实体关系,概率过阈值才连边。
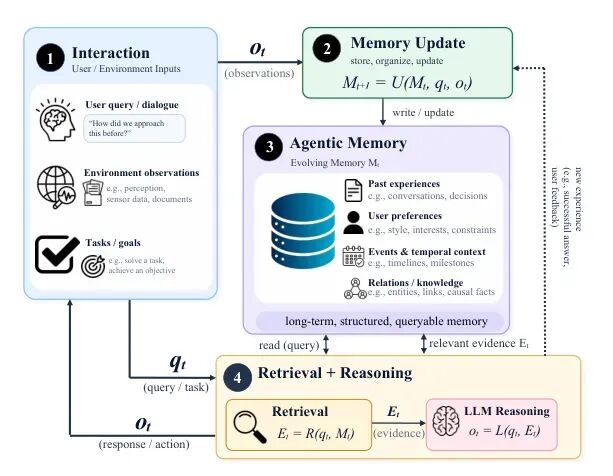
读路径上,它预测该查哪几张关系图、分配检索预算、逐轮评估证据够不够——不够就扩图,够了就停。
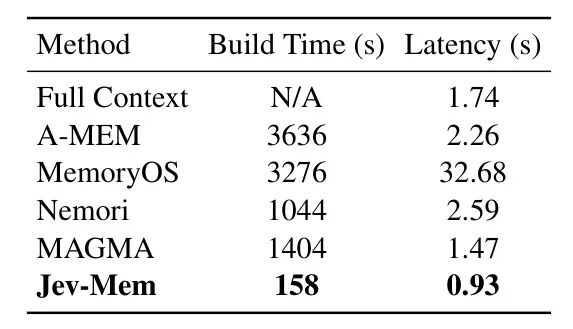
两个设计细节值得细品。一是写入时不做不可逆的取舍,原始观察全部保留,选择性只体现在建边和检索上。二是控制开销有硬上限:一次写入最多两批 Jev 调用,一次查询每轮最多一次证据评估加一次候选打分,图扩展、访问节点、深度、耗时全部设限。
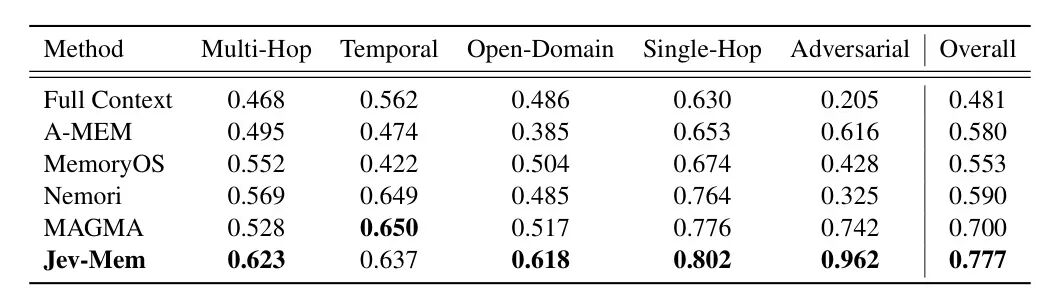
效果最能打的是对抗类问题,0.962 对 0.742,直接碾压最强 baseline MAGMA,总分 0.777,相对提升 11.0%。
最后
一个生成模型包打天下正在退潮。决策被拆出来,成为独立的一层,系统一和系统二的分工成了新范式——裁判、记忆、路由、执行,全是同一个配方。对这类技术动态感兴趣的开发者,也可以来云栈社区一起聊聊。
 发表于 2 小时前
|
查看: 3|
回复: 0


