没有术语堆砌,没有废话。这里只介绍你在每次 AI 工程面试和每次 PR review 中都会听到的词,并用我希望自己当初听到的方式解释它们。
我记得有一次开会时,有人说:“在接触 harness 之前,我们需要更好的 context engineering。”我点头表示理解。
老实说,我当时并不明白。
回家后,我花了两个小时才弄清楚自己刚刚答应了什么。
现在学习 AI 的人几乎都会遇到这种情况。
这个领域发展得很快,词汇发展的速度更快,而大多数解释都默认你已经知道他们用来解释另一半术语的其中一半。
所以,这里列出了 12 个会出现在实际工作中的术语:面试中、pull request 描述中,以及凌晨 2 点某个东西出故障时的 Slack 消息中。
这不是教科书式的术语表,而是人们实际使用的词。
我把它们分成了四个阶段,因为项目大致就是按照这个顺序,从“一个能回答问题的 chatbot”成长为真正有人依赖的系统。
阶段 1:模型本身处理的内容
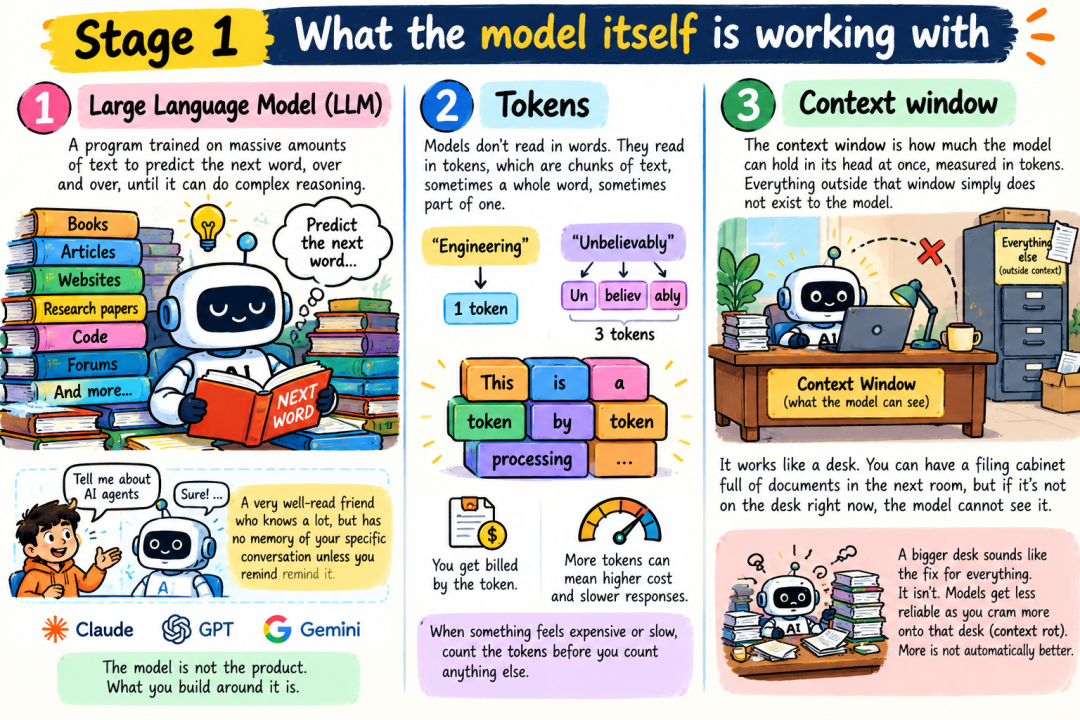
1. Large Language Model (LLM)
这是引擎。
Large Language Model(大语言模型)是一种经过海量文本训练的程序,它不断学习预测下一个词,直到这种预测表现得像推理一样。
可以把它想象成一位博览群书的朋友:它几乎什么都读过,但除非你提醒它,否则它不会记得你们具体聊过什么。每次与它对话时,你都相当于从头开始,除非你把之前的内容提供给它。
Claude、GPT 和 Gemini 都是大语言模型。模型本身不是产品。你围绕模型构建的东西才是产品,而这正是本文其余大部分内容所讨论的。
2. Tokens
模型不是按单词阅读的。
Tokens 是文本中的小片段,例如字符、单词的一部分、完整单词或标点符号,大语言模型使用它们来处理和生成语言。
模型读取的是 tokens,也就是文本片段;有时是一个完整单词,有时只是一个单词的一部分。
“Engineering” 可能是一个 token。“Unbelievably” 可能会被拆成三个 token。你的费用按 token 计费,模型的记忆容量也以 tokens 衡量,所以当你第一次收到意外账单时,这就不再是无关紧要的知识了。
当某件事感觉成本高或速度慢时,先计算 tokens,再考虑其他因素。
3. Context window
Context window(上下文窗口)是以 tokens 衡量的最大文本量,大语言模型在一次交互中能够读取、记忆和引用这些文本。
无论某些内容有多重要,只要超出这个窗口,对模型来说就等于不存在。
它就像一张桌子。Context window 就是这张桌子的大小。你可以在隔壁房间里放满文件的档案柜,但如果文件现在没有放在桌上,模型就看不到它们。
更大的桌子听起来像是一切问题的解决方案,但事实并非如此。关于如今所谓 context rot 的研究表明,即使桌面上的内容没有任何错误,随着你把更多内容塞到桌上,模型的可靠性也会下降。更多内容并不一定更好。
阶段 2:如何向模型提供外部知识
4. Embeddings
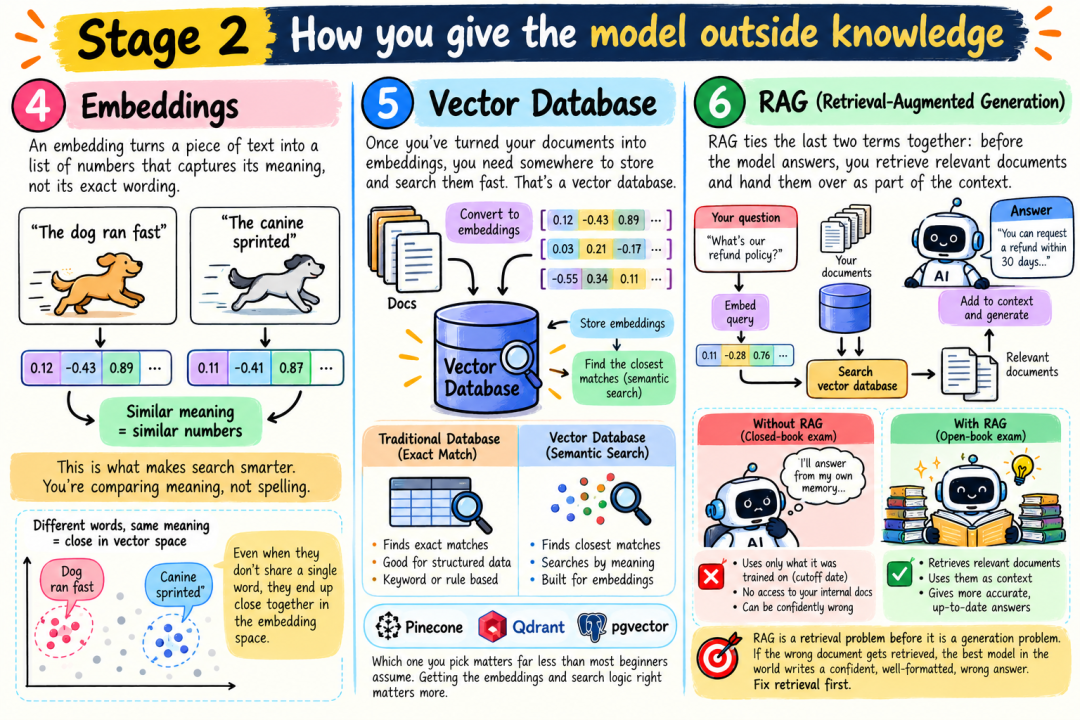
Embedding 会把一段文本转换为一组能够捕捉其含义、而非确切措辞的数字。
含义相近的文本最终会得到相近的数字,即使它们没有共享任何一个单词。“The dog ran fast”和“the canine sprinted”在这个数字空间中会彼此接近,因为经过 embedding 生成训练的模型学会了它们大致表达相同的含义。
这就是搜索能够超越关键词匹配的原因。你比较的是含义,而不是拼写。
5. Vector database
将文档转换为 embeddings 后,你需要一个地方来存储这些数字列表,并快速搜索它们。这就是向量数据库。
普通数据库用于查找精确匹配,而向量数据库用于查找最接近的匹配,也就是那些 embeddings 在含义空间中最接近你的问题 embedding 的文档。
Pinecone、Qdrant 和 pgvector 是招聘信息中常见的几种选择。你选择哪一个,重要性远没有大多数初学者想象的那么高。更重要的是正确处理 embeddings 和搜索逻辑。
6. RAG (Retrieval-Augmented Generation)
RAG 是连接前面两个术语的模式:在模型回答之前,先检索相关文档,并将它们作为上下文的一部分交给模型。
这就像开卷考试和闭卷考试之间的区别。
- 没有 RAG 时,模型只能依靠记忆回答问题,而它的记忆有截止日期,也不知道你公司的内部文档中有什么。
- 使用 RAG 时,你会在模型回答之前,把它需要的具体页面交给它。
RAG 首先是一个检索问题,其次才是生成问题。如果检索到了错误的文档,那么即使是世界上最好的模型,也会写出一个自信、格式良好但错误的答案。先修复检索。
阶段 3:模型如何采取行动,而不只是对话
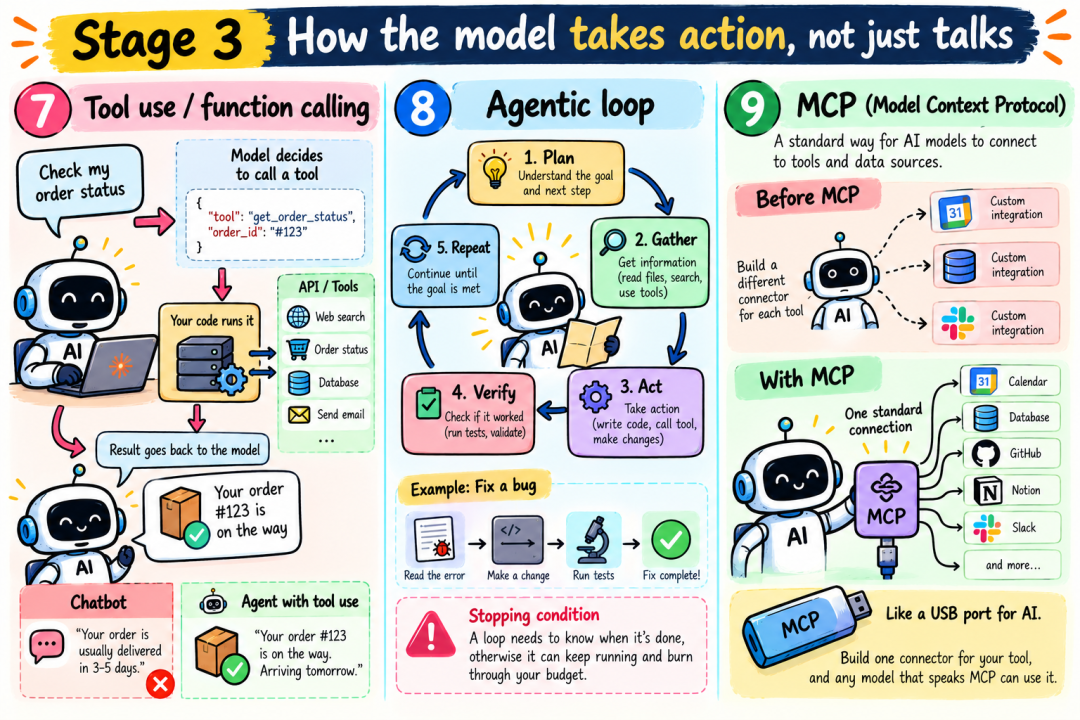
Tool use 让模型能够执行生成文本之外的操作。
你可以描述一个允许模型调用的函数,例如“搜索网页”或“查询订单状态”,然后模型就能决定调用该函数并使用其结果。
可以把它想象成给你的 AI Model 装上双手。
模型本身永远不会直接接触你的数据库或 API。它会以结构化格式请求某项具体操作,由你的代码执行该操作,然后将结果返回模型的上下文。模型负责提出请求,你的代码负责执行。
这就是 chatbot 和 agent 之间的区别。Chatbot 可以谈论你的订单,而具备 tool use 的 agent 可以实际查询订单。
8. Agentic loop
Agentic loop 是 agent 自主运行的循环:收集信息、采取行动、检查行动是否成功,然后重复这一过程,而不需要人在每一步都输入新的指令。
Anthropic 自己的工程团队对它的描述很简单:收集上下文、行动、验证、重复。
模型读取文件、进行修改、检查结果,然后自行决定下一步该做什么,并根据任务需要持续运行多个回合。
一个良好的循环与失控循环之间的区别,在于停止条件。一个不知道何时完成或何时失败的循环,最终会用消耗预算的方式让你付出代价。
9. MCP (Model Context Protocol)
MCP 是一种标准方式,使 AI 模型能够连接外部工具和数据源,而不必让每家公司为每个工具编写定制的 glue code。
它由 Anthropic 于 2024 年 11 月推出。
在 MCP 出现之前,将模型连接到你的日历、数据库和 ticketing system,意味着需要三个不同的定制集成,而且每个集成都只适用于特定的模型提供商。
MCP 就像 AI 的 USB port:为你的工具构建一个 connector,任何支持 MCP 的模型都可以使用它。
它很快就接近成为一种标准,这也是为什么你在 2026 年看到的几乎每一份 AI engineering 职位描述中,都会在靠前的位置看到它。
阶段 4:如何确认系统正在正常工作
10. Evals
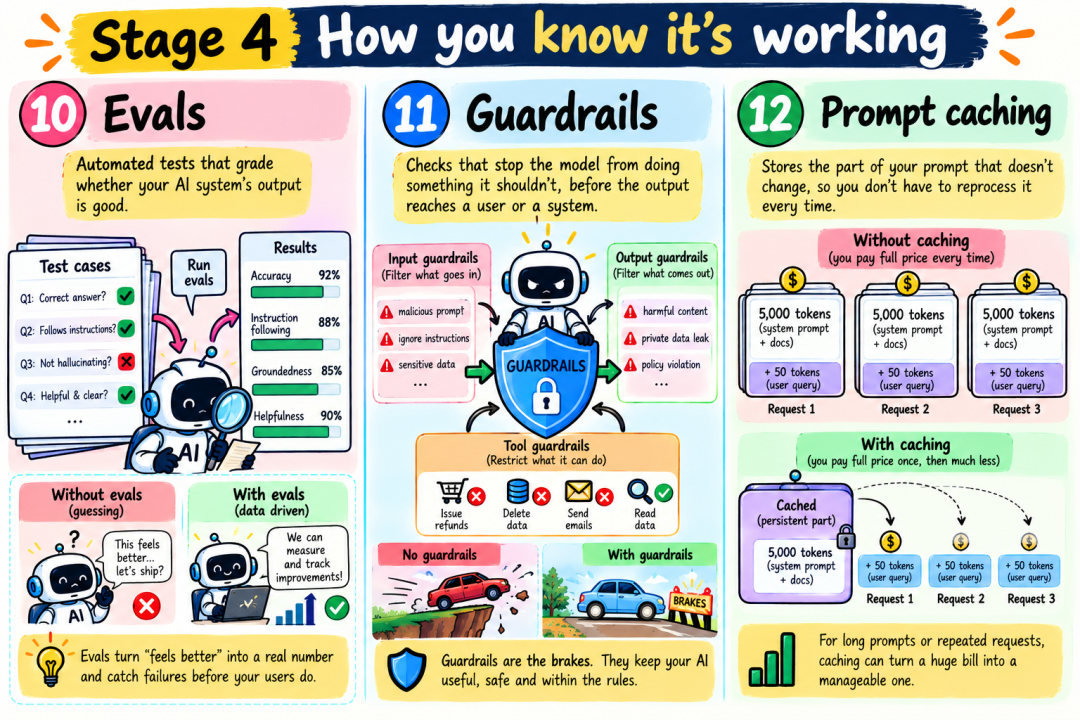
Evals 是用于评估 AI 系统输出是否良好的自动化测试,就像 unit tests 用于评估代码是否正常工作一样。
没有 evals,你只能靠猜。
你修改了一个 prompt,在尝试过的三个示例上感觉更好了,然后就把它发布出去。
Evals 会把“感觉更好”转化为一个可跟踪的数字,并在足够大的测试用例集上进行评估,从而捕捉三个示例遗漏的失败情况。
跳过 evals 的团队并没有更快。他们是在盲目推进,通常要等到客户投诉时才发现问题,而不是在测试运行期间发现。
11. Guardrails
Guardrails 是一系列检查机制,用于在模型输出到达用户或系统之前,阻止模型执行不该执行的操作。
- 过滤输入内容,防止有人诱骗模型忽略其指令。
- 过滤输出内容,防止模型泄露私人信息或说出有害内容。
- 限制它可以调用的工具,防止 support agent 意外发起本来不应批准的退款。
这就像汽车配备刹车与汽车只有一台固定在车架上的发动机之间的区别。
12. Prompt caching
Prompt caching 会存储 prompt 中不会发生变化的部分,例如较长的 system prompt 或大型文档,这样模型就不必在每次调用时都重新处理这些内容。
因为重新处理相同的 prompt 会再次消耗 token,而且在生产环境中很快就会变得昂贵。
如果你的 agent 在每次请求中都发送相同的 5,000-token 指令,而只有最后 50 个 tokens 会发生变化,那么 caching 意味着你只需支付一次全价,之后每次重复请求只需支付其中一小部分。
对于任何在生产环境中运行 agent 的人来说,这是最简单的调节手段之一,可以让账单保持在合理范围内,而不是高到让财务部门在 Slack 上联系你。
将这十二个术语联系在一起的一件事
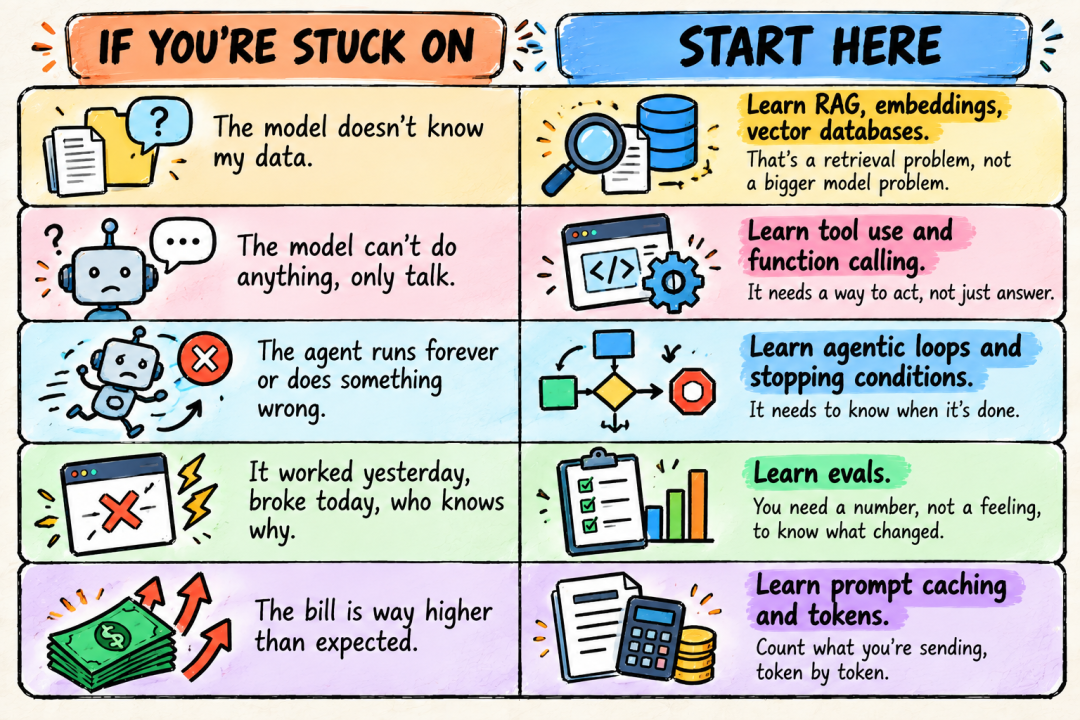
关键要点
- 这十二个术语可以分为四个阶段:模型处理的内容、模型获取外部知识的方式、模型采取行动的方式,以及验证模型是否正常工作的方式。
- 模型本身不是产品。RAG、tool use、evals 和 guardrails 才是将模型变成可靠工具的要素。
- 更大的 context window 并不一定更好。即使桌面上的所有内容都是正确的,当你把更多内容塞到桌面上时,可靠性通常也会下降。
- 如果你的 agent 给出了错误答案,请先检查检索,再责怪模型。大多数 RAG 失败都是披着生成外衣的检索失败。
- Evals 和 guardrails 并不是可有可无的装饰。它们决定了一个系统只是 demo,还是能够真正交给用户使用。
今天要做的一件事
从这份列表中挑出一个你一直点头表示理解、但实际上并没有真正理解的术语。你知道是哪一个。
去构建它最小可行的版本。
一个五行的 RAG 脚本。一次 tool call。一个只检查一件事的 eval。花二十分钟动手构建,你对它的理解会胜过再花一个小时阅读解释,包括这篇文章。
我至今仍清楚记得是哪次会议让我回家后感到困惑。我不记得那天我们做出了什么决定,但我记得一周后终于理解了“context”和“harness”的区别,而那两个小时没有白费。
参考资料
- Anthropic (2025). Effective context engineering for AI agents. https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Anthropic (2024). Contextual Retrieval. https://www.anthropic.com/engineering/contextual-retrieval
- Chroma (2025). Context Rot: How Increasing Input Tokens Impacts LLM Performance. https://research.trychroma.com/context-rot
 发表于 昨天 23:21
|
查看: 3|
回复: 0


