🧠 更聪明的 AI → 👥 AI 拥挤 → 📈 系统性风险
🚨 AI 越聪明,所有 AI 越可能在同一时刻犯下同样的错误。
这是 Andrew Lo 及合作者(MIT 与哈佛)一篇新论文 《Why Better Models Can Create Riskier Systems: Evidence from LLM Agents in Financial Markets》(2026 年 9 月 3 日)的核心结论。他们构建了一个模拟股票市场,用 AI 交易者填满市场,然后观察会发生什么。
实验设定
- 单一资产、100 轮交易;
- 每个 AI 代理人 每轮只能选择 买入、卖出或持有;
- 所有交易都围绕“价格与公允价值信号之间的缺口”进行系统性缺口交易,而不是高频做市。
作者指出:逐个评估 AI 模型并不够。当大量相似模型在同一市场中行动,而市场又由少数几种能力越来越强、推理方式趋同的 LLM 主导时,它们的共同盲点会让整个系统变得更危险——即便每个模型单独看都在变强,也会在“同一方向、同一时刻都出错”时把失败放大为系统性事件。
三个关键发现
1️⃣ 它们想得很像:两个模型越强,它们的决策就越一致;即便来自不同公司,也几乎无助于分散这种趋同。
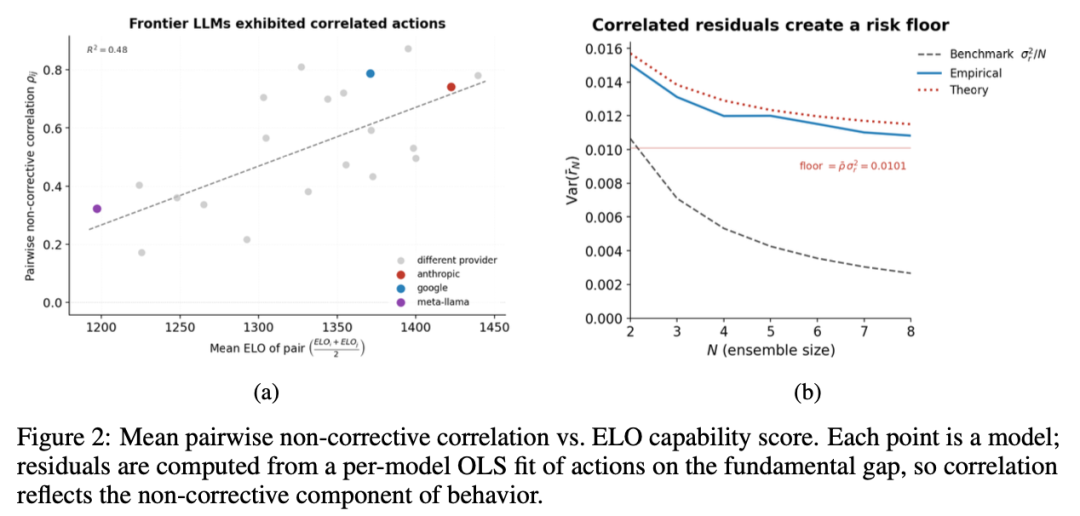
2️⃣ 信息好时,这是好事:更多 AI 交易者参与,价格更有效,市场风险更低。
3️⃣ 信息差时,会出问题:如果给所有模型同样的误导性叙事,市场错误定价(mispricing)会达到随机交易者情形的 5–7 倍;其中一个模型判断方向的准确率只有 42%,甚至 不如抛硬币。
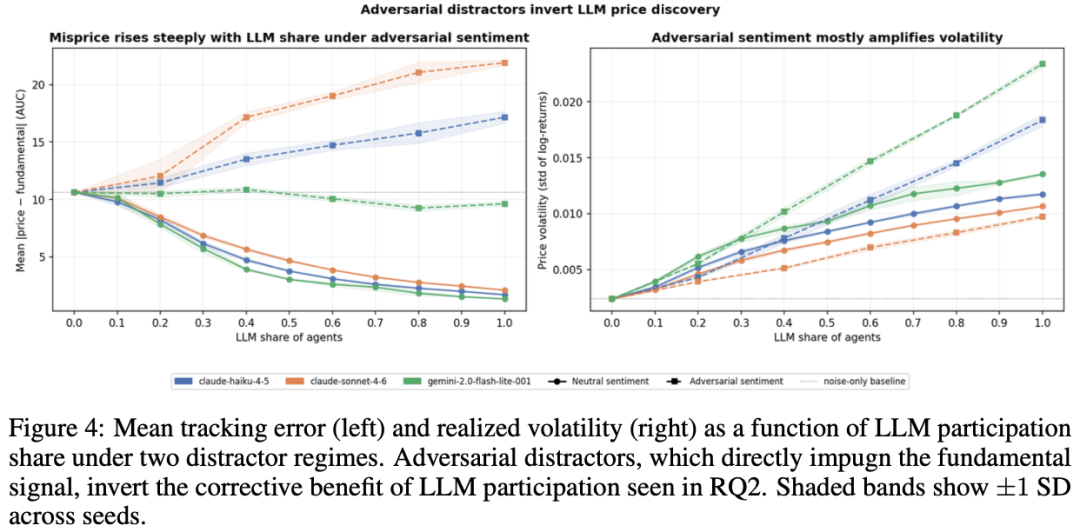
💡 直觉是:彼此不同的错误会相互抵消,但大家共享的错误会叠加放大。只测试单个模型永远看不到这种效应,换供应商也解决不了结构性趋同问题。
重要提醒
这是一个 简化模拟:单一资产、已知“真实价格”。因此应更相信其 机制逻辑,而非具体数值大小。
论文原文: https://arxiv.org/abs/2609.04373 |  发表于 昨天 23:54
|
查看: 2|
回复: 0


