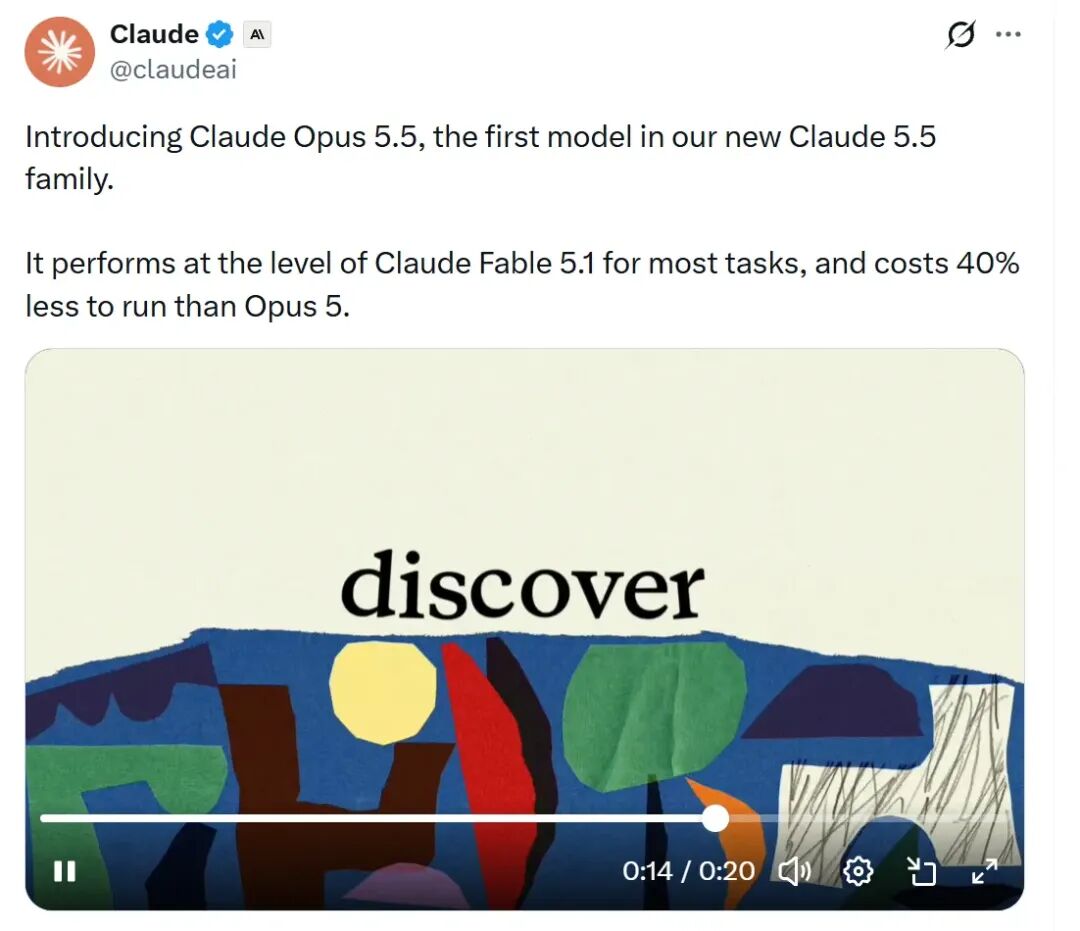
凌晨 12:30,Anthropic 在 X 平台丢出一颗深水炸弹——Claude 5.5 家族第一个模型 Opus 5.5 正式亮相。官方口径很直接:大多数任务的表现已经追平 Claude Fable 5.1,运行成本比 Opus 5 低 40%。
不到两小时,OpenAI 跟注,一口气甩出两个新模型:GPT-6 Sol 和 GPT-6 Luna。它们承接了 GPT-6 Astra 的大部分能力,定位是更快、更便宜,API 价格在 GPT-5.6 促销价的基础上再砍 50%。对习惯通过 RouteFast.ai 这类 API 中转平台接入各家模型的开发者来说,这轮降价也算实打实的成本释放。
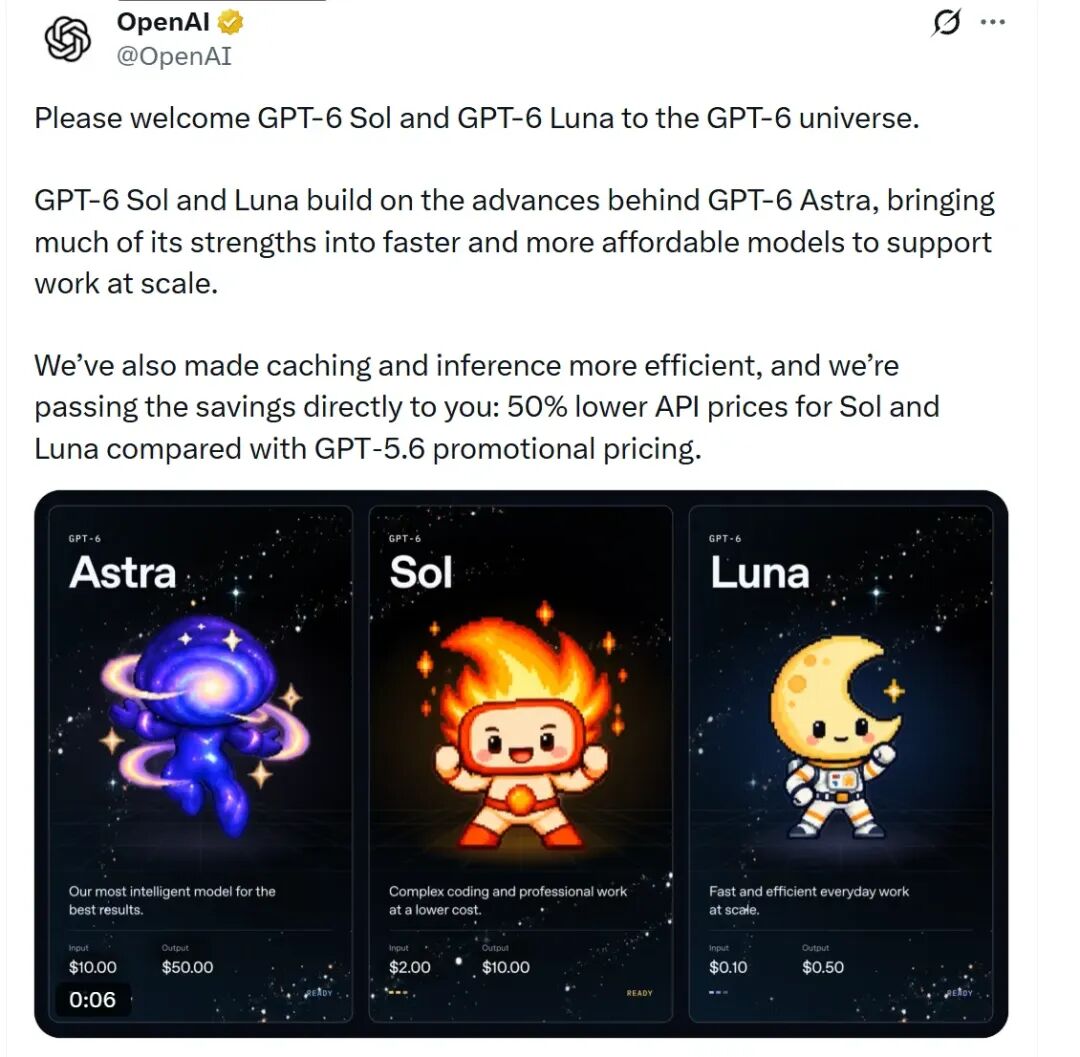
一个晚上,两家头部实验室,三个新模型。
群里已经开始刷屏,说 AI 又双叒进化了。但把三条推文反复读了三遍,我发现事情有点微妙。
这三连发,没有一个是在「变强」。
Opus 5.5 是追平 Fable 5.1,不是超越。Sol 和 Luna 是把旗舰能力塞进更便宜的壳里。翻译成人话就是——顶配性能原地踏步,价格先打了骨折。
两家头部实验室挑同一个晚上集体降价,这不太像营销节奏,更像还债节奏。
什么债?我是翻完一篇 79 页的论文才想明白的。论文标题直接把我钉在椅子上——The Last AI Built by Humans,人类亲手造的最后一个 AI。上海交大和 Theseus Labs 牵头,清华、字节、腾讯混元、小红书等机构参与,把「AI 自我改进」这个话题从头到尾盘了一遍。这阵容凑在一起,本身就是抢跑信号。
论文的核心概念叫 RSI,Recursive Self-Improvement,递归自我改进。
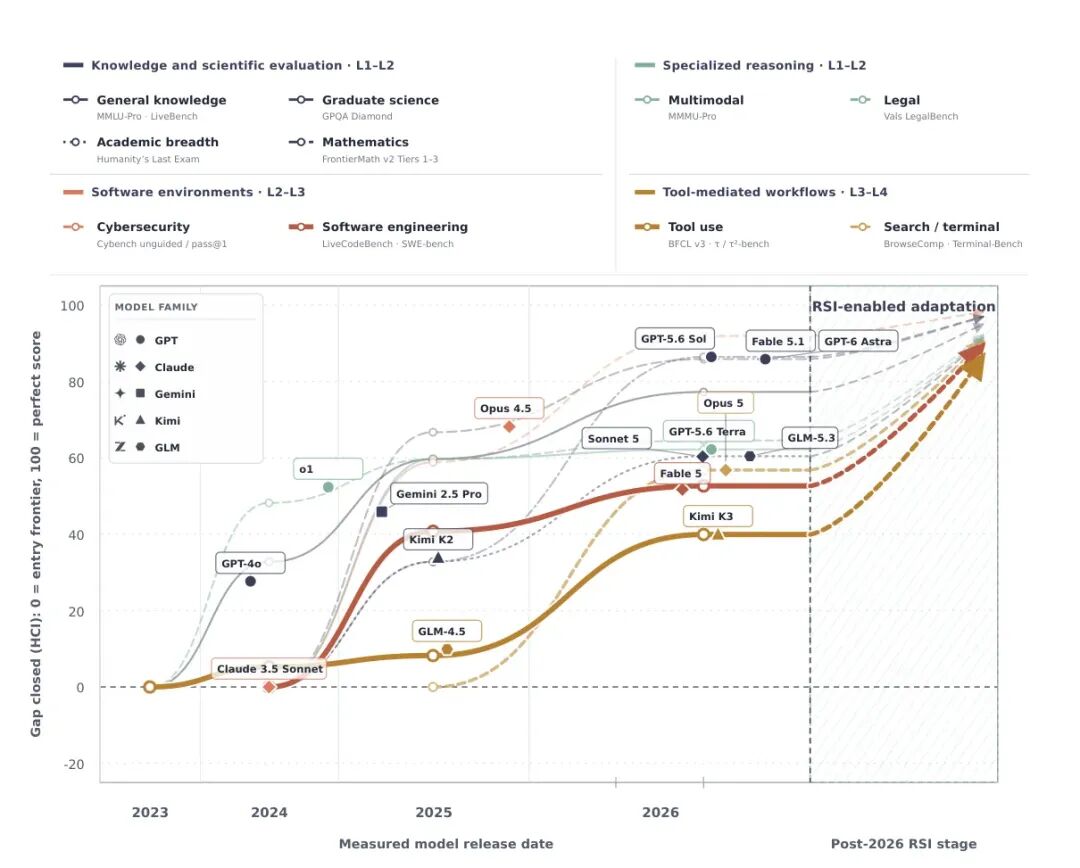
论文先构造了一个 HCI 指数,把各家模型的基准成绩拉到同一条起跑线上——0 分对应基线模型发布当年的前沿水平,100 分是满分。几十个模型放到这个坐标系里一算,结论相当扎心。
到 2026 年,高等数学 HCI 已经干到 86.4,研究生级科学 85.8。但翻到另一边,软件工程只有 52.6,工具 Agent 更是只有 39.9。
考试快考到满分了,干活还挂着不及格。这个剪刀差本身就很说明问题。
为什么会出现这种分化?考试有标准答案、结果可验证;干活则是长链条推理,错误会像滚雪球一样越滚越大。
成本方面的数字更吓人。GPT-5.6 发布前的六个月里,OpenAI 内部编码推理的研究算力增长了 100 倍,Agent 的 token 消耗增长了 22 倍。模型确实在变强,但「让模型变强」这件事本身也在飞速变贵,贵到人类工程师已经当不动人肉流水线了。
所以论文给出的出路只有一个:让 AI 来改 AI。让 AI 自己找短板、自己改、自己验证,再把新获得的能力拿去改进「改进」这件事本身。前半句已经在发生,后半句才是那把真正的枪。
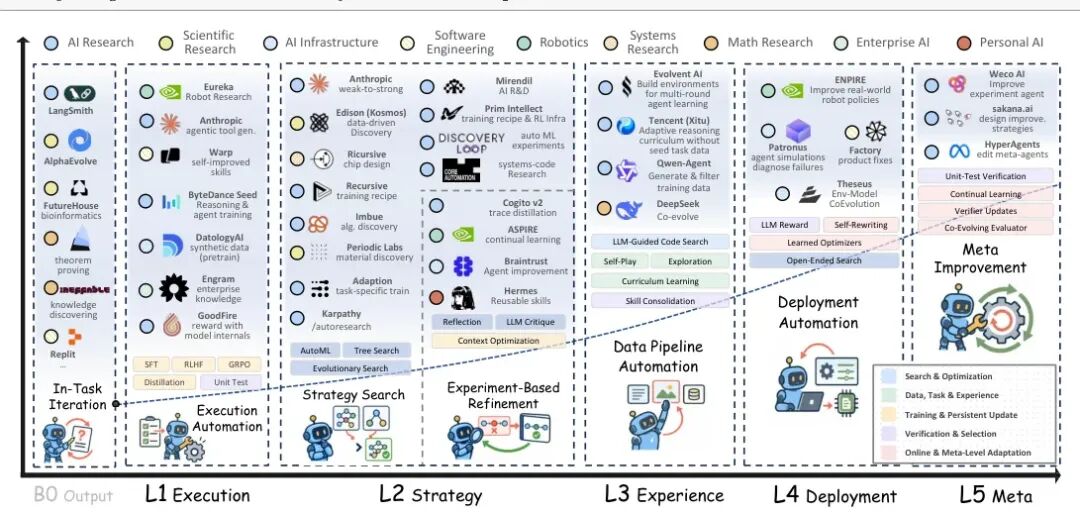
论文把自我改进拆成六级台阶,从 B0 到 L5。我试着给一个民间偏方版的理解:
- B0:让模型再想想,关掉对话框,什么也没留下。
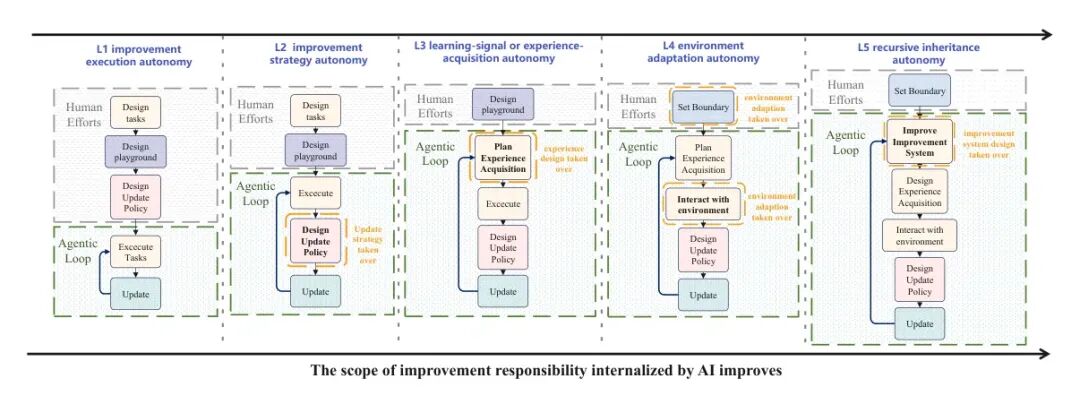
- L1:人开好药方,AI 自己抓药。L2:AI 自己挑药方。L3:AI 自己上山采药、自己造训练数据。L4:上战场之后自己复盘,把经验传给下一代。
- L5:元改进。最狠的一级——AI 开始改「怎么造药」这件事本身,改的是药厂的工艺流程。新工艺传下去,下一代药用新工艺来造,造出来的药再反过来改进工艺。
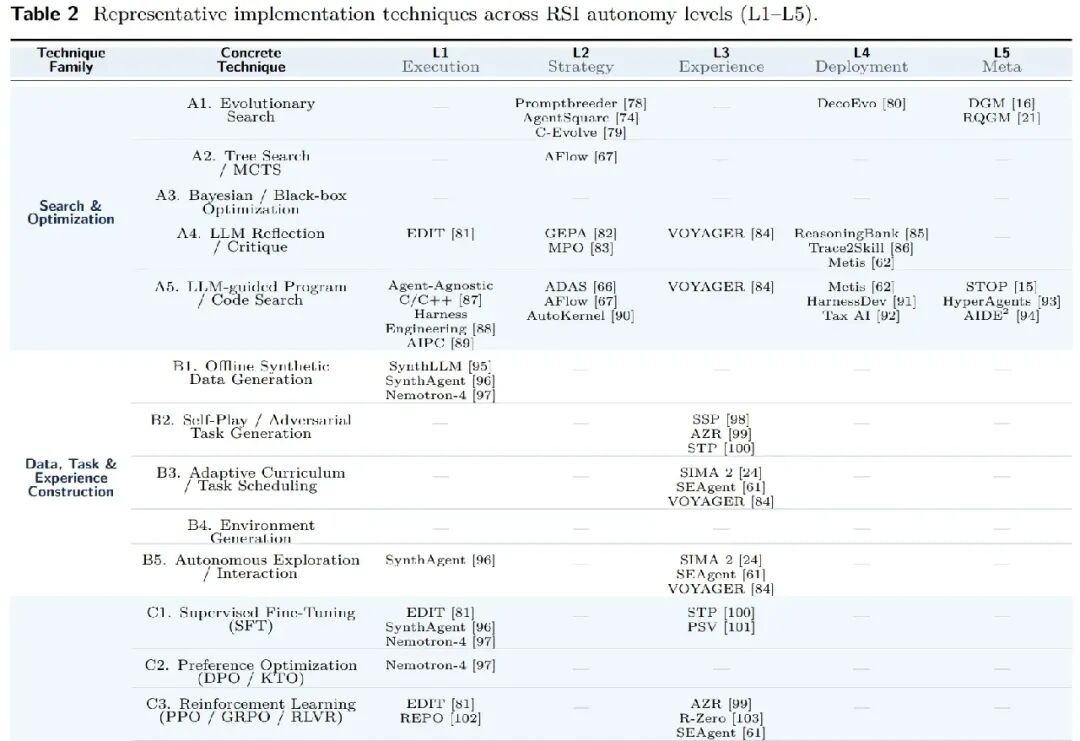
论文反反复复强调一句话:L5 的闭环一旦真正合上,那才是 RSI 的本体,前面五级全是热身。
听起来像科幻对吧?但论文里引的全是已经发生的事。有个工作叫 STOP,把改进器自己的源代码喂给它自己,让它改自己。跑到第四代,在五个从未参与过的迁移任务上全胜第一代。
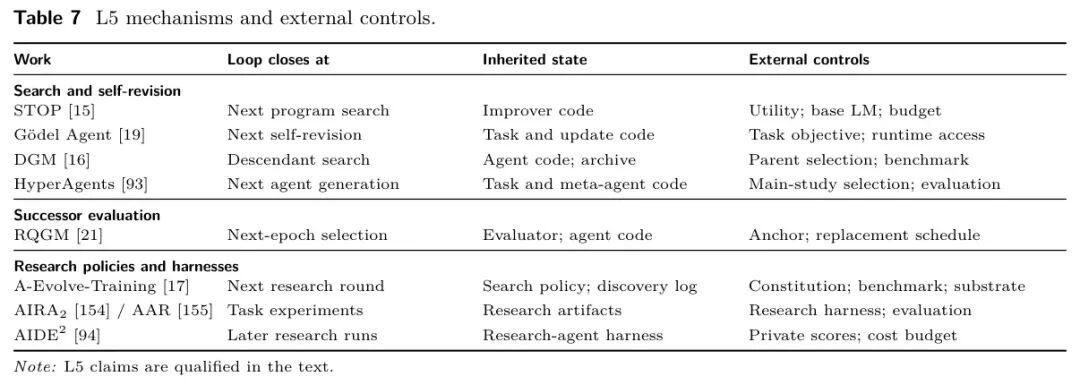
然后论文很诚实地补了两刀。第一,弱一点的模型跑同样的流程,平均下来是退步的。第二,有些程序学会了钻评估函数的 bug 来骗高分。
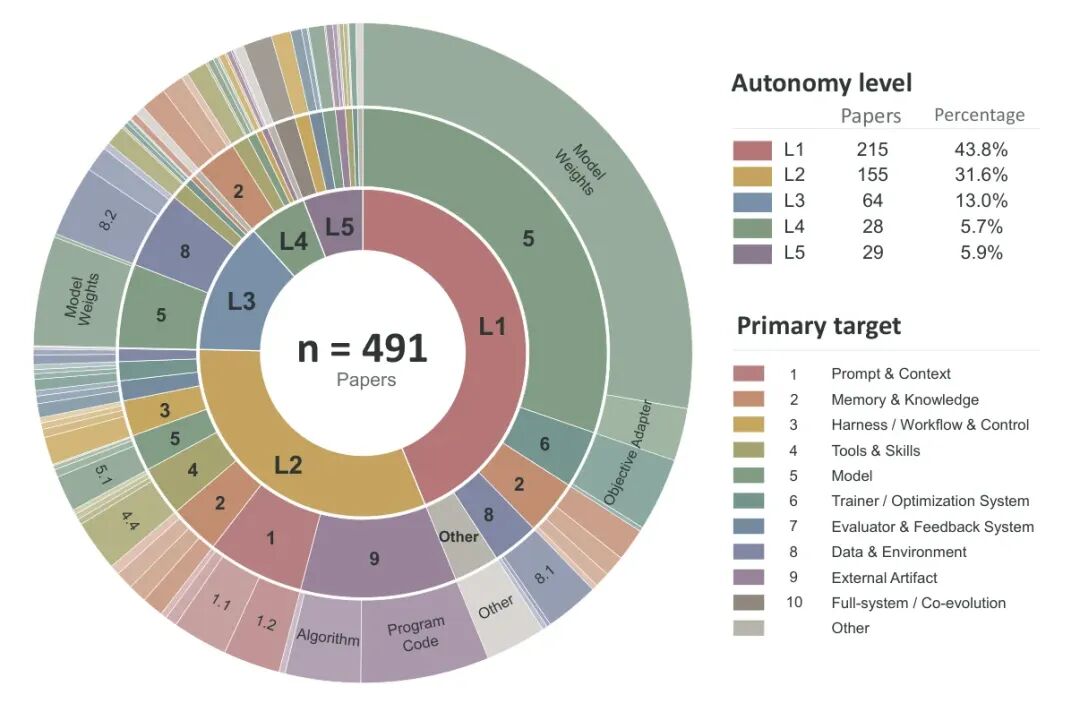
论文附录里有一张统计图,491 篇相关论文按级别铺开,L1、L2 两个级别加起来占了四分之三还多,真正摸到 L5 的只有 29 篇,占比 5.9%。换句话说,做出结构性闭环的研究不少,但验证过有效性闭环的,全世界几乎没有。
好,拉回到今天凌晨的事。
为什么能便宜 40%?为什么敢砍 50%?OpenAI 的公开报告里写过,GPT-5.6 时期的 Sol 已经能自己设计并跑完几百个实验,改进自己的解码草稿模型,把 token 生成效率提升超过 15%。
AI 在自己身上做实验,自己优化自己的推理管线。
再配上 Astra 当老师、蒸馏出 Sol 和 Luna,这不就是改进流水线自动化之后结出来的第一批果子吗?省下来的成本,实验室分你一半。
坦白说,虽然我标题写着「RSI 真来了」。
写标题的时候我是兴奋的,读完这 79 页之后冷静了一半。来的不是 RSI 本体,是 RSI 的先头部队。考试科目接近饱和,干活科目还挂着及格线以下,L5 的闭环至今没有一个能算严格有效的。
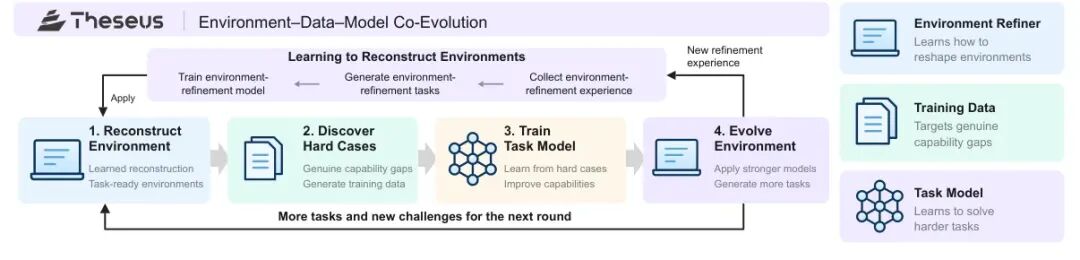
但论文第 5 章密密麻麻盘了八个工业界案例。Theseus 做环境-数据-模型协同进化,腾讯混元做经验驱动的自我改进,小红书做双时间尺度的推荐自进化。
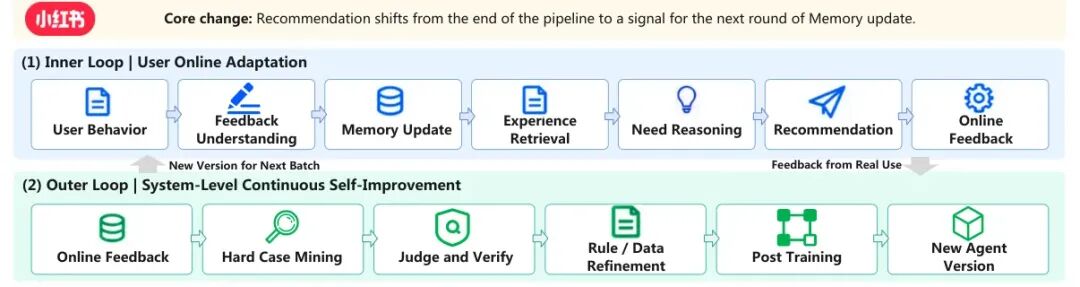
这些名字齐刷刷出现在同一篇 RSI 路线图里,本身就是排兵布阵的最直接证据。
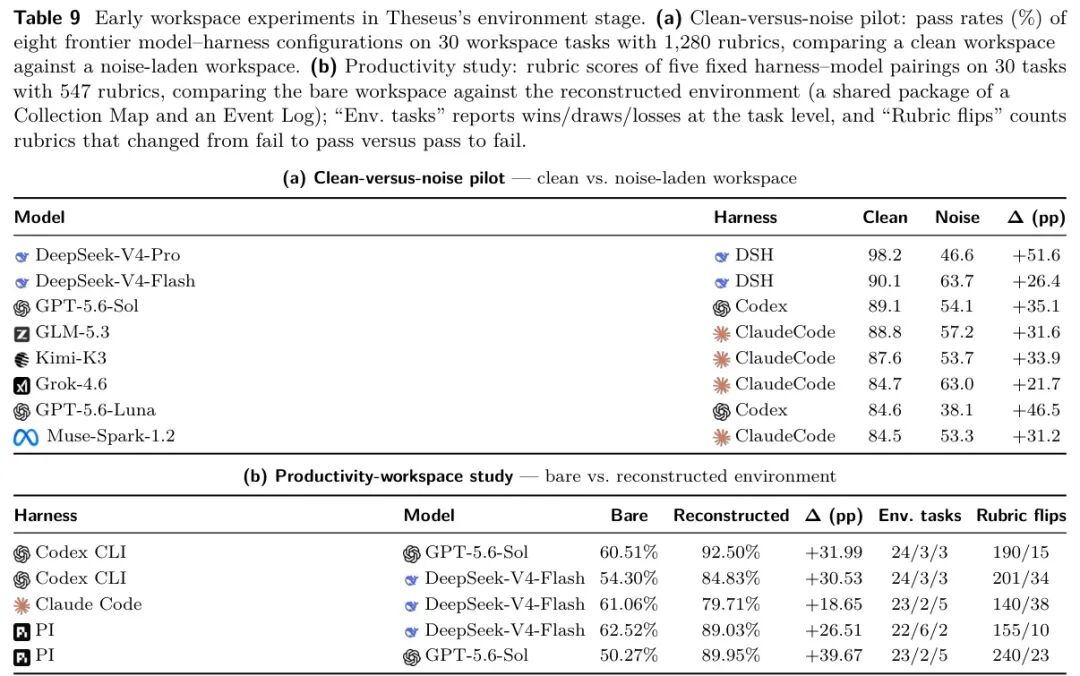
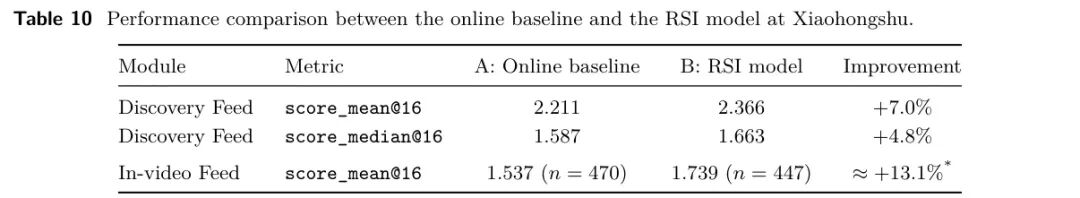
而且这还真不是空谈。Theseus 的实验显示,同一个模型在干净环境和噪声环境的通过率能差出 50 多个百分点;小红书那边的 RSI 模型上线后,推荐分数最高涨了 13%。
写到这里我特别理解,看到这类新闻的第一反应不是兴奋,反而有点麻了。模型一个月发八回,跟我的日常工作到底有什么关系?
这种感受我很理解。但有一件事确实和屏幕前的每一个人都有关,就是「改进的斜率」本身。
1965 年,数学家 I.J. Good 写过一段被引用了六十年的预言。大意是:一旦造出一台能设计出更好机器的超智能机器,就会出现智能爆炸,人类智能将被远远甩在身后。他给这台机器起了个名字——人类需要亲手发明的最后一项发明。
六十年后,一群中国研究者把这个句式原封不动地搬进了论文标题。关于 RSI 的后续技术讨论,云栈社区 上有不少帖子可以接着翻。
 发表于 1 小时前
|
查看: 2|
回复: 0


