打开终端向 AI 编程助手请教一个鉴权接口报错,屏幕上大概率会吐出这样一段话:
“这是个好问题!你的认证中间件与 Token 校验之间可能存在耦合。看 auth.ts:42,旧版第三方包似乎不兼容,建议先升级版本并重写该函数;改完记得跑一遍测试用例。另外,整体依赖项也该升了。希望这能帮到你!需要深入探讨随时叫我。”
近两百字的寒暄、免责声明与发散建议扑面而来,唯独你最急需的那条命令被深埋在中间。
看到这个没有一行模型训练权重、没有后端守护进程、核心不过百行规范的开源项目 i-have-adhd 在 GitHub 斩获 5.1 万 Star 时,我第一反应也是困惑:难道这不就是把几句系统提示词打包了一下吗?
但拆解它的设计逻辑与评测数据后,我才意识到它切中的不仅是注意力缺陷人群的痛点,更是所有重度依赖 AI 辅助编码的开发者早已忍耐到极限的交互死穴。
项目卡片
- 项目:i-have-adhd[1]
- 状态:GitHub 5.1 万+ Stars / MIT 协议 / 跨主流 Agent 运行时的输出重塑插件
- 一句话判断:用认知行为疗法的硬规矩反向驯服大模型废话病,首行即动作、步长硬封顶、状态每轮同步的开发者专注力外挂。
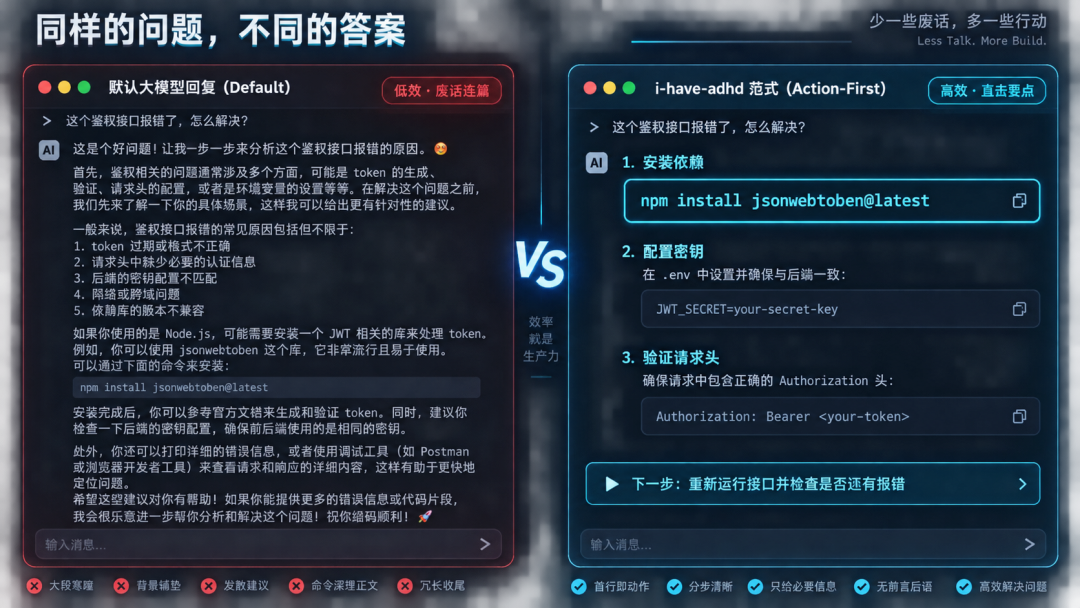
为什么在 Prompt 里写“请简短一点”总是失灵?
大多数人在受够了 AI 的套话后,常规做法是在系统提示词里追加几句软性约束:“回答请务必简短”、“直接给代码”、“不要客套”。
但实操过的开发者都清楚,这种祈使句通常撑不过三轮对话。随着上下文拉长,大模型又会迅速退回热情、啰嗦、习惯性奉承与免责陈述的默认舒适区。
i-have-adhd 的反直觉之处在于,它根本不试图在语言层面上“劝”大模型收敛,而是直接借用了成人注意力缺陷多动障碍(ADHD)的临床认知行为工具包(The Adult ADHD Tool Kit),把人类在注意力与执行力上的 5 个冷酷事实,机械映射成了 10 条不可逾越的负向硬红线:
- 工作记忆极度脆弱:屏幕之外的信息立刻会被遗忘,严禁要求人类“请牢记 X”;
- “知道答案”不等于“能做答案”:从看懂思路到真正落手之间的心理阻力,是工作流中断的元凶;
- 起步阻力最大:首个动作必须小到毫无心理负担,触手可及;
- 时间感知高度均质化:在认知过载的人脑里,“一会儿”和“三小时”毫无区分度,模糊预估等于废话;
- 多巴胺极度稀缺:看不见的进展等于没有进展,必须将微小胜利明文化呈现。
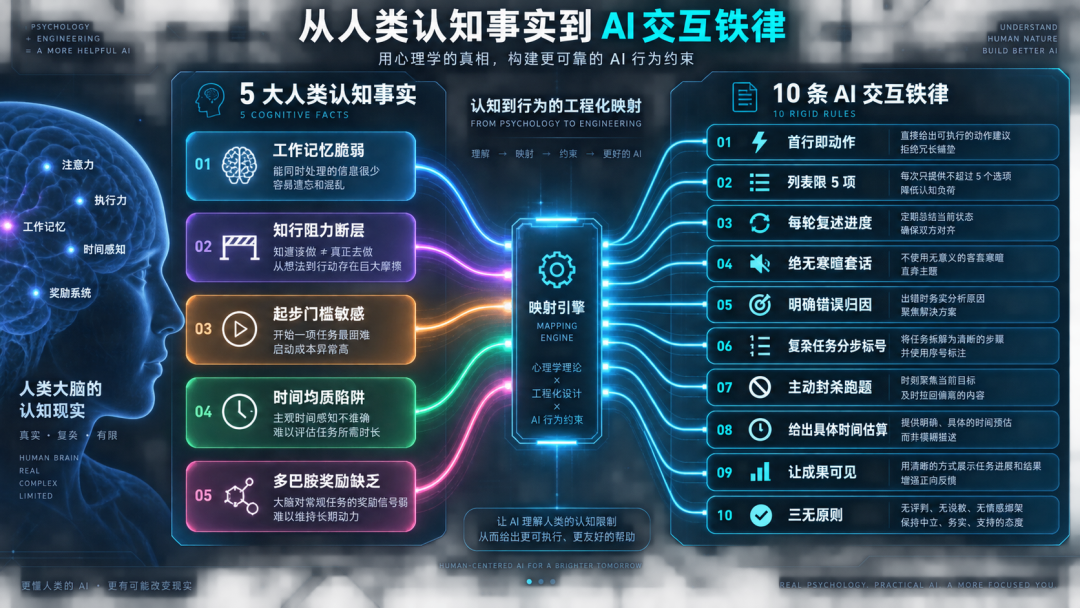
基于这 5 条心理学假设,项目制定了 10 条苛刻的交互铁律。
比如第一条“动作置顶(Lead with the next action)”:回复第一行必须是立刻能执行的具体动作——终端命令、文件路径或代码片段。解释性文字如果有必要,只能放在动作之后。
比如第十条“三无原则”:绝对禁止“好问题”、“让我来看看”等起手式,绝对禁止任务完成后的邀功复述,绝对禁止“希望对你有帮助”等闭环客套。
还有单次列表至多 5 项、多步任务每步禁止包含两个以上的“然后”、每轮对话强制复述全局进度(“第 3/5 步已完成:数据表结构已更新;下一步:运行回填脚本”)。这些规则把大模型发散的思考,强行压缩成了流水线般的明确工序。
怎么让十几种不同工具同时守规矩?
i-have-adhd 能快速破圈,关键在于它提供了一套零运行负担的轻量适配层。它把同一套规范,同时编译打造成了 Claude Code 插件、Cursor 技能目录、Antigravity(agy)插件包、Codex 清单以及 OpenCode 扩展。
对于 Antigravity 用户,一条命令即可挂载生效:
agy plugin install https://github.com/ayghri/i-have-adhd
如果使用 Claude Code,同样只需一行命令:
claude plugin install i-have-adhd
即使是在没有插件机制的环境里,你也可以直接将规范主体粘进 ~/.gemini/GEMINI.md 或各家自定义说明中,全局常驻。
更耐人寻味的是它的逃逸机制(Escape Hatches)。作者给出了严密的规则例外设计,防止把规则卡得过死:
- 用户明确要求“explain”或“walk me through”时,允许解除篇幅限制展开详述,但依然严禁前言套话与结尾寒暄;
- 遇到
rm -rf、强制推送或删除生产表等破坏性动作时,安全等级压倒简洁性,必须暂停并弹出二次确认;
- 最具工程洞察的是“3 轮诊断熔断”:如果同一个 bug 连续尝试三次依然报错,禁止继续盲目改代码,必须立刻停下,明确指控当前最可能失效的核心假设,并向用户抛出且仅抛出一条排查提问。
数据说明一切,但也有不能忽视的边界
这套机制到底是不是玄学?仓库内配套的基准评测工具,给出了相当扎实的实测数字。
在针对 claude-opus-4-8 模型的 14 个真实任务、84 次盲测裁判对比中,挂载该规则后的模型表现出了极具说服力的指标跃升:
- 简洁度(Concision):从基线的 3.429 暴涨到 4.571(净增 +1.143);
- 可执行性(Actionability):从 3.905 提升至 4.619(净增 +0.714);
- 正确性(Correctness):不仅没有因为回复变短而下降,反而从 4.333 微升至 4.524(+0.190)。
数据打破了固有偏见:剔除语言废料后,AI 的注意力反而更加聚焦在真实动作本身。
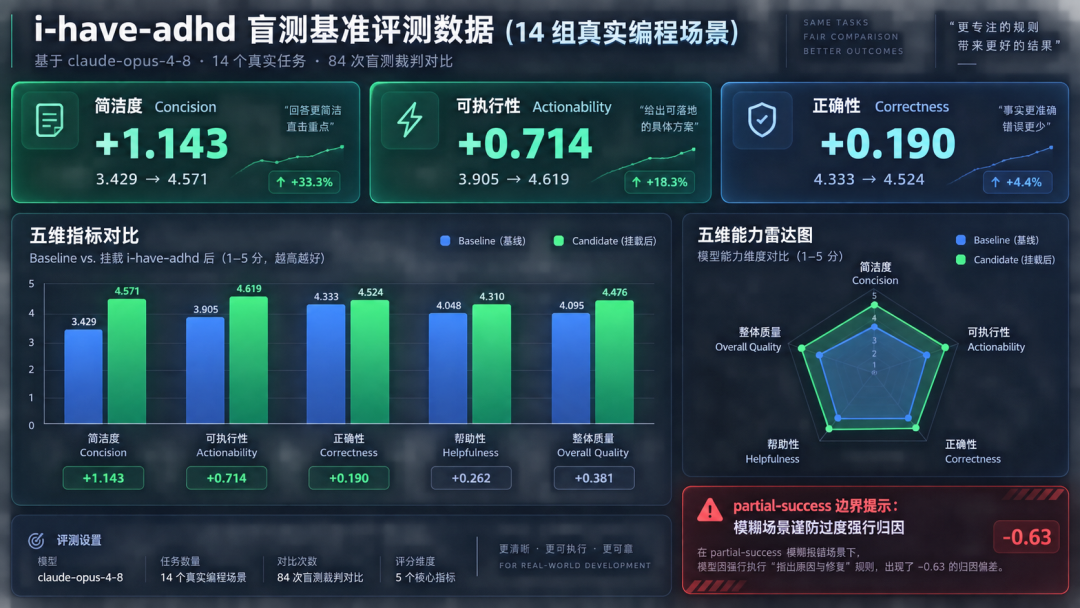
但在它的官方评测报告中,有一个负向回归案例格外值得警惕。
在 partial-success(部分成功)测试场景中,模型的综合评分出现了负向偏差(-0.63)。裁判模型捕捉到了一个隐蔽的副作用:
因为第 8 条规则严厉要求“对待错误必须实事求是,明确指出原因并给出修复方案”,在某些报错日志信息不充分、根本无法准确归因的场景下,模型为了遵守“原因加修复”的格式军规,产生了更强的归因焦虑,进而过度自信地虚构了一个并不存在的根因。
换句话说,极度压缩的动作偏好,可能在特定模糊场景下抑制模型的审慎怀疑态度。如果你在排查底层黑盒偶发崩溃或复杂的网络分布式竞态,盲目依赖这种“动作置顶”模式,可能会被带偏进一条看似利落、实则方向全错的死胡同。
人机交互的重心正在从“聊天”转向“驱动”
i-have-adhd 的爆火,标示着大模型应用范式的一个转折点。
在刚接触大模型时,人们惊叹于它的拟人语气与温度;但在高强度工程交付现场,“健谈”正在沦为最沉重的认知税。
你不需要一个在终端里对你点头哈腰的赛博管家,你需要的是一把拿起来就能拧紧螺丝的电动扳手。
正如项目在 README 里写的那样:“即使你没有 ADHD 诊断,只要它帮你省下了一次跳过‘好问题!’的鼠标滚轮翻页,就值得给它一颗 Star。”
如果你想继续看这类 AI 工具拆解,云栈社区上还有不少开发者分享的上手路径、关键限制和可复用配置清单,方便你直接判断值不值得试。
引用链接
[1] i-have-adhd: https://github.com/ayghri/i-have-adhd
 发表于 2 小时前
|
查看: 4|
回复: 0


