你让 AI 编程助手加一个日期选择器。
它给你装一个 flatpickr,写一个 wrapper 组件,附一份样式表,再跟你讨论半小时时区问题。你要的其实只是一行:
<input type="date">
这不是段子,是 Ponytail README 里的第一个例子。这个项目干的事只有一件:把一个「懒惰资深工程师」塞进你的 AI 编程助手。就是那种在公司比版本控制还资深、扎马尾、戴椭圆眼镜的人——你给他五十行代码,他一言不发,换成一行,能跑。
三个月,120k star。它凭什么?
项目卡片
- 项目:Ponytail
- 状态:v4.9.0 / 120,808 stars(2026-06 创建,三个月)/ MIT
- 一句话判断:不写代码、不装依赖,只往 agent 上下文里注入一套「先复用后手写」的决策规则,就挡住了 AI 编程最贵的毛病——过度工程。
AI 编程的病,不是写太慢,是写太多
用过 Claude Code、Codex、Cursor 的人对这个场景都不陌生:任务很小,产出很大。
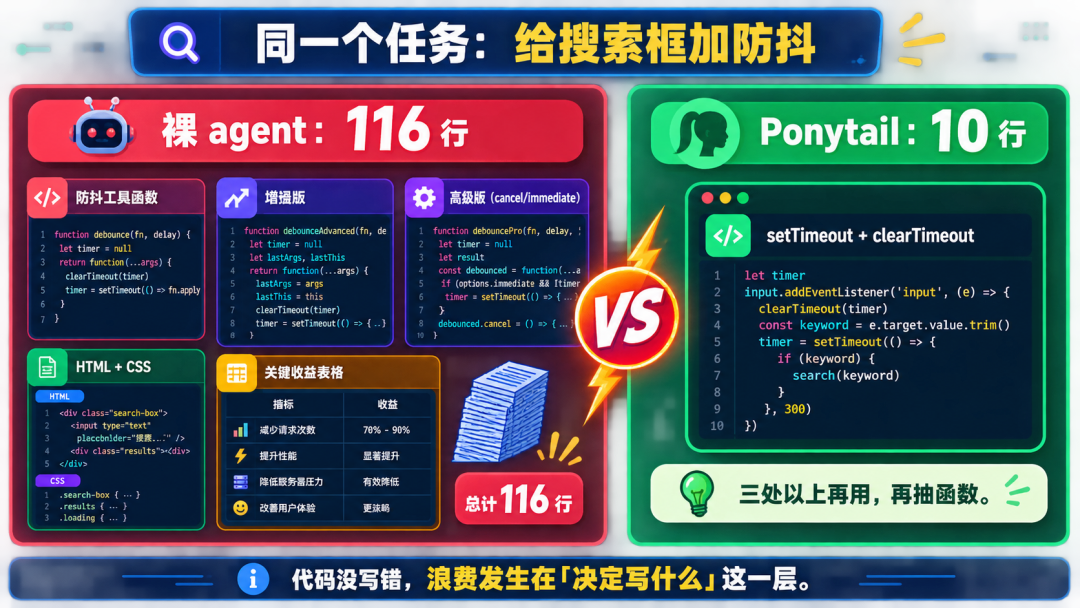
Ponytail 的 examples 目录存了一批真实基准输出。同一个模型、同一个提示——「给搜索框加防抖」,裸模型写了 116 行:防抖工具函数、增强版、带 cancel/immediate 选项的高级版,外加 HTML、CSS 和一张「关键收益」表格。装上 Ponytail 之后,同一个模型只写 10 行:setTimeout 加 clearTimeout,完事,附一句「等你有三处以上要用,再抽成工具函数」。
另一个例子更扎心:「解析和拼接 URL 参数」,裸模型的方案是 npm install query-string——每周 350 万下载的包。而 URLSearchParams 是浏览器和 Node 10+ 内置的标准 API,这包本质是给早已普及的原生 API 做的 polyfill。
注意这两个例子的共性:代码没写错,需求也完成了,浪费发生在「决定写什么」这一层。这也是我看完 examples 目录后觉得这项目摸对了地方的原因——模型缺的未必是能力,而是一个做决策前的固定检查动作。
它的办法:写代码前先爬一张梯子
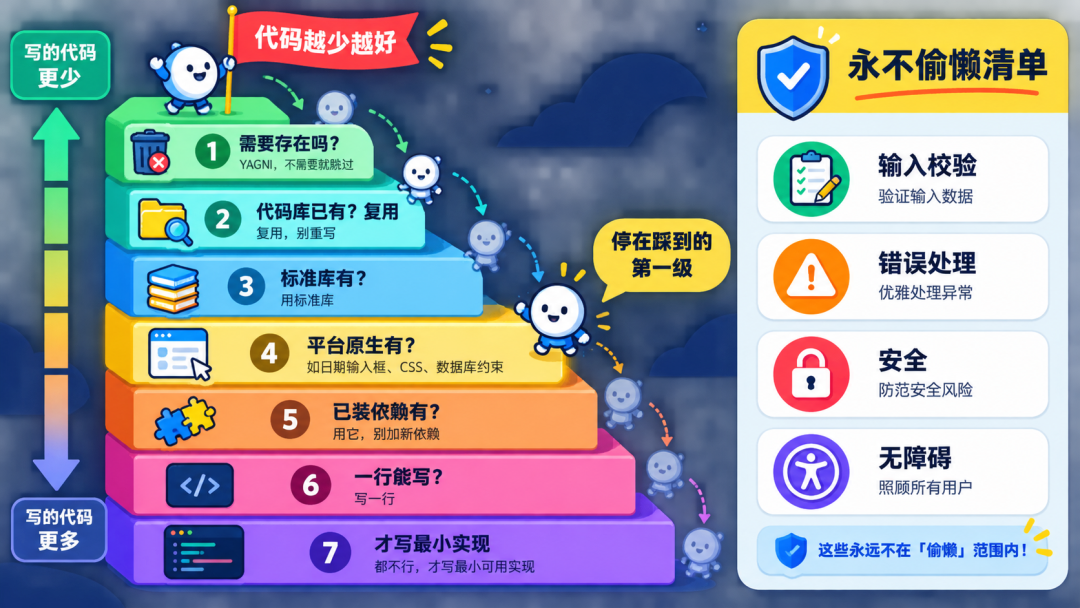
Ponytail 的全部核心机制,是一张七级梯子。写任何代码前,从上往下停在你踩到的第一级:
- 这东西真的需要存在吗?(不需要就跳过)
- 代码库里已经有了?(复用,别重写)
- 标准库有?(用标准库)
- 平台原生特性有?(
<input type="date">、CSS、数据库约束)
- 已装依赖能解?(用它,别加新的)
- 一行能写?(写一行)
- 都不行,才写最小可用实现。
它不碰运行时、不改工具链。所谓「安装」,就是把这套规则文本注入 agent 上下文,让它每轮带着梯子干活——整个项目没有一行你要执行的代码。
关键在两条容易被误解的纪律。
第一,梯子跑在理解问题之后。规则里明确写了:先读完任务和涉及的代码,追完真实调用链,再爬梯子。「读代码永远不偷懒,偷懒只针对解决方案」——最小 diff 改错地方,不叫 lazy,叫第二个 bug。修 bug 时先 grep 函数的所有调用方,在共享函数里修一次,而不是只补工单提到的那条路径。
第二,懒惰有豁免清单。信任边界的输入校验、防止数据丢失的错误处理、安全、无障碍——这些永远不在砍之列。故意砍出的捷径(全局锁、O(n²) 扫描)必须留 ponytail: 注释,写明天花板和升级路径;/ponytail-debt 命令把全仓库这类注释收进账本,防止「以后再说」变成「永不处理」。
一句 YAGNI 提示不够吗?它专门做了实验
规则类项目我一般先看一件事:它敢不敢把「一句裸提示」拉进来当对照组。很多同类项目不敢,一比就露馅。Ponytail 不仅敢,还把质疑者本人写的那句提示做成了实验臂。
6 月的 agentic 基准里,让一个真实的 Claude Code 会话在 FastAPI + React 真实仓库上做 12 个功能任务,四种配置各跑 4 次:裸 agent、装 Ponytail、装 caveman(只压缩话术不管代码的对照组)、以及一句裸提示「遵循 YAGNI 原则,倾向单行方案」。结果:
| 对比裸 agent |
代码行数 |
tokens |
成本 |
耗时 |
安全 |
| Ponytail |
-54% |
-22% |
-20% |
-27% |
100% |
| caveman(话术压缩) |
-20% |
+7% |
+3% |
+2% |
100% |
| 裸 YAGNI 提示 |
-33% |
-14% |
-21% |
-30% |
95% |
Ponytail 是唯一全面下降且安全满分的。那句裸提示减代码的力度不差,但在对抗性安全测试里掉了 5 分——「少写」和「该写的不写」之间那条线,正是这套规则真正在管的事。
还有一处难得的诚实:项目早期宣传过「少写 80-94%」,有外部开发者(issue #126)指出旧基准的基线是「爱聊天的裸模型」,行数里混了大段解释文字,数字有水分。作者没有删 issue,而是重建了整套基准,还在报告里公开自己踩过的污染 bug——一个 hook 意外泄漏到对照组,把差距从 4% 修正到 54%。README 上今天的数字,是被外部批评修正过的第二轮结果。
怎么用:一条命令,四个档位
如果你在用 Claude Code,两条指令装完:
/plugin marketplace add DietrichGebert/ponytail
/plugin install ponytail@ponytail
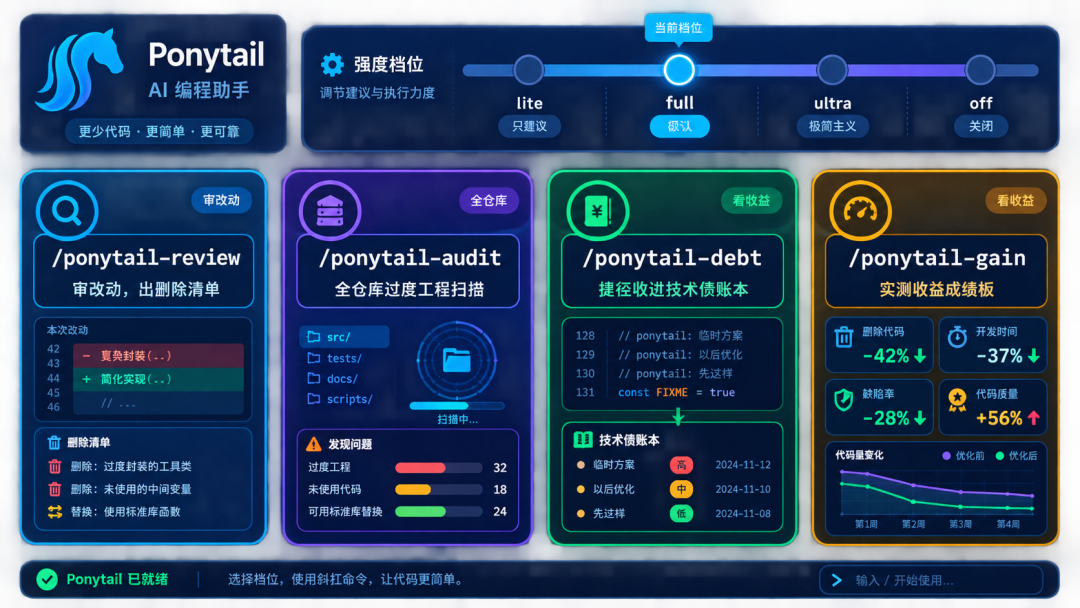
装完每个 session 自动生效,默认 full 档。档位即脾气:lite 照你说的做,但附一句更懒的替代方案;full 梯子强制执行;ultra 是 YAGNI 极端主义——「没有 profiler 说话,不准加缓存」。随时 /ponytail off 关。
四个配套命令覆盖存量代码:/ponytail-review 只审 diff,输出删除清单,标注该删的、该换标准库的、该换平台原生的;/ponytail-audit 把同样的审查扫到整个仓库;/ponytail-debt 收捷径账本;/ponytail-gain 看基准成绩。
生态适配是另一个超预期的地方:Claude Code、Codex、Copilot CLI、Gemini CLI、Devin 等有插件系统的直接安装;Cursor、Windsurf、Cline 这类规则文件驱动的,把对应规则文件拷进项目即可。README 自己数了:20 个 agent。
边界在哪
几个值得知道的限制。
效果数字测于 Haiku 4.5。规则要模型听话才生效:爱思考的强推理模型可能在每一级上反复琢磨,token 反而更多(GPT-5.5 上就是反向的)。它是行为约束,别指望在所有模型上都省钱。
Claude Code 和 Codex 的插件走两条 Node.js 生命周期 hooks,要求 node 在非交互 shell 的 PATH 上——Nix/nvm 用户注意。不在的话功能不受影响,只是常驻激活会静默失效。
规则文件方式(Cursor 那一路)只加载常驻规则,六个 /ponytail 命令不可用;反过来,卸载也有残留——模式标志、配置文件、可能写进 ~/.claude/settings.json 的 statusLine 条目,需要单独跑 scripts/uninstall.js 清理,而且要先于插件删除命令执行。
最后是适用边界:它管「写什么代码」,不管「说什么话」(话术压缩是 caveman 的事,两者官方明确可以叠装);它也不适用于非编码任务。如果你维护的就是一个高度抽象的框架级代码库,ultra 档的删除冲动可能需要慎用——好在 lite 档给回了选择权。
值不值得装
我的判断是:值得试,成本几乎为零。装一个插件的事,最坏情况是你忘关它、AI 写得过于克制;而最好情况是基准里那个——同样的任务,一半的代码、八成的成本,安全性不掉。三个月 120k star,说明被 AI 过度工程折磨的远不止你一个。
对一个每天和 agent 结对写代码的人来说,这可能是目前性价比最高的一次「提示工程即产品」:作者卖的与其说是提示词,不如说是给模型请了一位见过所有烂代码的懒人前辈——他什么都不说,他只写一行,能跑。
(本文基于仓库静态阅读与基准报告写作,未实际运行安装流程;基准数字引自仓库报告,复现步骤见 benchmarks/ 目录。)
 发表于 1 小时前
|
查看: 1|
回复: 0


