先说结论:超时重试是个甜蜜的陷阱。网络抖动时它能救你一命,但稍有不慎,它也能把下游服务活活打死。在云栈社区的技术讨论中,类似的线上事故可以说是屡见不鲜。
现场还原
凌晨 3 点 07 分,告警突然叫醒了值班同学。
订单服务的 QPS 从平时的 200 猛然拉满到 1800——但业务量没有任何变化。与此同时,上游的服务 A 开始疯狂报错,日志里清一色的 Read timed out。
值班同学第一反应是“订单服务是不是数据库慢查询了”,登上机器一看:数据库连接池被打满,全部在处理重复的创建订单请求。
再往上游追查,真相浮出水面:
服务 A 调用订单服务创建订单时,接口超时时间(ReadTimeout)设置的是 1 秒。而订单服务在高峰期创建订单的平均耗时是 1.2 秒。
于是,一连串的连锁反应开始了:
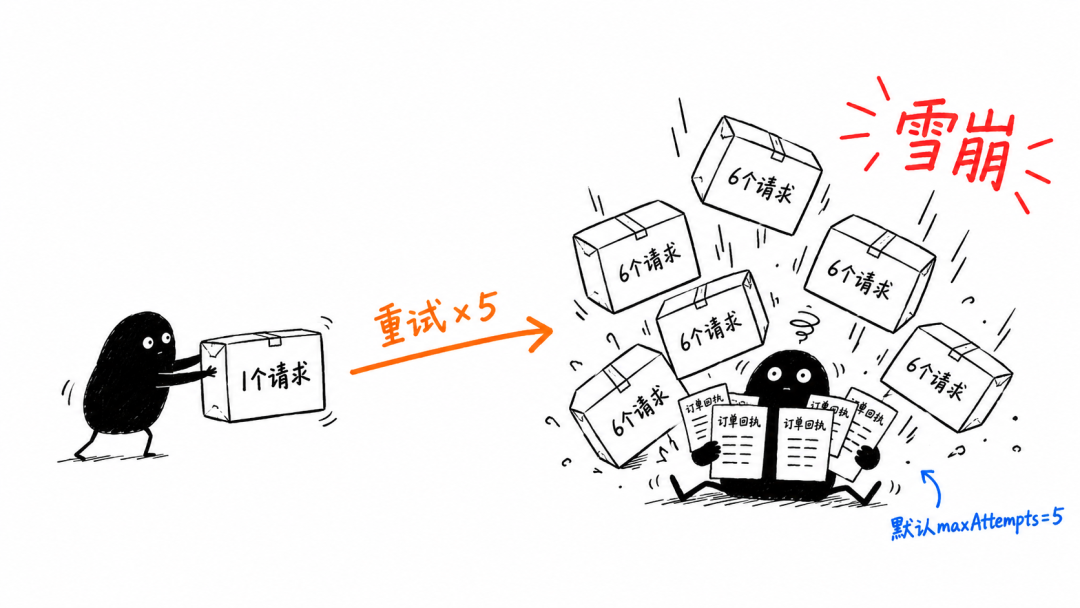
- A 发请求 → 1 秒后超时 → Feign 认为失败 → 重试
- 重试又发出了 1 个新请求 → 又超时 → 再重试
- 默认配置下重试 5 次,加上第一次,一共 6 个请求打到了订单服务
- 6 个请求都在创建订单,数据库写了 6 条记录
- 用户愤怒投诉:“我就点了一下,怎么扣了 6 次钱?”
一句话总结:ReadTimeout 设小了 + 默认重试开着 = 上游超时,下游被打穿。
为什么十几个请求能把服务打挂
这里有个很多人忽略的技术细节:重试不是“再来一次”,而是再来一次乘以上游的并发量。
假设 A 服务有 20 个线程在调订单服务,每个线程超时重试 5 次,那订单服务实际承受的 QPS 就是:
原始 QPS × (1 + 重试次数) = 200 × 6 = 1200
更糟的是雪崩效应:订单服务被打慢 → 更多请求超时 → 更多重试 → 订单服务更慢 → 直到彻底崩溃。
这就是经典的重试风暴(Retry Storm)。严格来说,它不是 bug,而是默认配置运转下的必然结果。
分层理解:Feign 里到底有几个超时
很多人只知道“Feign 有个超时”,其实这里有两层独立超时,任何一层配置错误都可能引发事故。
| 超时类型 |
含义 |
设错了会怎样 |
connectTimeout |
TCP 建连的时间上限 |
设太长:线程被卡住不释放,线程池被打满 |
readTimeout |
建连成功后,等待响应的上限 |
设太短:正常慢请求被当成失败,触发重试 |
关键认知:这两个超时是独立生效的。很多事故的本质其实是“连接超时设得合理,但读超时设得比下游正常耗时还短”。这就等于你自己亲手制造了一个必然失败的条件。
配置长这样:
feign:
  client:
    config:
      order-service:
        connectTimeout: 2000  # 2 秒建连
        readTimeout: 5000    # 5 秒等响应,必须 > 下游 P99 耗时
  retryer:
    Retryer.Default:
      period: 100  # 重试间隔
      maxPeriod: 1000
      maxAttempts: 1  # 非幂等接口必须设为 1,即不重试
最后那行 maxAttempts: 1 是重点,下面细说。
生活化比喻:催菜催出三碗面
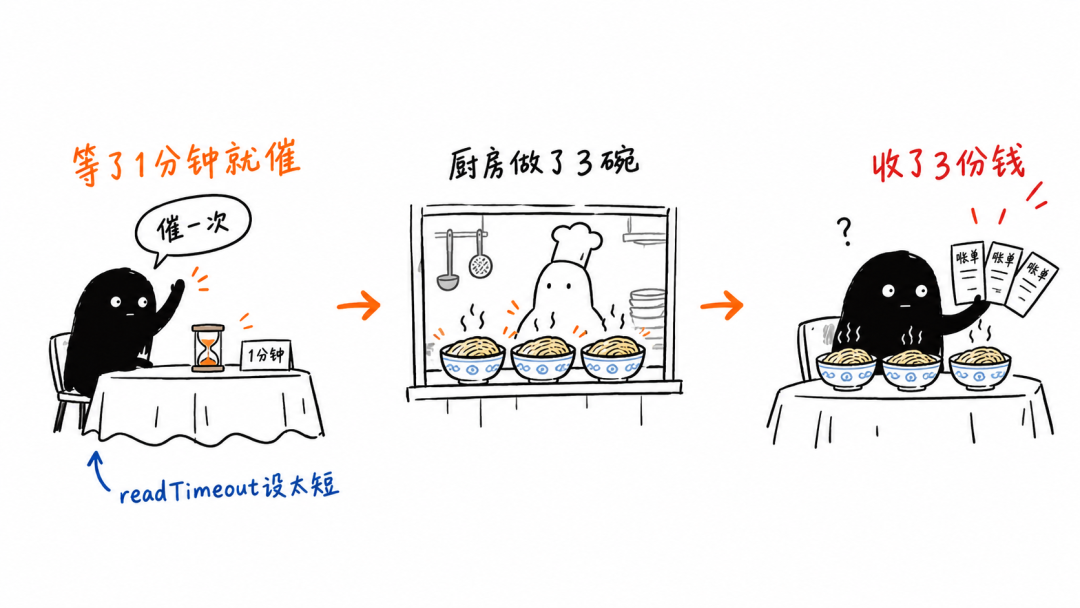
你在餐厅点了一碗牛肉面。
- 第 1 分钟没上 → 你催服务员:“好了吗?”
- 第 3 分钟还没上 → 你又催:“到底好了没?”
- 第 5 分钟 → 你第三次催
于是厨房收到了三条“来一碗牛肉面”的指令,端出来三碗。结账时你被收了三份钱。
复盘这个场景,其实存在两个致命问题:
- 你的等待耐心(readTimeout)设得太短了——后厨正常出餐要 8 分钟,你 3 分钟就催一次,注定每次都在“催已经在下锅的面”。
- “下面条”这个动作不幂等——每执行一次就真的多做一碗。如果当初点单时给的是“取餐号 #827”,厨房看到重复请求知道是同一个订单,就不会做三碗。
现实中的服务调用完全一样。重试发生在网络层,下游根本不知道“这是重试还是新请求”——除非你主动告诉它。
核心机制:幂等性是唯一的解药
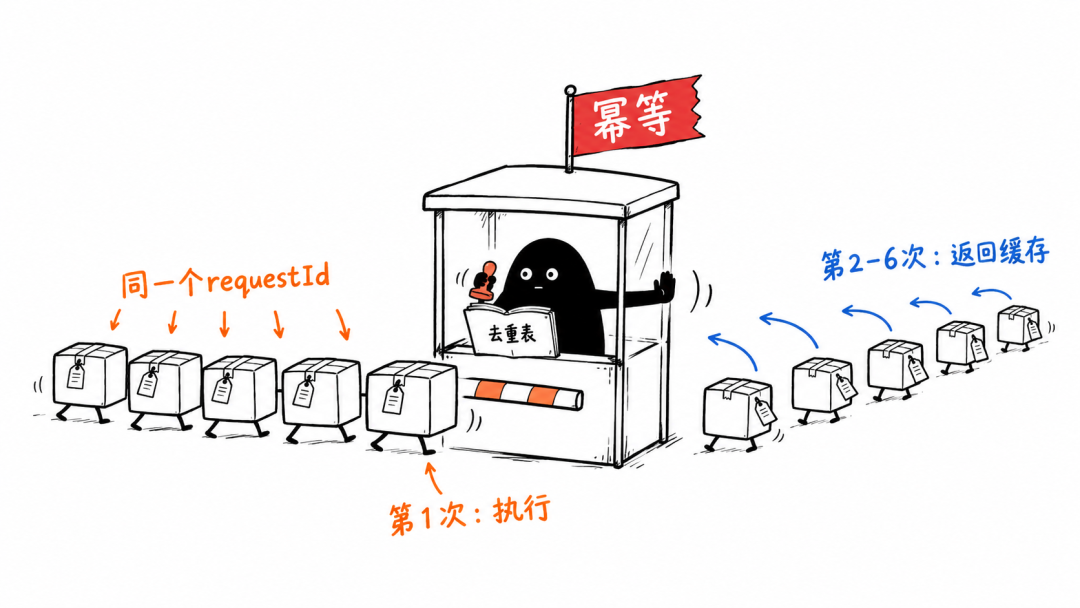
幂等性(Idempotency)的定义很朴素:同一个操作执行一次和执行多次,效果是相同的。
- 查订单(GET):天然幂等,随便重试
- 创建订单(POST):默认不幂等,必须自己实现
实现手段主要有三种,这里按可靠性从高到低排序:
方案一:唯一请求 ID + 去重表(最稳)
调用方生成一个全局唯一 ID(比如 UUID),跟着请求一起发。下游每次先查这个 ID 是否处理过:
// 调用方:生成唯一 ID 放进 header
String requestId = UUID.randomUUID().toString();
feignClient.createOrder(requestId, orderDTO);

// 下游:先查去重表,处理过就直接返回上次结果
if (dedupTable.exists(requestId)) {
    return dedupTable.getResult(requestId); // 直接返回,不重复执行业务
}
Order order = doCreateOrder(orderDTO);
dedupTable.save(requestId, order); // 记下来,供下次重试命中
return order;
方案二:数据库唯一约束(最简单)
订单号做唯一索引。重试时插入记录会撞上唯一键,捕获异常后查询已有记录返回即可。代价是会给数据库带来不可避免的无效写入压力。
方案三:Token 机制(防重复提交,但不防重试)
前端先取一个 token,提交时带上,服务端消费掉。这个只能防用户连点,防不了 Feign 重试,因为重试是服务端发起的。
重试到底该怎么配
三条原则,按优先级严格执行:
- 非幂等接口,直接关闭重试。创建订单、支付、发货这类接口,
maxAttempts 设成 1。宁可让上游收到失败,也不能让下游重复执行。
- 只给幂等接口开重试,且必须带退避(Backoff)。固定间隔重试等于有节奏地击打下单服务;指数退避(100ms → 200ms → 400ms)能给下游留出喘息空间。
- 重试次数坚决不要超过 3 次。重试是兜底手段,不是常态操作。如果 3 次都失败,说明下游已经出了大问题,应该立即走熔断降级而不是继续无脑重试。
顺带说一句,Retryer.Default 的默认值是 maxAttempts=5(加上首次共 6 次)。什么都不配,就等于默默接受了 6 倍的流量放大。
面试速记卡
Q:Feign 的 connectTimeout 和 readTimeout 有什么区别?
A:connectTimeout 是 TCP 三次握手建连的时间上限,超了说明网络不通或对端没监听;readTimeout 是建连成功后等待响应的时间上限,超了说明对端正在处理但速度太慢。两个独立生效,配置时必须让 readTimeout 大于下游接口的 P99 耗时。
Q:为什么重试会导致重复下单?
A:重试发生在网络层,下游无法区分“这是新的请求”还是“上次那个请求的重复投递”。如果接口不是幂等的,重试就会造成业务重复执行。解法是调用方传唯一请求 ID,下游用去重表拦截。
Q:Feign 默认重试几次?怎么改?
A:Retryer.Default 默认 maxAttempts=5,即首次 + 5 次重试共 6 次请求。通过注册 Retryer.NEVER_RETRY 关闭,或自定义 Retryer Bean 控制次数和退避间隔。
Q:怎么判断一个接口能不能开重试?
A:看幂等性。GET、PUT、DELETE 天然幂等(幂等的 PUT 指同一份数据覆盖写入),POST 通常不幂等。不确定的一律不开重试。
Q:重试和熔断是什么关系?
A:重试是“再试一次,也许能成功”;熔断是“连续失败太多次,先别试了”。两者配合使用:重试 2-3 次仍失败就立即触发熔断,直接返回降级响应,杜绝流量继续放大。
这篇在知识体系里的位置
属于「分布式」分类。之前讲过分布式锁(防并发)和 2PC/TCC(跨服务事务一致性),这篇讲的是可靠性工程里的第三条腿:幂等性。
三者解决的是不同维度的问题:
| 机制 |
防御目标 |
典型场景 |
| 分布式锁 |
多个请求同时改同一份数据 |
秒杀扣库存 |
| 2PC/TCC |
跨服务操作需要一起成功或一起失败 |
跨行转账 |
| 幂等性 |
同一个请求被重复投递 |
超时重试、消息重投 |
新增知识点:Feign 双层超时模型、Retryer 默认行为、幂等性三种实现方案、重试风暴的雪崩原理。
数据来源
 发表于 2 小时前
|
查看: 1|
回复: 0


