过去提到 NPU,通常想到的是手机、摄像头或者 AI 加速器。它负责执行神经网络模型,与 CPU、GPU 共同完成计算任务。
但现在,NPU 的应用范围开始向传统数据处理芯片延伸。10 月 28 日,芯片 IP 厂商 Ceva 发布新一代 NeuPro NPU 产品组合,其中 NeuPro Ultra 开始面向 AI 基础设施,包括智能内存、连接和数据处理芯片。
Ceva 新一代 NeuPro 产品组合将应用范围扩展至 AI 基础设施。(图片来源:Ceva 官网新闻稿)
01|为什么数据处理芯片也需要 NPU?
传统内存控制器主要负责地址映射、读写调度和数据传输;网络芯片则承担报文解析、转发和流量管理。这些任务通常由固定功能硬件、嵌入式 CPU 或专用处理引擎完成。
随着 AI 进入更多系统,部分数据处理任务也可能引入神经网络推理。例如,网络设备可以利用模型辅助流量分析,存储系统可以尝试通过学习访问模式优化资源调度。
NeuPro Ultra 面向智能内存、连接和数据处理等 AI 基础设施应用。(图片来源:Ceva 官网)
这类任务如果全部交给通用 CPU 处理,可能带来额外的计算和数据搬运开销。将 NPU 集成到数据处理 SoC 中,可以为特定 AI 任务提供本地计算能力。
但这并不意味着 NPU 会取代内存控制器或网络处理器。传统控制逻辑仍然需要专用硬件完成,NPU 主要承担适合神经网络执行的部分。
02|NPU进入数据路径,架构需要怎么改?
过去,NPU 通常作为 SoC 中的独立计算模块,通过片上互连访问内存,由 CPU 负责调度。
如果 NPU 进入网络或存储芯片,设计重点就会发生变化。
首先是数据位置。网络报文、存储请求和内存访问数据可能具有不同的数据格式与处理粒度。如果为了执行一个小型模型,需要频繁复制数据,搬运开销就可能抵消 NPU 的计算收益。
NPU 与片上存储、互连和数据处理模块的协同关系,是系统集成的重要设计因素。(图为 Ceva 官网 NeuPro 产品页)
其次是任务调度。网络和存储系统对延迟比较敏感,NPU 推理任务不能随意阻塞原有数据路径。因此,NPU 与 DMA、片上缓存、CPU 及固定功能处理单元之间的协同,将直接影响系统效率。
最后是资源配置。NPU 需要占用芯片面积、片上存储和功耗预算,设计者必须判断哪些任务值得使用神经网络,哪些继续交给传统硬件。
03|Ceva的新方向带来哪些架构启发?
Ceva 此次推出的新一代 NeuPro 产品组合,强调统一架构和软件开发环境,覆盖从端侧设备到 AI 基础设施的不同应用。
官方公布,相较第一代 NeuPro,新产品组合的单位面积 AI 吞吐最高提升 2 倍,能效改善 50%。从 SoC 设计角度看,这个方向带来了一个值得研究的问题:计算资源是否一定要集中配置?
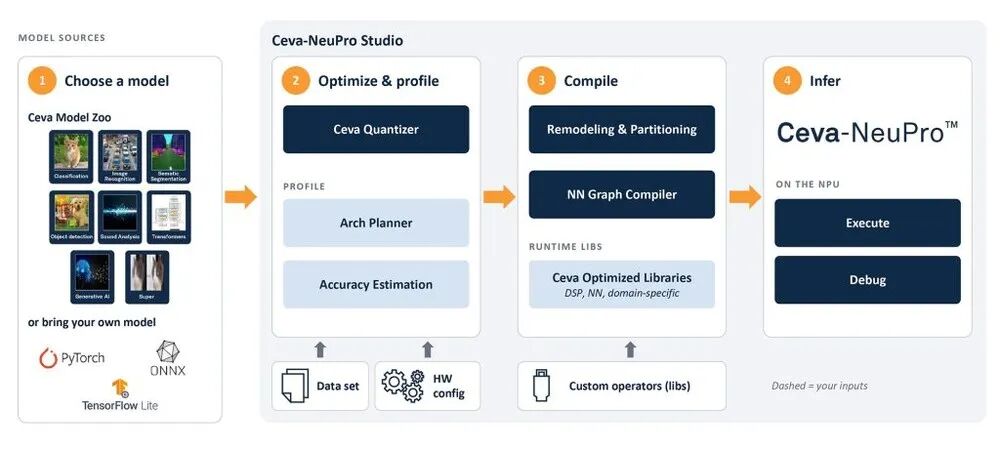
新一代 NeuPro 产品组合强调计算效率与不同 SoC 应用场景的适配能力。(图为 Ceva 官方 Ceva-NeuPro Studio 统一软件开发环境流程图)
传统 SoC 通常将 CPU、NPU 等计算资源与数据处理模块通过片上互连连接。当数据处理任务需要 AI 推理时,数据可能需要经过多次搬运才能进入计算单元。
如果将 NPU 部署在靠近网络、存储等数据处理模块的位置,部分任务就有机会在本地完成,减少跨模块的数据传输。
但这种设计也意味着更多的片上存储、功耗和面积开销。对于数据量较小、调用频率不高的任务,共享 NPU 可能依然更合适。
NPU 进入内存和网络芯片,给 SoC 设计提供了一种新的资源配置思路:让计算能力靠近数据,而不是让所有数据都去寻找计算资源。
这也是 Ceva 此次产品方向最值得关注的地方。对于长期关注 计算机体系结构 和芯片设计演进的设计者来说,这种从“集中算力”向“数据附近算力”的转变,值得继续观察。
 发表于 前天 22:47
|
查看: 19|
回复: 0
 /1


