过去两年,AI 芯片讨论里最热的关键词之一是 HBM。
原因很简单:GPU 算力增长得太快,模型也越来越大,真正限制系统性能的东西,越来越不是“算不动”,而是数据喂不进去、模型装不下。
但 HBM 也有一个很现实的问题:它很快,却不便宜;带宽很高,但容量扩展并不轻松。
于是 Sandisk 提出了一个很有意思的方向:HBF,High Bandwidth Flash,高带宽闪存。
它想做的事情听上去甚至有些“反常识”:
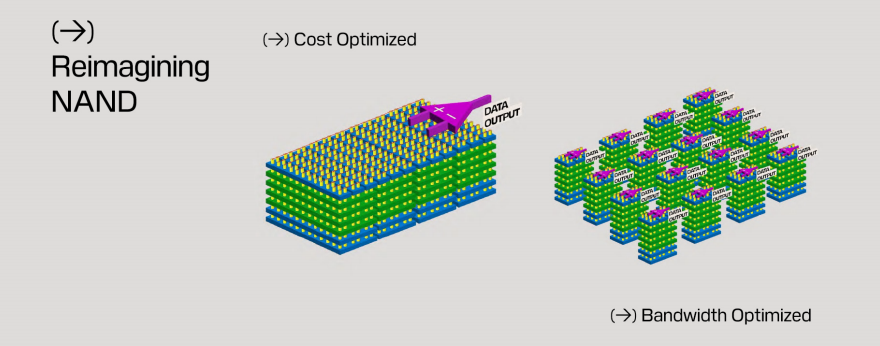
既然 NAND 的容量大、成本低,为什么不能像 HBM 一样,把大量 NAND die 高度并行起来,再通过先进封装和专用逻辑,把总带宽堆到 TB/s?
这就是 HBF 的核心思路。
但理解 HBF 最重要的一点,是不要被“1.6 TB/s”这样的数字带偏。
HBF 并不是把 NAND 变成了 HBM。
它真正有价值的地方,是试图在 HBM 和传统 SSD 之间,创造一个新的 memory tier。
一、AI 推理现在缺的,不只是带宽,而是“高带宽的大容量”
对于传统 GPU,内存系统大体可以理解成这样:
GPU Compute
    │
    ▼
HBM
    │
    ▼
DDR / CXL Memory
    │
    ▼
SSD / NAND
越靠近 GPU,速度越快、延迟越低,但容量越小、成本越高。
HBM 处在这个金字塔最靠近计算单元的位置。它最大的优势,是极高带宽和较低访问延迟。
问题在于,大模型推理正在同时要求两件过去很难兼得的事情:
第一是带宽。 GPU 每生成一个 token,都需要不断读取模型权重、KV Cache,以及各种中间数据。
第二是容量。 几百亿、几千亿参数模型,尤其是 MoE 模型,工作集可能大到单颗 GPU、甚至单台服务器的 HBM 根本装不下。
Sandisk 在 HBF 的技术资料里把这个矛盾说得非常直接:AI inference 同时需要更大的带宽和更高的容量,而其认为 HBM 在容量、功耗和成本方面存在扩展约束。HBF 的目标,是用 NAND 提供 HBM 约 8~16 倍的容量,同时保持相近的带宽等级。
这句话听起来很有冲击力。
但真正值得研究的不是“8~16 倍”,而是:
NAND 明明比 DRAM 慢很多,为什么还能做出 TB/s 级带宽?
这恰恰是 HBF 最值得讨论的地方。
二、HBF 的秘密:不是让一颗 NAND 变快,而是让大量 NAND 同时工作
先讲一个非常重要的概念:
单颗存储介质的延迟,和整个存储系统的总带宽,是两回事。
假设一条高速公路上的一辆卡车跑得不快。提高运输能力有两种办法。一种办法,是让卡车本身跑得更快。另一种办法,是同时修几百条车道,让几百辆卡车并行运输。
HBM 更接近前一种思路加大量并行:DRAM 单次访问本身已经很快,同时又拥有极宽的接口。
而 HBF 的思路,更像把 NAND 的第二条路走到极致:
单个 NAND die 依然不是低延迟器件,但同时让大量 die、plane、channel 工作,最终把 aggregate bandwidth 做得非常高。
因此,理解 HBF 最核心的公式不是 NAND ≈ HBM,而是:
HBF 总带宽 ≈ NAND Die 吞吐量 × Die 并行度 × Plane/Channel 并行度 × 高速接口效率 × Controller 调度效率 × 封装互连效率
这也是为什么 HBF 本质上是一项系统工程,而不只是 NAND cell 本身的创新。
三、CBA:HBF 背后的关键技术之一
Sandisk 在材料里反复强调一项技术:CBA,CMOS directly Bonded to Array。
简单理解,就是把负责控制、I/O 和外围逻辑的 CMOS,与 NAND Array 通过键合方式进行组合,而不是像传统 NAND 那样让所有逻辑和存储阵列在布局上互相妥协。
这种架构的价值,是可以分别优化:
- NAND Array → 追求容量和密度
- Logic / CMOS → 追求高速 I/O、控制逻辑和并行能力
然后再将两者连接起来。
Sandisk 将 CBA、先进 die stacking 和热机械设计列为 HBF 的核心基础,并称其 16-die 堆叠需要解决 die warpage、stress 和 thermal conductivity 等问题。HBF 同时保留 NAND 的非易失性,因此断电后数据不会丢失,也不需要 DRAM 那样的 refresh power。
这也是 HBF 与“把普通 SSD 接到 GPU 上”最大的不同。
普通 SSD 的数据路径可能是:
NAND
 ↓
Flash Controller
 ↓
PCIe
 ↓
GPU I/O
 ↓
HBM
 ↓
GPU Core
而 HBF 想把 flash 进一步推近 GPU:
HBF NAND Array
 ↓
HBF Logic / Controller
 ↓
高带宽封装接口
 ↓
GPU / xPU
也就是说,它试图从传统 storage,向 memory-like tier 靠近。
四、第一代 HBF 的数字确实很激进:512GB、1.6TB/s
Sandisk 给出的第一代 HBF 参数是:
| 指标 |
HBF Gen 1 |
| 单 die 容量 |
256Gb |
| Stack die 数 |
16 |
| 单 stack 总容量 |
512GB |
| Read Bandwidth |
1.6TB/s |
| 介质 |
NAND Flash |
| 非易失性 |
是 |
材料同时声称,其封装尺寸、功耗 profile 和 stack height 接近 HBM4。
这个容量是什么概念?256Gb 相当于 32GB。16 个 die:32GB × 16 = 512GB。
如果一个 accelerator package 上可以部署多个 HBF stack,那么理论上单颗 accelerator 周围就可能出现 TB 级本地存储容量。
Sandisk 在第二页的示意图中,就展示了从约 192GB HBM 配置,扩展到超过 3TB、甚至约 4TB 总内存容量的概念性配置。
这里才是 HBF 真正的杀手锏。不是单纯的 1.6TB/s,而是:几百 GB 乃至 TB 级容量,同时仍然拥有 TB/s 级 aggregate read bandwidth。
传统 SSD 容量当然也能做到 TB 级。问题是传统 SSD 到 accelerator 的路径太长、接口带宽太低。HBM 的带宽非常高,但容量昂贵。HBF 正试图填补两者之间的巨大空档。
五、但有一个必须讲清楚的问题:1.6TB/s ≠ HBM
这是理解 HBF 最重要的一部分。
Sandisk 自己其实在脚注里已经承认:HBF 相比 HBM 具有 higher latency 和 larger page size。
也就是说,HBF 的访问粒度和延迟特征依然与 HBM 不同。因此,HBF 1.6TB/s 绝不能简单理解成 HBF 的访问行为 = 1.6TB/s 的 HBM。两者解决的问题不同。
举个例子。如果 GPU 连续读取一个巨大的模型权重矩阵——地址 A、A+1、A+2、A+3……访问十分连续。这时可以提前把 NAND page 读出来,同时让大量 NAND die 并行工作,HBF 很可能表现得非常好。
但如果 GPU 的访问是:刚读地址 A,突然跳到地址 Z,然后访问 M,再访问 B,而且每次只需要几十个 byte。那么 NAND 较大的 page size 和更高的 read latency 就会暴露出来。
所以,HBF 的真正问题并不是“带宽有没有 1.6TB/s?”,而是:
真实 GPU workload 能不能持续产生足够大的并行请求,把这 1.6TB/s 吃满?
这两个问题的区别非常大。
六、Sandisk 的“只比无限容量 HBM 慢 2.2%”,应该怎么理解?
HBF 资料里最容易被传播成标题党的数字,大概就是这个:HBF 性能只比 unlimited-capacity HBM 低 2.2%。
这个数字必须看脚注。它并不是一个完整 HBF 芯片在服务器里运行真实模型得到的公开 benchmark。Sandisk 明确说明,这是 internal testing and simulation。
测试对象是 Llama 3.1 405B,模型权重是 8-bit pretrained weights,而且强调的是 one kernel is executed on the xPU performance model at a time。
更重要的是,为了比较访问性能,其模拟中的 HBM 被假设成容量无限——也就是说,这个实验刻意没有让 HBF 的容量优势参与比较。
所以这个结果能证明什么?可以证明:在一个以读取大模型权重为主、访问模式适合 HBF 的 inference simulation 中,较高 NAND latency 和更大的 page size 并没有造成严重性能下降。这是一个值得重视的结果。
但它不能证明 HBF = HBM,也不能证明所有 AI inference workload 只慢 2.2%,更不能证明 training 也可以如此。
七、HBF 最适合的,其实是“模型权重”
如果从 workload 而不是产品宣传出发,HBF 最自然的应用对象其实很清楚:LLM Weights。
原因是大模型权重具有三个非常适合 HBF 的特点。
第一,容量巨大。第二,推理时绝大部分权重是读多写少,甚至基本不写。第三,大量 GEMM/GEMV 操作具有较好的 streaming 特征,可以做 prefetch,也比较容易制造并行度。
比如一个 405B 参数模型。如果使用 INT8:405B parameters × 1 byte ≈ 405GB。理论上,一颗 512GB 的 HBF stack 就已经接近能容纳整个模型权重。
这会带来非常重要的系统变化。今天如果 HBM 放不下模型,通常只有几种办法:
把模型拆到更多 GPU
        ↓
增加 NVLink / Network 通信

或者

把权重放 DDR / SSD
        ↓
不断搬进 HBM
而如果 accelerator 周围拥有数百 GB 乃至 TB 级 HBF:
Model Weights
      ↓
     HBF
      ↓
 GPU Compute
很多原本因为“容量不够”而发生的数据搬运,就可能消失。这很可能比单纯提高 NAND 的峰值带宽更有价值。
八、真正值得关注的 HBF 场景,可能是 MoE
HBF 在 MoE 模型上的潜力甚至可能比普通 dense model 更有意思。
MoE 的特点是:模型总参数量巨大,但每一个 token 实际只激活其中少数 expert。假设系统拥有大量 expert——Expert 1、Expert 2、Expert 3……直到 Expert 256。如果全部放 HBM,非常浪费昂贵容量。但如果放 SSD,需要时再读取,又可能太慢。
一种更合理的层级可能变成:
GPU
 │
HBM
 │
HBF
 │
SSD
把最热门的 expert 放在 HBM。大量冷一些的 expert 常驻 HBF。再由软件预测下一批 token 需要哪些 expert,提前 prefetch。
这种情况下,HBF 不需要拥有 HBM 一样的单次访问 latency。只要预测足够准确、prefetch 足够早、并发度足够高、bandwidth 足够大,就有可能把 NAND latency 隐藏掉。
这才是 HBF 真正值得关注的架构方向。
九、KV Cache 就没有那么简单
看到“512GB 高带宽 NAND”,很多人自然会想到 KV Cache。容量上确实非常诱人。长上下文推理越来越多以后,KV Cache 可以达到几十 GB、几百 GB,甚至更高。
但 KV Cache 和模型权重有本质区别。模型权重近似于不断地 Read、Read、Read。而 KV Cache 则不断发生 Write new KV、Read previous KV、Write、Read 的交错操作。
这就触碰到了 NAND 最大的弱点:write latency、erase granularity 和 endurance。
Sandisk 在材料里特别强调 HBF 将使用先进 reliability 和 redundancy management 来解决 endurance 和高温数据中心环境的问题。但这只能说明厂商意识到了问题。资料并没有给出 P/E cycle、DWPD、TBW、write amplification、随机写性能、写延迟或 tail latency。
所以目前更合理的判断是:HBF 对模型权重的适配度明显高于 KV Cache。 KV Cache 能否成为核心 workload,要等真正的写性能和 endurance 数据。
十、Training 更不能直接套用 inference 的结论
HBF 的资料非常明确地把目标定位在:AI inference。这是合理的。
Training 对 memory system 的要求明显更加苛刻。训练不仅要读 weights,还要处理 Weights、Activations、Gradients、Optimizer States,而且不断发生写入和更新。
这意味着 memory workload 更接近 Read + Write + Random Access + Fine-grained Access,而不是纯粹的 streaming read。这恰恰是 NAND 相对于 DRAM 最不利的区域。
因此,就目前公开材料而言,最合理的位置仍然是:
Training
HBM >>> HBF

Inference Weights
HBF 很有潜力

Inference KV Cache
有潜力,但存在明显疑问
不能因为 HBF 在一个 inference simulation 中表现接近 HBM,就进一步推出“以后 AI GPU 不需要 HBM 了”。这个结论现在还远远站不住脚。
十一、所以 HBF 到底是 HBM Killer 吗?
目前看,我认为答案更接近:不是 HBM Killer,而是 HBM Augmenter。
实际上 Sandisk 第一页自己的架构图就使用了“Augmenting HBM Memory with NAND Flash for AI Inference Workloads”这样的定位。
从 memory hierarchy 看,HBF 最合理的位置可能是:
            Latency ↓
            Cost/bit ↑

        GPU Registers
             │
        SRAM / Cache
             │
            HBM
             │
   ┌──────── HBF ────────┐
             │
         DDR / CXL
             │
            SSD

            Capacity ↑
            Cost/bit ↓
它的位置非常关键。它不是传统 SSD——因为其目标带宽和封装位置明显更靠近 accelerator。它也不是传统 HBM——因为 NAND 的 latency、page size、写特性仍然存在。
所以 HBF 更像一种:Near-Compute High-Bandwidth Capacity Tier,中文可以理解为靠近计算单元的高带宽容量层。如果这个 tier 能成立,其系统意义其实可能比“替代 HBM”更大。
十二、为什么几百 GB 的 HBF 可能比更快的 HBM 更值钱?
AI 系统里有一个经常被忽略的问题:很多时候,GPU 数量不是由算力决定的,而是由内存容量决定的。
比如一个模型因为权重太大,本来需要 8 GPUs。但真正计算时,每张 GPU 都没跑满——只是因为模型必须拆开放。这时增加更多 GPU,其实是在“买 HBM”。
如果 HBF 能把单 accelerator 可访问容量从几百 GB 提高到 TB 级,就有可能出现这样的变化:
Before:
更多 GPU → 更多 HBM → 更多互联 → 更大功耗 → 更高成本

After:
更少 GPU + HBM + 大量 HBF
那么真正下降的就不仅仅是 memory cost。还可能包括:GPU 数量、网络交换机、NIC、板级功耗以及集群通信开销。 这才是 HBF 真正可能改变 AI economics 的地方。
十三、最终评价 HBF,不能只看 TB/s,要看 $/token
对于 AI 基础设施而言,最重要的指标最终不是 TB/s,甚至不是 GB,而是 $/token。
HBF 能否降低 $/token,大概取决于这样一条链条:
更多模型可以驻留在本地
            ↓
减少 SSD / Host Memory 搬运
            ↓
减少模型切分和 GPU 间通信
            ↓
更少 GPU 即可运行大模型
            ↓
GPU utilization 提高
            ↓
系统成本 / 功耗下降
            ↓
$/token 下降
注意,这里面任何一个箭头断掉,商业价值都会大幅缩水。比如 HBF 容量虽然很大,但实际访问 latency 导致 GPU 经常 stall——GPU 算力一直在等待数据、等待数据、等待数据,那么 512GB 就只是“装得下”,而不是“跑得快”。
所以:模型能放进去,与模型能高效运行,是两件完全不同的事情。
十四、HBF 目前最大的未知数,不是容量,而是“有效带宽”
Sandisk 已经公布 1.6TB/s。但对于架构师而言,我反而更关心另外一些数字:
- 典型 read latency 和 P99/P999 tail latency 是多少?
- 1.6TB/s 是多大 request size 下测出来的?
- 顺序访问还是随机访问?
- 有多少并发 request?
- 最小有效访问粒度是多少?
- NAND page size 是多少?
- GPU cache miss 如何映射成 NAND transaction?
- ECC 位于哪里?
- controller 有多大 SRAM?
- 是否存在 read disturb、GC 或 background management?
- write bandwidth 和 endurance 到底是多少?
- 16-die stack 的热阻和良率如何?
- 多个 HBF stack 同时跑满后,package power 会是多少?
这些问题才真正决定 Peak Bandwidth → Effective Bandwidth → GPU Delivered Performance 中间会损失多少。而这些数据,目前这份 fact sheet 并没有给出来。
十五、2TB/s、3.2TB/s 和 1.5TB:先把它们看成 Roadmap
Sandisk 也公布了 HBF 后续规划。Gen 2 预计 read bandwidth 超过 2TB/s,容量最高达到 1TB;Gen 3 预计达到 3.2TB/s,容量最高达到 1.5TB。同时功耗目标分别下降到 Gen 1 的 0.8× 和 0.64×。
如果这些数字真正实现,HBF 会非常有意思。但必须强调:这是 projected / expected roadmap,不是量产 benchmark。
尤其是 1.5TB stack + 3.2TB/s 这种组合,背后同时要求 NAND scaling、die parallelism、高速 logic、advanced bonding、thermal、yield、controller、ECC、package power——任何一个环节掉链子,都可能影响最终产品。所以目前不能把 Gen 3 roadmap 当成已经存在的器件。
十六、从产业化角度看,HBF 还处在哪个阶段?
这份资料中有一个非常容易误读的地方。Sandisk 的 BiCS NAND 和 CBA 基础技术本身具有量产基础。但这并不等于 HBF 已经成熟量产。
目前材料明确提供的,是产品架构、目标规格,以及部分 internal testing / simulation。尤其是“与 unlimited HBM 相差 2.2%”的结果,Sandisk 自己明确注明属于内部测试和 simulation。
所以从产业成熟度角度,更稳妥的判断应该是:
Concept           ✓
Architecture      ✓
Specification     ✓
Simulation        ✓

First Silicon     需要进一步确认
Sample            需要确认
Qualification     尚无充分公开信息
Mass Production   不能从这份材料判断
这和“BiCS NAND 已经大规模制造”完全是两个层次的问题。
十七、真正决定 HBF 成败的,其实只有一个问题
把所有技术细节都拿掉以后,HBF 的命运最终取决于:
能不能让 GPU 感觉自己访问的是一个“足够快的大容量 memory tier”,而不是一个“非常快的 SSD”。
二者只有一线之隔。
如果最终表现是 512GB + 1.6TB/s Peak,但实际 AI workload 只有几百 GB/s,而且 GPU 经常等待 NAND latency,那么它很难成为核心 memory tier。
但如果通过 Massive parallelism + Prefetch + Large sequential reads + Caching + Software scheduling + Workload locality,真正把 NAND latency 隐藏掉,那么 HBF 就可能找到一个非常独特的位置。
结语:HBF 真正值得关注的,不是“HBM 的替代品”,而是一个新的内存层
HBF 最吸引人的地方,并不是 Sandisk 把 NAND 做到了 1.6TB/s。而是它提出了一个越来越重要的问题:
在 HBM 和 SSD 之间,是不是缺少一种新的 memory tier?
今天的 AI memory hierarchy 中,HBM 很快,但贵、容量有限。NAND 很便宜、容量巨大,但离 GPU 太远。HBF 的赌注就是:利用 NAND 的密度和成本优势,通过极端并行、CBA、先进封装和专用 controller,把 flash 推到足够靠近 GPU 的位置。
如果成功,它未必会消灭 HBM。未来反而可能出现:
                GPU / xPU
                    │
                  Cache
                    │
                   HBM
                    │
                   HBF
                    │
               CXL / DDR
                    │
                   SSD
HBM 负责最热、最敏感的数据。HBF 负责超大模型权重和较冷的大容量工作集。SSD 则继续承担真正的持久化存储。这可能才是 HBF 最合理、也最有价值的未来。
因此,对 HBF 最值得提出的问题,不是“NAND 能不能打败 HBM?”,而是:它能否在真实 AI inference workload 中,以比 HBM 更好的容量和成本、又以远高于 SSD 的可用带宽,形成一个长期存在的新 memory tier?
从 Sandisk 目前公布的架构看,这个方向在系统层面是成立的,而且对超大模型 inference 尤其值得关注。但从 1.6TB/s 的规格数字,到真正降低 $/token,中间仍然隔着 latency、访问粒度、controller、ECC、endurance、thermal、yield、software stack 和真实 workload benchmark 这一整条产业链。
HBF 最精彩的故事,可能才刚刚开始。云栈社区的技术板块里,关于这类新兴存储层级的讨论也逐渐多了起来,值得持续跟踪。
 发表于 5 小时前
|
查看: 4|
回复: 0


