用 AI 写代码的人,大概都经历过这种让人安心的时刻。
功能写完了,顺手补一句:“给它配一套单元测试。”几秒钟后,测试文件出来了:用例排得整整齐齐,命名规范,边界、异常、正常路径一样不缺。跑一下,全绿。覆盖率 92%。
你满意地合上电脑。两周后,线上出了个 bug,恰好就藏在那 92% 里。
复盘时你盯着测试报告,脑子里只剩一个问题:这些测试明明全过了,它们到底测了个啥?
答案有点扫兴:它们大概率只证明了一件事——你的代码确实是那么写的。 至于“那么写”对不对,测试从头到尾没碰过。
这篇文章聊的就是这个:AI 写的测试为什么总是一把过,问题卡在哪个环节,以及怎么让它真正开始找错。
一套全绿的测试,和一个没人发现的洞
老规矩,先让问题现形。拿一个后台里再常见不过的功能来推演:订单页面上有个导出按钮,用户点了,系统生成文件,生成好了提供下载。里面有一条权限规则:
导出文件只有任务的创建者可以下载;另外,管理员也可以。
翻译成代码并不复杂:
function canDownload(user: User, task: ExportTask): boolean {
  // 只有创建者能下载——需求里的“管理员也可以”被漏掉了
  return task.ownerId === user.id;
}
注意,这段实现是有洞的:管理员那条规则,写代码的时候(不管人写还是 AI 写)给漏了。
现在把这段代码丢给 AI:“给它写单元测试。”你很可能会拿到这样的东西:
test('创建者可以下载自己的导出文件', () => {
  const user = { id: 'u1', role: 'user' };
  expect(canDownload(user, { ownerId: 'u1' })).toBe(true);
});

test('其他用户不能下载', () => {
  const user = { id: 'u2', role: 'user' };
  expect(canDownload(user, { ownerId: 'u1' })).toBe(false);
});
跑一下,全绿。两个用例,一正一反,看着挺周全。覆盖率工具也会告诉你:这个函数每一行、每个分支都被执行过了,100%。
但微妙的事实摆在眼前:这套测试里不会出现“管理员”三个字。 实现里没有这个角色,测试里就不会有。需求里的第二条规则,从代码到测试,悄无声息地消失了,没有任何一环报警。
直到某个管理员在线上点了下载,看到 403,工单进来,你才知道这条规则存在过。
问题出在哪?出在这套测试的信息来源上。
病根一:照着实现写测试,等于让被告给自己作证
测试的有效性从哪来?从一个有点哲学的原则:它必须来自一个独立于实现的信息来源。
需求是需求,代码是代码。测试站在需求这边,盯着代码发问:“你做到了吗?”两边一对质,不一致就报警。这是测试的全部意义——它是两个独立来源的交叉验证。
而 AI 写测试的默认姿势,是把这个结构拦腰斩断:
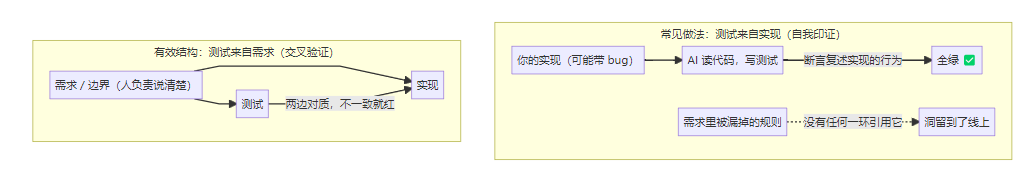
看上半张图。AI 拿到的是你的代码,它读代码、理解代码、然后描述代码的行为——写出来的断言,本质上是实现的复述。实现对了,测试证明它对;实现错了,测试照样证明它“对”,因为测试衡量的标准就是实现本身。
说白了,这是让被告给自己作证。证词当然永远有利。
canDownload 那套测试就是这么失效的:它验证的是“函数是否按照它实际的逻辑运行”,而不是“函数是否符合需求”。前者永远绿,后者才是你真正想知道的。
这里还有个陷阱会加重错觉:覆盖率。行覆盖、分支覆盖,衡量的是“代码有没有被执行到”,不是“行为有没有被验证对”。canDownload 的覆盖率是完美的 100%,洞也是实打实的。覆盖率报告里的绿色,和“没有 bug”之间的距离,比看上去远得多。
病根二:它默认你的代码是对的
就算 AI 偶尔从需求出发,它写测试时还有一个更深层的倾向:它默认你的代码基本是对的,任务是给它补一层保障。
这个倾向不奇怪。“给这段代码写测试”这个指令本身,就暗含着“代码写完了,基本能用”的前提。模型被训练成配合你的目标——你的目标是“通过”,它就奔着通过去。
于是它生成的用例有一种统一的气质:走在路中间。 输入是寻常的,状态是干净的,依赖是听话的。你给 canDownload,它就测“是创建者”和“不是创建者”,这属于功能的主干道。而那些真正会出错的地方,往往在路边上:
- 边界:导出上限是 1000 条,第 1000 条能不能导?第 1001 条呢?(实现里写的是
< 还是 <=?)
- 空态:一条订单都没有时点导出,该报错还是给空文件?
- 身份:被禁用的创建者还能不能下载?管理员算“其他用户”吗?
- 时序:文件还没生成完就点下载,会发生什么?
人写测试时也会偷懒,但一个被线上事故教育过的工程师,看到边界条件会本能地多写一个用例。AI 没有这种本能——它没被你的事故教育过。它写“创建者可以下载”时行云流水,你让它写“第 1001 条订单应该被拒绝”,它得先意识到 1000 是个边界,而这要求它怀疑你的实现。
怀疑,恰恰是它最不被鼓励做的事。
想感受这个差别,可以做个小实验:同一段代码,开两个会话。一个说“给它写单元测试”,另一个说“你是评审者,找出这段代码可能出错的所有场景”。对比两边列出的东西,后者通常长得不像同一个物种。
病根三:把真正会出错的地方 mock 掉了
还有第三种失效方式,更隐蔽。这回测试不是复述实现,甚至引用了需求——但它把会出错的部分换成了自己写死的替身。
比如导出功能里,点击取消要通知后台停止任务。AI 给页面写的测试可能是这样的:
test('点击取消后调用取消接口', async () => {
  // mock 掉整个任务服务:它永远乖乖返回成功
  const cancelMock = vi.fn().mockResolvedValue({ ok: true });

  renderExportPage({ cancelTask: cancelMock });
  await clickCancelButton();

  // 断言:mock 被调用了——但真实服务会不会执行,没人知道
  expect(cancelMock).toHaveBeenCalledWith('task-1');
});
全绿。但它证明了什么?证明了“按钮点击后会调用一个叫 cancelTask 的函数”。至于真实的任务服务收到请求后停不停、工作进程会不会在批次边界检查取消标记、已生成的临时文件删不删——全在 mock 的围墙外面。
集成当然要做取舍,mock 本身不是罪。问题在比例和意识:真实系统里,bug 最密集的地方恰恰是模块的接缝——序列化、时区、权限、重试、并发。AI 为了让测试稳定通过,倾向于把接缝全部 mock 平。接缝平了,测试稳了,bug 的藏身之处也就装修好了。
一条经验判断:mock 掉的东西越多,测试离“这个功能真的能用”就越远。 如果一个测试里 mock 的数量比断言还多,它多半是在测试自己的接线。
怎么办:把“需求”和“敌意”还给测试
聊到这,结论不是“别让 AI 写测试”。它写得快、覆盖全、不知疲倦,这些是真的。要改的是你给它的输入和位置。
第一,喂需求,不喂实现。 把那段权限规则的文字、边界清单、异常场景交给它:“根据这些规则写测试,不要看实现。”更好一点的顺序是让它先写测试,再写实现——测试从需求长出来,实现去通过测试,交叉验证的结构就保住了。你会发现同一个 AI,换一份输入,写出的测试攻击性完全不同。
第二,人负责回答一个问题:什么情况下算错? 这个问题 AI 答不好,因为它要求怀疑,而怀疑需要立场。你不需要手写每个用例,但“边界在哪、权限矩阵长什么样、哪些异常必须被处理”这张清单,得从知道业务风险的人那里来。清单给得越具体,AI 的测试越像回事。
第三,给它换一个角色。 前面那个小实验可以常态化:写完实现后,开一个新会话,不带实现背景,只给需求和代码,让它当对抗方——“找出这段代码会失败的场景”。把“证明对”和“找到错”拆成两个任务、两个会话,比指望一个会话里既建设又破坏要靠谱。
第四,偶尔给测试本身做一次测试。 思路很简单:故意把实现改坏一处,跑测试,看它红不红:
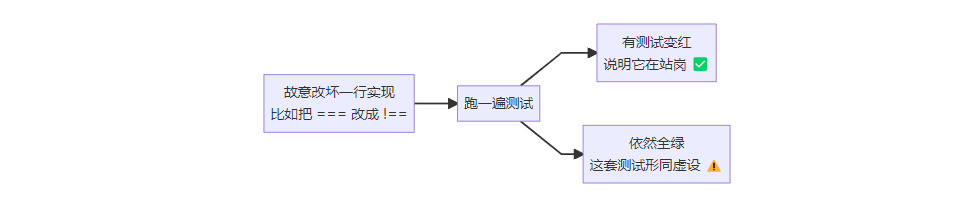
红,说明测试真的在盯着这行代码;还绿,说明这行代码的死活无人在意,覆盖率的绿色只是个安慰。这个做法有正式的名字,叫变异测试(mutation testing),JS 生态里有 Stryker 这类工具可以批量做这件事。不必全项目铺开,在核心链路上抽查一次,往往就能戳破几个“全绿”的泡沫。
写在最后
测试的全绿,是一种很容易被误读的信号。它真正的含义只是:“代码按它自己的方式运行了一遍。”
人写测试的时代,这个误读不太致命,因为写测试的慢,本身带着思考——你一边写一边在问“这里会不会错”。AI 把这个过程加速到几秒钟,思考的那部分被一并省掉了,只留下绿的形状。
所以,用 AI 写测试没问题,但别把“找错”这个职责也一并外包。让测试来自需求而不是实现,让边界清单来自懂业务的人,让“证明对”和“找到错”分开进行。如果你正打算系统性地补一补测试用例设计、自动化测试执行和持续集成环境下的测试实践,可以先从一套完整的单元测试方法论入手,把地基打牢。
一套测试的价值,从来不在于它通过的那一刻,而在于它本来有可能不通过。
 发表于 1 小时前
|
查看: 2|
回复: 0
 /1


