通常把 Prompt 交给云端模型,拿到的只是一串 token。服务商 究竟调用了宣传中的旗舰模型,还是临时换成了更小的模型?用户往往无从核验。
Anthropic 开源 FlashProve,把这个问题变成一道可验证的密码学命题:输出是否由事先锁定的指定模型,按照规定计算得出。它不要求服务商公开权重,也不要求用户重跑模型。
研究过程已开源,仓库和完整论文均可查看。
先给模型上锁,再检查每次推理
FlashProve 把流程拆成离线和在线两步。离线阶段,服务商为模型权重生成一份很短的隐藏承诺,相当于先给模型留下无法随意替换的密码学指纹。客户端保存这份承诺,不必下载规模可达 TB 的权重。
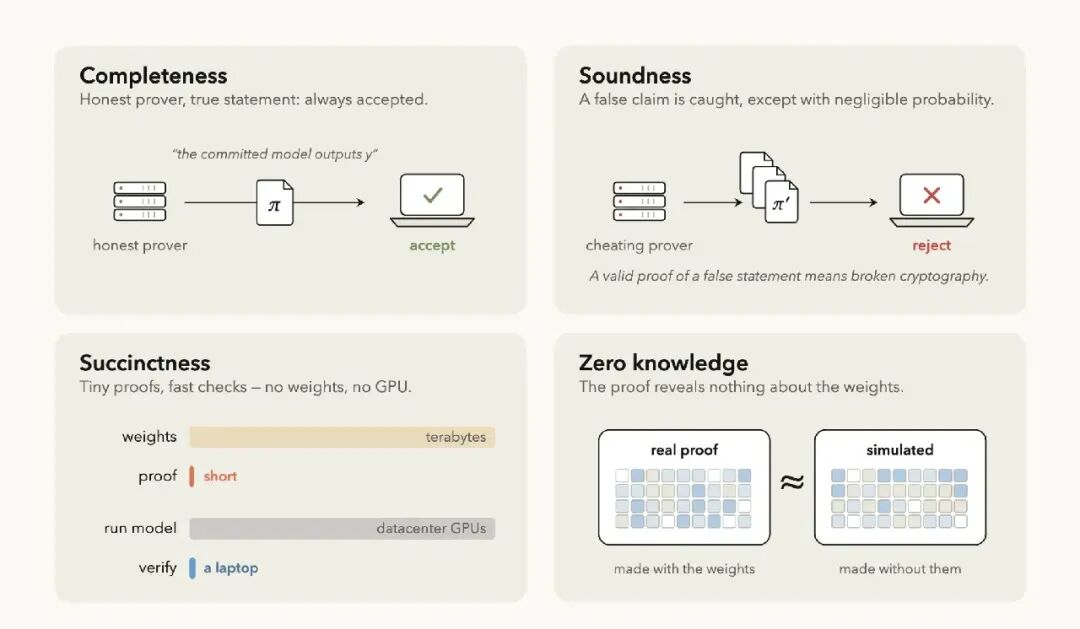
在线阶段,服务商除了返回答案,还要证明被检查的 token 确实来自承诺模型。这里的核心是两条保证:诚实的正确推理能够通过验证,更换权重或伪造计算则几乎不可能蒙混过关。同时,证明不会暴露权重和中间计算轨迹。
把巨大计算变成一次随机抽查
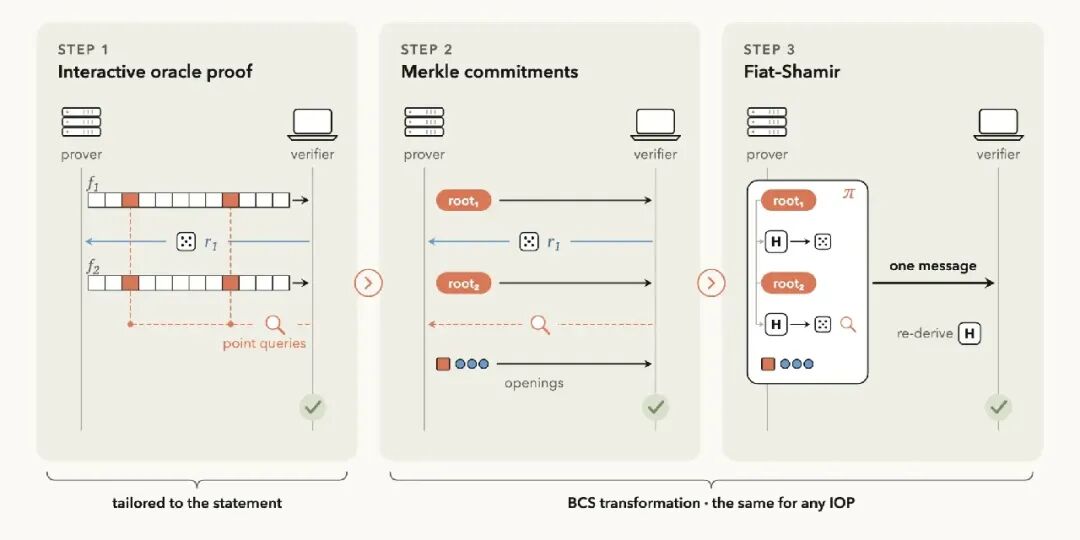
验证者不可能逐项重算,因此 FlashProve 先通过交互式预言机证明,把计算转换成带冗余的编码,再用少量随机查询发现错误。随后,Merkle 承诺把长消息压缩成短摘要,Fiat—Shamir 变换又把多轮交互折叠为一份证明。
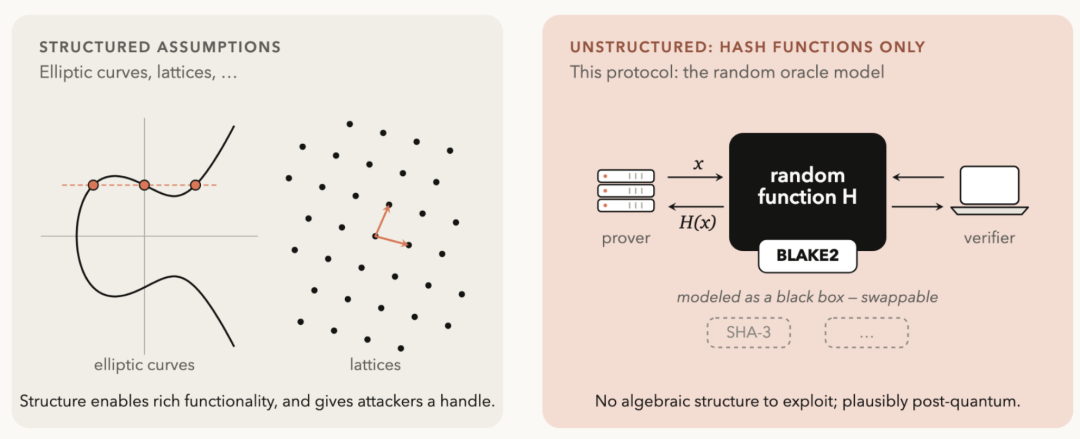
这条链路只依赖 BLAKE2 哈希等相对基础的密码学部件。论文在随机预言机模型下给出安全分析,并将方案定位为具有后量子安全潜力的简洁零知识证明。客户端看到的不是整段计算,而是可以快速核验的证据。
为什么 400B 模型先选择 MoE
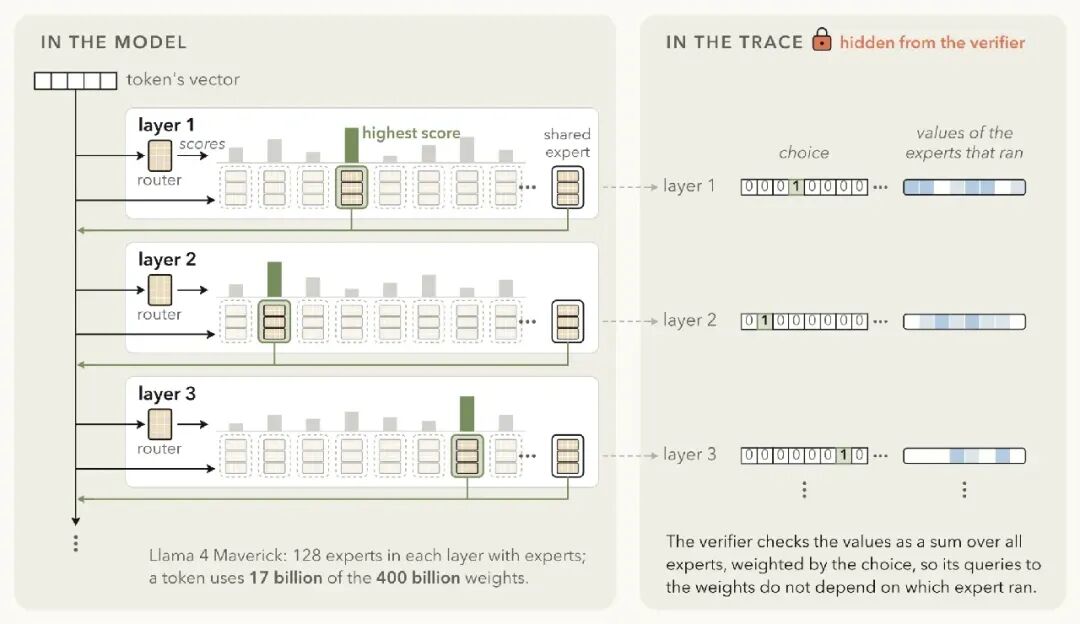
实验采用 Llama 4 Maverick。模型约有 4000 亿参数、128 个专家,但每个 token 在每个 MoE 层只激活一个路由专家和一个共享专家,实际动用约 170 亿参数。
这让证明者可以只记录被激活专家的计算轨迹,再验证路由选择是否正确。稀疏激活不仅节省推理成本,也减少了需要编码和证明的计算量。对非线性运算,系统使用查找表;对数值计算,则采用精确的 整数量化模型,避开浮点运算跨硬件难以复现的问题。
Lean 给密码学证明再加一层校验
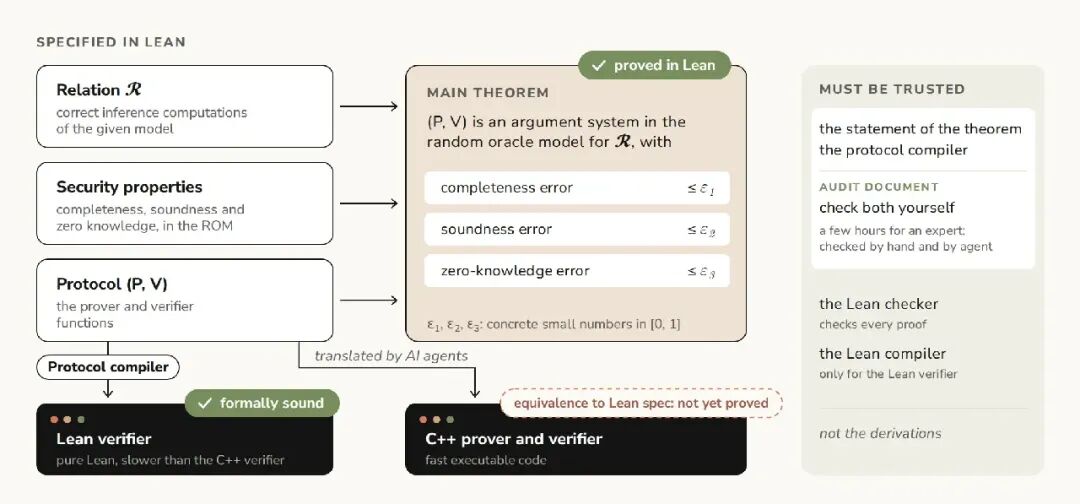
FlashProve 不只写出协议,还用 Lean 描述正确的推理关系、证明者与验证者算法,以及完备性、可靠性和零知识性质,并给出具体误差界。
论文同时提供直接由 Lean 编译的验证者。性能更高的 C++ 版本由 AI 智能体从 Lean 表示生成,但目前尚未证明两者形式等价。因此,数学协议已经走向机器校验,端到端实现的形式等价仍需补齐。
真正的突破藏在这组工程数字里
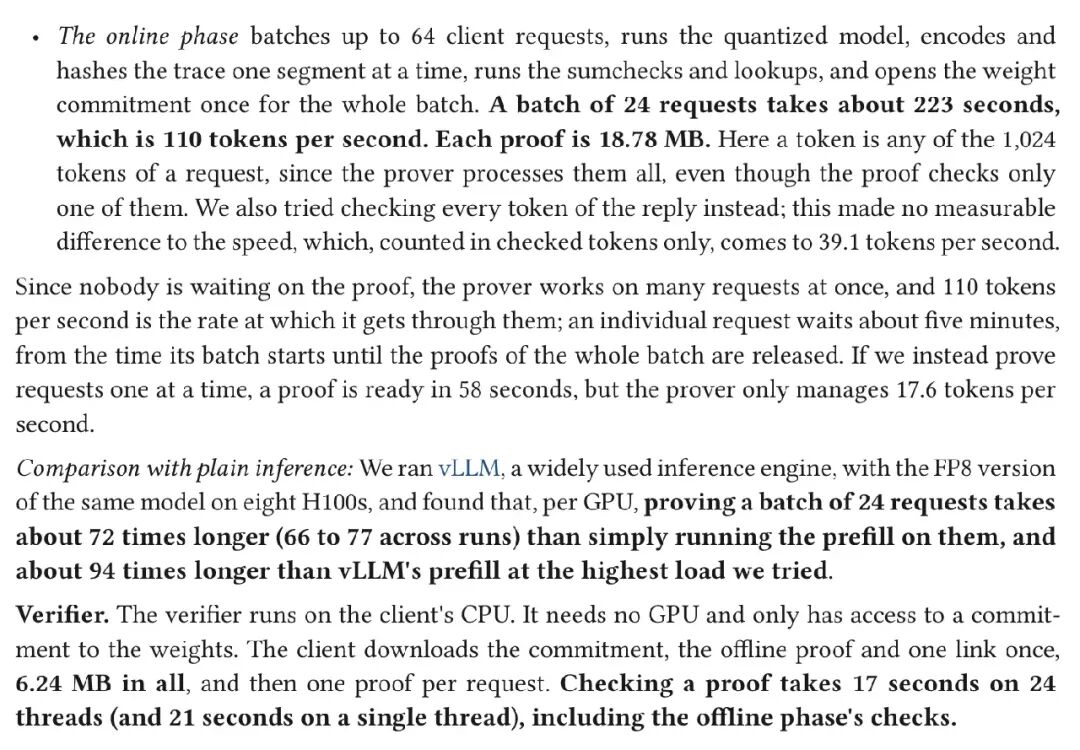
证明端使用单张 H100、24 个 CPU 核心和主机内存,232 GB 权重分批流入 80 GB 显存。24 个请求组成一批时,证明约需 223 秒,吞吐为每秒 110 个 token;单请求模式则约 58 秒出证明,吞吐降至每秒 17.6 个 token。
每份在线证明为 18.78 MB。客户端不需要 GPU,用 24 线程验证约需 17 秒,单线程约 21 秒。400B 模型证明能够在单 GPU 系统运行,而普通电脑可以独立验证,这才是可部署性的关键。
代价同样清晰:批处理模式下,单个请求约等待五分钟;按每 GPU 计,证明耗时约为普通 prefill 的 72 倍,在对比的最高负载下约为 94 倍。因此,当前设计采用事后生成证明,不让用户在线等待。
从可用原型走向基础设施
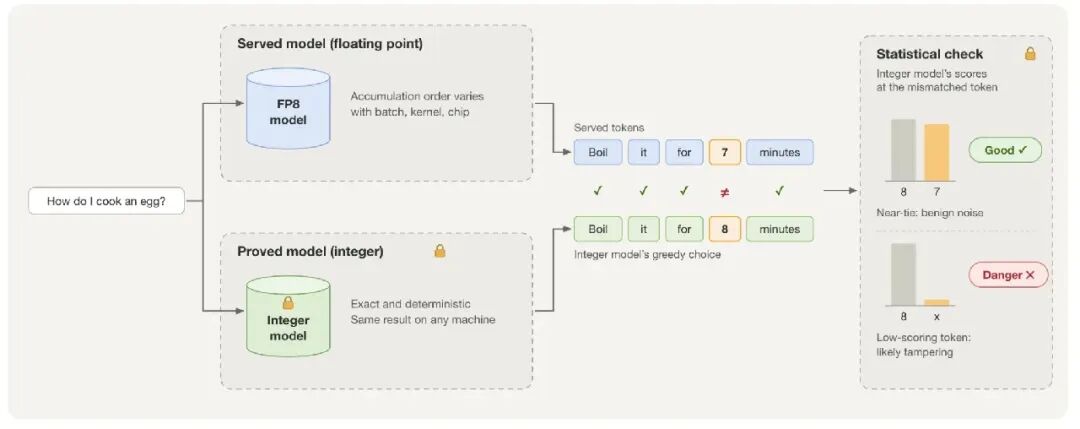
现版本证明的是整数量化模型在贪心解码或固定种子采样下的指定计算,并不直接覆盖任意浮点服务和采样结果。事后证明能够发现篡改,却不能阻止错误回答先送达用户。批量证明的零知识性质也尚未全部纳入 Lean 形式化。
这些边界指明了后续路线:压缩证明、降低延迟、补齐批量场景形式化,并建立生成代码与 Lean 规范的等价性。FlashProve 的价值,在于把模型服务的信任方式向前推了一步:从相信服务商的承诺,走向核验指定模型的一次计算。
研究资源:
对这类模型验证与 AI 基础设施话题感兴趣的读者,也可以到 云栈社区 继续讨论。
 发表于 3 天前
|
查看: 6|
回复: 0
 /1


