Kimi K3.1 Pro 在 Hugging Face 的模型页(截图)
这家模型出自谁手?月之暗面(Moonshot AI)是北京一家人工智能公司,大家熟悉的 Kimi 助手就是他们的产品。最近几年,团队一直在扎进「超长上下文」和「能自主完成任务的智能体」两个方向。
北京时间 11 月 5 日凌晨,月之暗面官方账号 @Kimi_Moonshot 在 X 上发布消息:“Releasing the model weights of Kimi K3.1 Pro”,宣告 K3.1 Pro 的完整权重正式开源。这是对 10 月 24 日发布会上“11 月 4 日前放出权重”承诺的兑现。Hugging Face 仓库的首次提交其实发生在 11 月 2 日中午,官方帖子出来之后才正式对外官宣。
模型地址:https://huggingface.co/moonshotai/Kimi-K3.1-Pro
官方开源帖配图(来源:X @Kimi_Moonshot)
一句话看懂:它是什么
模型卡里的原话是:K3.1 Pro 是一个开源权重、原生多模态的智能体模型,也是月之暗面迄今最强的 3T 级模型。它是 K3.1 系列的第一款,在 K3 的基础上进行了覆盖数百个下游领域的大规模联合强化学习。
核心规格可以列出来:
- 总参数 2.8T(2.8 万亿),每次推理只激活 104B(1040 亿)
- 上下文窗口 1,048,576 token(约 100 万)
- 混合专家结构:896 个专家,每个 token 选 16 个,另有 2 个共享专家
- 93 层网络:69 层 KDA 线性注意力 + 24 层 Gated DSA 稀疏注意力
- 原生多模态:文本 + 图片,视觉编码器 MoonViT-V2,4.01 亿参数
- 权重 MXFP4、激活 MXFP8,而且是量化感知训练的结果,不是跑完再压缩
- 仓库无需申请(ungated),直接下载,文件总量约 1.56TB
打个比方:MoE 就像一家养了 896 位专家的大公司,每个问题只叫其中十几位出来干活。公司体量虽然庞大,单次推理的实际成本只相当于一个千亿级模型。这里的量化感知训练不是简单的事后压缩,而是在训练过程中就模拟了低精度表示,这也是它能在 FP4 精度下保持性能的关键。
新在哪:和 K3 比改了什么
第一,注意力机制换了。 模型卡写明,与 K3 相比,原来的全注意力 Gated MLA 层被替换成了 Gated DeepSeek Sparse Attention(Gated DSA),目的是更高效地处理长文本。DSA 每次都只挑最相关的 2048 个位置细看(Index Top-K = 2048),不会把 100 万 token 全部过一遍。
第二,后训练投入更大。 官方博客的说法是:K3.1 Pro 用了“大得多的后训练算力”,为此把 RL 框架、长文本推理、沙箱环境、任务调度全链路重做了一遍。效果在自家长程编程基准 Kimi Code Bench 3.0 上最直观:K3 是 55.95%,K3.1 Pro 到了 61.2%。
第三,幻觉率大幅下降。 在官方故意“挖坑”的幻觉压力测试 Kimi Hallu Bench Hard 上,按单条事实算的幻觉率从 K3 的 23.4% 降到了 8.3%。官方也提醒,这是压力测试,不代表日常使用的整体错误率。
第四,开源版主动“削弱”了安全攻击能力。 他们在中期训练和 RL 阶段删掉了网络攻防相关数据。内部漏洞利用测试 xdev-bench-hard 上,未删数据的版本能解 90.5%,最终开源版降到了 81.0%。
和 DeepSeek、GPT、Claude 比如何
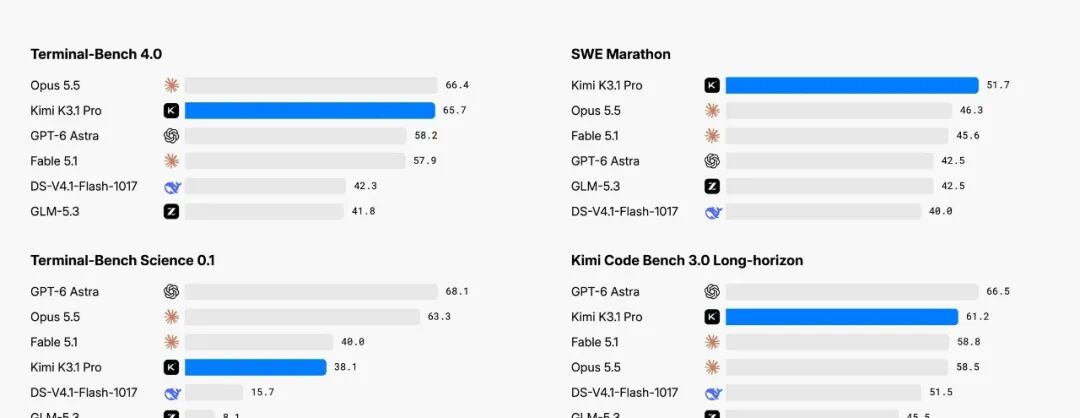
官方基准总览图(节选编程四项,蓝色为 K3.1 Pro)。图源:Kimi 官方技术博客
以下数字全部来自模型卡。K3.1 Pro 用 max 推理强度,多数编程项以 Claude Code 作为测试框架;对手分数部分是引用别家公布的数据,设置不完全一致,带 Internal 标注的都是月之暗面自己出的题。
- Terminal-Bench 4.0(真实命令行任务):K3.1 Pro 65.7,GPT-6 Astra 58.2,Claude Opus 5.5 66.4,DeepSeek-V4.1-Flash-1017 42.3,GLM-5.3 41.8——编程代理任务上超过了 GPT-6 Astra
- SWE Marathon v1.1(超长软件工程任务):K3.1 Pro 51.7,表内第一;Opus 5.5 46.3,GPT-6 Astra 42.5
- HLE-Full 带工具:K3.1 Pro 70.0,表内第一;Opus 5.5 67.7,GPT-6 Astra 57.2
- BrowseComp(联网检索):K3.1 Pro 92.1,GPT-6 Astra 91.5,Opus 5.5 90.8
- OfficeQA Pro v2(读真实财报做分析):K3.1 Pro 64.4,表内第一
短板也摆在那里:Terminal-Bench-Science 只有 38.1(GPT-6 Astra 68.1);Program Bench 31.5(Opus 5.5 65.0);不带工具的 HLE-Full 51.1,落后 Opus 5.5 的 59.8。网络安全类测试整体落后闭源旗舰,这跟主动删数据的做法是一致的。
和开源同行比,K3.1 Pro 在表里基本全面领先 DeepSeek-V4.1-Flash-1017 和 GLM-5.3,但也有例外:DeepSWE v1.1 上 DeepSeek 是 77.0,略高于它的 75.5。至于 Qwen,官方表格里没有放,我们也不硬比了。
一句话总结:开源阵营里最接近 Claude/GPT 旗舰的一档,智能体、长程编程、办公类任务很强,纯推理和安全类还差一截。
怎么用:三条路
路线一:直接调 API(最省事)。 在 platform.kimi.ai 选模型 kimi-k3.1-pro,官方提供 OpenAI 和 Anthropic 兼容接口。两个细节要注意:
- 它永远在思考,用顶层参数
reasoning_effort 调深浅,可选 low / high / max,默认 max
- 多轮对话和工具调用时,要把上一轮返回的完整 assistant 消息原样放回 messages,包括
reasoning_content 和 tool_calls,不能只回传 content
from openai import OpenAI

client = OpenAI(base_url="官方Quickstart中的地址", api_key="你的KEY")
r = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "你好"}],
    reasoning_effort="high",
)
print(r.choices[0].message.content)
注:base_url 请按照官方 Quickstart 填写,上面只是示意写法。如果你想在多个模型 API 之间做统一接入和切换,可以了解一下 RouteFast.ai 这类模型 API 中转服务,Claude、GPT、Gemini 等主流模型都能统一管理。
路线二:下载权重。 仓库免申请,用 Hugging Face 官方命令行即可:
pip install -U huggingface_hub
hf download moonshotai/Kimi-K3.1-Pro --local-dir ./Kimi-K3.1-Pro
提前备好约 1.6TB 硬盘空间。国内网络慢的话,可以去 ModelScope 的 moonshotai 组织找(模型卡里给了入口)。
路线三:自己部署。 模型卡推荐三个推理引擎:vLLM、SGLang、TokenSpeed。SGLang 的文档目前最详细,需要用专门的 kimi-k31-pro 分支或镜像:
git clone -b kimi-k31-pro https://github.com/sgl-project/sglang.git
cd sglang && pip install -e "python"
# 或直接用镜像 lmsysorg/sglang:dev-kimi-k31-pro
启动命令要在 SGLang 文档的命令生成器里按你的显卡配置选。下面是单机 8 卡的思路示意(推理与工具调用解析器名称来自官方文档):
python -m sglang.launch_server \
  --model-path moonshotai/Kimi-K3.1-Pro \
  --tp 8 --trust-remote-code \
  --reasoning-parser kimi_k3 \
  --tool-call-parser kimi_k3
vLLM 的部署配方在模型卡里有链接(见文末)。发稿时我们访问该页面返回 404,建议以 vLLM 官方 recipes 的更新为准。
Hugging Face 模型页:标注 2.8T params,许可证 kimi-k3.1-pro
私有化部署要多少钱
先说结论:这不是“买张显卡”的事,而是“买一整台服务器”的事。 以下估算全部来自公开报价,实际价格随渠道、数量、地区波动会很大。如果你正在规划团队的私有化部署方案,下面的数字可以作为初始参考。
第一步,算最低显存。 权重文件约 1.56TB(Hugging Face 显示的仓库总大小)。再加上 KV cache:SGLang 文档给出的数字是每个 token 约 18.9KB,外加每个请求一份 KDA 状态(8 卡并行时每卡约 52MB)。算下来,一个塞满 100 万 token 的请求,KV 就要约 19GB。再给运行时留一点余量,最低大约需要 1.7~1.8TB 显存,想多人同时用还得更多。
第二步,几种硬件方案。
- 8×B300(每卡 288GB,合计约 2.3TB): 一台机器就能装下,是 SGLang 主力验证平台。买:公开报价 8 卡 B300 整机约 57.7 万~73.5 万美元(Gatewell 报价页),评估机构 American Compute 给的新机价是每台 40 万~45 万美元。租:B300 按卡计价,最便宜约 7.1 美元/卡/小时,中位数约 9.7 美元,8 卡约 57~78 美元/小时,一个月(730 小时)约 4.1 万~5.7 万美元。
- 16×B200(每卡 180GB): 8 卡只有 1.44TB,装不下权重,至少需要两台。SGLang 文档里 B200 的配置也是 TP16。买:8 卡 B200 整机约 36 万~47 万美元一台(American Compute),两台约 72 万~94 万美元。租:中位数约 8 美元/卡/小时,16 卡约 128 美元/小时,一个月约 9.4 万美元。
- 16×H200(每卡 141GB): 同样需要两台 8 卡机,SGLang 文档给的 H200 配置正是 TP16。买:8 卡 H200 整机约 34 万美元左右一台,两台约 70 万美元。租:中位数约 4.7 美元/卡/小时,16 卡约 75 美元/小时,一个月约 5.5 万美元。H100 更吃力,文档里要 32 卡。
- 国产卡(昇腾 910C): 据《The Standard》援引的渠道消息,910C 已涨到每张 11 万元人民币以上。按每卡 128GB 粗算要 16 张左右,光卡就约 176 万元起。但要注意:模型卡和 SGLang 文档里没有昇腾的官方适配说明(文档里出现的国产方案是阿里的 PPU),昇腾能不能跑、跑多快,目前没有公开验证。
价格来源:Gatewell USA 报价页(11 月 3 日)、American Compute 2026 年 10 月报告、bargo.ai / Silicon Liquid / gpurentalprices.com 租价汇总(11 月 4 日)、The Standard 报道。均为估算,未含机房、电费、运维和人力。
第三步,能撑多少请求?先讲两个指标。 RPM 是每分钟能处理多少个请求;TPM 是每分钟能吞吐多少 token。TPM 要分开看输入和输出:输入主要靠预填充(prefill),输出靠逐词解码(decode),通常解码是卡住整体速度的环节。
估算假设(请当区间看,不是实测账单):
- 典型短请求:输入 8k、输出 1k(日常聊天/改代码);长上下文:输入 128k、输出 1k(读长文档)
- 并发:短请求按 16~64 路;长上下文按 4~16 路(显存和注意力都会更紧张)
- 单路解码速度:SGLang 在 8×B300 解码节点上,不开投机约 9.6 毫秒/词(约 104 token/秒),开 DFLASH 投机约 4.9 毫秒/词(约 204 token/秒);批量 64、8K 上下文时整机解码约 2583 token/秒(官方文档 Verified)
- 算力底账:激活 104B,每生成 1 个 token 大约要 2×10⁴B ≈ 0.21 TFLOPs 的矩阵运算;再叠加显存带宽和 MoE 路由开销,实际远低于理论峰值,所以我们优先用实测校准
- KV 大小:SGLang 写明 MLA+索引器约 18.9KB/token;config 里是 24 层 Gated DSA(Index Top-K=2048)+ 69 层 KDA。8×B300 扣掉约 1.56TB 权重后还剩约 0.7TB,理论上能缓存几千万 token。短请求并发不是显存瓶颈,长请求更多是预填充算力瓶颈
各方案吞吐(估算,非实测)——短请求 8k→1k:
- 一台 8×B300: 整机解码按 1000~2500 token/秒估算(上限贴着 SGLang 8 卡解码节点 2583 的实测;单机还要兼做预填充,所以给了更宽的下限)。换算大约 RPM 60~150;输入 TPM 约 48 万~120 万,输出 TPM 约 6 万~15 万,合计 TPM 约 54 万~135 万。
- 两台 16×B200: 按略高于单台 B300 的区间,解码约 1200~2800 token/秒 → RPM 70~170;输入 TPM 约 58 万~135 万,输出 TPM 约 7 万~17 万,合计约 65 万~150 万。
- 两台 16×H200: H200 对 MXFP4 不如 Blackwell 顺手,解码按 700~1600 token/秒 → RPM 40~95;输入 TPM 约 34 万~76 万,输出 TPM 约 4 万~10 万,合计约 38 万~86 万。
- 昇腾 910C: 没有公开的 K3.1 Pro 适配与吞吐数据,这里不编数字。
长上下文 128k→1k: 瓶颈从解码转到预填充。按预填充大约每秒 5 万~12 万 token 粗算,RPM 大概只有 15~40;输入 TPM 会被抬到约 200 万~500 万(因为每条请求本身就很长),输出 TPM 仍只有约 1.5 万~4 万。也就是说,长文场景“token 总量”好看,但“每分钟能服务多少用户”其实更少。
第四步,折成每百万 token 成本,和 API 比。 按我们 10 月 24 日在 Kimi 开放平台定价页看到的价格:缓存命中输入 1.3 元/百万、未命中输入 13 元、输出 68 元;批量推理打六折。短请求若按 8:1 的输入输出混合,未命中场景大约 19 元/百万 token。
- 8×B300 租用(约 57~78 美元/小时):短请求满载时,合计 TPM 54 万~135 万 → 每百万 token 约 0.7~2.4 美元(约 5~17 元)。跑在区间高端、机器几乎不闲,才明显便宜过 API;跑在低端或白天忙晚上闲,可能和 API 打平甚至更贵。
- 16×B200(约 100~140 美元/小时):短请求满载约 1.1~3.6 美元/百万(约 8~26 元),多数时候并不比 API 香,除非利用率极高。
- 16×H200(约 60~90 美元/小时):短请求满载约 1.2~4.0 美元/百万(约 8~28 元),和 API 比优势更薄。
校准来源:SGLang 官方 Kimi K3.1 Pro cookbook 里,B300 1P1D(2×8 卡)在 8K 上下文、batch 64 时解码 2583 token/秒,单并发 TPOT 4.89 毫秒(开 DFLASH)/ 9.6 毫秒(不开);同页还有 MI355X 上 AgentX 回放的并发曲线。上面其他方案是按卡数、显存和架构差异做的外推,不是我们实测。
回本怎么算?拿最乐观的 8×B300(自建约 10 元/百万、API 约 19 元/百万)粗算,每百万大约省 9 元;机器一个月约 30 万元,要消化 大约 300 亿 token/月(而且几乎 24 小时满负荷)才开始靠差价回本。绝大多数团队到不了这个量。自建更常见的原因,是数据不出域、要微调、要和内网系统死磕,而不是为了省钱。
第五步,看许可证。 K3.1 Pro 用的是自家的“Kimi K3.1-Pro License”,底子很宽松:允许使用、修改、分发、微调、商用。但有两条限制:
- 如果你做“模型即服务”(比如对外卖 API),且公司连续 12 个月总营收超过 2000 万美元,商用前要和月之暗面另签协议
- 如果产品月活超过 1 亿,或月收入超过 2000 万美元,要在界面上显著标注“Kimi K3.1-Pro”
内部自用(不把模型、输出或能力提供给第三方)不受这两条限制。中小企业私有化部署,基本放心用。
值不值得关注
三点收获送给你:一,开源模型第一次在真实命令行编程上压过 GPT-6 Astra,离 Claude Opus 5.5 只差 0.7 分;二,量化感知训练 + 稀疏注意力,让 2.8T 的庞然大物一台 8 卡 B300 就能装下;三,许可证很友好,绝大多数公司可以直接商用。
但别忘了,跑分都是官方公布的,不少是自家内部测试。最靠谱的做法仍然是:先用 API 拿自己的真实任务试一周,再决定要不要搬回机房。如果你对成本估算有不同看法,或者有实际部署经验想分享,欢迎到云栈社区和开发者们一起讨论。
相关链接
 发表于 10 分钟前
|
查看: 1|
回复: 0
 /1


