时间序列基础模型(Time Series Foundation Models,TSFM)近期又有一个值得关注的新进展:Mistral AI 发布了时序预测模型 Timestral。趁着这个节点,把这个方向的现状完整梳理一遍。
时间序列基础模型是 2023 年以来在时序预测领域快速成型的一类方法:在海量、跨域时间序列上预训练一个统一模型,目标是"开箱即用"地对任意未见序列做零样本(zero-shot)预测,并兼顾补全、分类、异常检测等多任务,核心卖点是大规模预训练 + 零样本预测。做完技术调研之后,可以得出以下结论:
其一,这一类方法的本质红利是"零样本/少样本"冷启动,在海量 SKU、没有数据训练模型的场景收益最大;
其二,零样本基础模型的真正稳健优势在短周期、少数据,长周期与强季节上并不稳赢经典方法,多变量、长周期仍被监督模型压制,自回归长周期误差累积是硬伤;
其三,把基础模型当零样本异常检测器,其"基础模型红利"基本不存在;
其四,数据充足时,微调后的任务专用模型(PatchTST、iTransformer、DLinear 甚至 GBM)仍常有优势;
其五,单变量 vs 多变量是主要分水岭:TimesFM 至今单变量;Chronos-2、Moirai 原生支持协变量,这在工业预测(需求/负载)里往往是决定因素;
其六,工程范式(预训练一次、复用)对运维/监控类海量序列场景价值明确,但未打破时序根本矛盾:外推、低信噪比、有效样本少、分布漂移依旧存在;
其七,需要谨慎或改用其他方法的场景:
- 强季节、平稳、可重复周期场景:精心调参的统计/梯度提升模型常持平或更优;
- 长周期(多季节周期外)预测场景:自回归误差累积,宜用直接多步或监督模型;
- 高监管/可审计(如 EU AI Act 高风险)场景:闭源 TimeGPT 不合规,需开源可审计模型;
- 强分布漂移、结构突变场景:需持续微调/更新,纯零样本会退化;
- 要求可解释因果场景:TSFM 是相关性黑盒,不如结构化/物理 informed 模型。
其八,选型要看基准:GIFT-Eval、LOTSA(预训练语料)、BOOM 是目前常用榜单,但伴随预训练语料膨胀,TSFM 正在重演 LLM 的"评测危机":直接重叠(训练/评测同数据集)与间接重叠(时间相关的序列共享因果驱动而泄漏)两类通道并存。
整体都还在快速变化,值得持续关注。
一、时序预测类模型的几个判断和为什么
具体到时序预测类模型,可以从几个关键问题入手做整理。
1、几个判断
其一,TSFM 在"低数据、冷启动、多数据集快速铺开"场景,显著降低部署成本与建模门槛,零样本表现常优于统计基线(Seasonal Naive、Auto-ARIMA 在部分基准上被超越)。证据见 GIFT-Eval 与 Chronos-Bolt 的 27 数据集聚合结果。
其二,TSFM 没有绕过时间序列预测的根本矛盾(单轨迹外推、低信噪比、有效样本稀少、分布漂移),它只是把"每数据集重训一个模型"替换为"一次预训练、零样本复用"。
其三,并非全面优于监督模型。在 GIFT-Eval 上,基础模型在单变量、低频预测领先;但在多变量、长周期(long-horizon)任务上,监督深度模型(PatchTST、iTransformer)仍更强;解码器自回归模型在长周期因误差累积而退化。
其四,评测存在失真风险。预训练语料与公开基准高度重叠导致"数据泄漏",且时间相关序列可经间接通道泄漏;这会使多个榜单名次虚高,结论需打折。
其五,跨域"通用时序语法"的可迁移性存疑。多个独立研究(含基于已知过程的模拟)表明,在强季节性、平稳、可重复周期上,精心调参的统计模型与 TSFM 旗鼓相当甚至更优;TSFM 的真正优势在短周期、少数据、多任务泛化。
同时,这里还存在三方面不确定:其一,榜单对"零样本"的定义不一,部分所谓零样本模型实际在评测数据上有预训练重叠;其二,TSFM 在异常检测、分类上的"基础模型红利"明显弱于预测,多项研究显示其与简单基线(移动窗方差、Last-N)相关性超过 0.9;其三,时间序列缺乏像 ImageNet/GLUE 那样被广泛认可的"无泄漏统一基准",选型仍以场景实证为准。
2、为什么时序预测不同于语言/视觉?
一个序列观测是单一随机过程的一条轨迹(对整条时间路径的联合分布),而非独立同分布样本。这触发三个独特困难(依据对标准基准的对比研究):
其一,外推而非插值:测试时的时间下标恒大于训练时,模型永远在做分布外外推,无法像图像分类那样在训练分布内插值;
其二,低信噪比:真实历史值包含的"可预测信息"稀疏,远不及自然语言每词携带的语义密度;
其三,有效样本稀少:高自相关降低了有效样本量。重要的是"独立周期数"而非"时间点数"。一段金融长序列可能只经历几次衰退或重大事件,算不上大样本;
其四,分布漂移更严重:概念漂移、结构突变、时变波动率普遍存在,预测目标本身在变。
3、基础模型范式在时序成立的隐含前提
只有当预训练语料覆盖足够多样的"时序语法"(季节性、趋势、突变、日历效应、异方差、缺失),且推理目标序列满足一定平稳性/遍历性时,跨域迁移才站得住。
更直白的结论是:只有当随机过程同时具备平稳性、遍历性与适当自相关,才能从观测序列估计其性质并做出有用预测;缺一则任何复杂预测器都会崩溃。 这意味着零售的季节性知识与能源的季节性知识是不同结构,而非同一通用模式,跨域"通用时序表征"的宣称存在上限。
二、时间序列基础模型的实现范式
从技术角度,可以对当下时间序列基础模型的实现范式做一些具体分析,主流的模型如下:
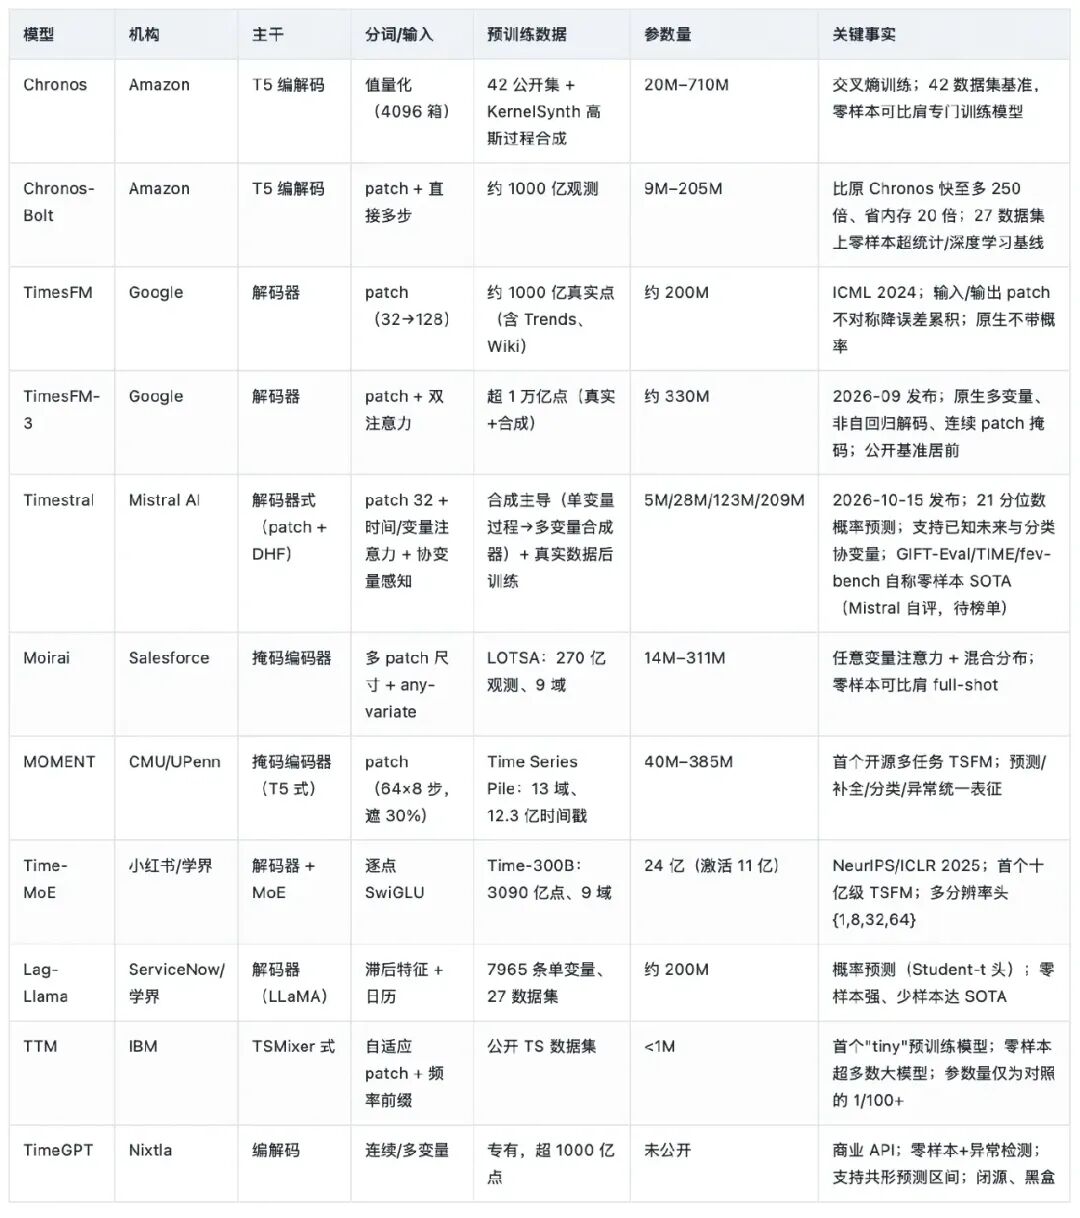
1、三种主干
从技术的角度来看,几乎所有 TSFM 都是三种 Transformer 主干 之一。选哪种主干,本质是对"模型最该擅长什么"下注,核心范式是:编码器式做表征与多任务,解码器式做预测,编解码式做灵活生成。
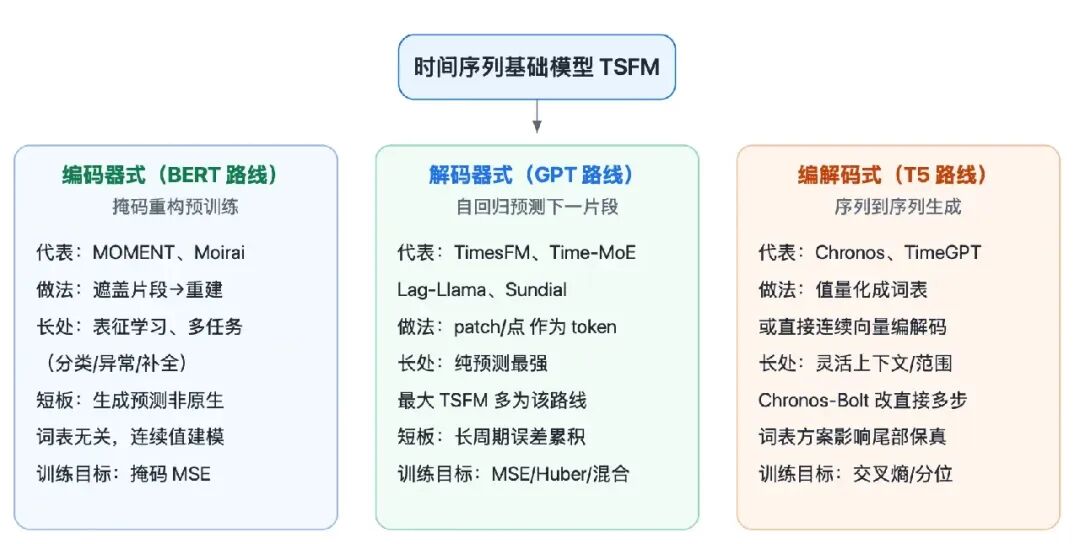
编码器式(Encoder-only,BERT 路线):用掩码 span 重构预训练,构建丰富表征。MOMENT、Moirai 属于此类,天然适合分类、异常检测等多任务,预测通常通过加一个小任务头或重构头完成。
解码器式(Decoder-only,GPT 路线):自回归预测下一个 patch(片段)。TimesFM、Time-MoE、Lag-Llama、Sundial 走此路线;纯预测场景最强,这也是参数量最大的 TSFM 集中在此的原因。
编解码式(Encoder-Decoder,T5 路线):把历史序列编码为表示,再解码生成未来。Chronos 复用 T5 主干(几乎不改架构),TimeGPT 亦为此类;Chronos-Bolt 已改为"直接多步预测"以提升速度。
2、分词(tokenization)问题
分词的目标,是把连续值变成模型能消费的 token,可以分成四种:
一种是 Patch 分词(片段):把连续时间步分组为一个 token(如 TimesFM 输入 32 步、输出 128 步;Moirai 多 patch 尺寸)。降低序列长度、解耦输入/输出长度。关键技巧:输出 patch 长于输入 patch,减少自回归步数,缓解误差累积。
一种是逐点分词(point-wise):Time-MoE 每个时间点作为一个 token(SwiGLU 嵌入),最大程度保留时序信息,但序列更长、计算更重,适合需要细粒度时序结构的场景。
一种是值量化(value quantization):Chronos 用绝对值均值缩放后,均匀分箱(词表约 4096)成离散 token,加 PAD/EOS 特殊符,直接套用 LLM 的交叉熵。优点是可复用 LLM 工具链;代价是词表大小直接影响尾部保真度(金融厚尾场景敏感)。
一种是滞后特征(lag covariates):Lag-Llama 显式把"上一日/周/年同期值"与日历特征拼成 token,把周期与季节结构直接注入输入,而非全靠注意力隐式学习。
3、训练目标函数
训练目标函数有几种:
一为回归(MSE):TimesFM 点预测;直接、快,但原生不带概率接口;
二为交叉熵(token 词表):Chronos 套 LLM 损失;概率预测靠轨迹采样;
三为混合分布负对数似然:Moirai 用 Student-t + 负二项 + 对数正态 + 低方差正态的混合,以适配不同支持域(如正计数、右偏数据);
四为掩码重构 MSE:MOMENT、Moirai 的预训练目标。
4、如何评测
没有统一、无泄漏的基准,是 TSFM 领域公认的软肋。代表性的是 GIFT-Eval,含 23 数据集、14.4 万条序列、1.77 亿点,覆盖 7 域、10 种频率、单/多变量与短中长周期,并配套约 2300 亿点的"无泄漏"预训练语料。指标 MASE、CRPS 均以 Seasonal Naive 归一(越低越好)。
其结论是:基础模型在单变量、低频预测领先,但在多变量与长周期任务上,监督深度模型(PatchTST、iTransformer)仍胜出;自回归解码器在长周期退化——递归误差累积使 Chronos、TimesFM 在中长周期表现下滑;直接多步/非自回归(Chronos-Bolt、TimesFM-3)正是为此而生。
总的来说,TSFM 是"降低时序建模冷启动成本"的实用工具,不是"预测理论突破"。它的真价值在零样本、少数据、多任务铺开;它的真边界在多变量、长周期、强漂移、高监管与异常检测红利缺失。选型以自有数据对照收口,而非以榜单名次收口。
 发表于 昨天 07:12
|
查看: 2|
回复: 0


