要点速览
- NVFP4:4 位 E2M1 格式结合两级缩放,权重内存占用相对 FP16 约降低 3.5 倍;KV 缓存占用相对 FP8 最高降低 50%;在给定测试条件下,同等交互性下的吞吐最高达到 FP8 的 4 倍。
- Wide-EP 与 Dynamo:专家并行将专家权重分散到 8 块或更多 GPU 上;在图示测试条件下,GB300 NVL72 的每兆瓦 token 吞吐达到 H200 NVL8 的 10 倍。Dynamo 将 KV 缓存作为整个集群的资源,通过路由、分离式服务和分层复用减少重复 prefill。
- Vera 与 CMX:Vera CPU 使用最高 1.5 TB LPDDR5X 暂存空闲会话的 KV 缓存,并通过 NVLink-C2C 回迁;CMX 新增 pod 级共享的 G3.5 闪存层,长上下文推理的 token 速率与能效最高提升 5 倍。
问题不只在容量,而在每字节产出多少 token
在 AI 工厂中,高带宽内存(HBM)是速度最快、成本最高、竞争也最激烈的内存层级。用于冗余权重副本、空闲会话 KV 缓存或重复计算前缀的字节,无法同时用于生成 token。衡量内存的关键因此不只是 GPU 有多少容量,还包括每个字节能完成多少有效工作。
代际数据说明了这个问题:从 GB300 到 NVIDIA Rubin,单卡 HBM 容量保持在 288 GB,带宽提升至 19.2 TB/s。
按每兆瓦计算,Agent 吞吐的增长幅度更大。在 SemiAnalysis AgentX 测试中,负载会回放带有真实工具调用间隙、上下文不断增长的编码 Agent 会话。在每用户每秒 160 token 的条件下,NVIDIA Vera Rubin NVL72 的每兆瓦吞吐最高达到 GB300 NVL72 的 30 倍。
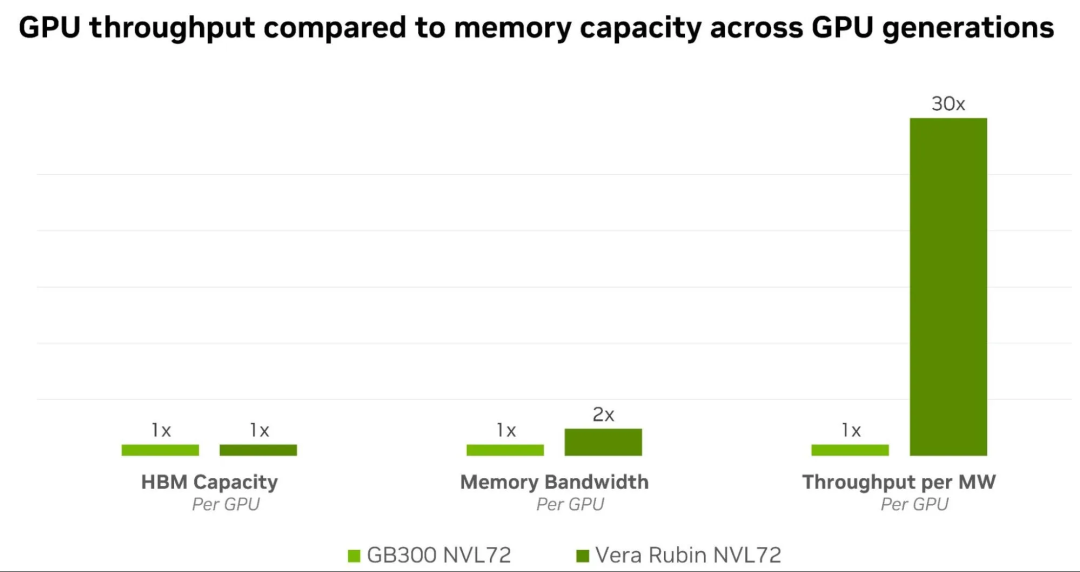
图 1:GB300 NVL72 与 Vera Rubin NVL72 的单 GPU HBM 容量相同,图示测试条件下的每兆瓦吞吐最高相差 30 倍。
只看容量,无法解释两者同为每 GPU 288 GB 时的吞吐差距。差别还在于系统如何利用这些内存。
NVIDIA 将其作为跨 GPU 架构、scale-up 互联、服务软件、CPU 与存储的协同设计问题。下面五种方法从编码权重的比特数出发,一直延伸到跨 Agent 轮次和节点共享上下文。
第一招:NVFP4,让每字节容纳更多数据
提高内存利用率最直接的方法,是让每个数值占用更少的字节,同时尽量保留其编码的信息。
NVFP4 使用 4 位 E2M1 元素和两级缩放:每 16 个值组成的微块共享一个 FP8(E4M3)缩放因子,再叠加一个张量级 FP32 缩放因子。较小的数值格式释放了 HBM,较细的缩放粒度则有助于在朴素 4 位格式精度不足的情况下保持精度。
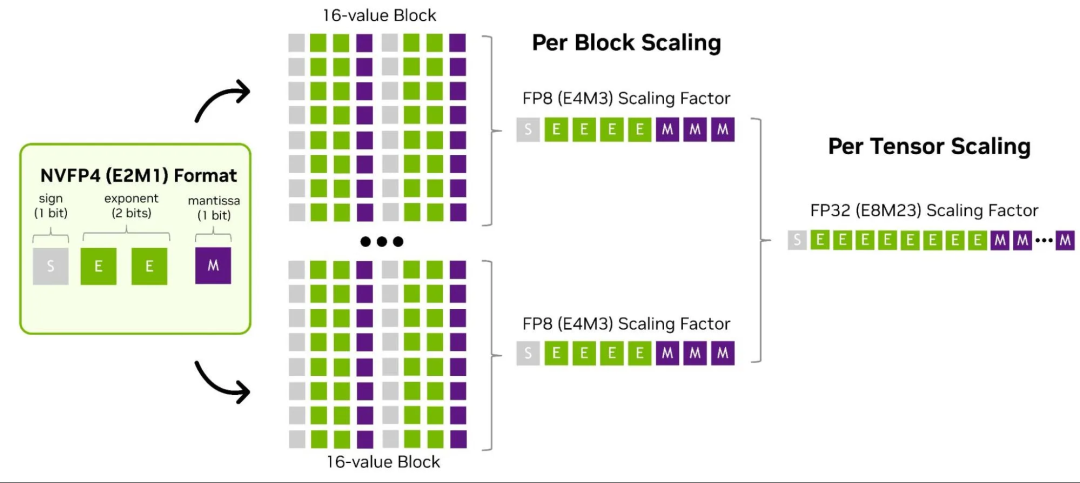
图 2:NVFP4 将 4 位数值与块级、张量级缩放结合起来。
用于权重时,NVFP4 相对 FP16 将模型内存占用降低约 3.5 倍,相对 FP8 降低约 1.8 倍。节省的内存可用于 Agent 推理所需的更多 KV 缓存、更大 batch 和更高并发。
NVFP4 已成为 AA-AgentPerf、SemiAnalysis AgentX、MLPerf Endpoints 等对精度要求严格的开放 Agent 基准的默认精度。在这些基准与主流 MoE 架构上,同等交互性下,其吞吐最高可达 FP8 基线的 4 倍。
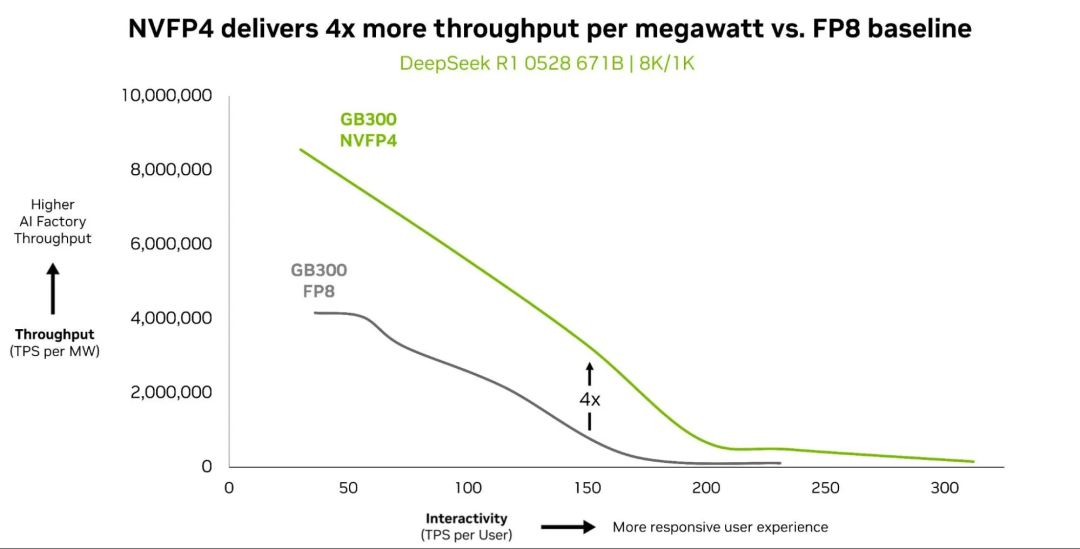
图 3:在图示 GB300 和 DeepSeek R1 测试中,同等交互性下,NVFP4 的每兆瓦吞吐达到 FP8 的 4 倍。
同样的原理也可用于 KV 缓存。NVFP4 KV 缓存相对 FP8 最高减少 50% 的缓存占用,使约两倍的上下文可以常驻设备。缓存逐出减少,有助于提高 prefill 阶段的缓存命中率;缓存体积缩小,也能减少 decode 阶段的带宽消耗。
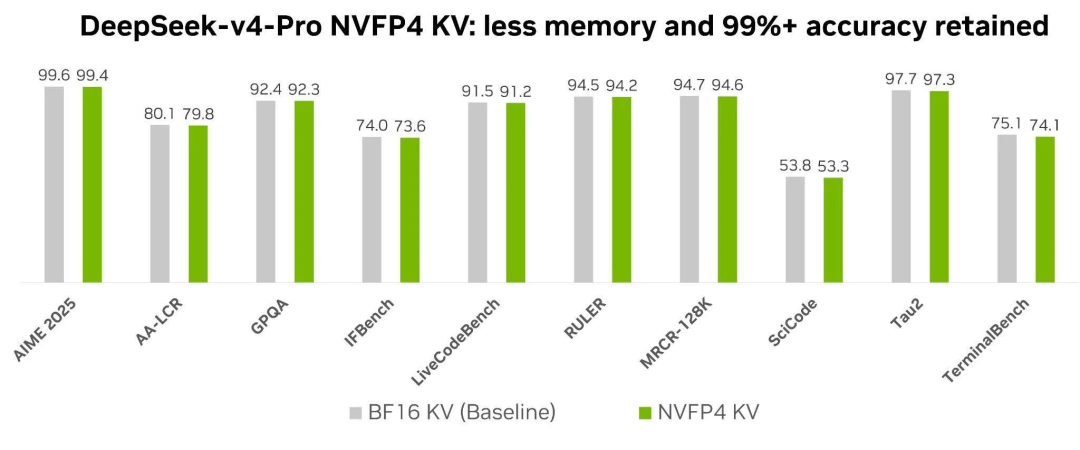
图 4:在图示的 10 项 DeepSeek-v4-Pro 基准中,NVFP4 KV 缓存保持了 BF16 基线 99% 以上的分数。
NVFP4 缩小了单个数据的占用。接下来的问题是,这些数据放在哪里,以及系统需要保留多少份权重副本。
第二招:NVLink 互联域让 72 块 GPU 协同使用内存
MoE 模型每生成一个 token,只激活部分参数,但每个专家的权重仍需存放在某处 HBM 中。如果专家集中在少量 GPU 上,每块 GPU 的大量内存会被权重占据,每个 decode 步骤还要承担 MoE GroupGEMM 的权重加载开销。
NVIDIA TensorRT-LLM 中的宽专家并行(Wide-EP)通过将专家分散到 8 块或更多 GPU 上,改变了这一比例。以 DeepSeek-R1 在 EP64 下运行为例,每层每块 GPU 放置 4 个专家,58 层 MoE 合计 232 个专家块,全模型共 14,848 个。
每块 GPU 保存的专家权重减少,带来三方面收益:
- 容量:为 KV 缓存、更大 batch 和更高并发留出更多 HBM。
- 算术强度:GroupGEMM 内核让每次加载的权重服务更多 token,提高每字节对应的 FLOPs。
- 负载均衡:专家并行负载均衡器(EPLB)在两次前向计算之间重新分配冷热专家,减少 GPU 间的内存和负载不均。
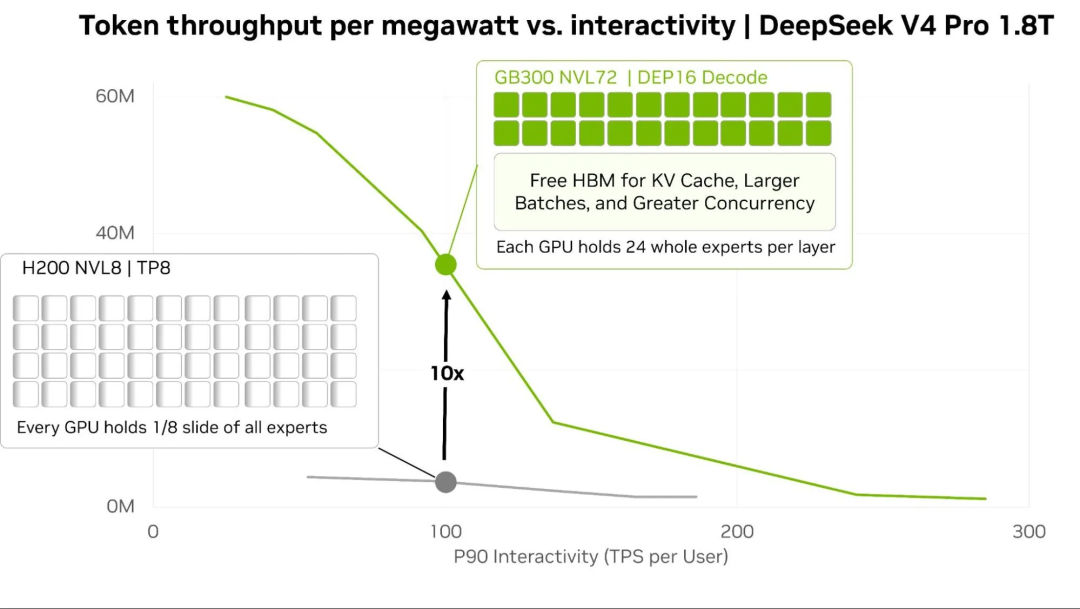
图 5:在图示测试中,每用户每秒 100 token 的条件下,GB300 NVL72 的每兆瓦 token 吞吐达到 H200 NVL8 的 10 倍。
这一方法依赖高速 scale-up 域:每个 MoE 层都会触发 all-to-all 的 dispatch 与 combine 流量。没有足够带宽的互联网络,集合通信可能抵消专家并行的收益。
在 GB200 NVL72 上,130 TB/s 的聚合 NVLink 带宽承担了这部分流量。大规模专家并行 EP32 相对 EP8,在每用户每秒 100 token 的条件下,每 GPU 每秒输出的 token 数最高多出 1.8 倍。
Vera Rubin NVL72 进一步扩展了这一设计。每块 Rubin GPU 最高配备 288 GB HBM4 和 3.0 TB/s NVLink 6 带宽,整个机架约有 20.7 TB HBM4。Rubin 还增加了内联内存张量加速器(TMA)描述符更新:一个共享描述符可以服务所有采用通用布局的专家,减少随专家数量增长的元数据开销。
Wide-EP 决定权重数据放在哪里;下一步要解决的是,已经算出的 KV 缓存能否避免重复计算。
第三招:Dynamo,让缓存跨 GPU 复用
KV 缓存保存此前处理过的 token 的中间注意力计算结果,让模型可以复用这些结果,而不是每次重新计算。这类推理状态可以被逐出,之后需要时再计算,但只有得到复用才有价值。
Agent 负载中存在大量复用机会,包括系统提示、工具 schema、共享文档,以及多步任务不断增长的历史。可如果请求被分配到没有相应前缀的 GPU,或者前缀刚被逐出,系统就得再次承担 prefill 开销。
NVIDIA Dynamo 是处理这一问题的分布式服务层。它将 KV 缓存作为整个集群的资源,通过三项能力协同工作:
- KV 感知路由:Dynamo 路由器跟踪 KV 块的位置,放置请求时同时考虑缓存前缀的重叠程度和 worker 负载,在复用已有上下文与向繁忙 GPU 派发工作之间权衡。
- 分离式服务:prefill 和 decode 分别运行在独立 GPU 池中,各自根据计算和内存特征确定规模。Decode GPU 可以将 HBM 用于 KV 缓存和 batch,而不必为突发 prefill 预留余量。
- KV Cache Runner(KVCR):跟踪每个缓存块在 GPU、固定 CPU 内存和存储层级中的位置,后者包括本地 SSD 与挂载的网络文件系统。HBM 之外的前缀可在后续请求需要时恢复,避免 GPU 逐出缓存后重新执行 prefill。
KVCR 使用 NVIDIA Inference Xfer Library(NIXL)作为存储传输路径,使缓存块可以在 GPU 处理其他工作的同时移动。它还支持分布式复用:路由器提供提示,帮助选定的 worker 从对端取回缓存上下文,同时推理引擎保留对 GPU 内存和本地主机卸载的控制。
新增的 KVCR-Guard 可以在引擎故障后保留由 KVCR 管理的主机内存缓存,前提是 guard 服务和主机仍然可用。
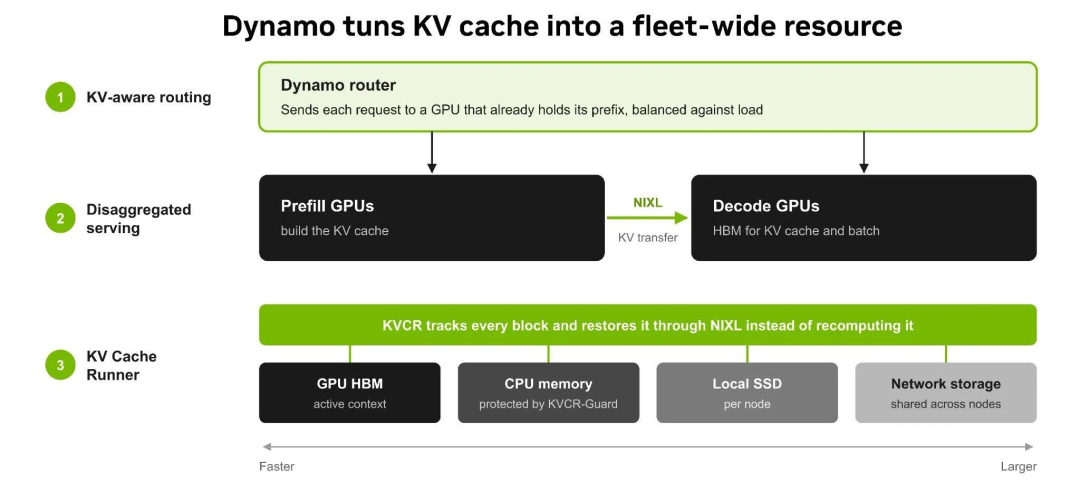
图 6:Dynamo 结合 KV 感知路由、分离式服务与分层 KV 缓存复用。
KV 缓存卸载依赖快速取回:将前缀保存在 HBM 之外,只有加载速度快于重新 prefill 时才能节省时间。NIXL 将卸载路径连接到外部存储系统。
在独立验证测试中,存储厂商 VAST Data 与 WEKA 分别展示了:使用 GPUDirect Storage 向单块 H100 GPU 提供 35 GB/s,以及通过定制 NIXL 插件在 8 块 H100 GPU 上实现最高 270 GB/s 的聚合读取吞吐。这些测试表明,外部存储在受测条件下可以向 GPU 系统提供 KV 缓存,支持超出 HBM 的缓存容量。
另一项 VAST 测试展示了响应时间收益:在 DGX H100 系统上使用 vLLM 与 LMCache,对 Qwen3-32B 的 130K token 提示词加载已保存的 KV 缓存,而不是重新计算,降低了首 token 延迟。
Dynamo 协调缓存数据的位置和回迁时机。接下来两种方法进一步扩展可供上下文使用的容量,首先是 CPU 内存。
第四招:Vera CPU,让空闲上下文暂离 HBM
Agent 推理通常不是一次连续的 GPU 计算。会话会在模型步骤与 CPU 侧工作之间交替,包括工具调用、代码执行、检索、数据库查询和沙箱评测。在这些间隙中,仍留在 HBM 的会话 KV 缓存占据容量,却不参与活跃的 token 生成。
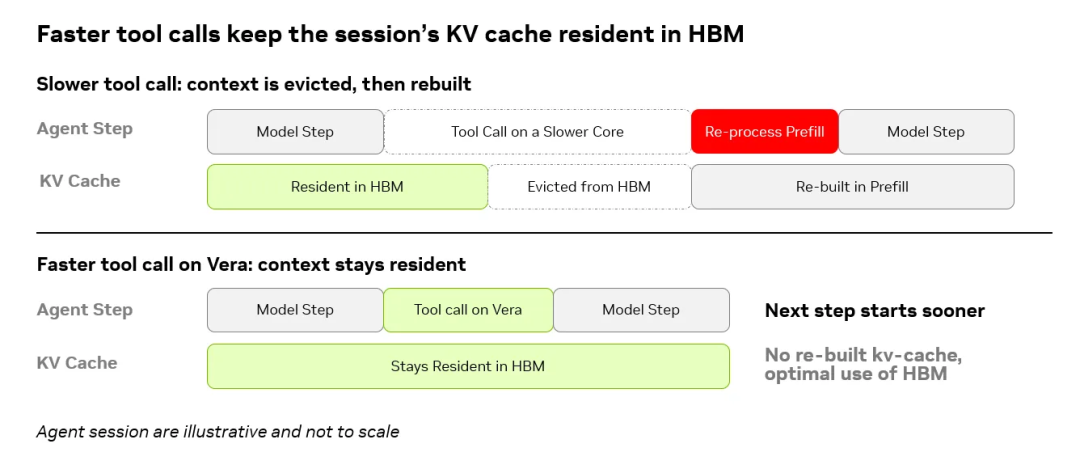
图 7:更快的工具调用有助于让 KV 缓存留在 HBM,避免重建并更快进入下一个模型步骤。
在负载已满的 AI 工厂中,GPU 可以在工具调用期间处理其他请求。间隙越长,原会话的 KV 缓存越可能被逐出,以便为新请求腾出空间。工具返回后,GPU 可能需要通过完整 prefill 重建上下文,而不能直接恢复缓存状态。
NVIDIA Vera CPU 从两个方向处理这个问题:
- 缩短间隙:88 个 Olympus 核心带来 1.8 倍的单线程性能,峰值负载延迟比 x86 CPU 低 40%,每核心内存带宽最高 14 GB/s。更快、更可预测的工具调用可以缩短 KV 缓存面临逐出压力的时间窗口。
- 提供快速的上下文暂存位置:每颗 Vera CPU 最高提供 1.5 TB LPDDR5X,超过单块 Rubin GPU HBM4 容量的 5 倍。NVIDIA NVLink-C2C 以 1.8 TB/s 的带宽将两者相干连接,约为 x16 PCIe Gen 6 链路 256 GB/s 的 7 倍。
除了将 KV 缓存一直留在 HBM 或直接丢弃,Dynamo 的 KV Block Manager 还可以在工具调用期间将其暂存到 Vera 内存,待 Agent 恢复时再经 NVLink-C2C 取回。这样,HBM 可留给正在生成 token 的活跃会话,暂停的会话也可避免重复 prefill。
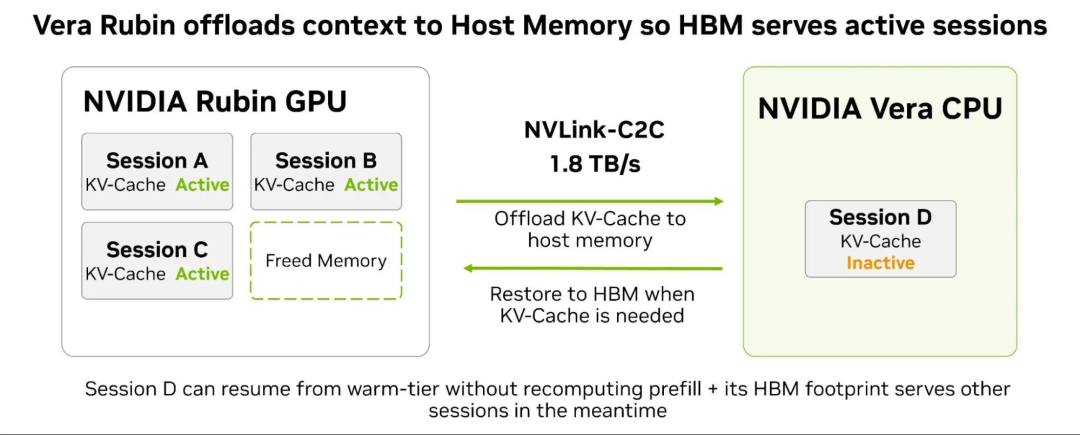
图 8:Vera Rubin 将非活跃 KV 缓存卸载到主机内存,为活跃会话释放 GPU HBM。
Vera 内存是温层,适合很快需要恢复的上下文。若要让上下文跨轮次、跨 Agent、跨节点保留,还需要更大的存储层。
第五招:CMX,将上下文内存扩展到整个 pod
把所有可复用 KV 缓存都留在 GPU 或主机内存里,会挤占活跃推理的容量;直接丢弃,则可能在之后需要时重新计算。
多轮会话、长时任务和共享工作内存的多 Agent 工作流,都会产生稍后还要使用的 KV 缓存。这些数据可能要在几分钟后、另一个节点上重新使用。随着上下文窗口变长、并发会话增多,缓存容量需求会超出 GPU HBM(图 9 中的 G1)与主机内存(G2)。
传统层级并非专为这种数据设计:本地 SSD(G3)绑定在单个节点上;共享企业存储(G4)面向持久数据,带有 KV 缓存不一定需要的复制和元数据开销。
NVIDIA CMX 上下文内存存储新增 G3.5 层级,以太网直连闪存,在 pod 级共享,并针对 KV 缓存优化。它基于 NVIDIA STX 参考设计,涉及四个协同设计的层面:
- 存储处理:NVIDIA BlueField-4 STX 存储处理器管理 NVMe SSD、运行存储服务,并卸载 KV 缓存的数据移动、数据完整性与加密工作。其集成的 NVIDIA Vera CPU 加速 CPU 侧存储处理,将同一 CPU 架构延伸到存储数据路径。
- 网络:NVIDIA Spectrum-X 以太网在计算节点与 CMX 存储节点之间提供低延迟、高带宽的 RDMA 访问。
- KV 感知服务:NVIDIA DOCA Memos 在 BlueField-4 上提供 KV 感知服务与 I/O 控制,使上下文可以作为资源进行放置和共享。
- 服务集成:Dynamo 与 NIXL 将 CMX 接入整个 pod 的上下文层级,预置上下文,并将请求路由到已有 KV 缓存的位置。
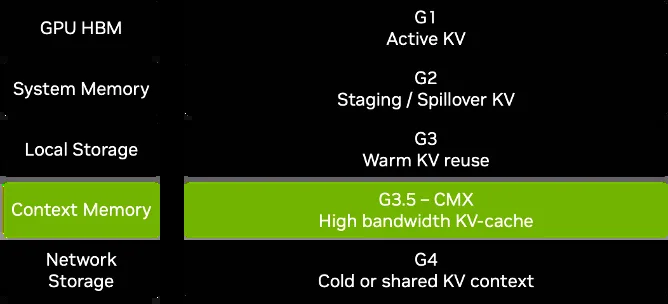
图 9:NVIDIA CMX 增加共享的 G3.5 层级,提供 pod 级 KV 缓存容量与复用。
pod 级设计有助于提高每字节的利用率。一次计算出的前缀可以在 pod 内跨兼容模型实例复用,共享文档、工具或工作内存的 Agent 因此有机会避免重复 prefill。跨 pod 汇集上下文存储,也可减少 KV 缓存重复和各节点的闲置容量,扩展推理可用的有效内存。
通过将可复用上下文预置到 GPU 或主机内存,CMX 可减少推理停顿;针对 KV 缓存优化的存储层级则降低了服务上下文的功耗开销。综合这些能力,CMX 相对传统存储在长上下文推理中可实现最高 5 倍的每秒 token 数和最高 5 倍的能效。
五招如何协同
每种方法针对不同的资源浪费:
- NVFP4 减少表示数值所需的比特。
- Wide-EP 分散专家权重,减少单 GPU 的权重占用。
- Dynamo 通过缓存路由和复用减少重复计算。
- Vera 缩短工具调用间隙,并为非活跃上下文提供暂存空间。
- CMX 让 KV 缓存跨节点共享和复用。
这些能力作为内存系统的一部分协同工作,收益可以跨层级叠加。例如,一个 4 位 KV 块在 HBM、Vera 内存和 CMX 中都能节省空间。
Vera Rubin NVL72 展示了这种设计思路:同为每 GPU 288 GB HBM,在特定 Agent 测试条件下,其每兆瓦吞吐最高达到 GB300 NVL72 的 30 倍。随着 Agent 负载的上下文和会话轮次增长,内存系统不仅要看容量,也需要看每个字节能产出多少有效 token。
来源
参考:Five Ways NVIDIA Co-Design Maximizes the Value of Every Byte in the AI Factory
 发表于 昨天 11:00
|
查看: 14|
回复: 0
 /1


