很多开发者部署开源大模型的第一步,往往是写个几十行 Python 脚本,用 Hugging Face 的生成管线配合 FastAPI 包一层接口。本地终端单请求测试时一切顺畅,可一旦把接口挂到团队内部机器人,或者用测试脚本发起几个并发请求,服务很快就会崩溃——要么控制台抛出刺眼的显存溢出报错,要么首字延迟直接飙升到几十秒。
我自己第一次在 24GB 显存的显卡上测开源模型时就踩过这个坑:单人单会话响应只要两秒,一旦开三个并发跑压力测试,显卡风扇还没完全起飞,控制台就先喷出了显存不足的堆栈。问题出在哪?单机脚本式的处理思路在大模型推理场景下完全行不通。大模型计算不仅受限于模型本身的权重大小,更被请求交互过程中动态生成的 KV Cache(键值缓存) 牢牢锁死。传统的无状态 Web 并发逻辑,直接搬到显卡显存里必然会撞上性能与容量的死胡同。
加州大学伯克利分校 Sky Computing Lab 在 2023 年开源的 vLLM,正是为了打破这套显存与吞吐困境而生。它在 GitHub 上获得了超过 9.5 万颗 Star,已经演进为大模型生产级推理服务领域的事实标准。
显存碎片防线:PagedAttention 怎么把显存浪费压到 4%
为什么自己手写的模型服务一遇到并发请求就会报显存溢出?核心瓶颈在于传统内存分配方式造成的严重浪费。
在标准的深度学习推理框架中,为了保存每个用户的对话上下文,系统必须为请求预先分配一块连续的物理显存空间。但由于模型在完成解码前无法预测用户最终会生成多少个 Token,框架只能按照模型允许的最大上下文长度(比如 4096 或 8192)顶格申请空间。当用户只收到一句简短回复时,大量预留显存只能被迫闲置,无法供其他排队请求使用。这种内存碎片导致传统方案的显存有效利用率往往只有 20% 到 40%。
vLLM 借鉴了操作系统经典的分页管理思想,提出了 PagedAttention 核心机制。它不再要求每个请求的 KV Cache 占据连续的物理显存,而是把缓存切分为固定大小的物理页块,默认每个 Block 容纳 16 个 Token。
项目卡片
- 项目:vLLM[1]
- 状态:v0.32.x / 95k+ Stars / Apache-2.0 协议
- 一句话判断:用虚拟内存分页思想重构 KV Cache,将单卡并发吞吐提升数倍的生产级大模型推理引擎。
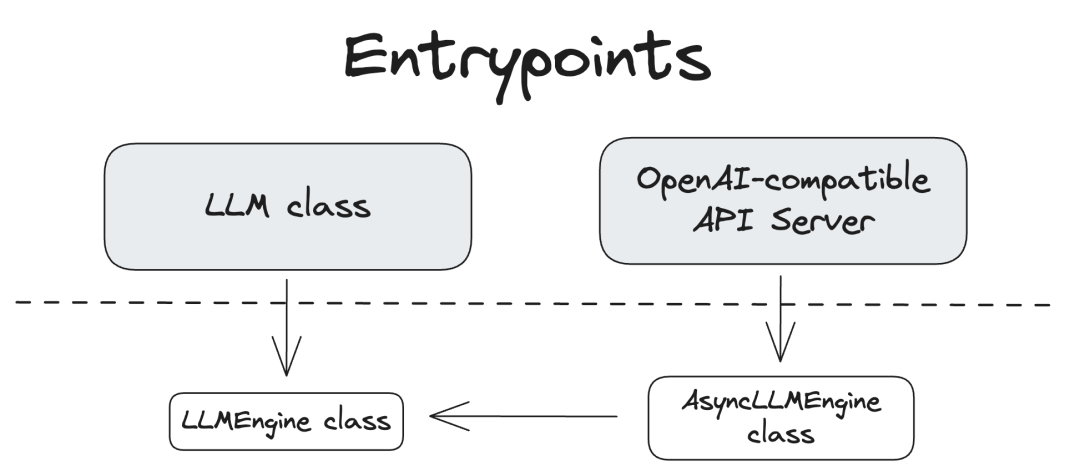
逻辑上的上下文序列被灵活映射到底层离散分布的物理块中,请求生成到哪里,调度器就实时分配新的块。这种非连续分配方式将 KV Cache 的显存浪费率直接压缩到了 4% 以下。省出来的显存空间让同一张 GPU 能同时容纳多倍的并发会话。
消除排队等待:连续批处理与前缀缓存如何解放吞吐
显存空间被释放出来后,推理服务面临的第二道难关是计算单元的利用率。每个用户的输入长度与生成长短千差万别。
传统静态批处理机制把一批请求打包送入显卡计算,必须等待生成最长、耗时最久的那条请求彻底结束,整批资源才能释放并接纳下一批任务。短文本请求早早执行完毕后,对应的计算单元就只能原地空转,造成算力的极大浪费。
vLLM 采用连续批处理(Continuous Batching)重构了调度逻辑,把调度粒度细化到每一次 Token 生成的单步迭代中。每当一个请求完成了最后一个 Token 的输出,它所占用的显存页立即被回收,处于等待队列中的新请求可以在下一个步长立刻插队进场。这让显卡的核心计算单元几乎始终维持在满载工作状态。
在多轮对话或带有固定系统设定(System Prompt)的场景下,vLLM 还配合了自动前缀缓存(Automatic Prefix Caching)能力。多个请求如果带有相同的长提示词或背景文档,系统会自动识别并复用已有的 KV Cache 块。第二次发起请求时直接跳过耗时的 Prefill 预填充阶段,首字响应延迟(TTFT)从原本的数秒缩短到了毫秒级。
一条命令拉起服务:无缝兼容主流应用生态
底层优化如果缺乏低成本的落地方式,对业务团队依然是一道高门槛。vLLM 极其注重开箱即用的工程体验。
借助现代 Python 包管理工具 uv,开发者两行指令即可配置好运行环境并拉取预编译算子:
uv pip install vllm
vllm download-kernels
启动一个支持主流开源模型的在线服务,只需一行简洁的 CLI 命令:
vllm serve Qwen/Qwen2.5-7B-Instruct --port 8000
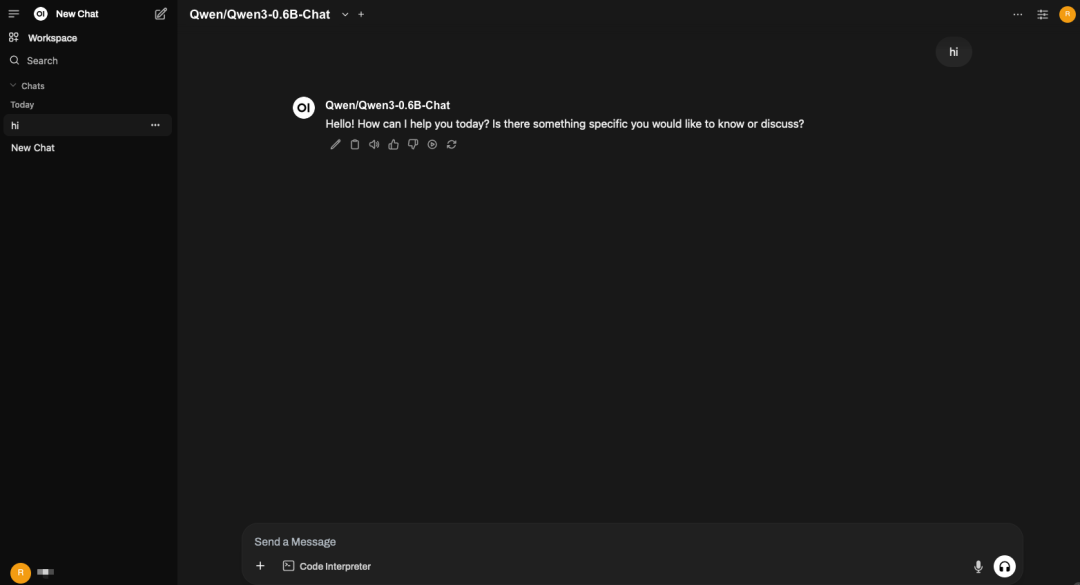
服务启动后,直接暴露完全兼容标准的 OpenAI 协议接口,包括 /v1/chat/completions 与 /v1/models,同时原生支持 Anthropic Messages 协议与工具调用(Tool Calling)输出解析。
这意味着绝大部分现存的大模型上层生态都能无缝对接。无论是前端界面 Open WebUI、Chatbox,还是应用开发框架 Dify、LangChain、FastGPT,只需要将请求地址指向本地的 http://localhost:8000/v1,无需重写任何业务胶水代码就能直接投入使用。
生产选型边界:什么时候千万不要选它
评估一项基础设施,必须看清它的设计权衡与适用边界。vLLM 是为多并发、高吞吐的生产级工作负载打造的重型引擎,并不适合所有使用场景。
最需要注意的边界在于显存独占倾向。vLLM 在默认配置下,会直接把 gpu_memory_utilization 锁定为 0.92(即占用 92% 的整卡显存)。即便加载一个参数较小的模型,它也会把剩余的绝大部分显存划归为 KV Cache 的管理池。在多任务混部的测试机上,如果你没调低这个参数,启动第二个实例甚至连模型权重都还没读完,就会直接被系统 OOM 强行杀掉。在共享硬件环境下,必须显式传入 --gpu-memory-utilization 0.5 等参数约束显存上限。
另一个边界是单人单机轻量化场景。如果只是个人在 MacBook、纯 CPU 设备或低配小显存显卡上做简单的单会话调试,Ollama 或 llama.cpp 的安装包与内存管理机制要轻巧得多,不需要经历较长的冷启动编译准备;但如果业务目标是搭建企业私有推理网关、支撑数十人并发访问,或者串联复杂的 Agent 多轮调用,vLLM 则是当前生态中极具性价比与稳定性的确定性选择。
引用链接
[1] vLLM: https://github.com/vllm-project/vllm
关于 vLLM 在多卡并行、模型量化或异构硬件适配等进阶调优方向,云栈社区上还有不少来自一线开发者的实战讨论,遇到具体问题不妨去翻翻对应板块。
 发表于 9 小时前
|
查看: 2|
回复: 0
 /1


