在一颗 MCU 里集成 NPU,早就不算什么新鲜事了。可如果限制条件再加一条:芯片面积不能增加,价格还得和原来持平,事情就没那么简单了。
NPU 要吃晶体管,信号处理器要占用计算资源,模型运行还得挤占片上存储。对于一颗主打工业控制的 MCU 来说,这些资源从哪来?
11 月初,意法半导体发布了 STM32H7P,答案直截了当:砍掉一部分旧功能,把硅面积让给 AI。
图1 STM32H7P系列面向工业控制与端侧AI应用,在传统MCU架构中引入硬件信号处理及特定型号的NPU加速能力。(来源:STMicroelectronics)
STM32H7P保留520MHz Arm Cortex-M7,同时引入硬件信号处理器 HSP,并在 H7P5 等特定型号中加入 85 GOPS 的 Neural-ART NPU。H7P4 则没有 NPU,并非全系标配 85 GOPS 算力。
ST 的说法是,相比 STM32H72x/3x 系列,新产品没有增加芯片面积,价格也维持在相近水平。
01|为了给 NPU 腾地方,ST 删掉了什么?
一颗 SoC 的面积预算是有限的。
CPU、SRAM、Flash、总线、模拟电路和各种外设,每个模块都得在硅片上分一杯羹。如果一味往里堆新 IP,Die 面积和制造成本必然水涨船高。
STM32H7P 的选择是重新分配这笔预算。ST 在官方工程博客里讲得很明白:为了维持相近的芯片面积,新架构去掉了以太网控制器、显示控制器和 GPU。
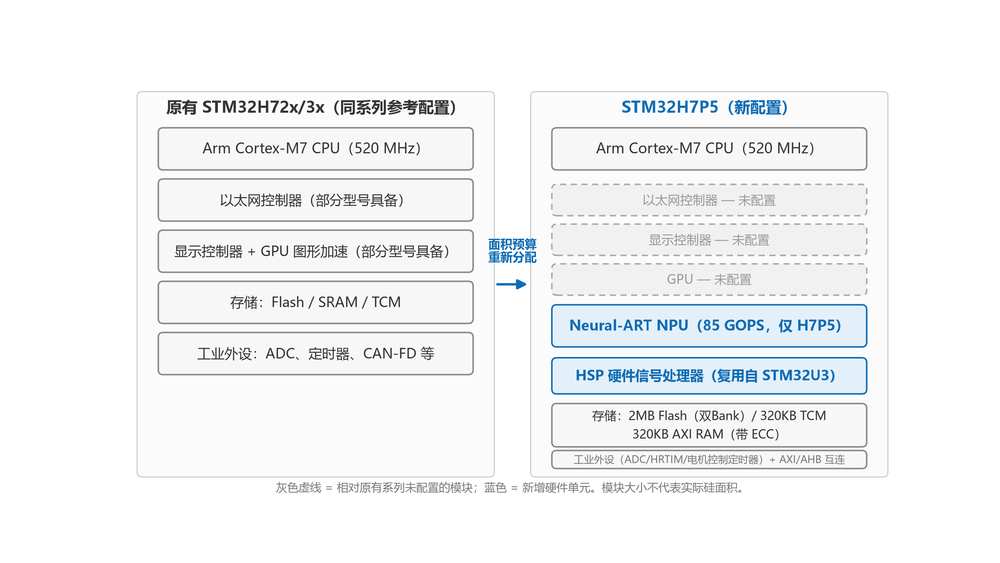
图2 STM32H7P通过调整原有IP配置,为NPU和HSP腾出硬件资源。模块大小不代表实际硅面积。(根据ST官方资料整理)
拿掉这几个模块,并非随意为之。
以太网服务于联网设备,显示控制器和 GPU 服务于图形界面。但工业控制器并不都需要这些能力。一套电源保护装置可能需要高速采样、异常识别和精确控制,却完全不用画一个图形界面。
对这类设备来说,与其留着一块用不上的 GPU,不如把面积换成能跑神经网络的 NPU。
但代价也存在:去掉以太网意味着这颗芯片不再适合直接承担所有工业网络控制场景。需要以太网的场合,只能换型号或者外挂器件。
02|85 GOPS 的 NPU,其实是从更大的 NPU 上裁出来的
ST 并没有为 STM32H7P 从零开发一套全新 NPU。
它沿用了与 STM32N6 同代的 Neural-ART 架构,只是缩减了计算资源。STM32N6 用的是 N10-288 配置,内含四组计算阵列;STM32H7P 则采用 N10-72 配置,只保留一个 CA+ 计算单元。
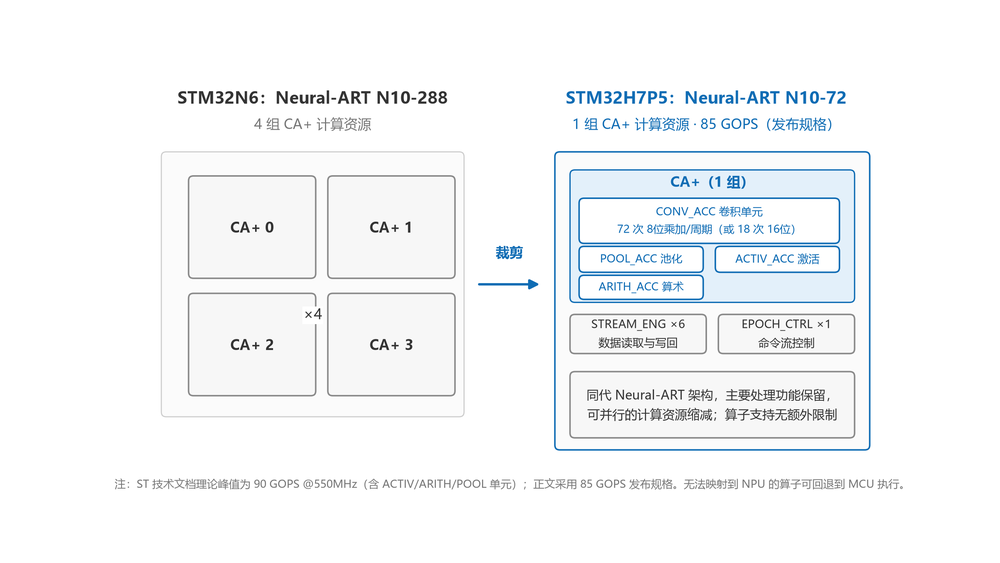
图3 STM32H7P采用规模更小的Neural-ART N10-72配置,将计算资源从N10-288的四组缩减为一组CA+,同时保留卷积、池化、激活和算术处理等功能。(根据ST官方NPU文档整理)
注意,一个 CA+ 并不等于 NPU 内部只剩一个乘加阵列。
N10-72 仍然包含卷积单元 CONV_ACC、池化单元 POOL_ACC、激活单元 ACTIV_ACC 和算术单元 ARITH_ACC,另外还有 Stream Engine 负责数据搬运、命令控制模块协调执行流程。
其中卷积单元每周期最多完成 72 次 8 位乘加,或者 18 次 16 位乘加。各运算单元合在一起,才构成 NPU 的完整计算能力。
这种裁剪方式保留了神经网络推理所需的主要功能,但缩减了并行度。
计算量大的应用可以上 STM32N6;而仍以实时控制为主、只需跑轻量模型的设备,STM32H7P 提供了另一个选项。
值得关注的是,ST 技术文档明确说明,两者的算子类型支持并没有因为 N10-72 的规模缩减而受限。遇到无法映射到 NPU 的算子,软件可以回退到 MCU 执行。
所以,模型能不能部署,和模型能不能高效运行,是两个问题。
如果有算子回退到 CPU,就得考虑 CPU 执行时间、数据交接和同步开销。就算 NPU 标称 85 GOPS,也不代表整个模型都能跑到这个速度。
03|NPU 缩小了,存储问题却没有消失
把计算单元裁到合适规模,只解决了面积预算的一部分。
神经网络推理还需要读取模型权重、保存中间特征,再把结果交给其他处理单元。
STM32H7P 采用 64 位 AXI 互连加 32 位多层 AHB 总线矩阵,连接片上存储以及 FMC、XSPI 等外部存储接口。
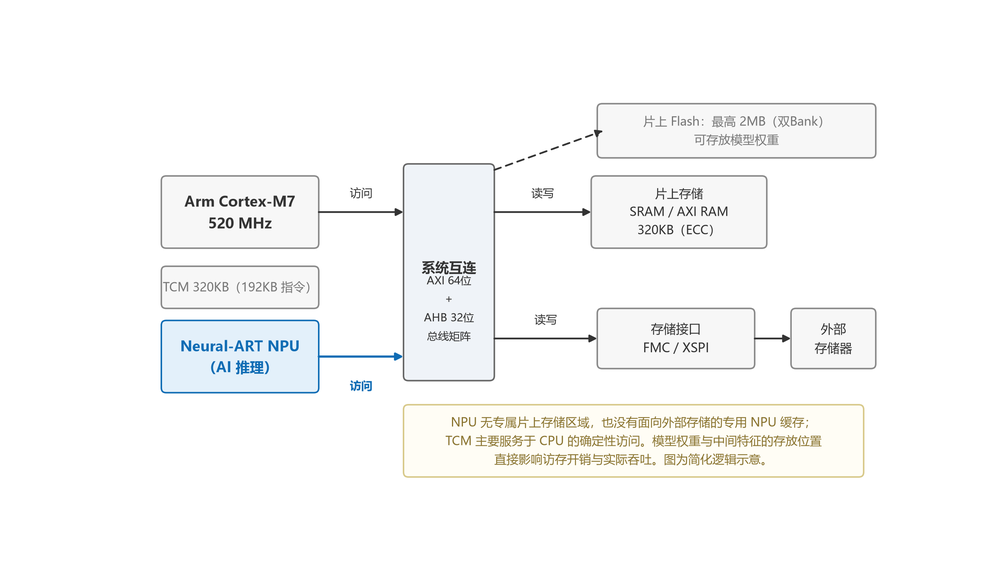
图4 STM32H7P的NPU通过系统互连访问相关存储资源,模型权重和中间特征的存放位置会影响访存开销。图为简化逻辑示意。(根据ST官方技术资料整理)
这里有一个关键的架构选择:NPU 能访问系统中映射的相关片上存储,但没有专属内存,也没有面向外部存储的专用 NPU 缓存。
这样一来,模型权重和中间特征的存放位置,就直接决定了访存开销和实际吞吐。
举个例子:如果中间特征频繁落在片外存储器,NPU 就得走外部接口读写数据。计算单元哪怕再快,也可能因为等数据而空转。
与此同时,CPU 还要跑实时控制任务,DMA 和其他硬件加速器也可能同时访问系统存储。
STM32H7P 提供最高 320KB TCM,其中 192KB 用于指令,另外还有 320KB 带 ECC 保护的 AXI RAM。TCM 主要是服务 CPU 的确定性访问,不能简单理解成 NPU 独占的高速缓存。
对工程师来说,部署模型时就得通盘考虑权重与中间特征的分配、存储访问路径、数据搬运以及潜在的总线竞争。
这套设计没有为 NPU 额外堆大容量专用存储,有利于控制硬件成本,但也让模型部署和存储布局优化变得更重要了。
04|GPU 和以太网没了,工业控制能力不能丢
删了一堆功能之后,STM32H7P 还得回答一个问题:它还算不算一颗合格的工业 MCU?
对电机控制、数字电源和逆变器而言,实时性与外设能力基本没有妥协空间。
STM32H7P 保留了 Cortex-M7,最高 320KB TCM,用来支撑对执行时间敏感的代码。外设方面,配备两组高分辨率定时器、最多 24 个通道、三组电机控制定时器,以及四组 12 位 ADC。
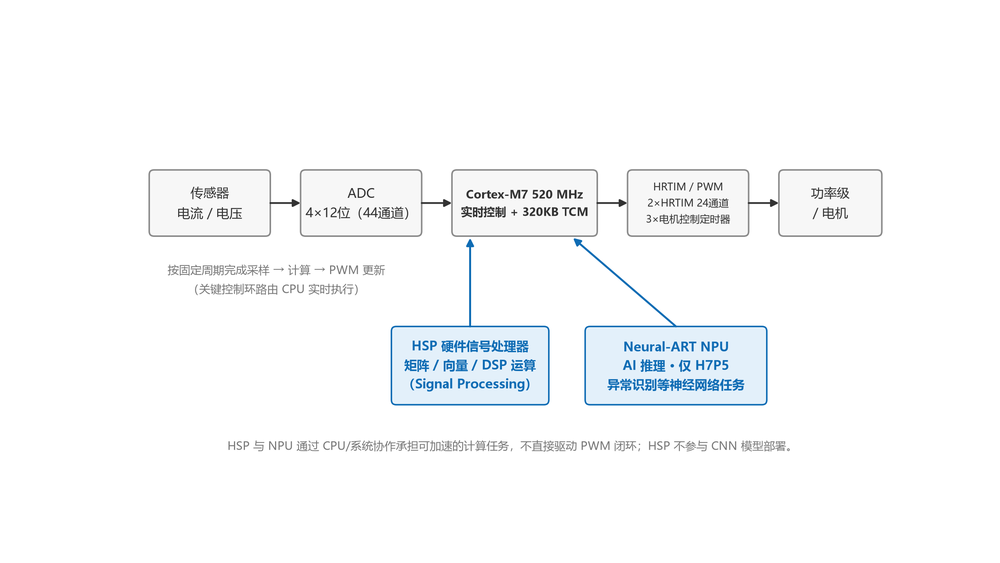
图5 STM32H7P保留工业控制所需的ADC、定时器及实时处理资源,同时通过HSP和特定型号的NPU承担适合硬件加速的计算任务。(根据ST官方资料整理)
这些资源为什么重要?
以数字电源为例,控制器必须按固定周期完成采样、计算和 PWM 更新。神经网络推理可以辅助判断异常状态,但绝不能让关键控制环路随意延迟。因此,STM32H7P 还加入了 HSP,专门加速矩阵、向量和数字信号处理。
ST 复用了此前 STM32U3 上的 HSP 设计,NPU 则源自 STM32N6 同代架构。两套成熟 IP 经过不同配置,被整合进同一颗面向工业控制的 MCU。
不过,HSP 并不是 NPU 执行神经网络前的必经前处理单元。它可以承接适合硬件加速的信号处理任务,但 ST 明确说明:HSP 不参与 CNN 模型部署。在 ST 提供的太阳能电弧故障检测案例里,把特定 AI 模型从 Cortex-M7 软件执行迁移到 NPU 后,推理速度提升约 40 倍。
还有一个容易被忽略的工业约束:高温运行。
STM32H7P 提供带裸露散热焊盘的封装选项。ST 介绍,在 125°C、350MHz、CPU 满负载 的指定工作条件下,产品能够满足其描述的 10 年运行设计要求。
注意,这里的 350MHz 不能与产品最高 520MHz 混为一谈,更不能理解成芯片在 125°C 下还能一直跑满最高频率。
对工业 MCU 来说,芯片面积、散热能力和长期可靠性必须一起权衡。加了计算单元之后,关键控制任务还得在规定条件下稳定执行。
05|这颗 MCU 给 SoC 设计留下了什么启发?
STM32H7P 的设计过程,可以看作一次典型的 SoC 资源重新分配。
先明确目标应用需要什么:实时控制、信号处理、异常检测和端侧 AI 推理。
再识别可以舍弃什么:目标场景里不需要图形界面和以太网的设备,相关 IP 就不再是必备配置。
然后裁剪已有加速器 IP:采用规模更小的 Neural-ART NPU,控制计算资源和面积,同时保留主要算子支持能力。
最后处理存储与互连:让 NPU 访问现有系统存储,同时接受模型规模、访存效率和软件优化上的约束。
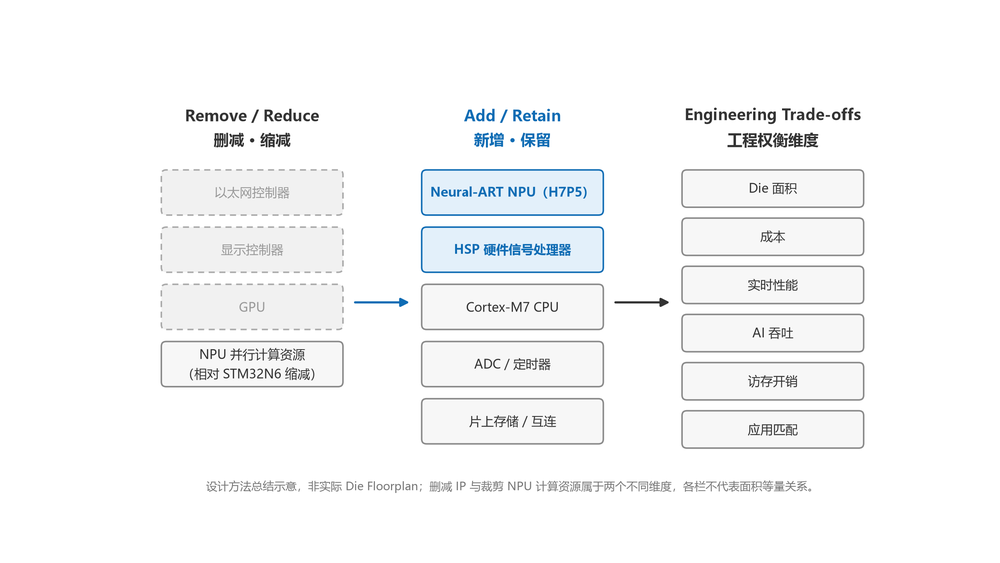
图6 STM32H7P展示了固定面积预算下的SoC设计思路:删减目标应用不需要的IP,裁剪计算资源,并在存储、成本和实时性之间重新平衡。(根据ST官方技术资料整理)
这里还有一个容易忽略的成本因素。
就算两颗芯片 Die 面积相同,制造成本也未必完全一致。不同 IP 的验证成本、良率、封装和软件投入,都可能有差异。
ST 此次公布的是相近的芯片面积和产品价格定位,不能据此认定所有研发与制造成本都没有变化。
对 SoC 工程师来说,这个案例有三点值得借鉴:按应用需求删减 IP、通过计算单元裁剪复用架构、把存储访问成本纳入加速器设计。
这也解释了为什么 STM32H7P 没有选择简单增加 CPU 核心数量,或者把更大的 NPU 整体塞进 MCU。
它必须在工业控制的面积、成本、功耗和实时性约束下,找到适配端侧 AI 的硬件配置。
目前 STM32H7P 仍处于客户送样阶段,ST 计划 2027 年 1 月量产。实际应用中的功耗、端到端推理延迟以及 CPU 实时性,还需要通过具体工作负载来验证。
STM32H7P 展示的设计思路很直接:当芯片面积不能无限扩张时,增加新能力的第一步,有时是决定哪些旧功能可以不要。
 发表于 9 小时前
|
查看: 1|
回复: 0
 /1


