在多数 GPU 程序里,CPU 一直扮演调度者:准备数据、发起 Kernel,GPU 只管执行计算。即便 GPU 需要 CPU 协助某项操作,通常也得提前把流程安排好。
不过,随着 GPU 承担的任务越来越复杂,这套分工模式开始显露短板。
以 MoE 推理为例,GPU 执行到某个阶段,才知道接下来要和哪些设备交换数据。如果这些通信依赖 CPU 侧软件处理,传统路径就可能引入额外的同步与调度开销。
图1 AMD Research 开源 KIWI,为 GPU Kernel 提供面向 CPU 的可编程任务请求机制(来源:AMD Research)
AMD Research 最近公开了 KIWI 项目,全称 Kernel-Initiated Workload-defined Invocations。该项目面向 ROCm/HIP 提供了一套 GPU 与 CPU 双向消息队列和可编程回调机制,让 GPU Kernel 能够在执行过程中主动发起 CPU 侧操作。
01|GPU 为什么需要反过来调用 CPU?
传统 GPU 程序往往沿着一条相对固定的控制路径运行:CPU组织工作,GPU执行计算,CPU 同时还要负责操作系统服务以及大量外部资源管理。
这种模式适合任务边界清晰的工作负载。比如一次矩阵乘法的输入、输出和执行步骤,在启动 Kernel 之前就已经基本确定。
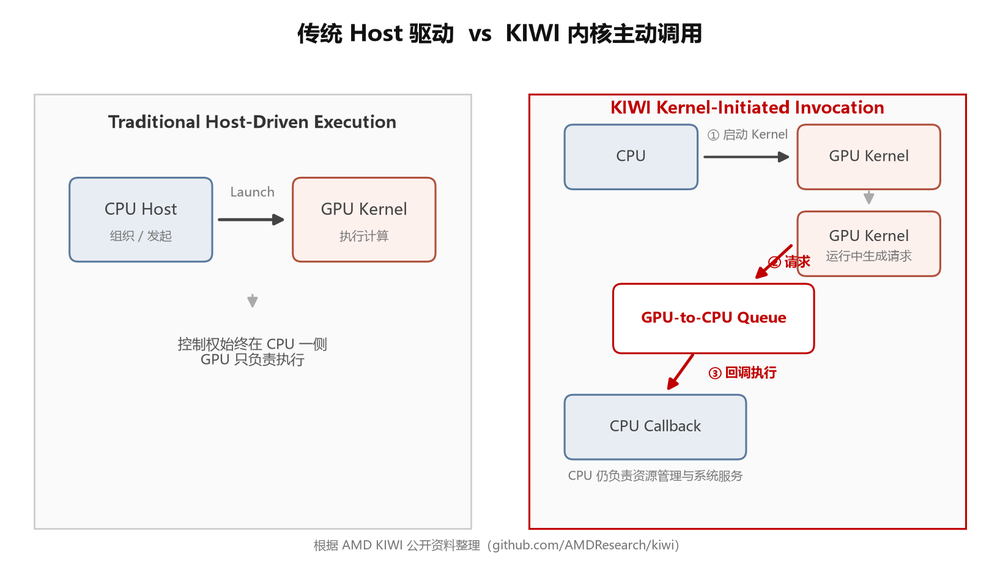
图2 传统 GPU 程序主要由 CPU 发起计算任务;KIWI 进一步允许运行中的 GPU Kernel 主动请求 CPU 执行回调(根据 AMD KIWI 公开资料整理)
但并非所有任务都能提前安排。以 MoE 模型为例,Token 要先经过路由计算,才能确定由哪些 Expert 处理。如果 Expert 分布在不同 GPU 甚至不同节点上,通信组织就必须依赖运行时结果。
GPU 已经算出下一步需要什么,却仍可能依赖 CPU 侧的软件机制去完成相关操作。
一种做法是在 CPU 端提前组织更多工作,或者在 GPU 计算之间插入同步点。但当任务变化频繁、控制消息又很小时,这些操作反而可能成为额外负担。
KIWI 则尝试提供另一条路径:让 GPU 在 Kernel 内部生成请求,交给 CPU 侧回调处理。这相当于允许正在干活的 GPU 主动给 CPU 派任务,而不必所有操作都从 CPU 一侧发起。
02|KIWI 如何让 GPU 主动发起请求?
KIWI 的核心由两部分组成:GPU 与 CPU 之间的消息队列,以及构建在队列之上的回调调用层。
它并没有让 GPU 直接执行 CPU 指令,而是借助一套请求传递机制,把 GPU 产生的工作交给 Host 侧处理。
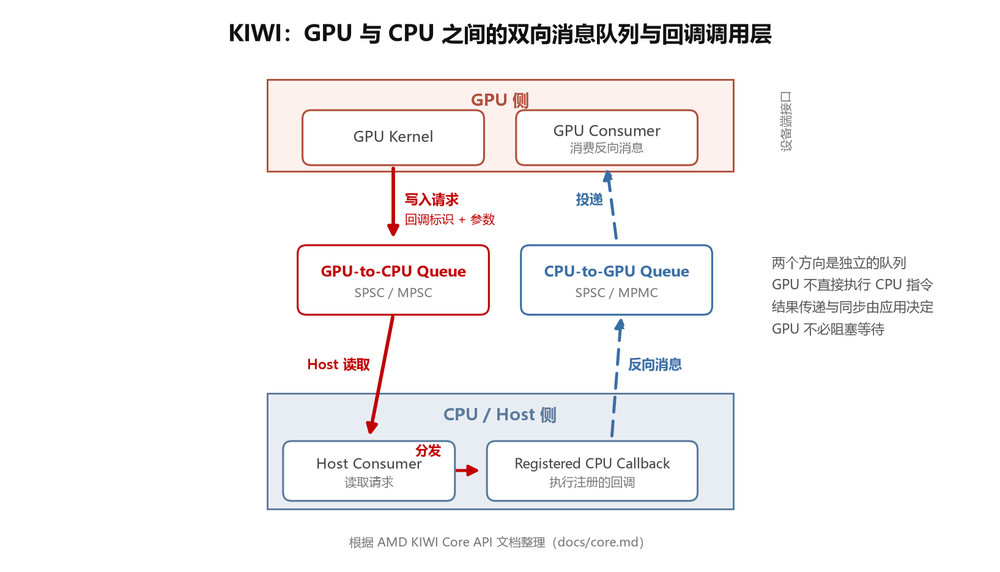
图3 KIWI 通过 GPU 与 CPU 之间的消息队列发起和处理任务请求,CPU 侧执行回调,反向通信及同步由应用按需组织(根据 AMD KIWI 技术文档整理)
第一步,GPU Kernel 通过设备端接口向队列写入请求。请求中包含回调标识和相应参数,CPU 端读取后调用预先注册的处理函数。
第二步,KIWI 利用细粒度 Host 内存支持实现 GPU 与 CPU 之间的通信。其 GPU 到 CPU 队列支持 SPSC(单生产者、单消费者)和 MPSC(多生产者、单消费者)模式,可适配不同数量的 GPU 执行单元同时发出请求的场景。
CPU 执行完对应回调后,结果传递与同步方式取决于应用设计。除了 GPU 到 CPU 的 SPSC、MPSC 队列,KIWI 还提供 CPU 到 GPU 的 SPSC 与 MPMC 队列,可支持反方向消息传递。但这并不意味着每次回调都会自动返回结果,也不代表 GPU 必须阻塞等待 CPU 完成操作。
值得注意的是,KIWI 传递的主要是控制消息,并不要求所有大规模数据都经过 CPU 内存复制。实际数据仍可走适合应用的 GPU、DMA 或通信路径传输。
03|为了降低队列开销,AMD 做了哪些设计?
让 GPU 给 CPU 发送请求并不复杂,难点在于如何把请求成本压到足够低。
如果每次调用都伴随大量原子操作、缓存同步和 PCIe 访问,GPU 虽然获得了主动发起任务的能力,却可能把大量时间耗在等待控制消息上。
KIWI 针对这些问题设计了一套较为轻量的队列。
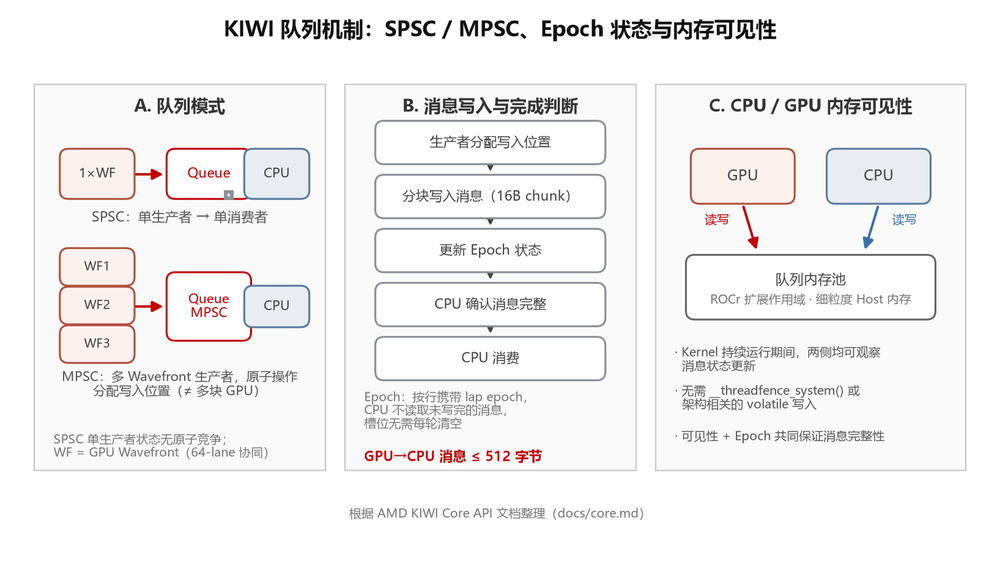
图4 KIWI 通过 SPSC/MPSC 队列、消息状态标记与细粒度 Host 内存机制,实现 GPU 到 CPU 的低开销请求传递(根据 AMD KIWI Core 文档整理)
以单生产者、单消费者模式为例,生产者和消费者的位置管理可以避免额外的共享原子竞争。GPU 还可以缓存队列的消费进度,减少热路径上反复读取 Host 状态带来的流量。
当多个 GPU Wavefront 需要向 CPU 提交任务请求时,KIWI 的 MPSC 队列允许多个生产者共享同一条消息队列。各生产者通过原子操作分配写入位置,再由 CPU 侧统一消费。
另一个细节是消息布局。KIWI 的 GPU 到 CPU 消息最大支持 512 字节,数据采用分块写入,并借助状态标记判断消息是否完整可见。
这解决了一个很实际的问题:CPU 不能因为看到消息开头已经写入,就去读取尚未写完的剩余部分。
KIWI 使用 Epoch 状态判断消息是否就绪,让消费者能够识别完整消息,无需每轮都清空队列槽位。其当前设备端实现也对 AMD GPU 的 64 线程 Wavefront 协同操作有明确要求。
队列能正常工作,还依赖 CPU 与 GPU 之间的内存可见性。KIWI 使用 ROCr 提供的扩展作用域细粒度 Host 内存池分配队列,让两侧能够在 GPU Kernel 持续运行期间观察消息状态。再配合消息中的 Epoch 标记,CPU 可以判断数据是否已完整写入,避免在消息尚未完成时就提前消费。
这些机制都指向同一个目标:尽可能降低 GPU 发起 CPU 工作时的消息传递与同步成本。
04|这套机制能用在哪里?
KIWI 的公开仓库目前提供两类原型应用:P2P 通信,以及 MoE Expert Parallel 中的 Dispatch 与 Combine 操作。
P2P 通信需要在设备间传递数据,但具体通信行为往往由 GPU 计算结果决定。如果 GPU 能直接生成 CPU 侧通信请求,就有机会减少传统 Host 驱动流程中的部分控制交接。
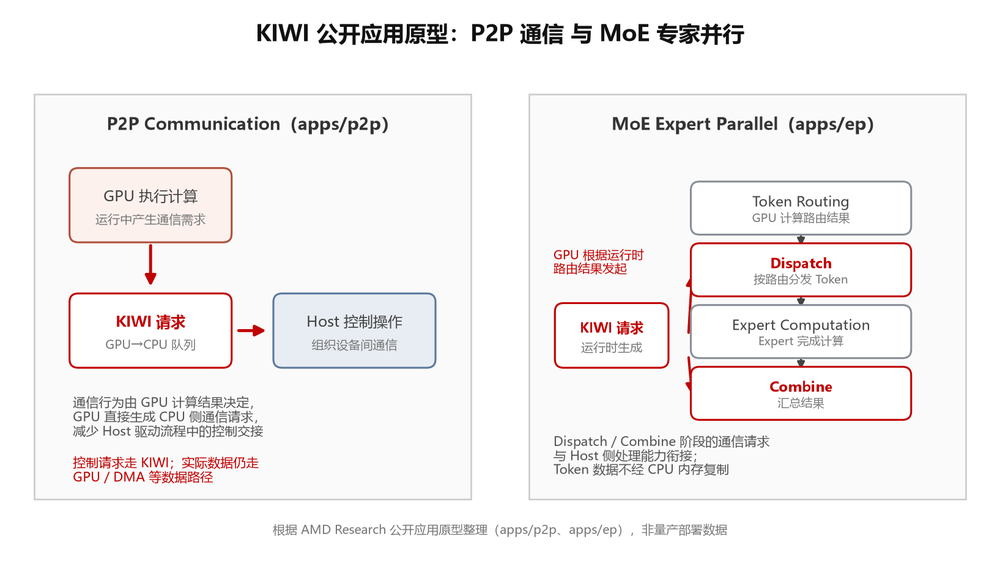
图5 KIWI 的公开原型包含 P2P 通信和 MoE 专家并行场景,展示 GPU 运行时请求如何与 Host 侧控制操作结合(根据 AMD Research 公开项目整理)
MoE 推理更能体现这种需求。Expert 路由结果由 GPU 计算产生,后续需要把 Token 分发到相应 Expert,计算完成后再汇总结果。KIWI 尝试把这些运行时产生的通信请求与 Host 侧处理能力衔接起来。
KIWI 的工程价值在于:面向 AMD ROCm/HIP 提供一套可编程队列与调用层,并将其应用于 GPU 通信和 MoE 应用原型。
公开仓库已提供测试及 Benchmark 代码,但目前还无法据此认定 KIWI 在所有应用中都优于传统 Host 驱动方式。端到端收益仍需结合具体负载、队列压力和同步策略来验证。
05|GPU 与 CPU 的分工正在变得更灵活
KIWI 带来的一个变化是:CPU 与 GPU 之间的任务发起关系可以更灵活。
过去,CPU 通常是 GPU 计算流程的组织者。如今,对于一些依赖运行时计算结果的任务,GPU 也可以成为工作请求的发起方,而 CPU 则承担它更擅长的控制与服务操作。
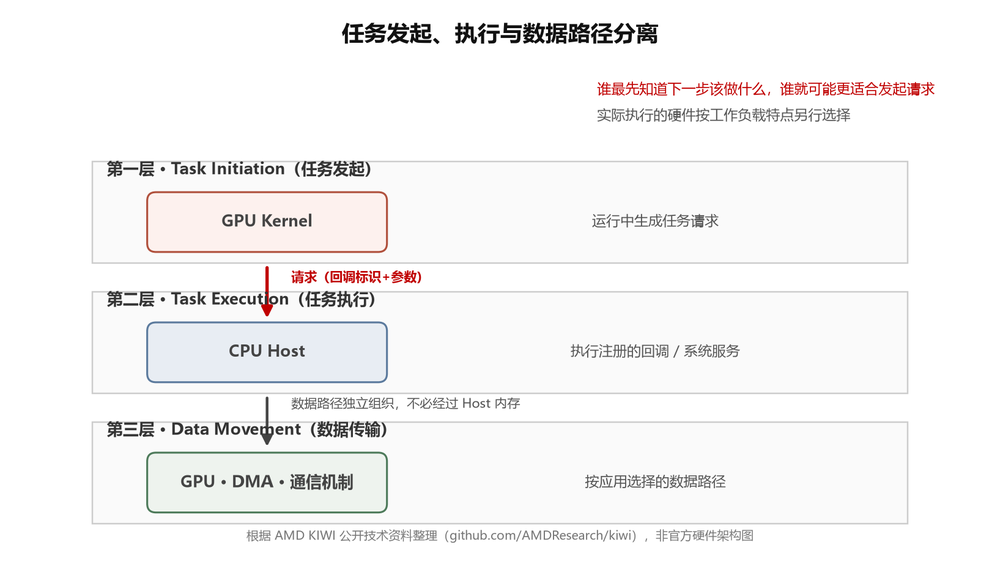
图6 KIWI 展示了异构计算中任务发起、CPU 侧执行与实际数据传输路径可以分别组织的设计思路(根据 AMD KIWI 公开技术资料整理)
这种设计仍然保留了 CPU 的优势:操作系统交互、复杂分支处理以及丰富的软件接口。
同时,GPU 可以继续专注高吞吐计算,在需要时通过轻量控制消息请求外部协助。
对于 SoC 和异构系统工程师,KIWI 也提供了一套值得借鉴的设计思路:把任务发起权、实际执行位置和数据传输路径分开考虑。
谁最先知道下一步该做什么,谁就可能更适合发起请求;而真正执行任务的硬件,则可以根据工作负载特点另行选择。
KIWI 目前还是一个仍需进一步验证的开源实现,但它展示了一种有意义的异构计算组织方式:GPU 不仅可被 CPU 调度,也能在运行过程中主动组织需要 CPU 协助完成的工作。
 发表于 9 小时前
|
查看: 2|
回复: 0
 /1


