谷歌刚刚发布了 Gemini 4 Hydrogen。
它是 Gemini 4 系列继 Argon、Carbon 之后的第三个模型,也就是此前一直被传为「Gemini 4 Flash」的那一档。谷歌最终没有沿用 Flash 这个名字,而是直接把内部代号 Hydrogen 定为正式名称。
碳、氩、氢,氢在元素周期表里排第一,也最轻,拿来命名最快最省的一档,倒也贴切。这已经是谷歌六周之内发布的第三个新模型。
谷歌 CEO Sundar Pichai 表示:
继 Carbon 和 Argon 之后,Gemini 4 Hydrogen 把前沿智能带给所有人。它为速度和效率而生,面向日常任务、编程和 Agent 工作流。相比 3.8 Flash,它完成任务的速度快 2.5 倍。它还有 4 档思考深度,任务需要多深的推理,你就只为多深的推理等待和付费。
这次免费用户也能用上 Hydrogen。
AI Studio 和 Gemini API 的所有档位、Gemini App、谷歌搜索,今天起都开始推送。付费的 Google AI Pro 和 Ultra 用户还能在 Antigravity 里使用。
成绩:多项领先,终端和电脑操作仍落后
官方成绩单选择的对比对象,是同一档位的 Claude Sonnet 5.5 和 GPT-6.1 Terra。
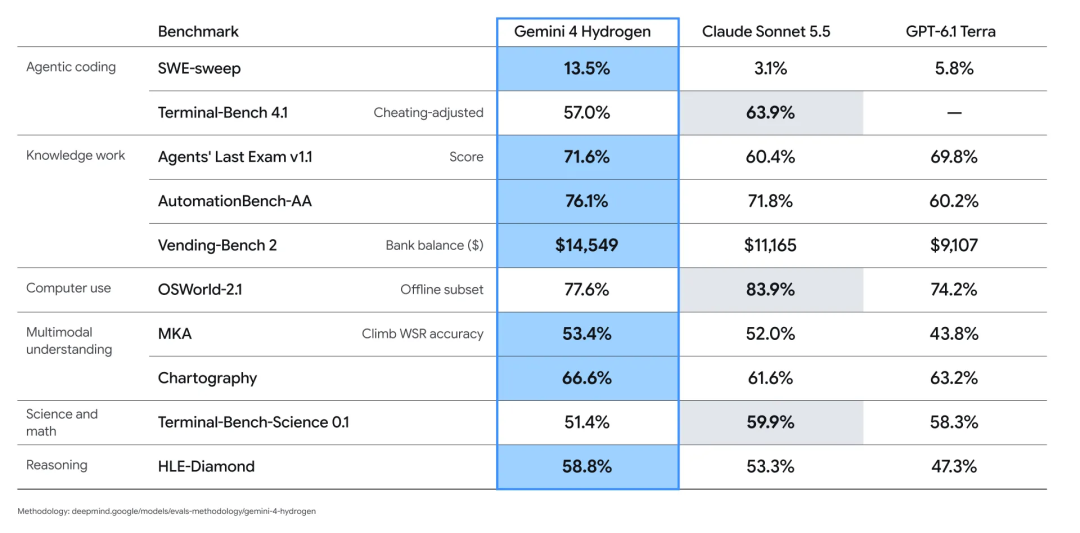
在 Artificial Analysis 智能指数上,Hydrogen 默认的 high 档得 51 分,超过了同系列 Argon 的 50 分。开到最高的 xhigh 档则是 54 分。
表里差距最大的一项是 SWE-sweep,它测试模型能否在不破坏已有代码的前提下,自己找出并修好 bug。
Hydrogen 在这一项拿了 13.5%,Sonnet 5.5 只有 3.1%,GPT-6.1 Terra 是 5.8%。
Vending-Bench 2 让模型经营一台自动售货机,看最后账上剩多少钱。Hydrogen 最终账上有 14,549 美元,比 Sonnet 5.5 多了三千多美元,看来谷歌的模型做小生意也有一手。
此外,在 Agents' Last Exam v1.1、AutomationBench-AA、多模态的 MKA 和 HLE-Diamond 上,它也都是三家里最高的。
不过有三项它落后了:
- Terminal-Bench 4.1:Hydrogen 为 57.0%,Sonnet 5.5 为 63.9%。
- OSWorld-2.1:Hydrogen 为 77.6%,Sonnet 5.5 为 83.9%。
- Terminal-Bench-Science:Hydrogen 为 51.4%,Sonnet 5.5 为 59.9%。
在终端里跑的 Agent 任务和电脑操作上,Sonnet 5.5 仍然更强一些。
和上一代 3.8 Flash 相比,Hydrogen 基本是全面换代。Terminal-Bench 4.1 从 18.2% 涨到 57%,是原来的三倍多。编造事实的情况也降到了原来的五分之一以下。
第三方机构 Artificial Analysis 第一时间给出了独立评测。
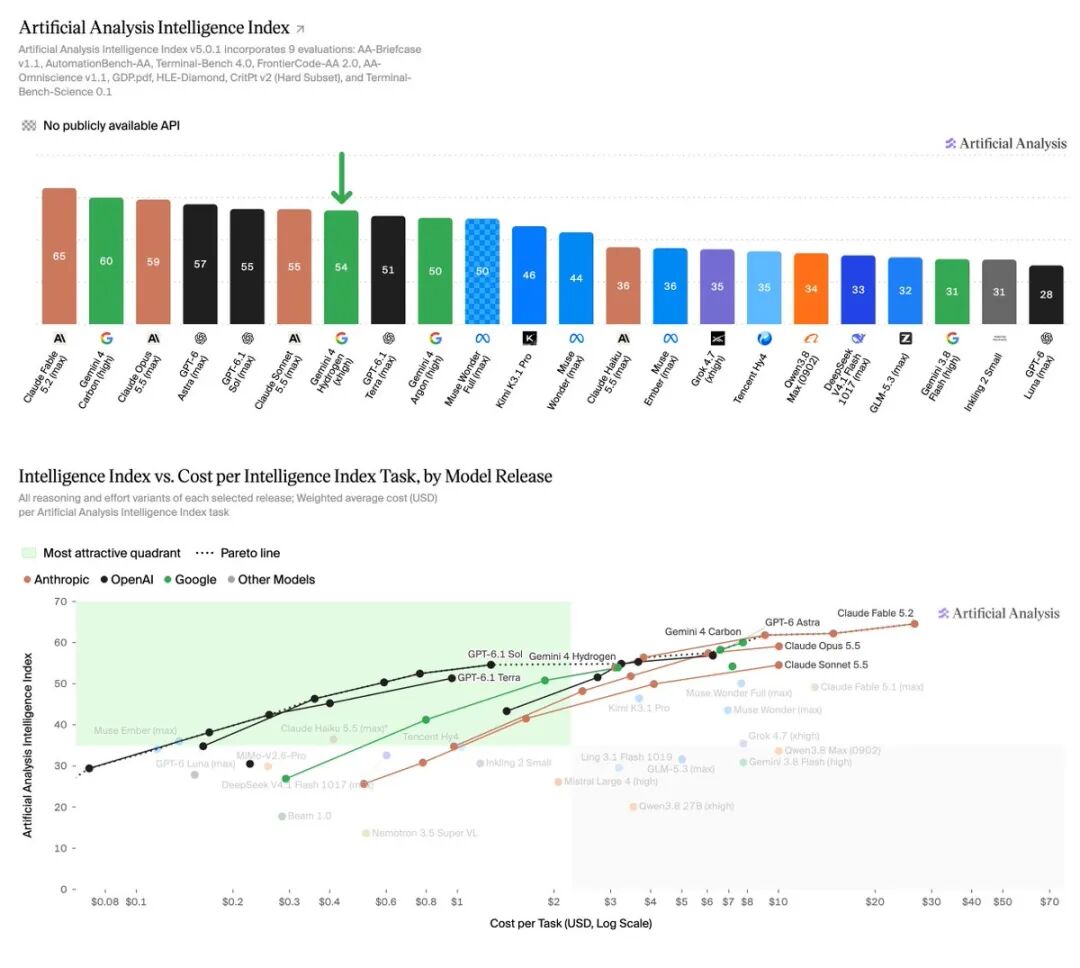
xhigh 档的 Hydrogen 得 54 分,只比 Claude Sonnet 5.5 和 GPT-6.1 Sol 的最高档各低 1 分。它每个任务的成本约为 Sonnet 5.5 的 32%,但约是 GPT-6.1 Sol 的 2.5 倍。
它的另一个强项是幻觉率低。在 AA-Omniscience 上,Hydrogen 的幻觉率只有 8%,Sonnet 5.5 是 43%,GPT-6.1 Sol 是 52%,是 AA 记录过的最低水平之一。
在终端类 Agent 任务上,结果和预期一致:Terminal-Bench 4.0 上,Hydrogen 以 54% 不敌 Sonnet 5.5 的 64%。
速度:单步 7.3 秒,Agent Arena 前十里最快
Hydrogen 主打的是速度。
在 Agent Arena 上,Hydrogen 单步平均只需 7.3 秒,是榜单前十里最快的模型。速度约为 Sonnet 5.5 的 2.7 倍、GPT-6.1 Sol 的 3.1 倍。
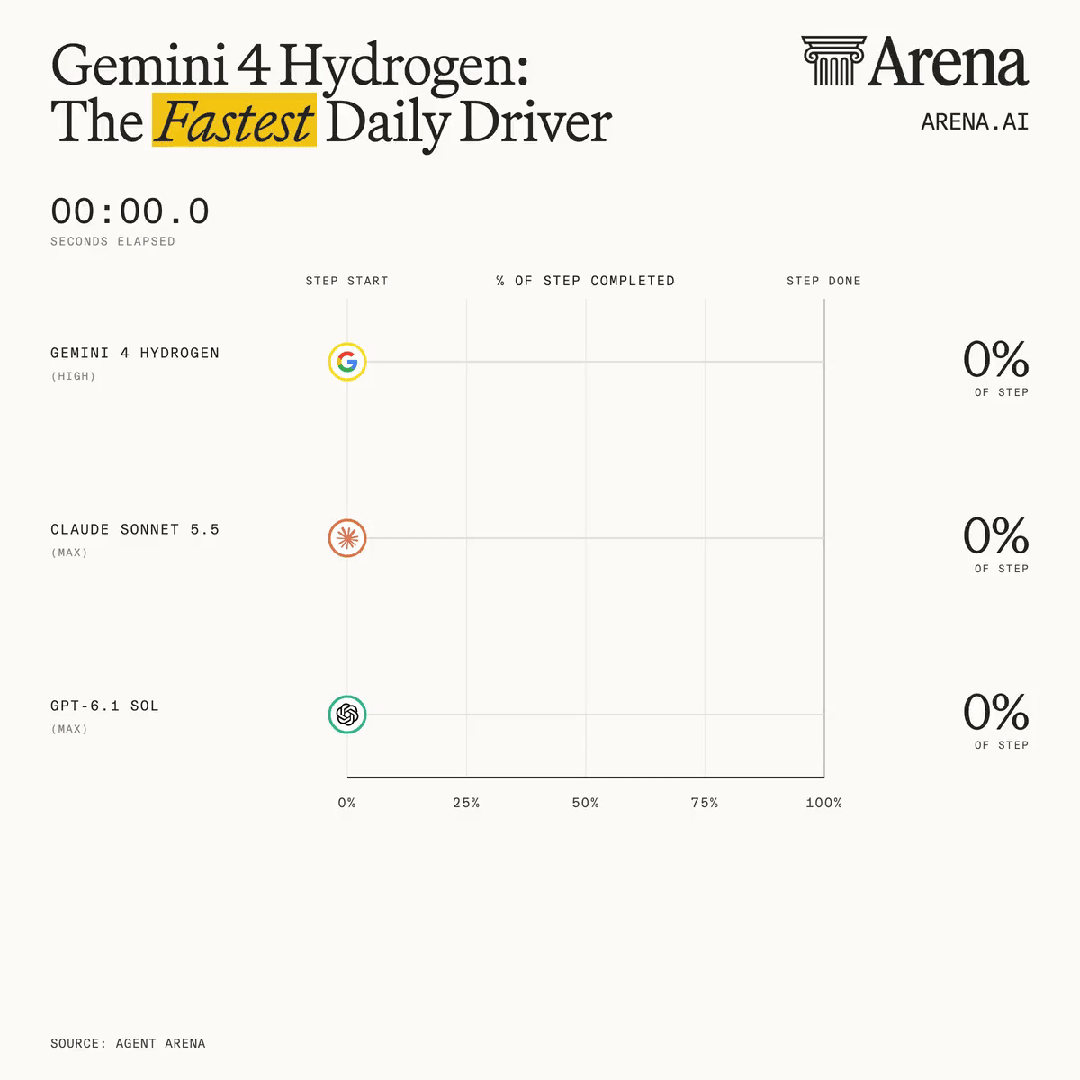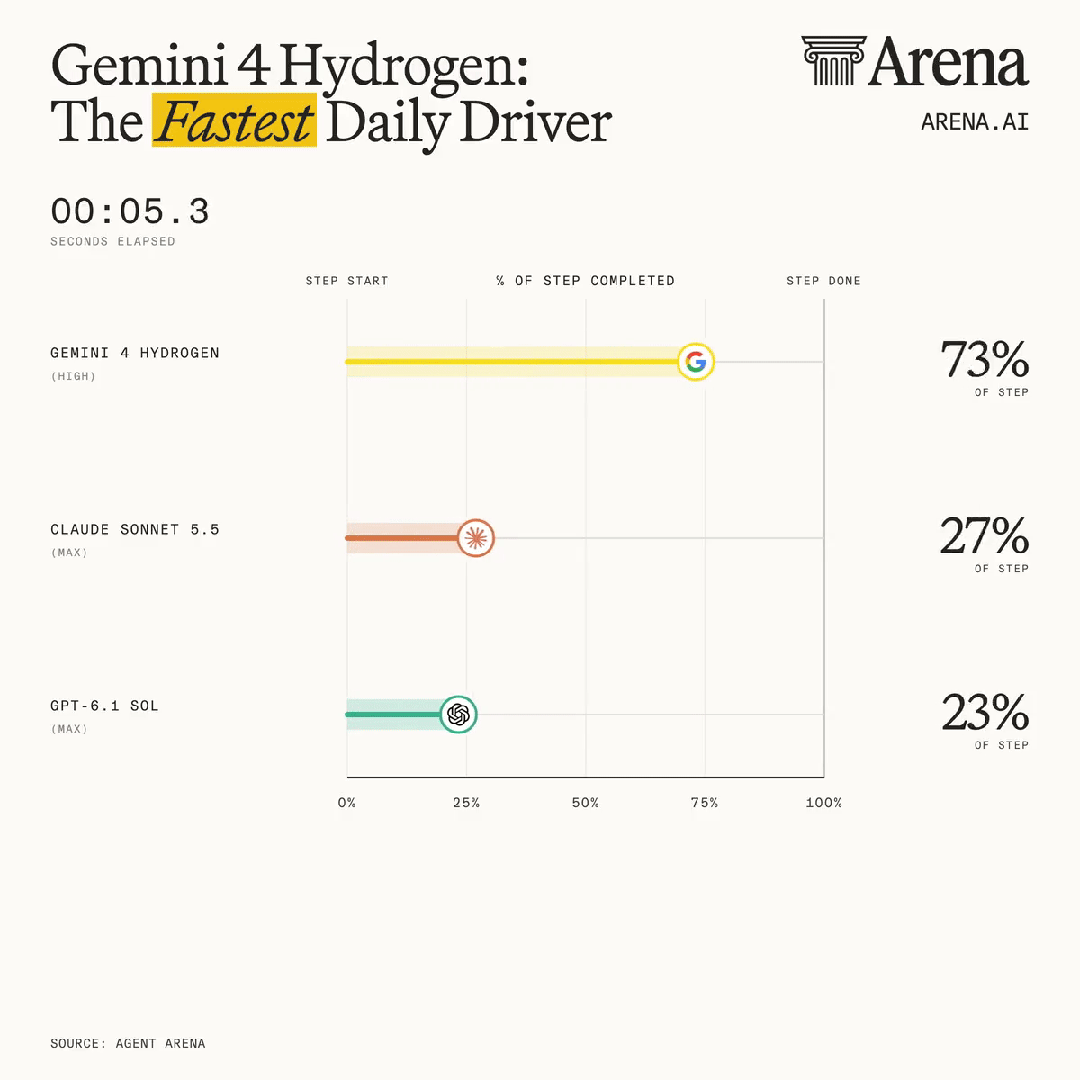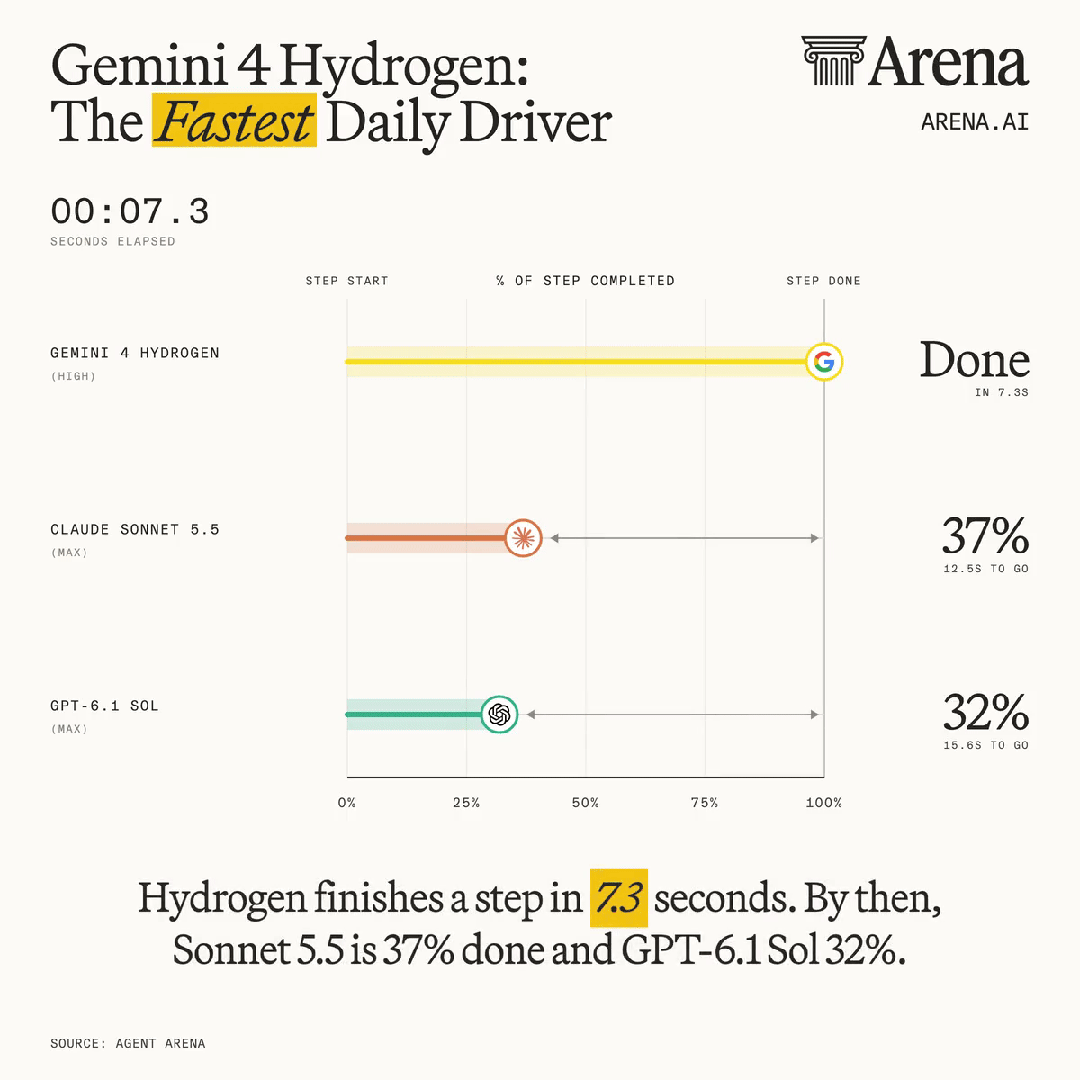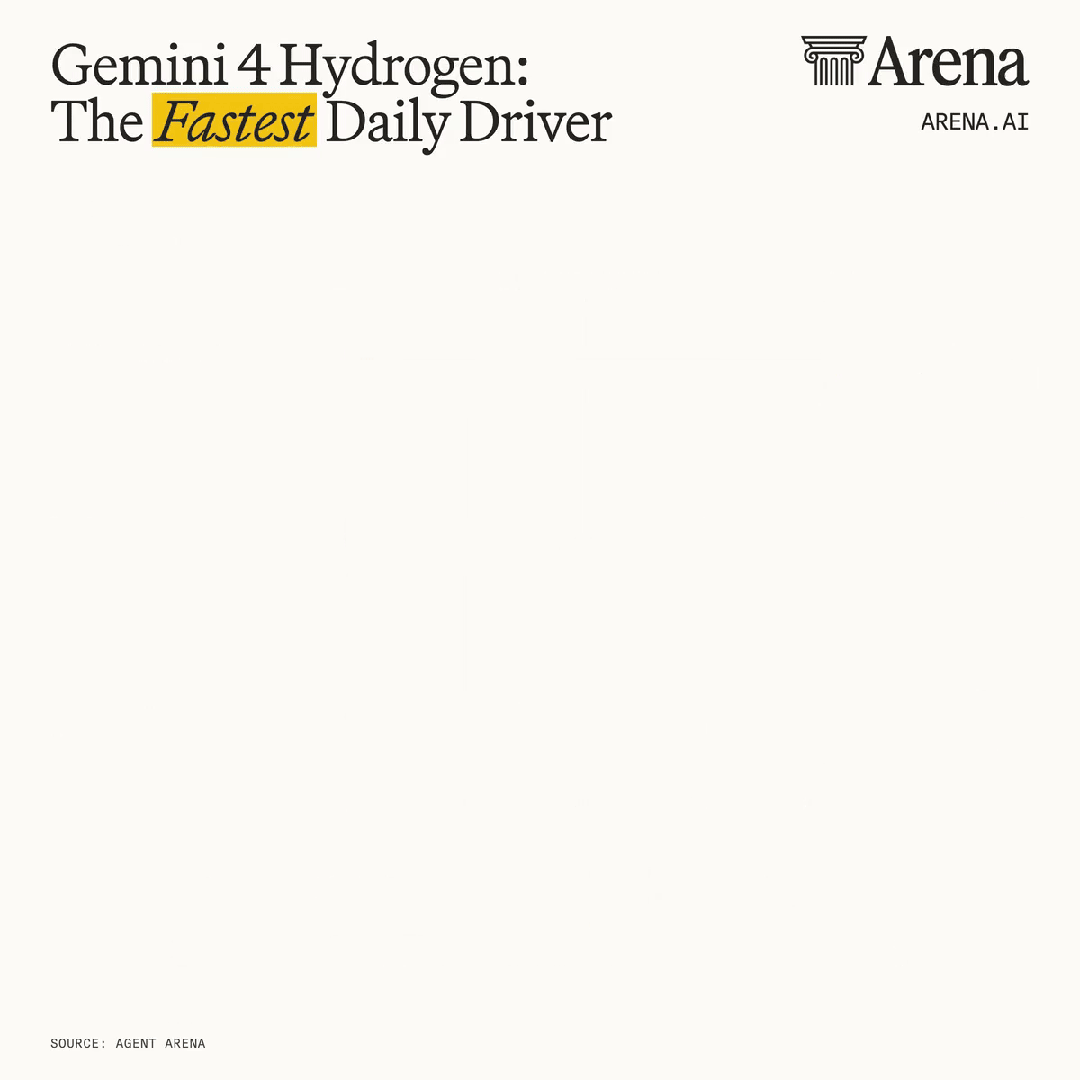
Hydrogen 完成一步时,Sonnet 5.5 才走了 37%,GPT-6.1 Sol 走了 32%。
放到整个任务上,Hydrogen 有 82% 的任务在 10 分钟内完成,GPT-6.1 Sol 是 55%,Sonnet 5.5 是 44%。到 30 分钟时,Hydrogen 已完成 97%,GPT-6.1 Sol 和 Sonnet 5.5 分别是 81% 和 78%。
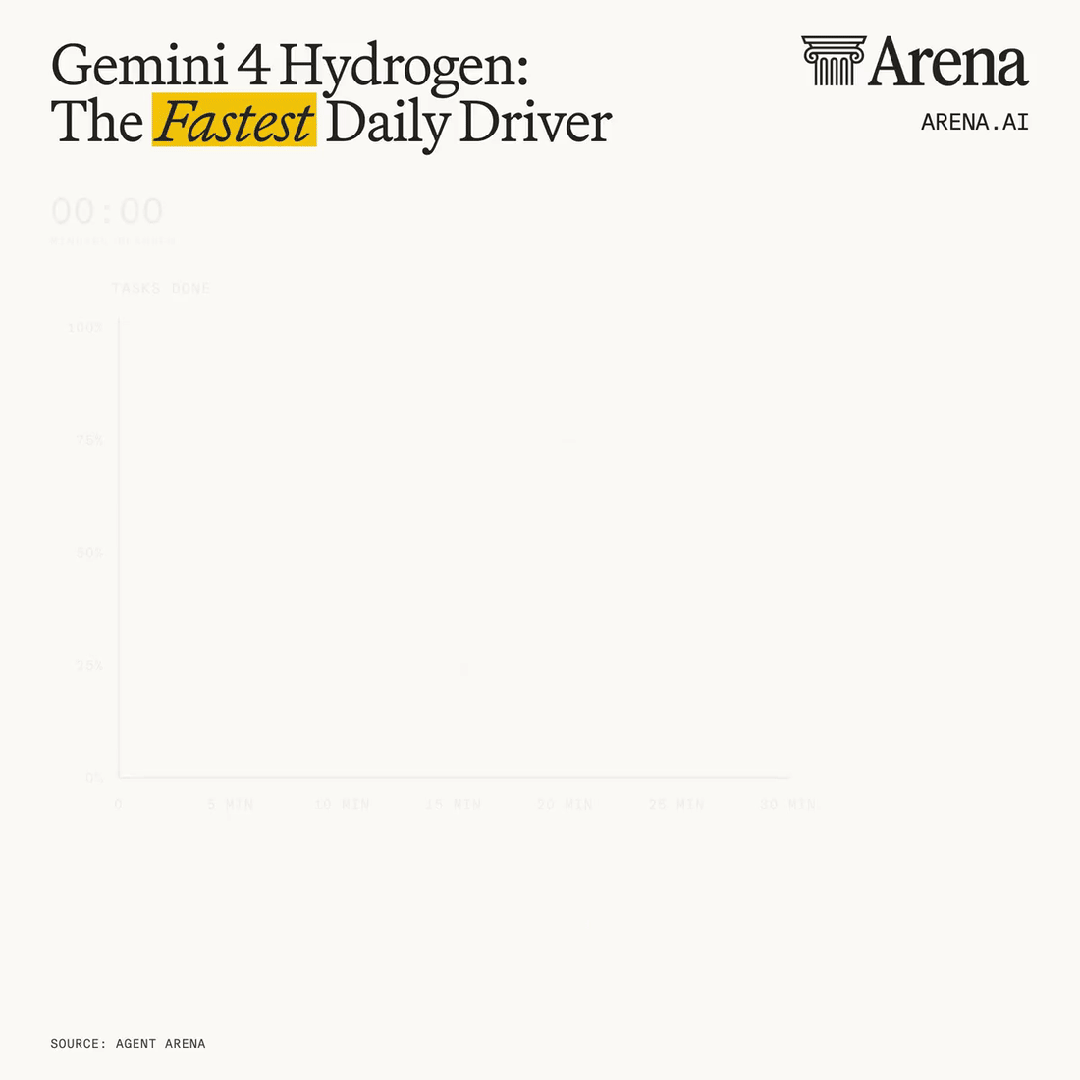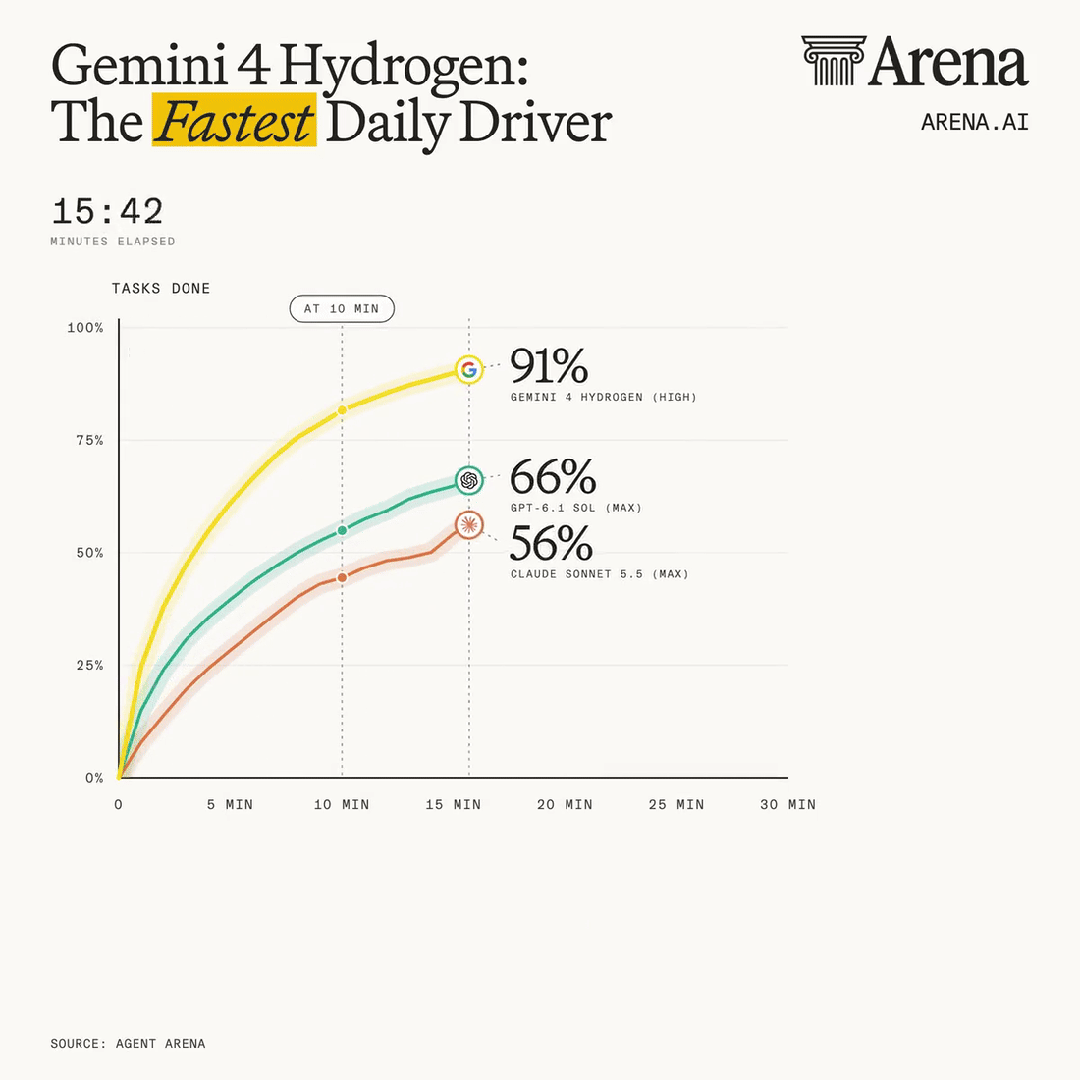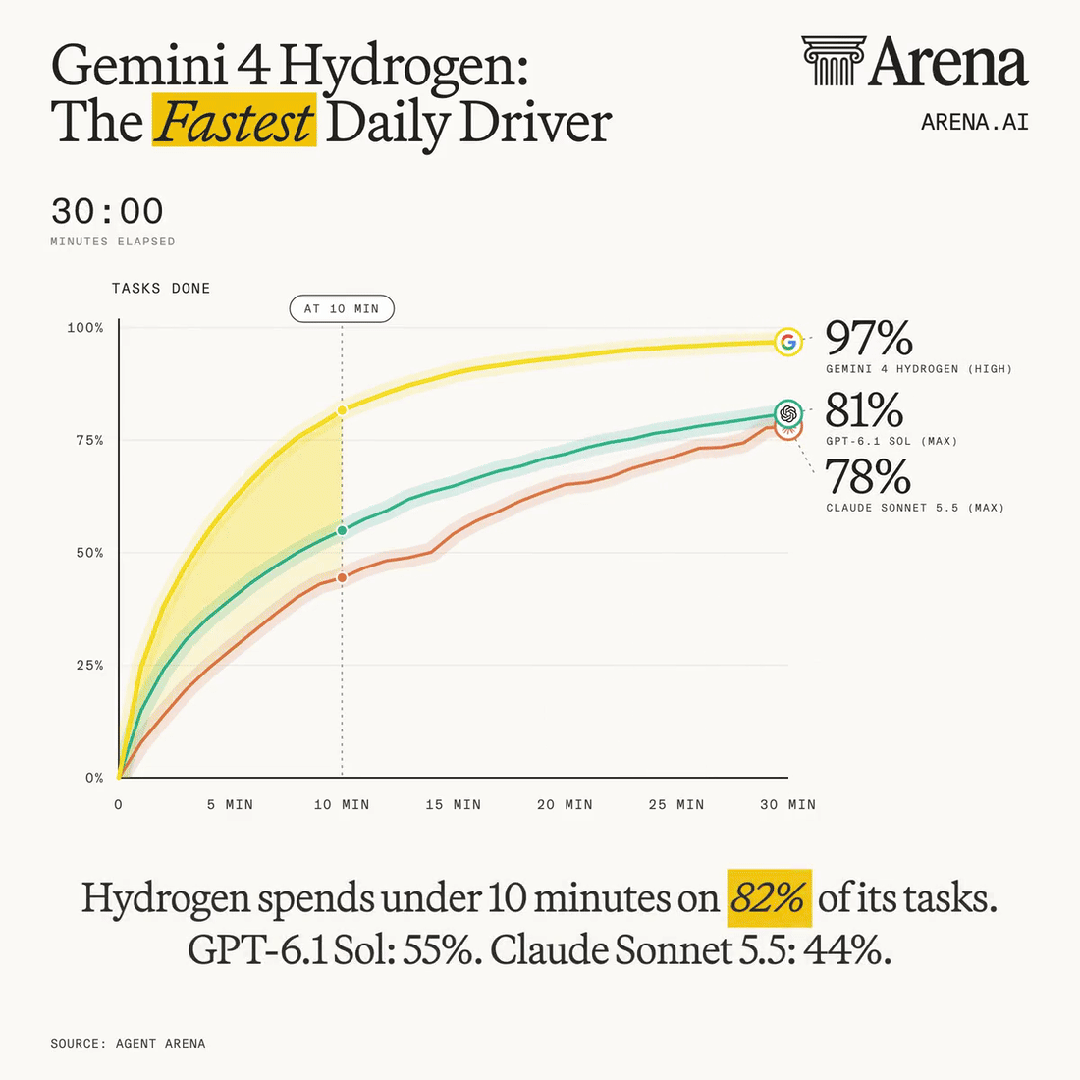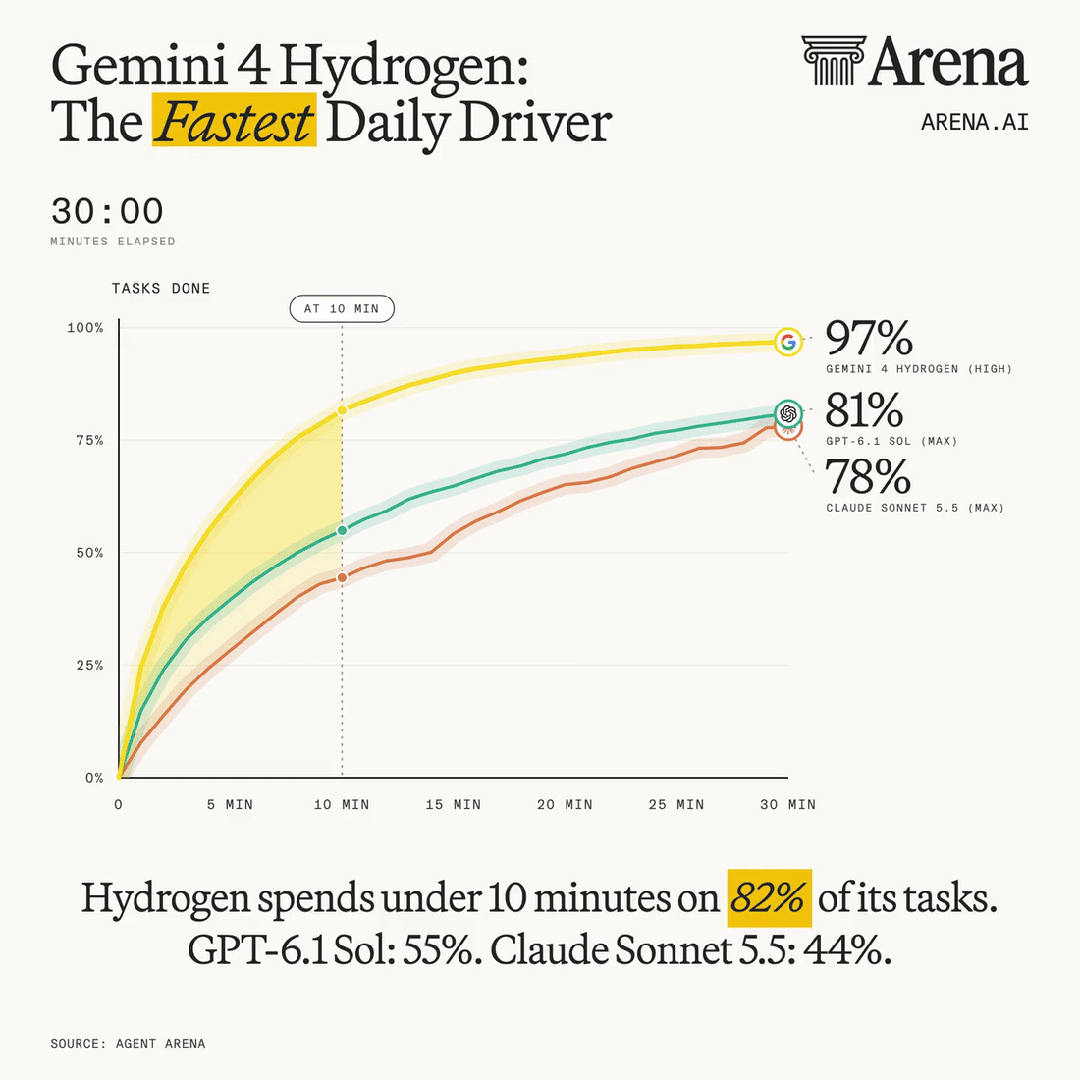
Arena 也特别说明,这并不是拿质量换速度,Hydrogen 的净提升和这两个模型基本持平。在 6500 次真实 Agent 会话中,Hydrogen(High)的净提升是 +14.8%,首发排在 Agent Arena 第 5 名。
单个任务的中位耗时是 5.3 分钟,比第一名的 Claude Fable 5.2 快 3 倍。每个任务的中位成本只有 1.6 美元。
不过它话也偏多:每个任务输出的 token 比 Carbon 多 41%,是 Argon 的 2.8 倍。
四档思考深度与定价
Hydrogen 有 low、medium、high、xhigh 四档思考深度,默认是 high。xhigh 是本次新增,也是 Gemini 模型第一次出现比 high 更高的一档。
Artificial Analysis 测算的四档智能指数和每任务成本如下:
- low:27 分,0.29 美元
- medium:41 分,0.80 美元
- high:51 分,1.87 美元
- xhigh:54 分,3.16 美元
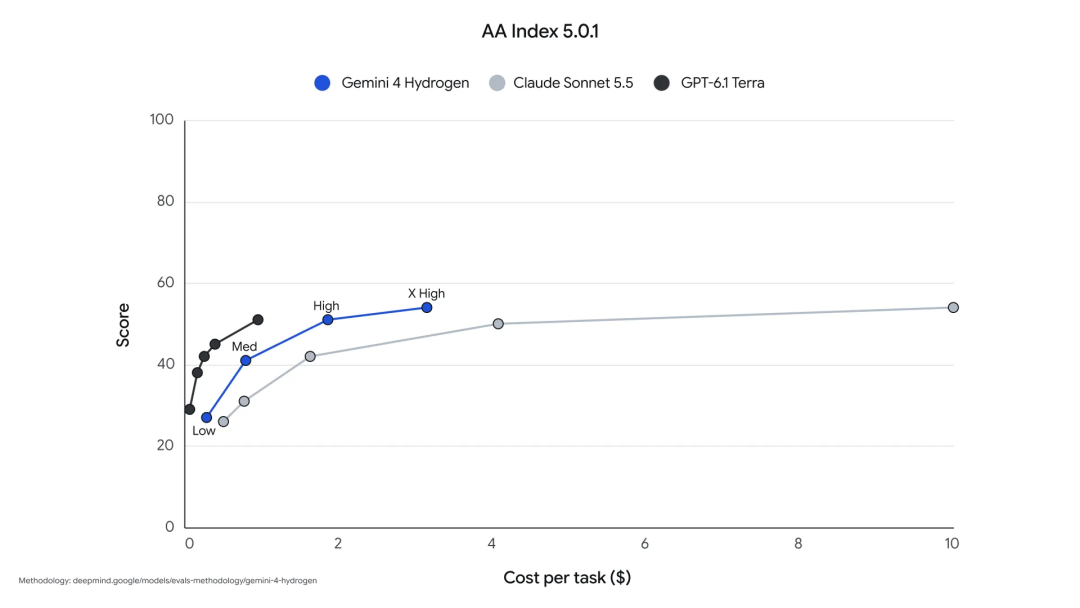
从 high 开到 xhigh,输出 token 差不多翻倍,智能指数只多了 3 分。
在 Terminal-Bench 4.0 上,xhigh 和 high 的得分甚至相同(AA 测得都是 54%),多花的钱等于白花。
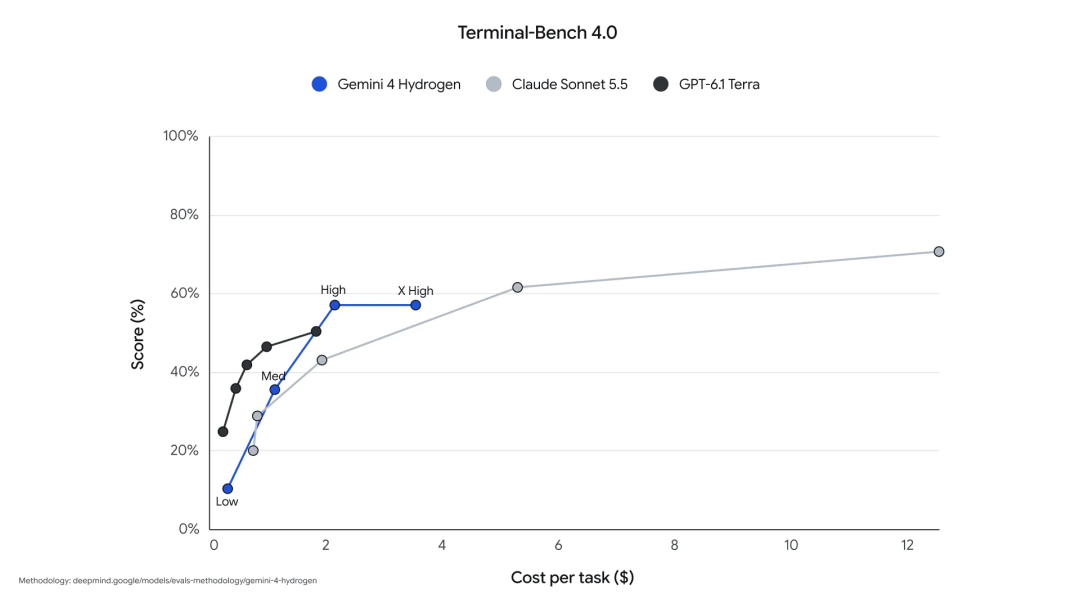
AI Studio 文档也提醒,xhigh 会增加延迟和 token 消耗,在简单的 prompt 上还容易想太多。
Hydrogen 在整个 1M 上下文内统一定价:输入 1.5 美元、输出 7.5 美元每百万 token。缓存命中的输入只收 5%,即 0.075 美元。
作为对比,Carbon 和 Argon 的 API 定价是输入 2 美元、输出 10 美元。单看 token 单价,Hydrogen 只便宜了四分之一。
那它省钱省在哪?主要省在每个任务的总成本上。按 AA 的测算,high 档的 Hydrogen 与 Argon 智能相当,每个任务的成本却只有 Argon 的 19% 左右。
Orchestrator:Carbon 规划,Hydrogen 执行
和 Hydrogen 同时发布的,还有 Antigravity 里的新选项 Orchestrator。
它不再从头到尾只用一个模型,而是在同一个会话里让 Carbon 和 Hydrogen 来回切换。在模型下拉菜单里选中它即可。
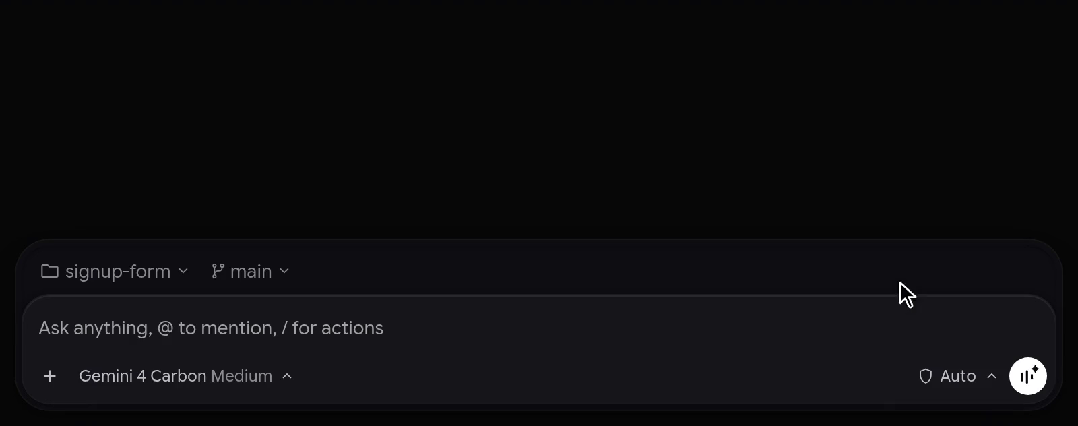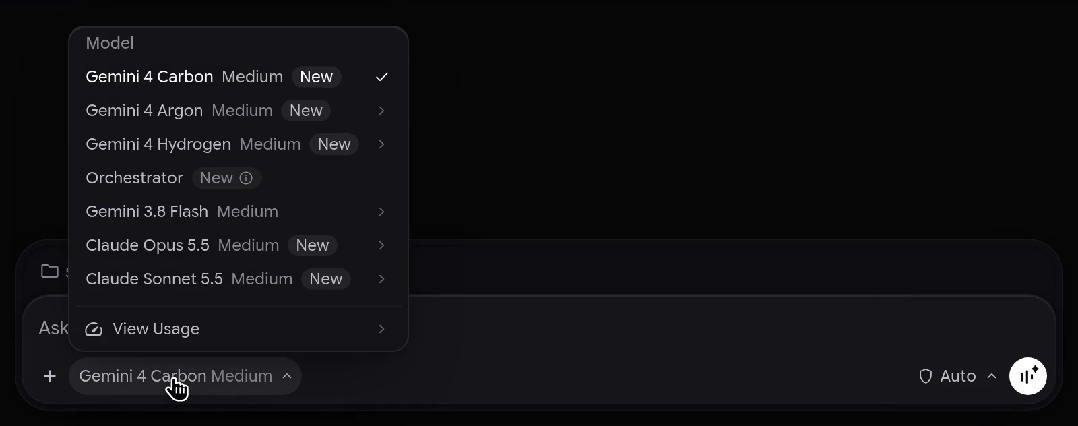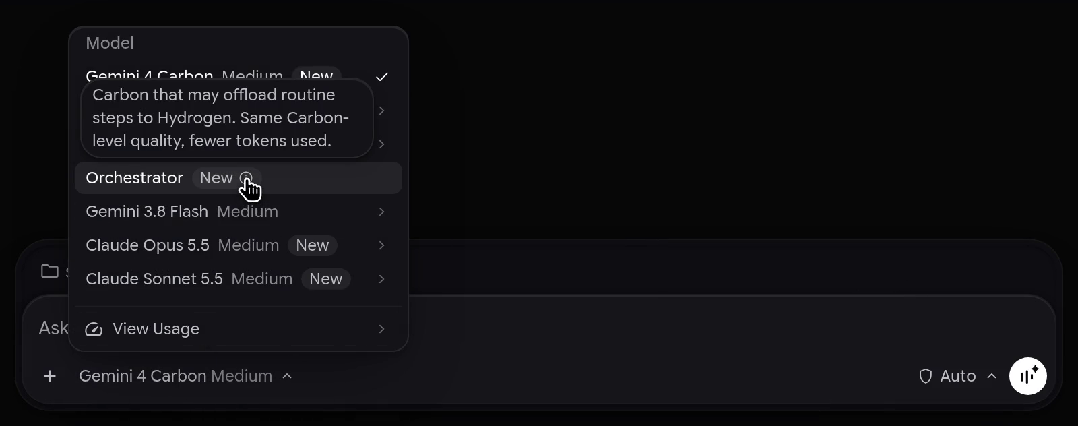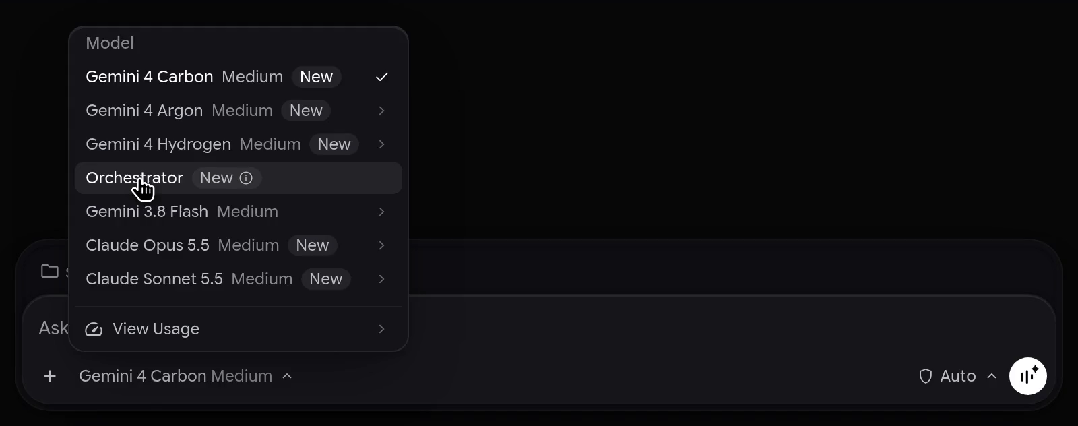
具体分工是这样的:Carbon 先在只读阶段摸清依赖、定好计划,再交给 Hydrogen 去改代码、升级依赖包、跑测试。Hydrogen 遇到卡住的地方,会交回给 Carbon。
在 Terminal-Bench 上,Orchestrator 的任务成功率接近纯 Carbon,平均少用 24% 的额度,完成速度快 19%。
在需要并行 Agent的场景里,也可以让 Carbon 当协调者,Hydrogen 去驱动各个隔离工作区里的 worker 和 verifier Agent,同时构建和测试改动。
Antigravity 还用 SDK 搭了一个开源的 issue 分诊系统做演示。其中 Hydrogen 负责分诊和写代码,重构、新功能和安全检查这类任务则路由给 Carbon。
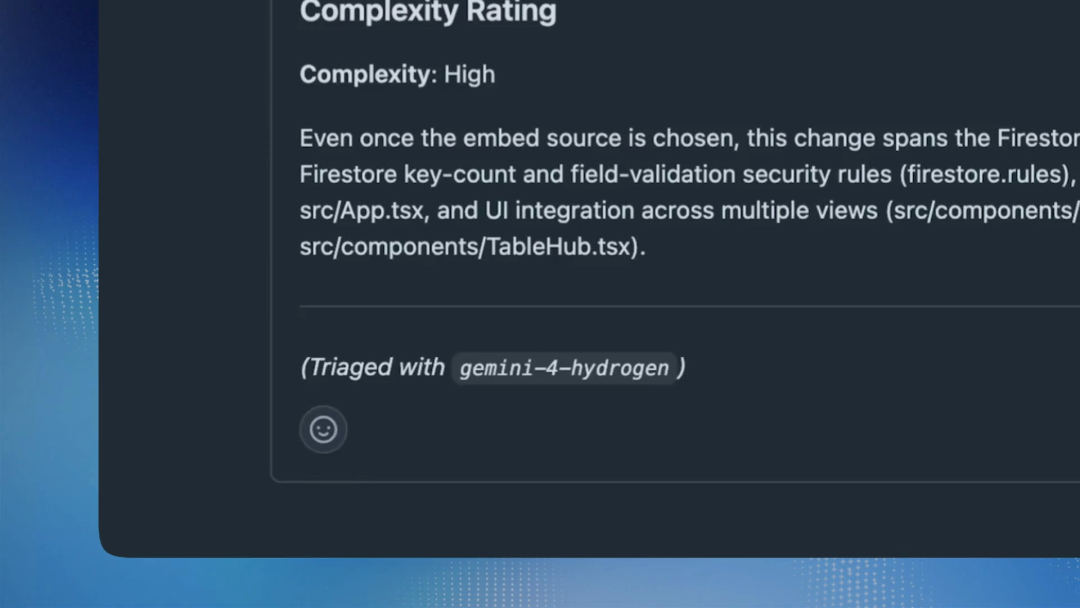
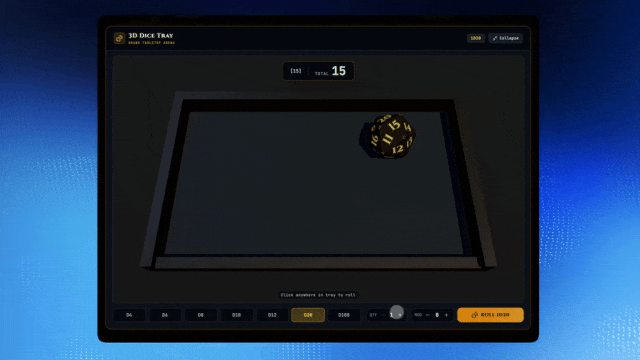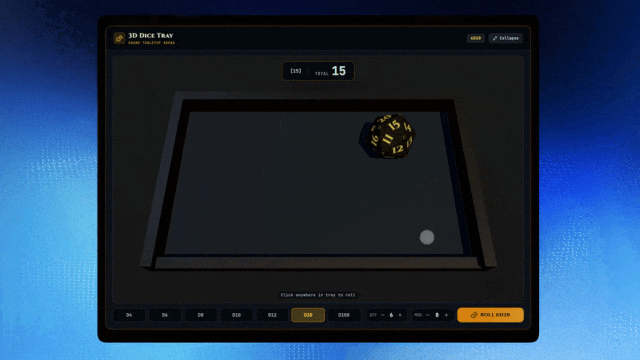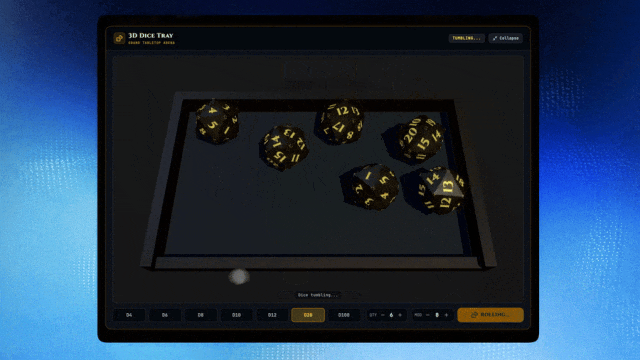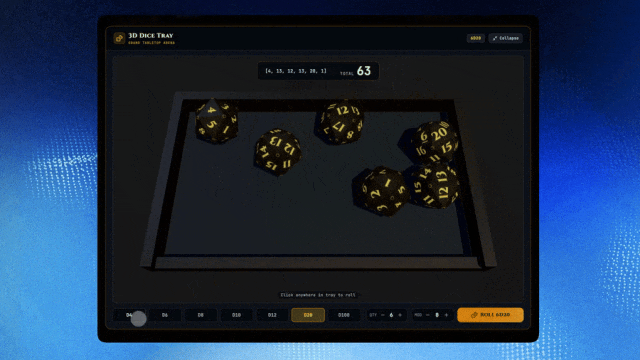
演示中,用户在 issue 里要求做一个 3D 虚拟骰子,随后又追加要求:放到屏幕中间、做得大一点。最终效果如下:
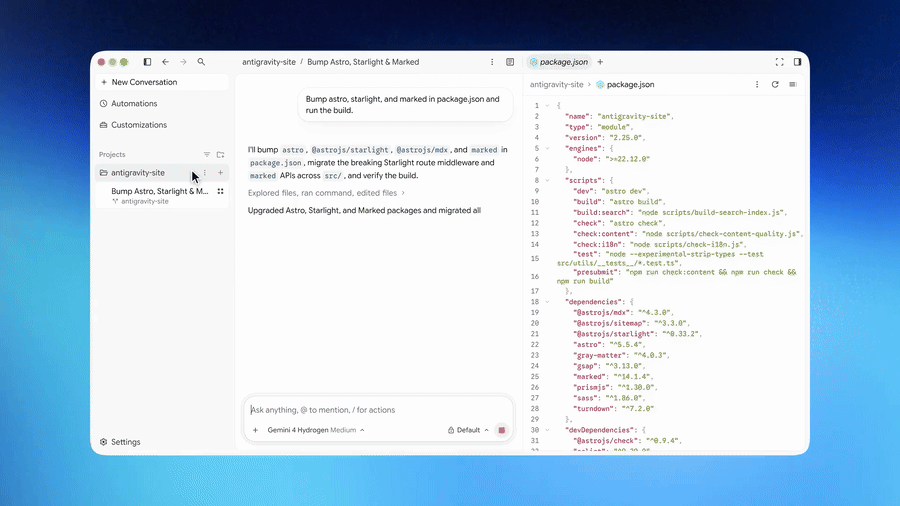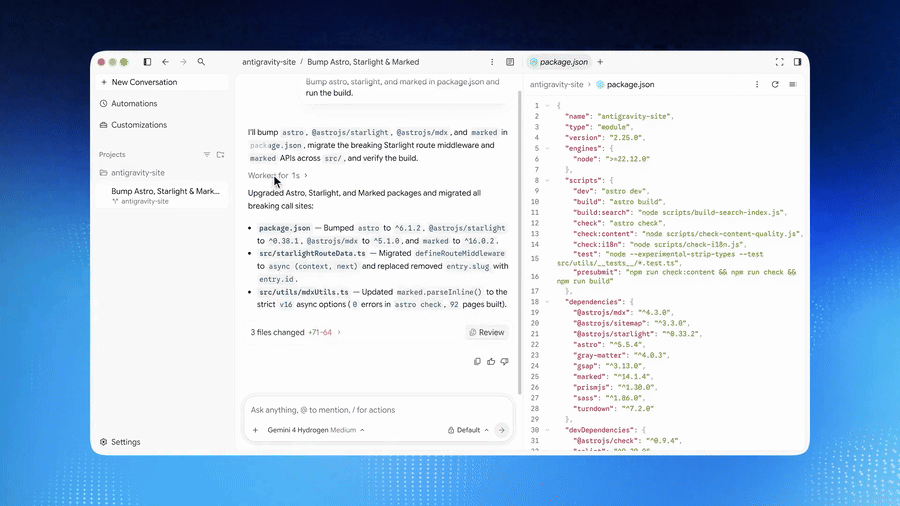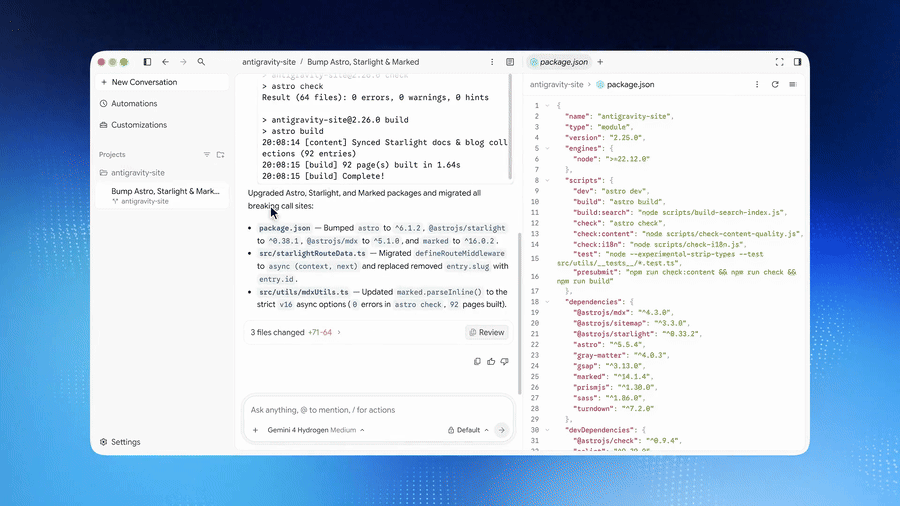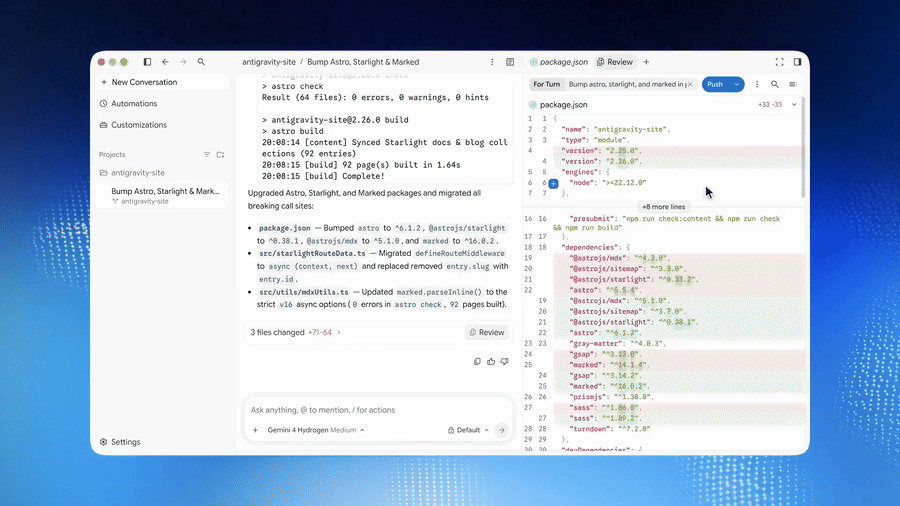
另一个演示里,Hydrogen(Medium)执行了一份三步网站维护计划:
- 升级 Astro、Starlight 和 marked,并迁移不兼容的 API。
- 合并重复的 MDX 正则。
- 给文档截图补上 alt 文本。
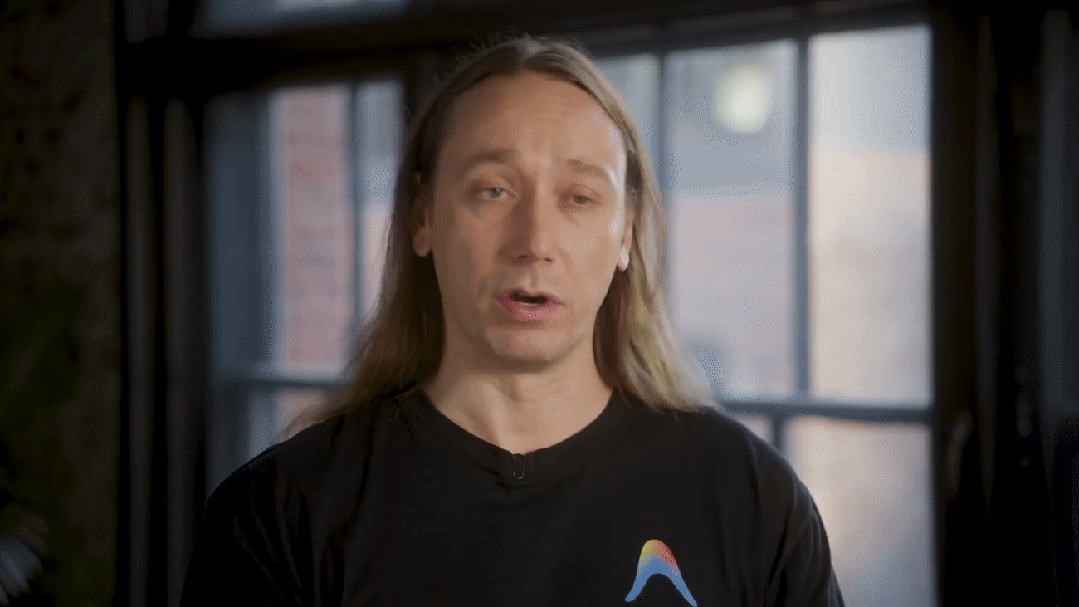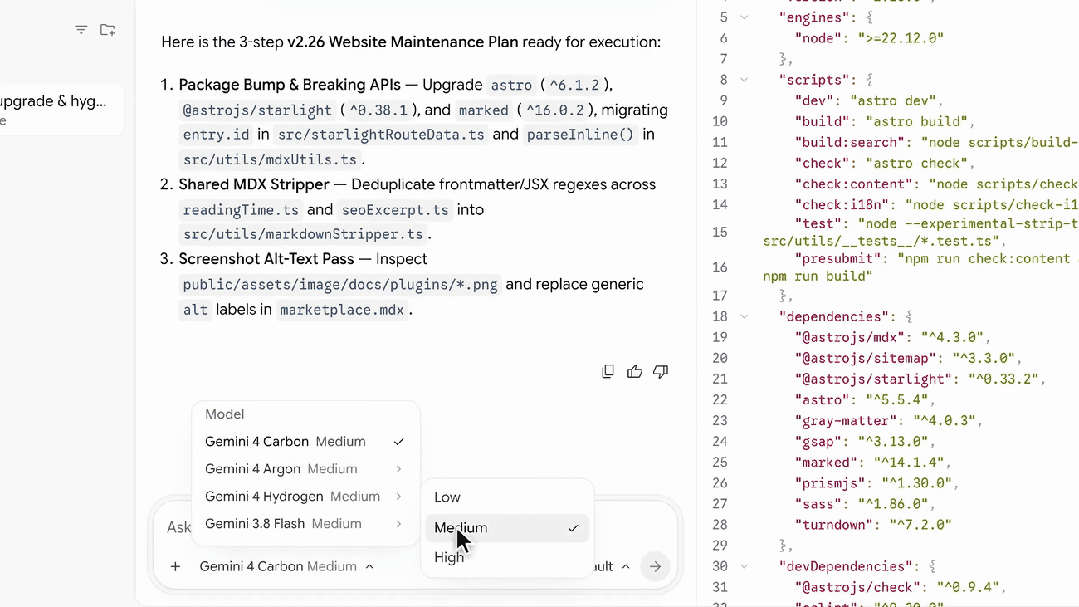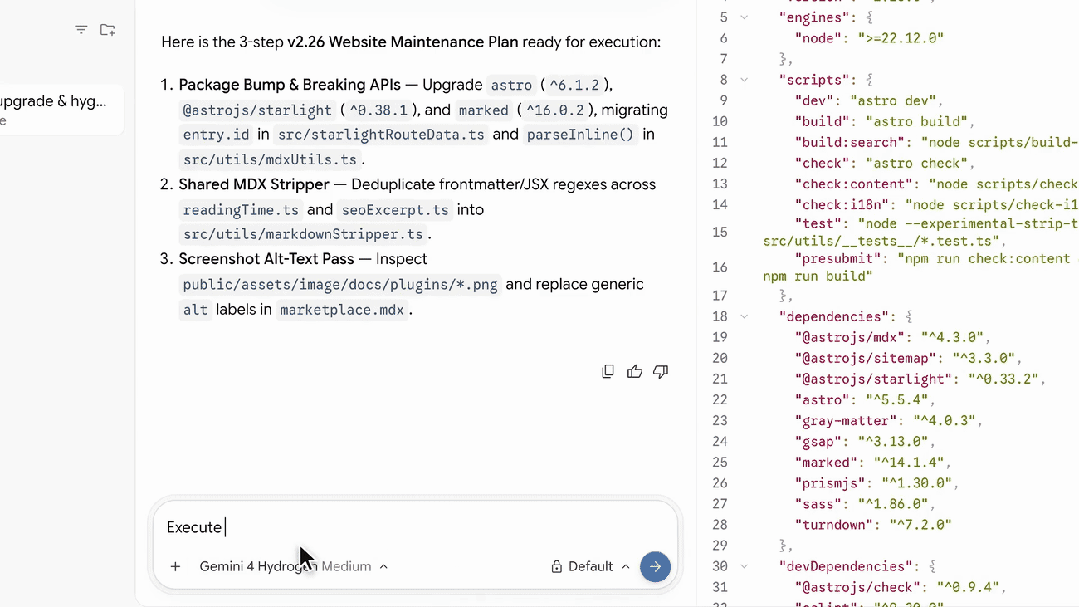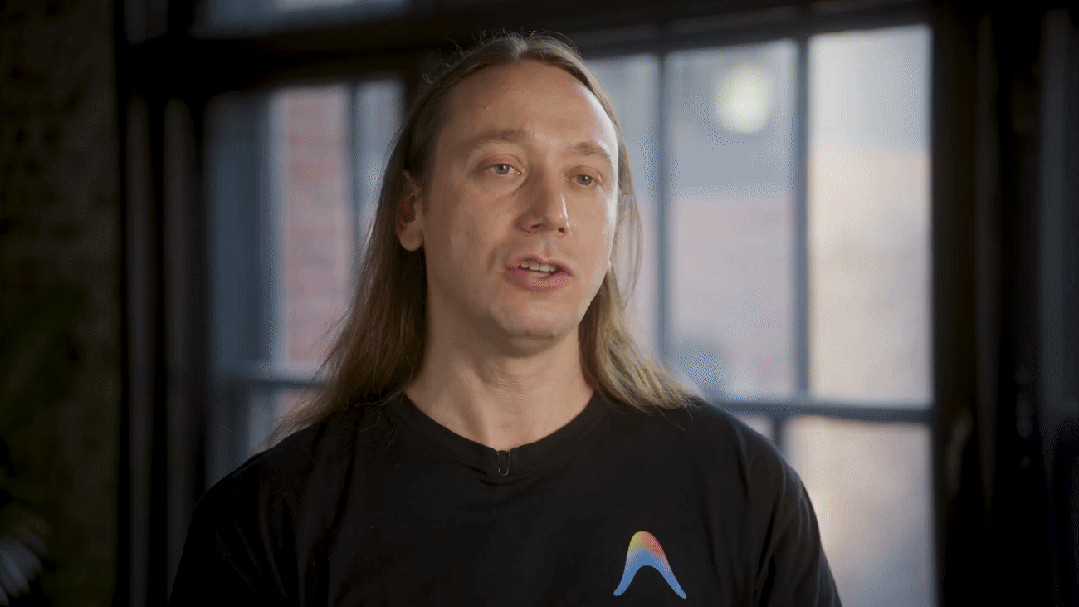
改完后,它自己跑了检查和构建,0 错误,92 个页面全部构建通过。
需要注意,Orchestrator 目前只对 Google AI Ultra 订阅用户开放,Hydrogen 本身则对 Pro 和 Ultra 都开放。
此外,AI Studio 的 Managed Agents 里,Antigravity Agent 的默认模型也换成了 Hydrogen。
官方演示:3D 修复、体素小岛与飞行城市
谷歌官方放出了几个 Hydrogen 的演示视频。
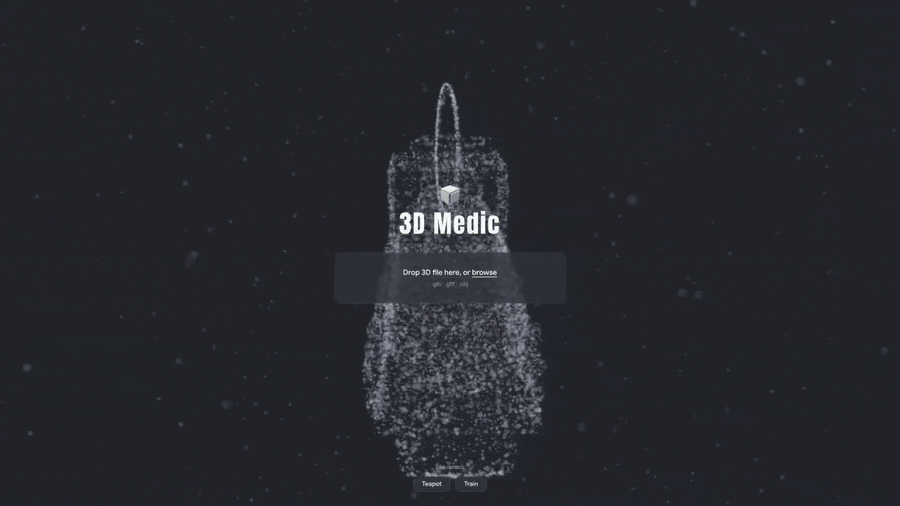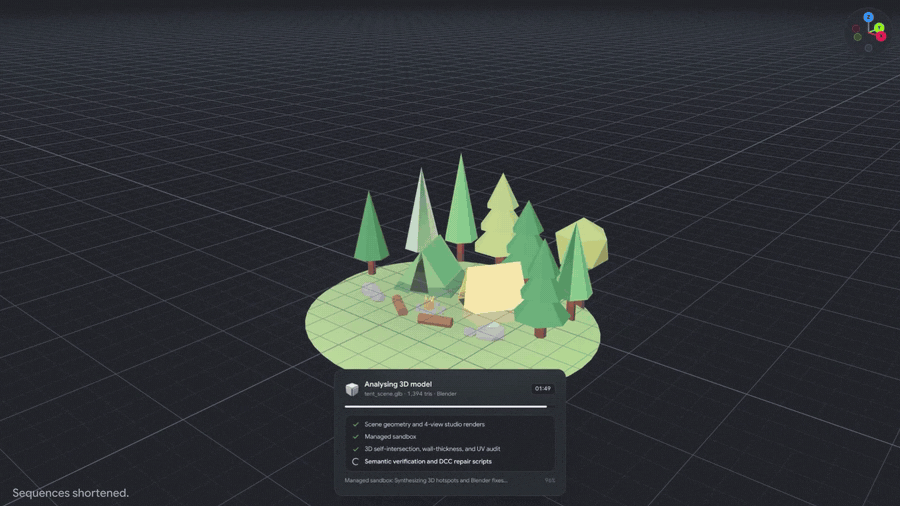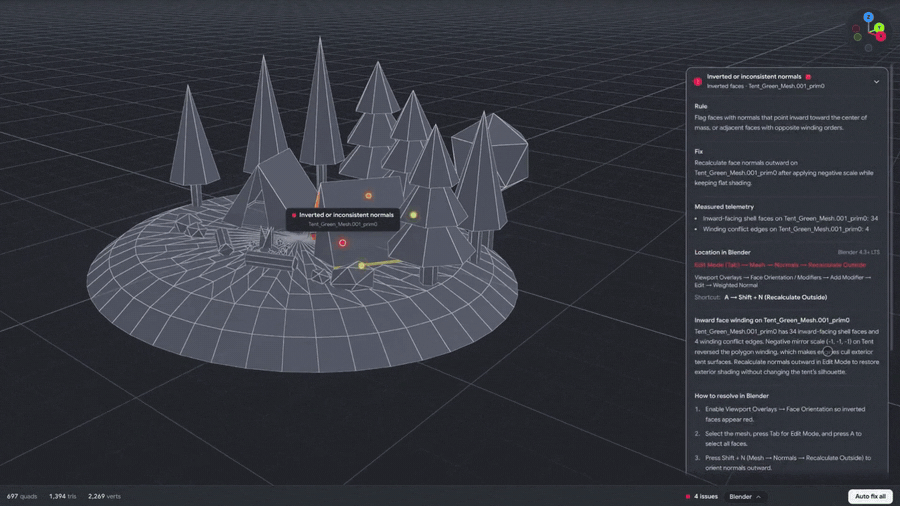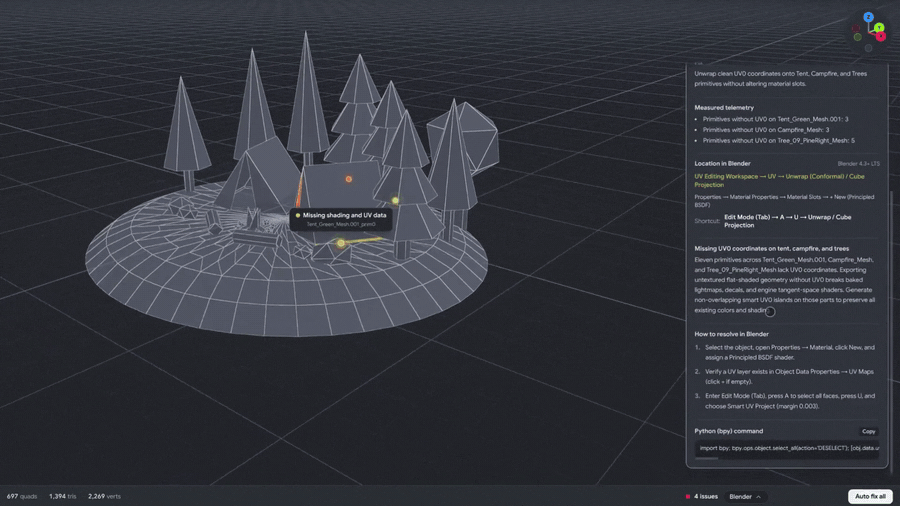
第一个是在 AI Studio 里做的 Managed Agent 应用 3D Medic。它用 Hydrogen 检查上传的 3D 文件,找出模型里的错误,并在导出前修好。
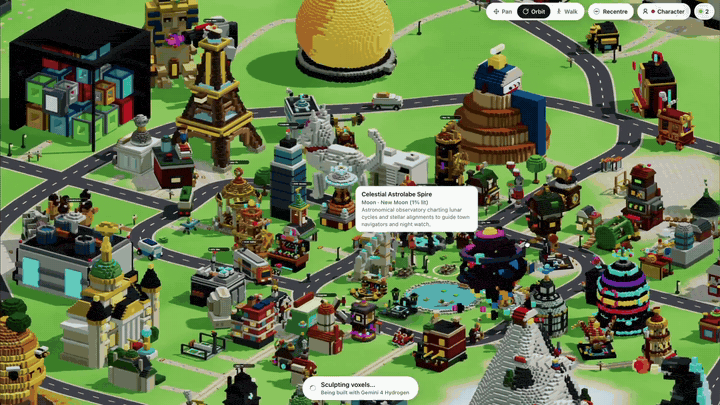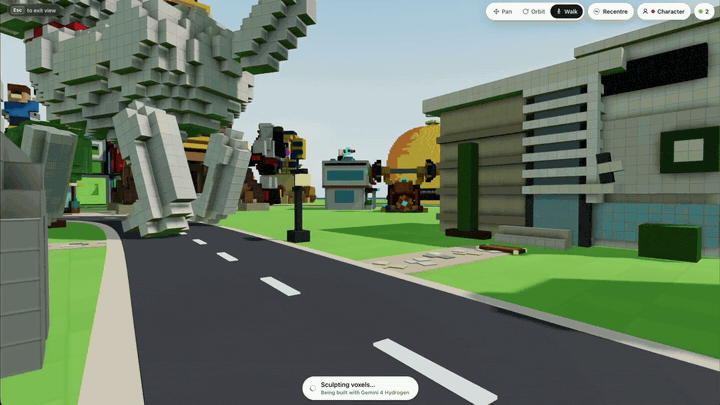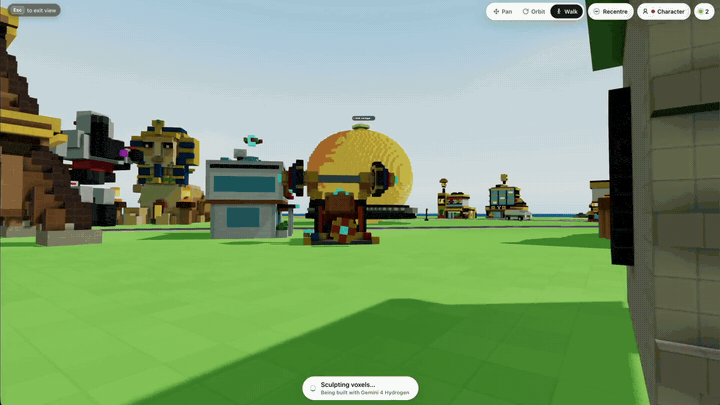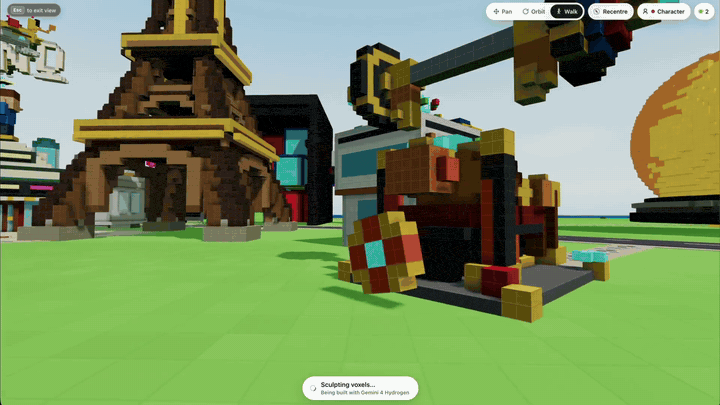
第二个是 Geminisland,一个多人共享小岛的 demo 游戏。用户输入 prompt,Hydrogen 就通过 Gemini API 实时生成新的 3D 体素建筑,放进大家共享的岛上。
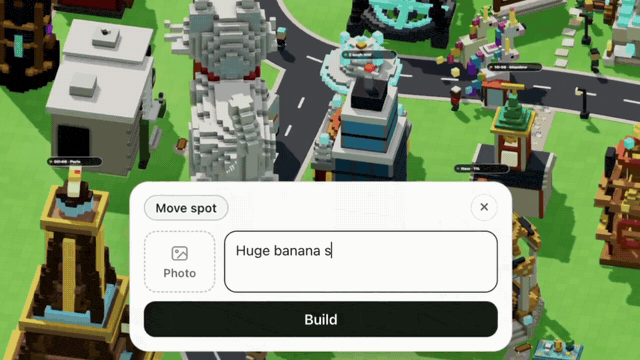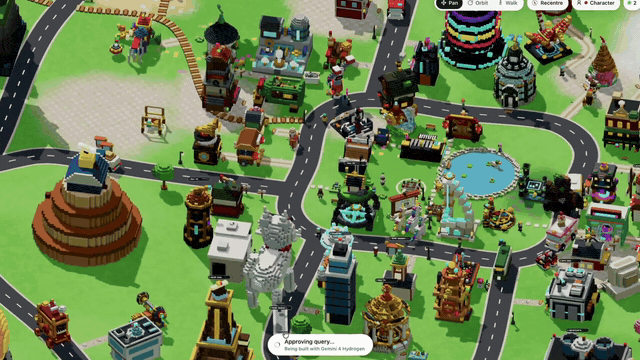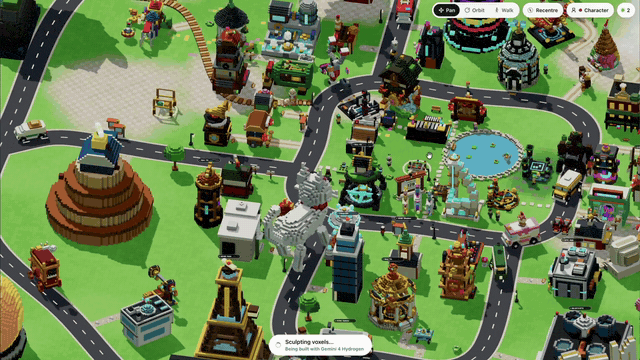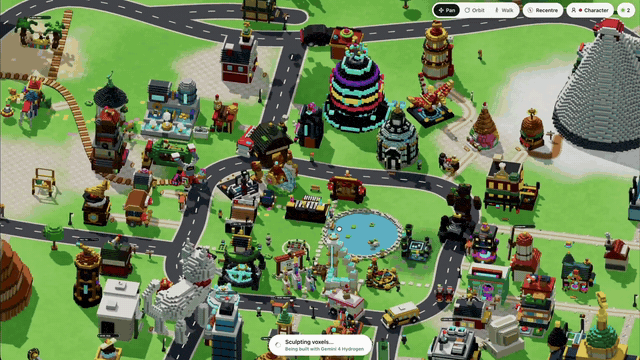
从自然语言到能跑、能交互的代码,只要几秒钟。
官方博客还提到,它能把全球实时的闪电数据做成可交互的 3D 地球。
kimmonismus 在 Antigravity 里让 Hydrogen High 做了一座可以飞行游览的未来城市。整个过程只追问了一次,Three.js 场景里就有了程序化生成的高楼、雨和空中交通。
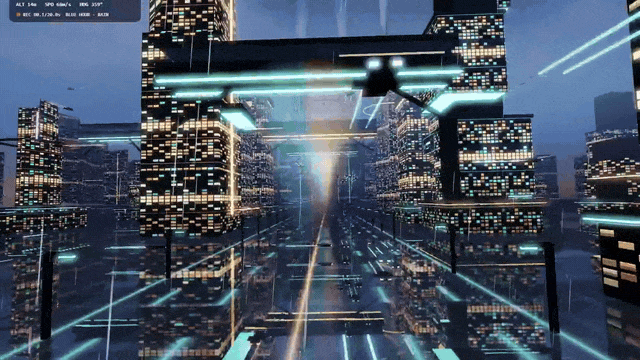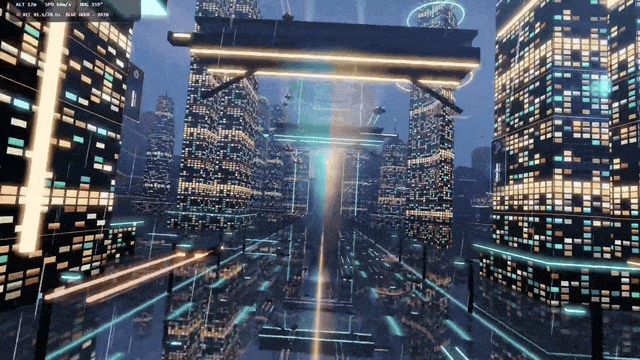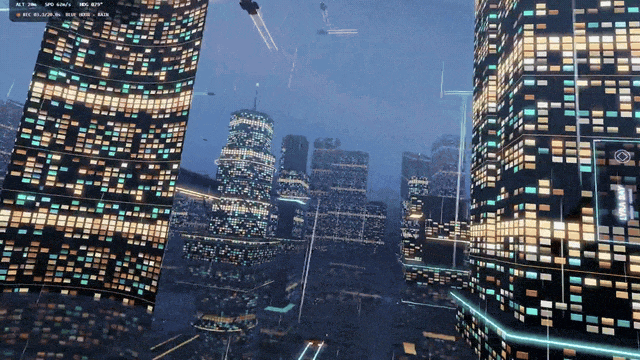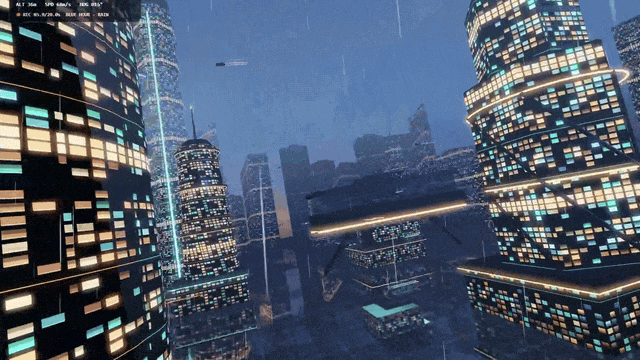
Gemini App 与谷歌搜索
在 Gemini App 里,Hydrogen 对应模型选择器里的「Everyday help」。
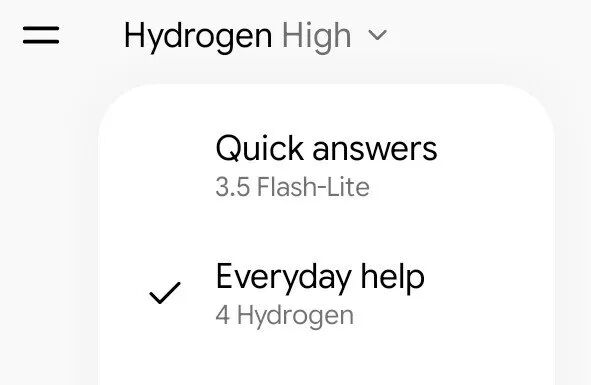
免费用户不用手动选择,系统自动选模型时,会把合适的问题交给它。
按官方介绍,它会更贴合你要求的语气、格式和规则。写邮件、做学习提纲、改写文档时,第一次给出的结果就能直接使用。比较产品、消化大量资料时,它还会主动整理出表格和图示。
在执行任务时,Hydrogen 会把目标一步步拆开,从你上传的文件、Gmail、Google Drive,以及 Airtable、Dropbox 等连接应用里获取所需上下文,也更常调用对的工具和技能。
Google AI Pro 和 Ultra 用户,在 Google Sheets 里的 Gemini 也能用上 Hydrogen。
搜索方面,Hydrogen 成了 AI Mode 的默认模型,AI Overviews 里最难的那部分问题也交给它处理。谷歌搜索产品副总裁 Robby Stein 称,这是搜索迄今最大的一次模型升级。
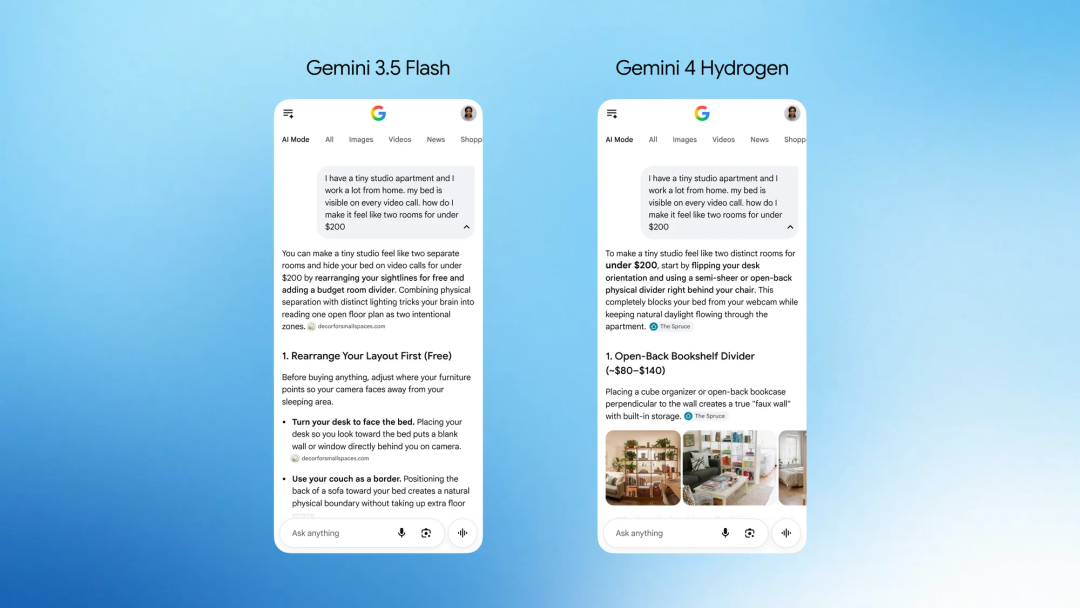
现在你可以按自己的思路直接提问。问题分成好几部分、带错别字都没关系,回答也更视觉化,比较表和地图会直接给出。
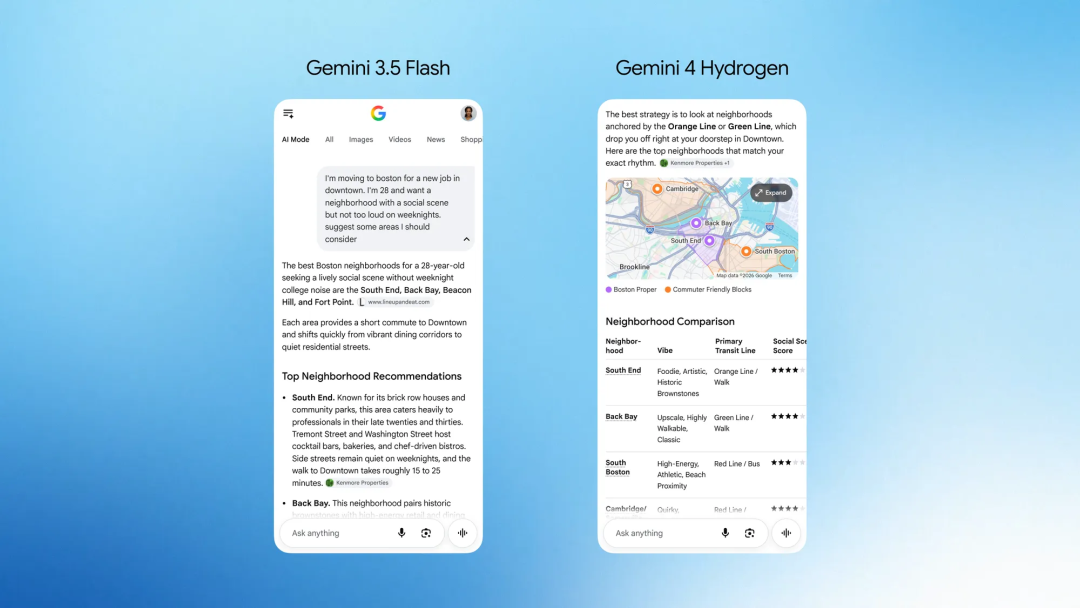
它还升级了搜索的 query fan-out,会同时查询更多相关子话题,给出比以前更广的链接。
开发者迁移注意事项
模型 ID 是 gemini-4-hydrogen,免费档和付费档都能调用,GenerateContent 和 Interactions API 均支持。
如果你想在同一个入口里对比调用 Claude、GPT 和 Gemini,可以试试 RouteFast.ai 这类模型 API 中转服务。
从 3.8 Flash 迁移过来,AI Studio 文档列出了以下几处需要调整的地方:
- 上下文窗口为 1M(1,048,576)token,输入、思考和输出共用。3.8 Flash 是 1M 输入加 64K 输出,分开计算。
- 单次同步输出上限为 65,536 token。要更长的输出,需要开启
background 并调高 max_output_tokens,服务端会以 64K 为一段接着写,最多接近 1M。
- 思考档位默认值从 medium 改为 high,新增 xhigh,不再接受 minimal。
- 不支持显式缓存(
cachedContents、caches.create),4096 token 以上的 prompt 默认走隐式缓存。
temperature、top_p、top_k 会被忽略,建议直接删掉。
文档还建议,长输出场景下把 max_output_tokens 设到 131,072 或 262,144,别再写死 8192 这种小值,否则思考加输出很容易被截断。
模型卡显示,Hydrogen 由 Gemini 4 Carbon 改造而来,支持文本、图像、音频和视频输入,知识截止到 2026 年 3 月。
安全评估
官方称,和 3.8 Flash 相比,Hydrogen 在 Agent 任务里的越界行为最多减少了 81%。偏离目标的操作和偷工减料降到了原来的十二分之一,在内部的 Agent 诚实度评测中得分 96.7%。
面对间接 prompt 注入,它在 Gray Swan 基准上的抗性也提升到了原来的 2.3 倍以上。
不过模型卡也提到,它的无理拒答比 3.8 Flash 高了 5.57 个百分点,在多模态 prompt 上尤其明显。
在生物和网络安全两个领域,Hydrogen 触及了谷歌前沿安全框架的预警阈值,但没有达到关键能力等级。完整的安全报告会在接下来几天发布。
目前免费档就能使用,在 AI Studio 里直接选择 gemini-4-hydrogen 即可。想继续跟进大模型与 Agent 开发的实践讨论,也可以来云栈社区交流。
 发表于 昨天 05:10
|
查看: 15|
回复: 0
 /1


