Coding Agent 的上下文越长,每一步调用的开销越高。能否在不影响任务完成的前提下,压缩这些上下文?
Coding Agent 解决软件问题时,需要反复查看代码、修改程序、运行测试。每一步返回的文件内容、搜索结果和日志,都会留在上下文里,下一轮调用时还要重新带上。任务越难,上下文越长,每一步要处理的 token 越多,费用也越高。统计显示,在 SWE-bench Verified 上,这些 observation(观测内容)占总 token 消耗的 45.7%;在 Terminal-Bench 上,最高达到 67.8%。
能否直接压缩这些 observation?难点在于,压缩时很难判断删去的内容后续是否还会用到。
来自清华大学人工智能学院的团队提出了 CoACT,一种面向 Coding Agent 的 observation 压缩方法。它不以压缩结果与原文的相似程度作为主要标准,而是考察压缩后 Agent 的下一步动作是否发生变化。在 SWE-bench Verified 的 200 个实例和三个 Agent 模型上,CoACT 平均减少了 33.0% 的总 token 消耗,平均 PASS@1 从 69.0% 变为 71.0%,任务表现与未压缩时相近。该工作已被 CCF A 类会议 ICSE 2027 直接接收(Top 5%)。
一、现有压缩方法的局限
已有方法大致分为两路。
一路是改写历史:滑动窗口丢掉较早的命令和输出,AgentDiet 则让模型定期回看历史,自行删除重复或用不上的内容。但历史一旦被改写,原有的 KV Cache 就无法完整复用,模型还得对改写后的内容重新执行预填充。即使 token 少了,开销也未必下降。
另一路是在新 observation 进入上下文之前先进行压缩。此前的历史保持不变,缓存可以照常复用。CoACT 选择的就是这条对 KV Cache 友好的路径。
压缩目标该如何确定?Agent 的目的是完成任务,因此压缩效果也应以任务完成情况衡量:在任务成功率 PASS@1 与未压缩 Agent 接近的前提下,尽可能减少总 token 消耗。
这里需要权衡两方面:删减过多,Agent 可能缺少必要信息,导致任务失败或重复读取;删减过少,则无法有效降低开销。
二、核心思路:下一步动作保持
验证压缩效果最直接的办法,是让 Agent 读完压缩结果并完成整个任务。但同一份 observation 可以有多种压缩结果,逐一跑完整个任务的成本很高;而且一次任务中会发生多次压缩,也很难判断最终结果由哪一次压缩造成。
研究团队将 Agent 的执行过程看作“读取输出、执行动作、获得新输出”的循环。假设初始环境相同,且环境对相同动作的响应也相同,那么只要每次压缩后 Agent 的下一步动作不变,环境收到的操作和返回的结果就一样。理论上,后续动作序列和最终结果也不会改变。
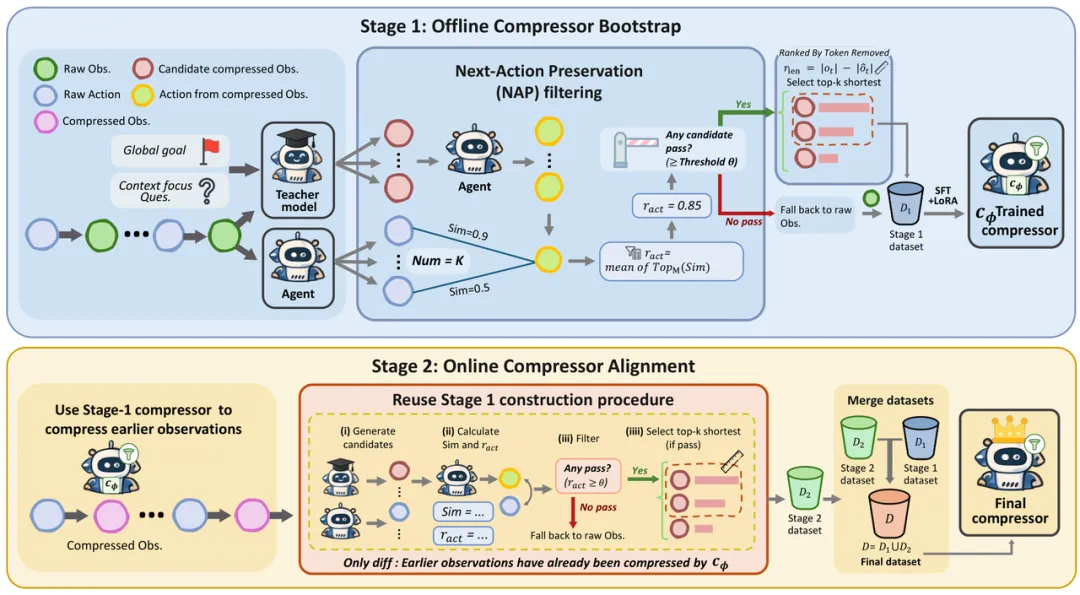
基于这一推导,研究团队提出下一步动作保持(Next-Action Preservation,NAP):保持任务目标和历史相同,分别让 Agent 读取压缩前后的 observation,再比较它接下来的动作。
例如,读完一段代码后,Agent 原本要查看其中调用的某个函数;换成压缩结果后,它仍然去查看这个函数,就认为此次压缩保持了下一步动作。这样,每次压缩都可以单独检验,无需等到任务结束。
三、基于 NAP 构造压缩训练数据
研究团队以 Qwen3.5-4B 为基座训练了一个轻量压缩器,数据构造过程分为几步:
- 让教师模型 Gemini3-Flash 为同一份 observation 生成 8 份压缩候选。
- 让 Agent 在原始 observation 下多次采样,得到 8 个参考动作。
- 将每份压缩结果引出的动作与参考动作逐个比较,取最相似的 3 个得分求平均;平均得分达到 0.6,才算通过。
- 从通过检查的候选中挑选更短的版本,作为训练示范。
动作比较并非简单地比较字符串,而是解析命令的操作类型、目标文件和读取范围。即使命令写法不同,只要读取的是同一段代码,就会被识别为相同操作。
如果 8 份候选都未通过检查,就使用原始 observation 作为目标,让模型学会在必要时保留原始内容。
四、两阶段训练:离线引导与在线对齐
只用未压缩 Agent 的轨迹构造数据,存在一个隐患:收集数据时,Agent 看到的历史都是完整的;实际部署后,前几步读到的内容也经过了压缩,历史上下文已经不同。
CoACT 分两个阶段解决这一问题:第一阶段用离线轨迹进行监督微调,得到初始压缩器;第二阶段让压缩器实际参与 Agent 运行,保留此前已经压缩的历史,重新进行动作比较和长度筛选,得到第二批数据;最后合并两个阶段的数据,训练最终压缩器。
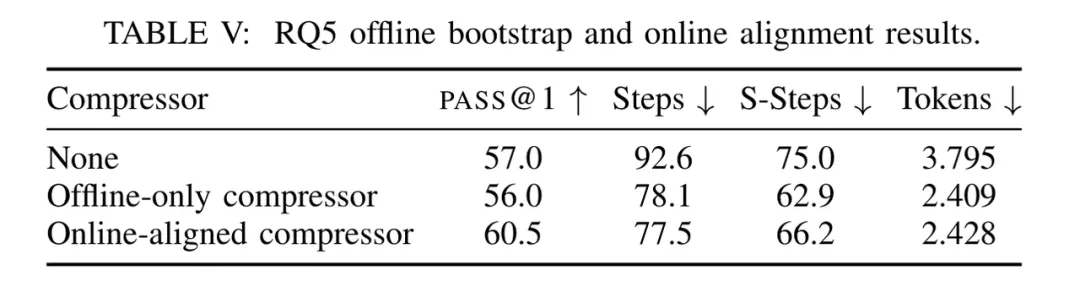
对照实验中,只用离线数据训练的压缩器,PASS@1 为 56.0%,略低于未压缩时的 57.0%;加入第二阶段的在线数据后,PASS@1 升至 60.5%,总 token 消耗与仅用离线数据时基本相当。
五、实验结果:平均减少三分之一 Token 消耗
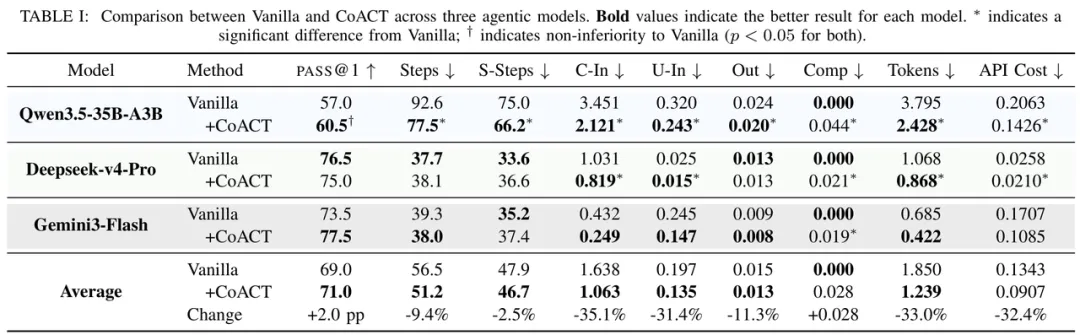
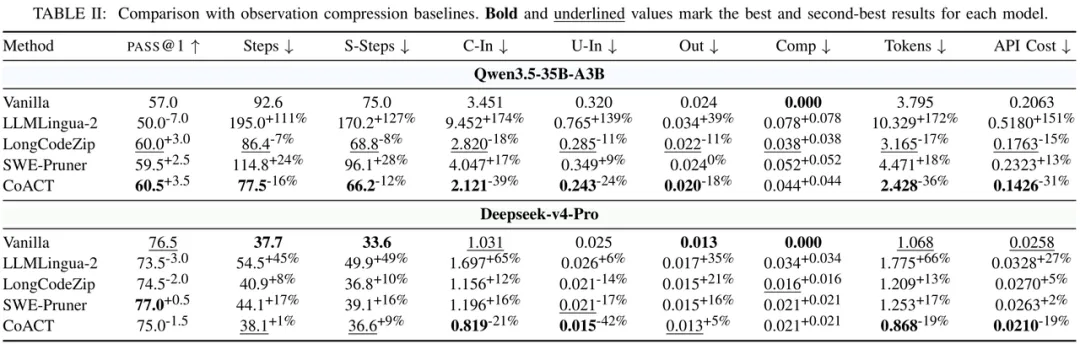
在从 SWE-bench Verified 随机抽取的 200 个实例上,CoACT 在 Qwen3.5-35B-A3B、Deepseek-v4-Pro 和 Gemini3-Flash 三个模型上均减少了 token 消耗:
- Qwen:从 3.795M 降至 2.428M。
- Deepseek:从 1.068M 降至 0.868M。
- Gemini:从 0.685M 降至 0.422M。
三个模型的总 token 消耗平均降幅为 33.0%,平均 PASS@1 从 69.0% 变为 71.0%。其中,Qwen 和 Gemini 分别提高 3.5 和 4.0 个百分点,Deepseek 下降 1.5 个百分点。平均交互步数也从 56.5 步降至 51.2 步。
压缩后,较长的 observation 明显减少:在 Qwen3.5-35B-A3B 上,超过 1K token 的 observation 占比从 32.3% 降至 9.4%。
与已有 observation 压缩方法相比,结果也显示出差异。以 Qwen 为例,LLMLingua-2 压缩后,PASS@1 从 57.0% 降至 50.0%,总 token 反而从 3.795M 增至 10.329M;SWE-Pruner 增至 4.471M;LongCodeZip 降至 3.165M;CoACT 则为 2.428M,PASS@1 为 60.5%。
在 Deepseek 上,三种基线方法的总 token 消耗都高于未压缩时的 1.068M,CoACT 则降至 0.868M。在这两个评测模型上,CoACT 都是总 token 消耗最低的方法。这说明,仅以缩短 observation 长度为目标,并不能保证整个任务的总开销下降。
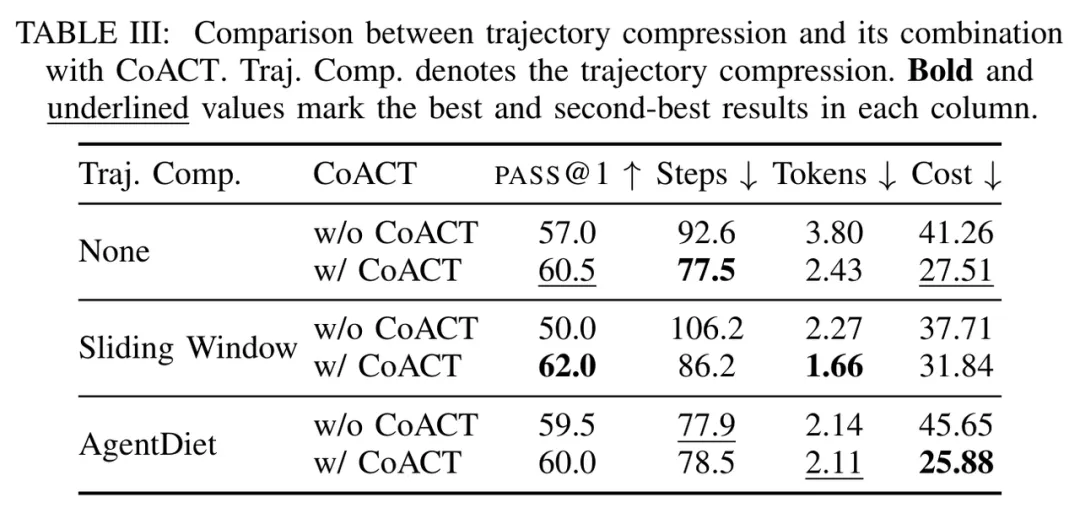
CoACT 作为单步压缩方法,还能与历史压缩方法配合。单独使用 AgentDiet 时,总 token 虽然减少,估算总费用却从未压缩时的 41.26 美元升至 45.65 美元,原因是改写历史影响了 KV Cache 复用。在 AgentDiet 流程中先加入 CoACT,估算总费用降至 25.88 美元,任务成功率保持相近,费用比单独使用 AgentDiet 减少约 43.3%。
来源
来源:机器之心
编辑:文婧
研究团队:清华大学人工智能学院 AI Agent 课题组
通讯作者:李佳
第一作者:陈浩瑞
 发表于 昨天 22:48
|
查看: 7|
回复: 0
 /1


