Prompt 越写越长、Skills 越堆越多,模型就一定越好用吗?
我的体会是:模型能力越强,人为添加的约束有时反而可以越少。过度复杂的规则和 prompt 可能干扰 SOTA 级别的 LLM。把要做什么、花多少 effort、怎么验证说清楚,往往比堆砌规则更重要;人则需要在关键处给出引导。
本文整理了我在项目文档管理、effort 选择、测试与 code review、prompt 与 skills、调研与寻找 idea 方面的经验。这些方法主要来自个人项目,适用性需要结合具体任务判断。
文中提到的模型包括 GPT-6 Astra、GPT-6 Astra Pro、GPT-6 Luna、GPT-5.6 Sol、Fable 5.1、Opus 5.5 和 Gemini 4 Argon。模型迭代很快,相关体验和结论都有时效性。
核心观点:Harness 做减法,Human 把握关键
Claude Code 负责人 Boris Cherny 曾分享过一个 demo:让 Opus 5.5 为 Acquired 播客的 Home Depot 那一期制作互动网站。
出乎他意料的是,相比生成内容,人们更关注他分享的 prompt:它居然如此简单。
Boris 的原始 prompt(翻译)
最新一期 Acquired 播客关于 Home Depot 的内容非常精彩。
我想让你制作一个能够叙述整集内容的 Artifact。把它做成精美且互动的形式,重点传达贯穿整集的商业智慧精华。一定要做得非常出色,使用大量的 token 并不断迭代,直到你对其感到自豪为止。
也许可以在整个作品中加入水彩插图和历史照片,目标是营造出《纽约客》或《纽约时报》数据可视化的风格,甚至要更好。我认为你可以使用 OpenCV 来处理水彩图片。
2023 年和 2024 年,prompt engineering 曾经十分热门,相关课程、书籍和教程数不胜数。现在看到顶尖 AI 研究人员使用如此朴素的 prompt,难免让人好奇。
Boris 的回应
我很惊讶,大家会对我这样给 Claude 写 prompt 感到惊讶。
像对待同事一样和 Claude 说话。prompt 没有什么秘诀,大多数任务不需要过度的约束和规定,给 Claude 一个目标,它自己会想办法。
在 Sonnet 3.5 那时候,prompt 很重要。而现在,更重要的是向模型讲清楚:
- 你想让它做什么。
- 你希望它花多少 effort。
- 它应该怎么验证自己做对了。
我认同这个方向:Harness 需要做减法。模型能力越强,越不必事无巨细地替它规划每一步。
例如,不必因为某些 skills 很热门就盲目使用。在我的体验里,不少工具的噱头大于实用性;过度复杂的规则和 prompt,有时会干扰 SOTA 级别的 LLM。
那为什么同一个模型在不同人手里,发挥出的作用仍然不同?
模型会犯错,也可能短视、片面。人在关键部分提供正确引导,正是 human-in-the-loop 的核心价值。
再看 Boris 的 prompt,虽然简单,但任务、投入和目标都有所交代:
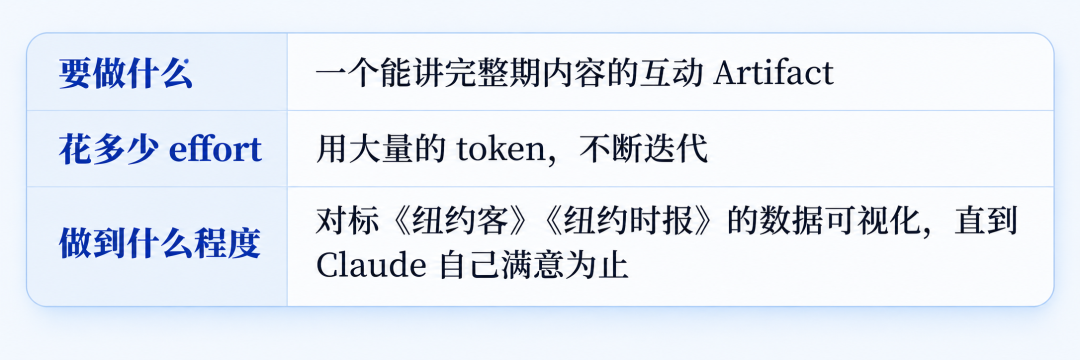
一些评论认为,最重要的是第一点和第三点:讲清楚要做什么、怎样算做好,agent 就有机会自行验证和迭代。
还有一种说法很直接:“你想要什么,解释得多烂都没关系,只要你把它解释出来。”
后文也基本围绕这三件事展开:通过项目文档说清楚要做什么,通过 effort 选择决定投入多少力气,再通过测试和 code review 验证结果。
Vibe Coding:项目管理浅见
跨会话协作的关键在于文档
LLM 的 context window 是有限的。按我的使用体验,Codex 默认支持 258k,可以调到 1M,但官方没有将 1M 设为默认,因此我不认为手动设到 1M 一定是好选择;Claude Code 默认为 1M;Gemini 4 Argon 支持 2M。后者我还没有体验过,对其 coding 能力暂时持保留态度。
这些数值取决于具体模型和工具配置。即使是 1M,对大项目来说也可能不够;在我的使用中,context 用到 50% 以上,尤其是达到 70%—80% 时,更容易出现遗漏和错误。因此,让 agent 在多个会话之间协作很重要。
跨会话协作的关键,是维护好项目文档。
我的习惯是在工作目录下开启与 agent 的对话,正式开始前先初始化 AGENTS.md,以及下面的目录。按我的使用体验,Claude 现在也支持 AGENTS.md:
my-project/
├─ AGENTS.md          # 最核心的项目指引
├─ docs/              # 存放长期维护的文档
│  ├─ README.md       # docs/ 的索引与简单说明
│  ├─ HANDOFF.md      # 跨对话长期项目的交接文档
│  ├─ DATASET.md      # 数据集说明
│  └─ ENV.md          # 环境说明
├─ data/              # 数据集放数据盘,这里建软链接
├─ experiments/       # 实验结果,占空间时也建软链接
├─ notes/             # 草稿、待定决策、头脑风暴、调研
├─ ref-papers/        # 参考文献的 LaTeX source
├─ ref-repos/         # 代码实现的参考
└─ workspace/         # 真正的开发目录
ref-papers/ 中的论文最好从 arXiv 获取 LaTeX 源码,供 AI 阅读时保真度较高。最主要的是 docs/,其中存放需要长期维护的文档。
其他文件可以按项目需要增减,但我认为 AGENTS.md 不可或缺。
我强烈建议以 human-in-the-loop 的方式创建和维护这些文档:当 Agent 连续犯同一个错误时,可以把相关说明加入 AGENTS.md。
我的 AGENTS.md 节选
将方括号中的内容替换成自己的项目内容即可。下面的测试策略针对我的研究项目,仅供参考;不同项目应根据风险和验证需求调整。
# Agents Guidelines

本目录用于 [研究方向] 研究(项目名 [xxx]):[一句话说明目标]。接手先读 docs/HANDOFF.md;当前主线草案见 notes/cur_mainline.md。

## 目录与归属

- ref-papers/:参考论文,只读。论文事实以本地原文为准,不凭记忆转述。
- workspace/:代码与实验。上游仓库克隆只用于跑基线,改动保持最小;自己的新代码放独立目录;临时文件放 workspace/tmp/<任务名>/。
- notes/:调研、讨论、未定稿草案。当前有效草案用 cur_ 前缀,过期后移入 notes/archive/。
- docs/:正式文档。HANDOFF.md 为接手入口,ENV.md 为环境,spec/ 为正式方案。
- experiments/<name>/:results.md 首屏维护 Current Summary,运行记录写 runs.md。

## 环境与执行

- 安装、启动、评测、环境排障先查 docs/ENV.md。
- 不要停止非本任务启动的进程。
- 长时程任务确认正常运行后,报告任务标识和日志路径,然后停止轮询。
- 数据传输持续低速或失败时,停止并报告;不反复重试,不自行更换下载源。

## 测试

- 默认不写测试:不补单元测试,跑通一次、看一眼输出即可。
- 复现已发表工作时,以对上论文报告的指标为准。
- 只有改动自己方法的核心代码(训练流程、数据处理、评分)时才专门验证:先列出可能出错的方式,再用缩小版验证,产出 loss 曲线、指标 JSON 等可核查的结果。

## 文档

- 写入前按上面的归属选位置,不新建平行文档。
- HANDOFF 只记当前状态、关键决策、已验证结果、接手须知、明确待办;40–70 行量级;修订而非追加。
- 原则:删掉某句话不影响接手,就删掉。
如何选择 Thinking Effort
Codex:谨慎使用 Ultra / Max 直接写代码
我的建议是,使用 Codex 时,不要一开始就用 Ultra / Max 直接 coding,尤其要谨慎使用 Ultra。
在我的体验中,Ultra 可能生成大量 subagent 互相讨论,针对许多意义不大的边界情况反复测试、打补丁,导致项目臃肿,消耗 token 和 context。
我认为这与 GPT 的过度防御性有关:它有时过于谨慎。
主代理启用 subagents,本意是减轻自身负担、隔离上下文、协作完成任务;但我经常看到 GPT 的主代理不够信任子代理。即使子代理报告任务完成,主代理仍会再次检查,增加 token 和上下文消耗。相比之下,我更喜欢 Claude Code 的 Ultracode 体验。
Max 也有类似问题。我的建议是将规划与执行解耦:规划阶段使用较高 effort,执行阶段使用相对较低的 effort。
这里的解耦指通过多个会话并行处理任务,而不是在同一个对话中不断切换模型或思考预算。在某些实现中,切换可能影响 KV cache,也就是 prompt cache 的复用,增加计算和对话成本。
我把 thinking effort 理解为类似 system prompt 的一部分:切换后,先前缓存可能需要重新计算;切换模型也可能有类似影响。具体缓存行为仍取决于工具和模型的实现。
据我的使用体验,Claude 的 Fable 5.1 和 Opus 5.5 可以在 Claude Code 中调整 effort 而不破坏提示缓存,对话中途也能用 /effort 切换;我使用时的 Codex 尚未提供相同体验。
Anthropic 研究员的 370 次实验
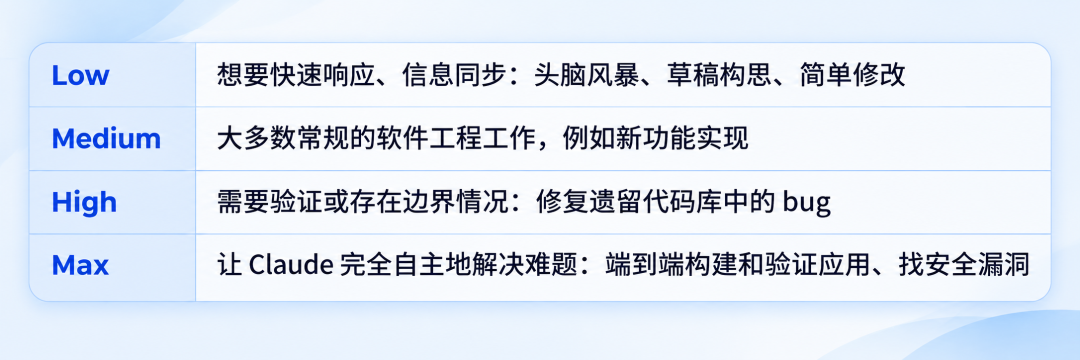
Thinking effort 越高,模型就一定越聪明吗?Low 一定比 High 差很多吗?情况并不完全如此。
Anthropic 研究员 Thariq 使用 Fable 5.1,在 Terminal-Bench 3.0 上从 Low 到 Max 跑了 370 次实验:
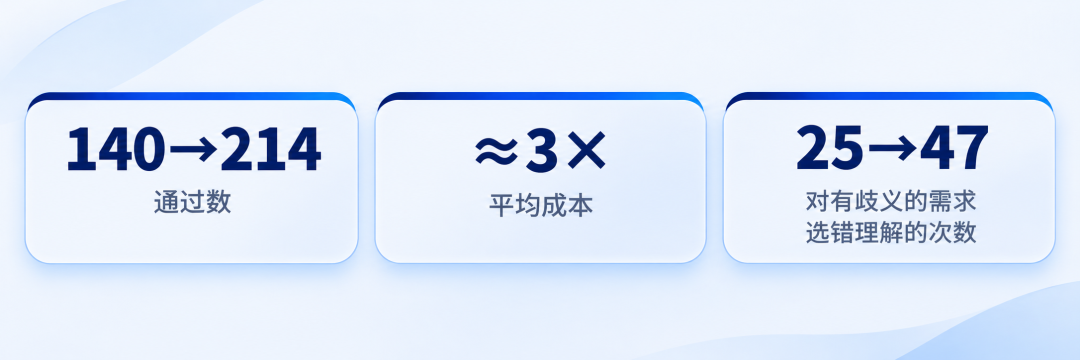
从宏观上看,effort 让模型大致了解你希望它为任务投入多少计算资源,也与对任务难度的判断有关。
我的理解是,effort 不会从根本上提高模型的智力水平,而是让模型花更多功夫思考和验证。
对于边界情况较多的任务,比如修复老代码中的 bug、安全分析和性能优化,这种投入可能很有价值;但简单问题过度思考,也可能导致过度解读。因此,effort 应该与任务难度,以及你希望参与的程度相匹配。
Thariq 的经验法则
他实现新功能时,会额外安排一步高 effort 验证:
- 先给 Claude 一份 spec,让它反过来提问,弄清缺失的细节。
- 使用 Low 实现。
- 自己检查方向是否正确;不对就继续用 Low 修改。
- 最后切换到 High,进行验证和测试。
单元测试与停不下来的 Code Review
控制测试范围
在我的体验中,一些 SOTA 级别的 LLM 很喜欢增加测试:它们可能写出大量代码,测试一些意义不大的情况,导致项目臃肿并消耗大量 token。
OpenAI 的官方文档也解释过一部分原因:以前的模型可能需要督促才会运行测试,而 GPT-6 Astra 会主动做这些事。如果 AGENTS.md 或 prompt 里仍保留“记得跑测试”之类的旧指令,可能进一步增加不必要的测试。
因此,可以检查 AGENTS.md 中是否还留有这类指令。不过在我的使用中,即使不写,模型有时也会写大量测试。
一位开发者将下面三条放在 AGENTS.md 顶部:
- 永远不要在写完代码之后再补单元测试。
- 强烈倾向于将端到端(E2E)测试作为唯一测试手段;E2E 测试结束时,产出一个可验证、可复现的 artifact。
- 如果确实需要单独测试某个模块,先写下所有可能出错的方式,再写代码。
我的理解是,LLM 常常倾向于写局部单元测试,写一部分就测一部分,而不是验证整个系统。对于我的 research 场景,端到端测试有时更合适。具体测试策略仍应由项目风险、改动范围和可靠性要求决定。
我自己的写法见前面 AGENTS.md 的“测试”一节。
什么时候停止 Code Review?
让 LLM 做 code review,最大的问题未必是发现不了问题,而是它总能列出一堆问题,其中不少并不是真正的问题。它可能不知道什么时候该停,只是在持续回应你的提问。
尤其当你对代码本身了解不多时,更容易陷入这种循环。我自己也会遇到这种情况,所以会尽量强迫自己看一眼代码。
也许有帮助的做法是:提供干净的 context、简洁而约束完整的 prompt,事先写清完成标准,并尽可能理解系统的顶层架构。
不只是 code review,论文审稿也有类似情况:即便是一篇 best paper,也可能被批评得一文不值。
Prompt 与 Skills
我建议不要太依赖 GPT 写 prompt。每个模型都可能写出烦琐的提示词,在我的体验中 GPT 尤其明显:约束多、可读性差,还可能让模型陷入局部最优。
可以在让模型写 prompt 时,加上一条要求:
我认为这种 harness 应该做减法,也就是不给太多复杂的约束,因为模型能力够强,约束过多只会对模型造成干扰。
总之,要有自己的判断。Vibe 工作流的每个阶段、每个步骤,都应该保留 human-in-the-loop。
也可以把 OpenAI 文档《Rethinking skills and prompts for GPT-6 Astra》交给模型参考。我认为值得记住的几点是:
- Skill 描述要短,写清什么时候使用。 描述太长可能被 Codex 截断,让模型更难选对。
- 渐进式披露。 根文档指向子文档和脚本,需要时再读取。
- 不要写成过细的流程清单。 过于具体的指导可能拖后腿。
- 定期检查
AGENTS.md 中每一条规则。 例如,把“每次编辑前先读 xxx.md”改成“修改 schema 时看 database.md”。
- 事先写清完成标准。 以前的强约束可能被过度当真,使模型在你希望它继续的地方停下来。
Skills 分享
我用过 GitHub 上 Master-cai 的 Research-Paper-Writing-Skills,感觉比较简洁。好的 skills 不一定复杂,有些看起来像随手写的 prompt,效果却不错。
此前很火的 grill-me 对我来说效果一般:有时它问得太细,反而容易钻牛角尖;而当我自己对项目架构没有清晰规划时,它问我,我也不知道怎么回答。
我也试过不少拥有几十 K stars 的全自动科研 skills。在我的体验中,它们往往过于冗余,产生的 idea 和写作质量也比较一般。
Research:调研与寻找 Idea
不要太依赖 LLM 直接输出的 idea。在我的体验中,模型缺乏 research 所需的判断力,因此需要较强的 human-in-the-loop。
用 Pro 做调研
Web 端的 Pro 模型适合做调研,尤其是 GPT-6 Astra Pro;但我不会过于指望它直接写代码。
我的体验是,Web 端缺少相应的 harness,因此即便 Codex 搭配相对较弱的模型,代码质量也可能优于 Web 端搭配 Pro 模型。
Pro 做调研时也可能钻牛角尖,需要多调整 prompt,并自己用关键词检索。我发现它有时会反复搜到同几篇 paper,遗漏其他相关研究。
我的找 Idea 流程
- 用 Pro 独立调研几轮,两三轮通常就够了。简单整理输出内容,放进 Project source。
- 精读一些 paper,最后选择两三篇你认为最值得做、能够结合的论文。这一步需要自己的判断和直觉,是最关键的环节。
- 把选中的论文和之前的调研一起放进 Project source,进行最终一轮问答。不满意就继续迭代,同时讲清楚自己对这些论文的理解,以及哪些地方吸引了你。
别轻信 GPT 对 Novelty 的判断
让 GPT 判断一个 idea 是否有 novelty 时,它经常会搜索一堆 paper,只读摘要,不看具体方法和贡献,就得出类似结论:“paper A 已经这样做了,paper B 已经那样做了,因此只是这样并不足够……”
最后,你可能得到一个价值不大的结论,还因此陷入自我怀疑。
但自己读完论文后,又可能发现这些工作与 GPT 所说的并不是一回事。因此,对新颖性的判断仍需要 human-in-the-loop。
Research:Benchmark 工作
我认为一个好的 benchmark 需要回答两个层面的问题。也可以用这些问题询问 GPT:当前构思的方案是否回答得足够好?
层面一:三个顶层追问
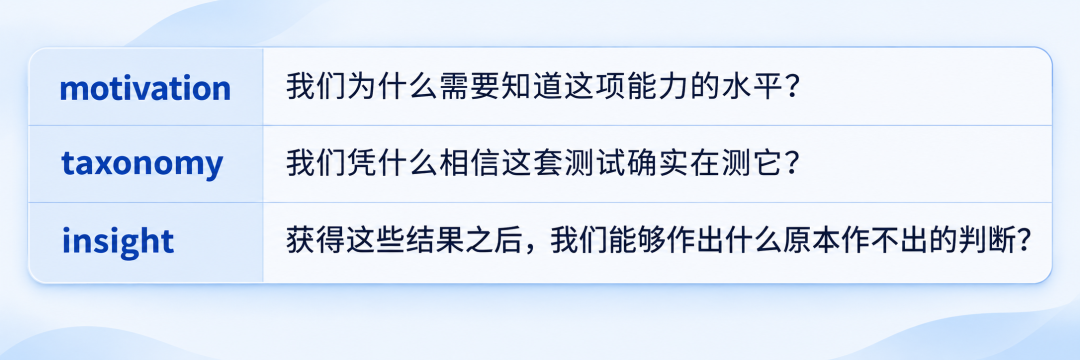
层面二:研究组织的六个问题
- 主线与边界: 整项工作围绕哪个核心问题展开?各个任务为什么属于同一项研究?哪些问题明确不在范围内?
- Taxonomy: 问题空间按什么依据拆分?这些分类是否区分了有意义的能力或困难,并真正指导数据覆盖与结果分析?
- 任务与设计: 抽象能力如何落实为明确的输入、输出、成功条件和数据约束?每个关键设计为什么必要?
- 验证与诊断: 实验是否不仅比较模型,还检验 benchmark 本身,并帮助区分能力不足与数据、接口或评分造成的问题?
- Insight 与贡献: 结果揭示了哪些有证据支持的能力边界或失败规律,而不只是模型排名和“当前模型还不够好”?
- 复用与延续: 别人能否独立运行、核查并持续使用这套评价,让后续研究在共同标准下积累进展?
读 Paper 的技巧与杂谈
我现在喜欢把 paper 翻译成中文阅读。过去我也觉得这样不够专业,加上想锻炼英语,所以一直坚持读英文。
后来发现,快速阅读大量 paper 时,这样做比较耗时,也容易读了后面忘前面。于是我决定把读 paper 和学英语解耦。
我的做法是让 Codex 拉取 arXiv 的 LaTeX 源码,逐句意译后重新编译成中文版 PDF;翻译工作可以交给多个子代理并行处理。按我的体验,GPT-6 Luna Medium 足以完成这项任务。
我觉得翻译质量和排版都不错。如果不想让 “token” 被翻成“词元”,调整一下 prompt 即可。
杂谈
- Codex Fast 模式: 我的体验是 token 消耗约增加 2—2.5 倍,速度只提高约 1.2—1.5 倍,需要自己衡量是否值得。
- ChatGPT Web 的 Project: 对结果不满意时,可以重开对话或创建分支(branch)。尽量少用“xxx 是不是更好?”这样的追问,否则可能收到迎合式回答。
- Codex Side chat: 这是我很喜欢的功能,作用相当于 Claude Code 的
/btw。
- LLM leaderboard: 可以参考 Artificial Analysis。
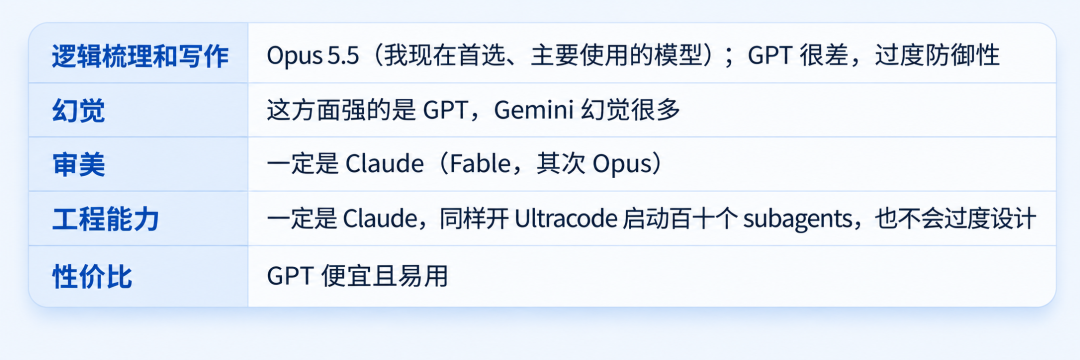
各家模型擅长什么:纯个人体验
 发表于 昨天 21:41
|
查看: 5|
回复: 0
 /1


